目录
C1 文章元信息与封面页内容
- S1 [描述性拆分] 文章标题、作者与出版元信息
- 页码:1-1
- S2 [描述性拆分] 封面页附加元信息与图像占位
- 页码:1-1
C2 摘要、关键词与引言
- S3 [描述性拆分] 内文首页元信息
- 页码:2-2
- S4 ABSTRACT
- 页码:2-2
- S5 [描述性拆分] ARTICLE HISTORY 与 KEYWORDS
- 页码:2-2
- S6 [描述性拆分] 引言:音乐表达与隐喻语言
- 页码:2-2
- S7 [描述性拆分] 引言:意象与隐喻在教学中的运用
- 页码:3-3
- S8 [描述性拆分] 引言:意象教学效果与本研究目的
- 页码:3-3
C3 Method
- S9 [描述性拆分] ## Participants
- 页码:4-4
- S10 [描述性拆分] ## Materials and procedure
- 页码:4-4
- S11 [描述性拆分] 两首旋律的意象描述与研究包分发
- 页码:5-5
- S12 [描述性拆分] 研究包第一页指令
- 页码:5-5
- S13 [描述性拆分] 研究包第二、三页意象练习与记录流程
- 页码:5-5
- S14 [描述性拆分] 研究包第四页提交与表现录音收集
- 页码:6-6
- S15 [描述性拆分] ## Data analysis
- 页码:6-6
- S16 [描述性拆分] 认知翻译过程编码与评分者信度
- 页码:6-7
- S17 [描述性拆分] 非参数统计方法的选用理由
- 页码:7-7
C4 Results
- S18 [描述性拆分] ## Results 与 ## Expressive performance
- 页码:7-7
- S19 [描述性拆分] 练习次数补充结果
- 页码:8-8
- S20 [描述性拆分] ## Participants’ cognitive processes
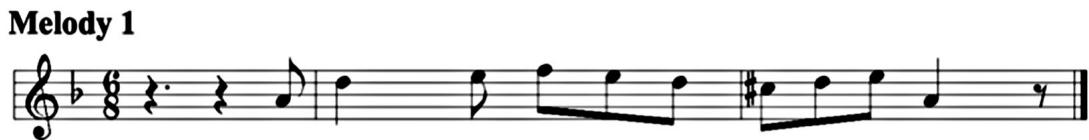
- 页码:8-8
- S21 [描述性拆分] “误判表现力”案例与认知翻译分组
- 页码:8-8
C5 Discussion
- S22 [描述性拆分] ## Discussion
- 页码:10-10
- S23 [描述性拆分] 讨论:旋律熟悉度与“误判表现力”案例
- 页码:10-10
- S24 [描述性拆分] 讨论:研究的可推广性与对音乐教育的启示
- 页码:11-11
C6 作者信息、利益声明与参考文献
- S25 [描述性拆分] ## Disclosure statement
- 页码:11-11
- S26 [描述性拆分] ## Notes on contributors
- 页码:11-11
- S27 [描述性拆分] ## ORCID
- 页码:12-12
- S28 [描述性拆分] ## References
- 页码:12-12
- S29 [描述性拆分] 参考文献续
- 页码:13-13
S1 [描述性拆分] 文章标题、作者与出版元信息
第1段(P0001)
原文复述
The eficacy of imagery-based instruction for expressive performance: a study of university musicians’ practice
中文讲解
这是文章的主标题,原文为英文,照原样复述(标题中“eficacy”按原文拼写保留,未改为常规的“efficacy”)。中文释义为:“基于意象的教学对表现性演奏的效果:大学音乐家练习的一项研究”。标题点明了四个关键信息:(1) 研究对象是“意象”(imagery),即演奏者在没有外部声音输入时,脑海中主动唤起的听觉、动作或情感表征;(2) 研究落脚点是“教学”(instruction),表明研究关注的是教学干预的效果而非单纯的心理表征本身;(3) 效果考察的是“表现性演奏”(expressive performance),强调演奏中的音乐性表达维度,而非音准、节奏等基本技术维度;(4) 研究群体是“大学音乐家”(university musicians),且数据来自他们的“练习”(practice)环节,暗示研究方法很可能与日常练习情境挂钩。
补充说明
标题中的“eficacy”是原文的拼写形式,疑似 OCR 或排版造成的漏字(通常写作 efficacy),但讲解时仍按原文保留以避免改写源材料。
第2段(P0002)
原文复述
Robert H. Woody, Mary Beth Hilbers, Jessica Schreiner & Aaron D. Schuck
中文讲解
本段列出论文的四位作者署名:Robert H. Woody、Mary Beth Hilbers、Jessica Schreiner 与 Aaron D. Schuck,署名顺序即合作作者顺序。其余栏目(如机构、脚注中的通讯信息)在本节提供的页面上并未出现,故此处不展开。
第3段(P0003)
原文复述
To cite this article: Robert H. Woody, Mary Beth Hilbers, Jessica Schreiner & Aaron D. Schuck (2024) The eficacy of imagery-based instruction for expressive performance: a study of university musicians’ practice, Music Education Research, 26:5, 622-633, DOI: 10.1080/14613808.2024.2384370
中文讲解
这是期刊页面提供的正式引用格式,可译为:“引用本文:Robert H. Woody、Mary Beth Hilbers、Jessica Schreiner 与 Aaron D. Schuck (2024) 《基于意象的教学对表现性演奏的效果:大学音乐家练习的一项研究》,《Music Education Research》(音乐教育研究),第 26 卷第 5 期,第 622–633 页,DOI: 10.1080/14613808.2024.2384370。”该段提供了三类出版元信息:(1) 完整作者列表与出版年份 2024;(2) 期刊名《Music Education Research》、卷 26、期 5、页码 622–633,说明这是 Taylor & Francis 旗下的同行评议期刊;(3) 数字对象标识符(DOI),用于在数据库中精确定位该文。题名同样按原文保留“eficacy”拼写。
补充说明
DOI 链接号在本段以“DOI: 10.1080/14613808.2024.2384370”出现,与下一段的链接形式相对应;引用项中的页码 622–633 即本篇文章在期刊中的起止页。
第4段(P0004)
原文复述
To link to this article: https://doi.org/10.1080/14613808.2024.2384370
中文讲解
这是期刊页面给出的文章永久链接提示,可译为:“链接到本文:https://doi.org/10.1080/14613808.2024.2384370。”与上一段的 DOI 编号一致,提供通过解析该网址获取正文的途径,对学术引用与读者查证具有功能性意义;不包含研究内容本身的信息。
补充说明
该 URL 与 P0003 中的 DOI 编号完全对应,前缀“https://doi.org/”是 DOI 基金会规定的标准解析路径。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节为文章首页的元信息区,未出现脚注、表格、图示或边栏等附加材料,故无额外附加信息汇总。
💡 本节核心要点
- 本节是论文首页的元信息区,包含标题、四位作者署名、正式引用格式与 DOI 链接四项内容。
- 文章标题点明核心变量:意象教学(imagery-based instruction)、被解释变量为表现性演奏(expressive performance)、研究对象为大学音乐家、数据来源为其练习实践。
- 出版元信息显示:2024 年发表于 Taylor & Francis 的《Music Education Research》第 26 卷第 5 期,页码 622–633。
- 标题中“eficacy”按原文拼写保留,应理解为 efficacy(效果/效力)。
- P0003 与 P0004 中的 DOI 编号一致,DOI 既是引用要素,也是文章的数字定位标识。
🔑 关键术语
- imagery-based instruction:基于意象的教学,指在教学过程中引导学习者主动运用心理意象(包括声音、动作、情感等内部表征)来辅助技能学习的干预方式;在本节标题中暗示其与表现性演奏效果之间的关系是研究焦点。
- expressive performance:表现性演奏,指演奏中包含的音乐性表达维度,如力度变化、句法、情感塑造等,而非仅指音准、节奏等基础技术要素;在标题中作为被考察的因变量出现。
- DOI:Digital Object Identifier(数字对象标识符),用于在数字环境中唯一标识学术资源;本节给出的 DOI 为 10.1080/14613808.2024.2384370,对应本文在《Music Education Research》中的具体条目。
- Music Education Research:本研究发表的期刊名;属于音乐教育领域的同行评议学术期刊,本节仅显示其名称、卷期与页码,未涉及学科定位的进一步说明。
S2 [描述性拆分] 封面页附加元信息与图像占位
第1段(P0005)
原文复述

中文讲解
这是一段位于第1页的图像占位符,原文经OCR处理后内嵌图像数据被省略,仅保留了图片语法外壳与位置提示。从该段在封面页附加元信息区的序列位置(紧邻前后均为英文期刊平台导航短语)来看,它很可能对应某种功能性图标,例如出版商标志、社交分享按钮、计量图标等装饰性/交互性图像。由于图像本体不可见,具体内容须查看原图确认,不作臆测。
第2段(P0006)
原文复述
Published online: 02 Aug 2024.
中文讲解
该段明确告知本篇文章正式在线发表的日期为2024年8月2日。它出现在期刊封面页附加元信息区内,属于期刊平台对正文学术稿件给出的标准化出版时间戳。日期格式采用“日 月 年”:02 Aug 即 8 月 2 日,2024 为年份。在学术发表语境中,这一日期通常被用来界定文章的优先权、作为引用统计与版本归属的时间参照,也常与“Submitted / Accepted”等时间节点配合展示。
第3段(P0007)
原文复述

中文讲解
该段为又一个位于第1页的图像占位符,原图数据已被省略。其上下文位置紧跟“Published online”日期之后、位于“Submit your article”之前,按出版平台常见布局推测可能对应某种带链接的图标(如 RSS、订阅、收藏按钮或期刊导航图标),但因图像内容不可见,不能具体判定其功能,需查看原图。
第4段(P0008)
原文复述
Submit your article to this journal
中文讲解
这是一段面向潜在投稿者的引导语,提示读者向本期刊投递稿件。在期刊网站中,它通常以可点击的超链接形式呈现,后端跳转至期刊的在线投稿系统(如 Editorial Manager 或 ScholarOne 等)。该段位于封面页附加元信息区,属于期刊网站运营层面的导航/号召性用语,并非论文正文内容;其功能是引导作者进入投稿流程。
第5段(P0009)
原文复述

中文讲解
该段是位于第1页的另一个图像占位符,原图数据被省略。从序列位置(夹在“Submit your article”与“Article views: 327”之间)来看,其在版面中承担的视觉/交互角色无法直接依据输入判定,需查看原图确认具体是装饰图、计量图标还是其他元素;不应据上下文猜测其内容。
第6段(P0010)
原文复述
Article views: 327
中文讲解
该段显示本文截至某一时点的文章浏览次数为327次。它是期刊平台常见的页面访问计量指标,统计的是读者打开或访问文章页面的次数。该数值与下文 P0016 段的“被引次数”是两种不同的计量维度:前者计量页面流量,后者计量正式学术引用,二者均随时间动态变化,本节快照中的“327”仅为该抓取时刻的当时值。
第7段(P0011)
原文复述

中文讲解
该段是位于第1页的又一个图像占位符,原图数据被省略。其上下文紧邻“Article views: 327”与“View related articles”,从结构判断可能对应某种计量/导航图标,但具体图像内容不可见,需查看原图确认;不能凭前后文推断图像本体。
第8段(P0012)
原文复述
View related articles
中文讲解
该段为期刊平台的导航性提示,引导读者查看与本文章相关的其他文章。在常见实现中,这是一段带超链接的短文本(常伴随放大镜或相关推荐图标),点击后跳转到基于主题、关键词、共同引用或合作作者关系推荐的类似论文列表。它是面向读者的扩展阅读/相关文献推荐入口,并非论文正文信息的一部分。
第9段(P0013)
原文复述

中文讲解
该段是位于第1页的另一个图像占位符,原图数据被省略。它在序列上位于“View related articles”与“View Crossmark data”之间,从版面位置推断仍属元信息区的视觉/交互元素,但具体图像本体无法确认,需查看原图,不作猜测。
第10段(P0014)
原文复述
View Crossmark data
中文讲解
该段提示读者查看本文的 Crossmark 数据。Crossmark 是由 Crossref 提供的标准化服务,用以展示一篇学术文章的最新版本状态以及自初次发表以来是否有勘误(errata)、更正(corrections)、撤稿(retraction notice)、增补(addenda)等更新。其作用是帮助读者验证所阅读版本是否为当前正式版本,并追踪文章后续可能的学术状态变化。该链接体现的是期刊在版本管理/学术诚信保障方面的能力。
第11段(P0015)
原文复述

中文讲解
该段是位于第1页的又一个图像占位符,原图数据被省略。其上下文位置介于“View Crossmark data”与“Citing articles: 2 View citing articles”之间,从序列仍属附加元信息区的图像装饰/图标位,具体图像内容不可见,需查看原图确认;不应依据前后文猜测。
第12段(P0016)
原文复述
Citing articles: 2 View citing articles
中文讲解
该段表明本文截至该时点已被 2 篇其他学术文章引用,并提供“View citing articles”这一查看入口链接至引用本文的文献列表。被引次数是文献计量学(如影响因子、h 指数等指标)的核心数据维度之一。注意文中的“2”是当时的快照值,会随时间推移发生变化;它与 P0010 段的文章浏览数(327)分属不同计量范畴:前者计量学术引用,后者计量页面流量。
第13段(P0017)
原文复述
Full Terms & Conditions of access and use can be found at https://www.tandfonline.com/action/journalInformation?journalCode=cmue20
中文讲解
该段以一条法律声明式的提示告知读者,使用与访问本期刊资源需遵守完整的条款与条件,并给出一个具体 URL。从链接域名为“tandfonline.com”可以看出该期刊由 Taylor & Francis 出版集团托管;查询参数“journalCode=cmue20”作为该期刊在 Taylor & Francis 平台的代码标识,可直接定位到该期刊的期刊信息页面。这是期刊封面页元信息区末尾常见的标准条款入口,作用是声明平台与读者之间的服务契约,而非文章正文内容。
补充说明
URL 中的“tandfonline.com”域名与“journalCode=cmue20”期刊代码含义均可在输入文字本身找到,不引入外部补充资料。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节全部 13 段均为期刊网页封面页附加元信息片段,未包含有正式学术内容或解读价值的脚注、图表说明、边栏或附录。所有图像元素均以占位符形式呈现,原图数据被省略,无法确认每张图像的具体视觉内容或图注,故不作具体功能判断。
💡 本节核心要点
- 本节 13 段全部来自期刊网页封面页附加元信息区,属于 Taylor & Francis 旗下期刊(journalCode=cmue20)在线出版页面的标准布局片段,不含正文内容。
- 正式在线发表日期为 2024 年 8 月 2 日(P0006),是本小节中唯一的时间性元数据。
- 学术计量快照显示浏览量 327 次(P0010)、被引次数 2 次(P0016),二者属于不同计量维度,且数值会随时间变化。
- 多个功能性链接构成期刊平台的导航矩阵:Submit your article(P0008)、View related articles(P0012)、View Crossmark data(P0014)、View citing articles(P0016)分别指向投稿、相关推荐、版本更新、引用列表四个不同入口。
- Crossmark(P0014)作为版本管理服务,提示本文附带有 Crossref 提供的最新版本校验能力。
- 末尾条款链接(P0017)以 tandfonline.com 上的期刊信息页面(journalCode=cmue20)为入口,属于出版平台标准的法律声明式提示。
🔑 关键术语
- Crossmark:由 Crossref 提供的学术文章版本与更新状态服务,可展示一篇文章的当前版本以及勘误、更正、撤稿等后续变动信息;本节中由 P0014 段“View Crossmark data”链接引导查看。
- Citing articles:在文献计量与期刊网站语境下,指代引用本文的其他学术文章条目数量及对应列表;本节 P0016 段显示被引 2 次并提供查看入口。
- Article views:文章页面被读者打开/访问的累计次数,是期刊平台常见的页面流量计量指标;本节 P0010 段数值为 327,且为快照值。
- Terms & Conditions of access and use:期刊平台对读者访问与使用期刊资源所设定的法律条款与条件;本节 P0017 段给出指向完整条款所在页面的 URL。
- tandfonline.com / journalCode=cmue20:Taylor & Francis 旗下在线期刊平台的根域名与其上具体某本期刊的内部代码标识,可直接定位到该期刊的信息页面;本节 P0017 段 URL 中完整出现。
S3 [描述性拆分] 内文首页元信息
第1段(P0018)
原文复述
Check for updates
中文讲解
这段原文是"Check for updates",是期刊文章电子版页面(通常位于标题区附近)的一个按钮或链接文字,作用是引导读者跳转到该文章的更新、更正或修订记录页面。它本身不包含作者主张,只是一个版面交互提示,因此在本节中起到元信息提示的作用,并标明该篇论文可能有动态更新的版本(如勘误、增补或撤稿)。需注意,这只是页面元素,不属于正文章节内容。
第2段(P0019)
原文复述
The efficacy of imagery-based instruction for expressive performance: a study of university musicians’ practice
中文讲解
该段为论文标题,原文复述为:“The efficacy of imagery-based instruction for expressive performance: a study of university musicians’ practice”。中文意为"基于意象(表象)教学对表现性演奏的效果:以大学生音乐家练习为对象的研究"。标题本身界定了论文的三个关键信息:(1) 研究对象聚焦于"意象/表象式教学"(imagery-based instruction),即让学习者在内心唤起声音、动作、情绪等心理图像的教学方法;(2) 因变量是"表现性演奏"(expressive performance),关注演奏中情感与音乐性表达而非纯技术层面;(3) 样本范围明确——“大学音乐家”(university musicians)的"练习"(practice),意味着研究是在高等教育情境中考察练习阶段的教学效果。冒号前为研究目的(验证某种教学法的效果),冒号后为研究设计与对象说明,整句构成典型的实证研究题目格式。
第3段(P0020)
原文复述
Robert H. Woody, Mary Beth Hilbers, Jessica Schreiner and Aaron D. Schuck
中文讲解
该段为论文署名行,原文复述四位作者的英文姓名:“Robert H. Woody, Mary Beth Hilbers, Jessica Schreiner and Aaron D. Schuck”,按惯例排列,第一位作者通常为主要作者或通讯贡献者,后续作者按贡献或字母顺序排列。署名行表明本项关于意象教学与表现性演奏的研究由四位作者合作完成,但仅凭此处信息无法判断各自的分工、所属子学科或通讯作者身份,需要进入正文与作者信息脚注才能进一步确认。
第4段(P0021)
原文复述
University of Nebraska – Lincoln, Lincoln, NE, USA
中文讲解
该段为机构署名,原文复述为:“University of Nebraska – Lincoln, Lincoln, NE, USA”,中文译作"美国内布拉斯加州林肯市内布拉斯加大学林肯分校"。它表明前述四位作者共同隶属于同一所大学——位于美国内布拉斯加州林肯市的内布拉斯加大学林肯分校(University of Nebraska–Lincoln)。这一行只提供机构归属,并不具体指明每位作者所在的院系、系别或研究中心,因此本段在本节中的作用是确定研究开展的总体机构背景,而非细化到学科单位。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为论文内文首页的元信息区块,包含一个期刊网页交互元素(Check for updates)、论文标题、四位作者署名以及单一机构署名,不包含脚注、图表、边栏或图注等附加材料。
💡 本节核心要点
- 本节属于期刊论文首页的元信息区域,不承载研究论点,只提供出版层面的标识信息。
- 论文标题由"研究目的"与"研究设计/对象"两部分构成,明确指向意象教学对表现性演奏的因果效果,并以大学生音乐家的练习作为实证情境。
- 署名行显示研究为四人合作,且四人共享同一机构归属(内布拉斯加大学林肯分校)。
- “Check for updates"为期刊平台的页面元素,提示该文章可能存在后续的更新或更正记录。
🔑 关键术语
- imagery-based instruction:基于意象(表象)的教学,指引导学习者在内心形成声音、动作、情绪等心理图像以辅助技能习得与演奏表现的教学方法,是本文的自变量。
- expressive performance:表现性演奏,指演奏中涉及情感表达、音乐性塑造与艺术诠释的层面,而非纯技术准确性,是本文的核心因变量。
- university musicians’ practice:大学生音乐家的练习,指本研究抽样与观察的具体情境,强调对象为高等教育阶段的学习者,并聚焦于其日常练习过程。
S4 ABSTRACT
第1段(P0022)
原文复述
ABSTRACT
中文讲解
这是论文正文的章节标题“ABSTRACT(摘要)”。它开启整篇论文的浓缩呈现,告诉读者接下来的一段将以独立、自包含的方式交代研究目的、被试、过程、主要结果与关键发现。该标题本身不包含论证,只承担版面与导航功能,但在阅读顺序上标志着全文论证的最精炼概述即将出现。
第2段(P0023)
原文复述
In this study, we investigated how musicians use descriptive imagery to perform expressively. The study’s procedure was carried out by university musicians alone in a naturalistic practice environment. They recorded their performance of two melodies both before and after receiving imagery-based instruction designed to make performance of the melodies very expressive. Participants read and considered a teacher’s expressive instructions for each melody, practiced in light of it, and recorded a final expressive performance, transcribing their thoughts while practicing. Results showed that ratings of expressiveness increased significantly from pretest to posttest, indicating that the imagery-based instruction was efective at improving participants’ expressive performance quality. Also, some musicians used a cognitive translation process, by which they explicitly generated plans for the musical sound properties in their performance, but others exclusively reflected on and personalised the provided imagery in their thoughts. Further analysis revealed that scoring high in the use of the cognitive translation process corresponded with greater improvement in expressive performance. We were also able to identify ‘cases of mistaken expressivity’, i.e. instances when participants believed their performance had efectively improved, but a change in expressive sound properties was not perceived by the listeners who made up our panel of judges.
中文讲解
本段是论文的完整摘要,按“研究问题—方法—结果—发现”的逻辑展开。
-
研究问题:作者要探究的是音乐家如何运用“描述性意象(descriptive imagery)”来实现富有表现力的演奏。这里“描述性意象”特指以语言、画面、情感等可描述的内容构成的内心表征,而不是抽象的技术动作指令。
-
被试与情境:参与者是大学音乐学习者(university musicians),且强调“alone in a naturalistic practice environment”,即在接近真实日常练琴的情境下独自完成。这与以往在实验室被严格监控的研究不同,意在让意象的使用更接近真实练习中的自然状态。
-
实验流程:每位被试在两首旋律(two melodies)上,先做一次前测录音;随后接受针对“使演奏极具表现力”的意象指导(imagery-based instruction);接着阅读并思考教师为每首旋律所写的表现性指导、依此练习、录下最终表现性演奏,并在练习过程中同步转录自己的想法(transcribing their thoughts while practicing,即出声思考式的思维记录)。这一设计的关键在于:既观测表现力的可听变化(前测—后测录音对比),又观测思维过程的内部差异(思维转录文本)。
-
主要结果一:表现力评分从前测到后测显著提高,说明这套意象指导整体上有效提升了被试演奏的表现力品质。这里的因果归因依赖于“前测—指导—后测”这一时间序列与对照。
-
主要结果二:被试在使用意象时存在两种个体差异路径——其一为“认知翻译过程”(cognitive translation process),即被试在内心把意象显式地转化为对具体音乐声学属性(如力度、节奏、句法)的演奏计划;其二为另一部分被试只停留在“反思并个人化(personalised)”所提供的意象本身,并不显式形成声学计划。前者是“意象→声学执行方案”的中介转换,后者更接近“意象→个人化情感/意义体验”的内化。
-
进一步分析:在认知翻译过程中得分高者,其表现力的提升幅度也更大。换言之,把意象“翻译”为可执行的声学参数,越彻底,改善越明显——这暗示意象对演奏的影响可能并非自动发生,而需要某种显式的中介机制。
-
一个反直觉的发现——“误判表现力”(cases of mistaken expressivity):部分被试自认为演奏已经明显改善,但听感评判小组(panel of judges)并未在声学层面的表现力属性上感知到对应变化。这是一个“自我评估与外部评估背离”的现象,意味着音乐家对自身表现力改善的主观感受并不总能被外部听者证实,作者借此提醒读者:意象训练的效果不应只看练习者自评,还需配合客观听感评价。
整段摘要的功能是预告全文:它点出研究问题(意象与表现力演奏)、方法要点(自然环境、前后测、思维转录)、关键变量(认知翻译 vs. 个人化反思)以及一个意外发现(误判表现力),为后续正文的展开提供索引。
补充说明
摘要段中出现的两处拼写“efective”疑为原文 OCR 或印刷遗漏(应为 effective),但按本节输入原样保留,以避免在复述中改动原文。摘要内并未给出具体被试人数、评分量表、效应量等数字,这些细节应留待正文与方法节交代。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节仅包含一个章节标题(P0022)与该标题下的摘要正文(P0023)。摘要段本身不附脚注、不含图表说明或边栏,因此 additional_information 项无额外附加材料可汇总。
💡 本节核心要点
- 研究聚焦于音乐家如何把“描述性意象”转化为富有表现力的演奏,并以大学音乐学习者在自然练琴环境下的前测—后测录音作为核心证据。
- 意象指导整体有效:表现力评分从前测到后测显著提高,说明意象式教学可改善演奏的表现力品质。
- 被试在使用意象时呈现两条路径——“认知翻译过程”(显式生成声学属性的演奏计划)与“对意象进行个人化反思”,二者代表了意象到演奏之间的不同中介方式。
- 在认知翻译过程中得分高者,表现力提升幅度也更大,提示意象的作用可能依赖于是否被显式转换为可执行的声学参数。
- 作者提出“误判表现力”(cases of mistaken expressivity)这一概念:当练习者自评改善而外部听感小组未感知到相应变化时,自我评估与外部评估之间存在系统性偏差。
- 摘要以“研究问题—方法—结果—发现”四段式为读者建立全文索引:先给出干预,再给出群体层面的有效性,再给出个体差异机制,最后给出反直觉的边界条件。
🔑 关键术语
- descriptive imagery:指以可描述的语言、画面、情感或情境构成的内心表征,区别于抽象的动作指令或技术参数。它在本节中作为干预手段的核心,被提供给被试以引导其表现性演奏。
- naturalistic practice environment:指接近真实日常练琴的情境,被试独自在其中完成练习与录音。该术语强调生态效度,即意象的使用方式应尽可能贴近真实练习,而非受控实验室条件。
- imagery-based instruction:基于意象的教学干预,目标是让演奏“very expressive”。在本研究中它包含教师写就的表现性指导文本与被试的思考—练习环节。
- cognitive translation process:指被试在使用意象时显式地将其转化为对具体音乐声学属性(如力度、节奏、句法等)演奏计划的心理过程。它在本节中被识别为影响表现力改善幅度的关键中介变量。
- cases of mistaken expressivity:指被试主观上认为演奏已经改善,但外部听感评判小组并未在声学层面感知到相应表现力变化的实例。它揭示了自我评估与外部听感评估之间的背离,是本研究一个重要的边界性发现。
S5 [描述性拆分] ARTICLE HISTORY 与 KEYWORDS
第1段(P0024)
原文复述
ARTICLE HISTORY
中文讲解
这是一个版块标题,用于引出本文的投稿与审稿时间记录。位于论文首页末尾、关键词之前的位置,标识接下来两行(P0025、P0026)是文章在期刊处理流程中的关键日期,而非正文内容。
第2段(P0025)
原文复述
Received 6 November 2023
中文讲解
本项说明期刊编辑部首次收到本稿件的日期,即 2023 年 11 月 6 日。它与下一行(P0026)配合,构成完整的“投稿—录用”时间区间。读者据此可以估算审稿与修改周期约为八个月(2023 年 11 月至 2024 年 7 月),从而判断该论文经历了较长的同行评审与修改过程。
第3段(P0026)
原文复述
Accepted 17 July 2024
中文讲解
本项说明稿件被正式录用的日期,即 2024 年 7 月 17 日。结合 P0025 的收稿日期可知,从投稿到录用历时约八个月。该信息仅用于学术规范中的时间声明,本身不参与正文论证。
第4段(P0027)
原文复述
KEYWORDS
中文讲解
这是一个版块标题,引出下一行(P0028)所列出的关键词。其作用是帮助检索系统与读者快速定位本文所属的研究主题,反映作者对论文核心议题的自标注。
第5段(P0028)
原文复述
Cognition; expression; music learning; music psychology; performance
中文讲解
这是本文的五个关键词,分号分隔,用于主题标引:
- Cognition(认知)——涉及心智加工与信息处理;
- Expression(表达)——涉及情感与音乐意图的外在呈现;
- Music learning(音乐学习)——指习得演奏或理解音乐的过程;
- Music psychology(音乐心理学)——本文所属的学科领域,研究音乐相关的人类行为与心理过程;
- Performance(演奏/表演)——指实际的音乐演出行为。 五个关键词共同定位本文:它处于音乐心理学领域,聚焦于音乐演奏与学习中的认知与表达问题。这与前文摘要所讨论的研究焦点一致,可作为读者快速判断本文是否相关的索引线索。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节均为论文首页的元数据条目(ARTICLE HISTORY 下的两个日期、KEYWORDS 及其列表),属于学术期刊的标准化信息,不参与正文论证,仅用于声明投稿时间线与辅助检索。
💡 本节核心要点
- P0024 与 P0027 为版块标题,分别引入投稿录用日期与关键词列表。
- P0025 注明收稿日期为 2023 年 11 月 6 日,P0026 注明录用日期为 2024 年 7 月 17 日,审稿周期约八个月。
- P0028 列出五个关键词:Cognition、expression、music learning、music psychology、performance,共同标定本文属于音乐心理学中关于演奏认知与表达的研究。
- 本节内容不构成正文论证,仅为期刊规范所要求的元数据声明与检索辅助。
🔑 关键术语
- ARTICLE HISTORY:论文首页的版块名称,用于列出稿件的收到与录用日期,标识学术出版流程的时间记录。
- KEYWORDS:论文首页的版块名称,用于以简短术语标定论文核心主题,便于数据库检索与读者快速判断相关性。
- Music psychology:音乐心理学,本文所属学科,研究音乐活动中的人类心理与行为过程,是本小节关键词中最能定位研究领域的术语。
- Performance:在本节中指音乐演奏/表演,是连接认知(Cognition)、表达(expression)与学习(music learning)的核心研究情境。
S6 [描述性拆分] 引言:音乐表达与隐喻语言
第1段(P0029)
原文复述
People look to the arts to evoke emotion and to help them find meaning in the human experience (e.g. Fingerhut and Prinz 2018; Kaimal 2022). Exactly how the arts accomplish these lofty outcomes has been the topic of much discourse among philosophers, theologians, scientists, and of course, artists themselves. Narrowing the focus to music, there exist varied theories about its expressive nature, but there is general consensus that music is more than a pleasant sonic phenomenon. Music is meaningful to people and often the meanings expressed and experienced are quite profound.
中文讲解
本段是引言的起点,先建立一个上位命题:人们求诸艺术,是为了唤起情感并帮助自己在人生经验中寻找意义(Fingerhut and Prinz 2018; Kaimal 2022 两项研究被用作佐证)。随后作者承认,艺术究竟如何实现这些"崇高"目标,长期以来由哲学家、神学家、科学家乃至艺术家本身共同讨论,并无单一答案。接下来作者把镜头拉近到"音乐"这一具体对象:一方面承认关于音乐之表现性的理论众说纷纭(varied theories),另一方面强调存在一种共识——音乐远不止是"令人愉悦的声学现象”。最后一句是本段的核心收束:音乐对人是有意义的(meaningful),且这种被表达和被体验到的意义往往相当深远(quite profound)。作者用"崇高"“深远"这类高强度限定词,是在为后文探讨音乐中具体的表达机制(尤其是隐喻语言)铺垫一个高位的理论预设:音乐值得被严肃讨论,而非仅作审美消遣。
补充说明
本段所引文献(Fingerhut and Prinz 2018; Kaimal 2022)以及后文将出现的 Leech-Wilkinson 2009、Leech-Wilkinson and Prior 2014 等具体研究内容未在当前段落中展开,仅作为作者立场的支持性引证出现,无法在本次输入范围内进一步定位。
第2段(P0030)
原文复述
That music conveys ideas and feelings beyond itself can be seen in the great extent to which people use metaphorical language when talking about music (Leech-Wilkinson 2009). Upon reviewing musicians’ use of heuristic imagery and metaphor, Leech-Wilkinson and Prior (2014) explained why certain terms are useful for communicating about musical expressivity:
中文讲解
本段是 P0029 与具体例子之间的桥梁,承担两层推进。第一层把上段的抽象论断(音乐承载意义)落到一个可观察的证据上:人们在谈论音乐时大量使用隐喻语言(Leech-Wilkinson 2009),这本身就反向证明音乐所传达的内容"超出了音乐本身”(beyond itself)。所谓"beyond itself",是指音乐承载着无法被还原为纯声音事件的观念与情感。第二层,作者引出 Leech-Wilkinson and Prior (2014) 的综述研究,说明音乐家在使用启发式意象(heuristic imagery)和隐喻时,某些术语之所以有效,是因为它们在沟通音乐表现性时具有特殊价值。本段末尾的冒号提示读者:接下来将进入一个被直接引用的例证段,以具体展示这种"有用性"究竟指什么。整体而言,本段的功能是把读者从"音乐有意义"的总命题,引向"音乐人如何用隐喻交流这种意义"这一可操作的子论题。
第3段(P0031)
原文复述
An example is ‘shape,’ which, as recent research has shown, is immensely flexible and useful for sharing ideas about how to generate expressive performance without having to specify exactly which sounds might be required. The word is used between musical performers with a high level of mutual understanding, as a way of communicating expressive features that are actually very dificult to articulate in more detail (34)
中文讲解
这是一段直接引文(出处页码 34,来自 Leech-Wilkinson and Prior 2014),用一个具体词"shape"(形状)来例证上一段所说的"某些术语有用"。引文本身包含三层信息,需要拆开理解:第一,“shape” 之所以被选中作为例子,是因为近期研究表明它具有极高的灵活性(immensely flexible);第二,它的实用性体现在:演奏者之间可以用它来交流如何生成有表现力的演奏(expressive performance),而不必明确指出究竟需要哪些具体声音(which sounds might be required);第三,演奏者群体在共享这个词时,彼此之间已经达到高度的相互理解(a high level of mutual understanding),它实际上承担着一种"难以更细致言说"(very difficult to articulate in more detail)的表现性特征的沟通功能。值得注意的是,原文单词 “dificult” 是原文中的拼写错误,应为 “difficult”,但作者在引文中原样保留,故本复述也照原样保留。这一例子的关键不在"shape"这个词本身,而在它揭示了一种机制:隐喻术语能够在不指定具体声音参数的前提下,传递关于演奏表现性的高阶指令。换句话说,音乐人的隐喻语言是一种高效率的、共享的、意义承载的交流工具——这正是本节为后文论证所准备的具体起点。原文未出现 supplementary discussion of “shape”,因此本节中没有继续展开其他例子。
补充说明
原文将页码 34 置于引文末尾的括号中,属于引文出处标注;引文本身逐字保留,原文中的拼写 “dificult” 也照原文出现,未做更正,以避免改写引文内容。
第4段(P0032)
原文复述
CONTACT Robert H. Woody rwoody2@unl.edu © 2024 Informa UK Limited, trading as Taylor & Francis Group
中文讲解
本段并非正文,而是第 2 页页脚处的出版与联络信息。版面属性上属于作者联系方式和版权声明:通讯作者为 Robert H. Woody(电子邮箱 rwoody2@unl.edu),出版方为 Informa UK Limited,以 Taylor & Francis Group 名义经营,版权年份为 2024。这些信息不参与引言的论证,仅用于学术规范和出版溯源。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节仅在引文末尾(页码 34 标注)出现一处直接引文,来自 Leech-Wilkinson and Prior (2014);本小节内未出现图表、框图、边栏或脚注内容;除正文末页脚处的作者联络与版权声明外,无其他附加材料。
💡 本节核心要点
- 本节为论文引言的开端,先确立一个上位前提:艺术(包括音乐)承载情感与意义,且音乐的意义往往相当深远。
- 作者用 Leech-Wilkinson 2009 作为外部支持,论证"音乐传达超出其自身之物",并将此落到一个可观察的现象——谈论音乐时大量使用隐喻语言。
- Leech-Wilkinson and Prior (2014) 的综述被引入,作为解释"为何某些隐喻术语对沟通音乐表现性有用"的权威依据。
- 以 “shape” 一词为具体例证,展示了隐喻术语的功能:无需指定具体声音参数,即可在演奏者之间以高度共享的默契传递高阶表现性指令。
- 本节为后文从"隐喻语言"切入音乐表现性研究做了问题铺垫:从一般共识到具体交流机制,形成"总—分—例"的论证节奏。
🔑 关键术语
- metaphorical language (隐喻语言):在本节中指人们在谈论音乐时所使用的大量隐喻性表达,作者将其作为"音乐承载超越自身之物"的可观察证据,是本节论证的入口概念。
- heuristic imagery (启发式意象):出现在 P0030,指音乐家用来辅助理解和沟通的启发性意象或比喻,与"metaphor"并列出现,强调其在演奏交流中的探索性、辅助性作用。
- expressive performance (有表现力的演奏):P0031 引用文中的核心对象,指承载情感与意图、超越纯技术性音响输出的演奏;“shape” 这一隐喻术语正是用于在演奏者之间传递如何生成此类演奏的指令。
- shape (“形状” 隐喻):P0031 中作为例证出现的隐喻术语,其本节中的具体作用是说明:演奏者可以用这个词在彼此高度默契的前提下,交流难以用更细致语言描述的表现性特征,而不必指明具体声音参数。
S7 [描述性拆分] 引言:意象与隐喻在教学中的运用
第1段(P0033)
原文复述
Leech-Wilkinson and Prior (2014) also noted that expressive variations associated with the ‘shape’ concept appear to be influenced by musicians’ age, gender, and main instrument.
中文讲解
这句是上一节’指引意象’讨论的延续与补足。Leech-Wilkinson 与 Prior(2014)观察到一个重要细节:与’shape’概念相关的表达性变化并非整齐划一,而是与演奏者的年龄、性别以及主修乐器挂钩。这就把读者对’shape’概念的理解从’一种抽象、统一的表达框架’拉回到’受演奏者个体变量调节的具体实践’。换句话说,同样的’shape’意象在不同演奏者身上会产生不同的表达效果。这为转向下一段’教师在教学中如何运用意象与隐喻’埋下伏笔——如果演奏者本人对’shape’的反应存在差异,那么教师在课堂上以意象、隐喻为媒介进行教学时,就必须把这些差异纳入考虑。
补充说明
句首的’also noted’承接前文对’shape’概念的研究综述,表示此处添加的是该领域文献中的另一项观察,而非全新论题。
第2段(P0034)
原文复述
Many music educators prefer to teach expressive performance to students using imagery and metaphor (Karlsson and Juslin 2008; Lindström et al. 2003; McPhee 2011; Schippers 2006). Juslin and Lindström (2016) have provided a well-supported theoretical explanation of emotional expression in music performance, which advances a ‘coding’ process whereby performers express emotions that they associate with the music, rather than expressing their own emotional state:
中文讲解
本段提出本节的核心议题,并给出理论依托。
第一句开门见山:许多音乐教育者倾向于借助意象(imagery)与隐喻(metaphor)来教学生如何演奏得富有表现力,并列出 Karlsson & Juslin(2008)、Lindström 等(2003)、McPhee(2011)、Schippers(2006)作为支持依据。这一观察是经验性的,说明’用具象语言教抽象表达’是教学现场的常态。
第二句引入 Juslin 和 Lindström(2016)的理论解释作为后续论述的支柱。他们提出’编码(coding)‘过程:演奏者在表演中传达的并非’自己正在体验的情绪’,而是’他们与这段音乐相关联的情绪’。这一区分至关重要——它解释了’为何教师用隐喻/意象的语言来引导学生’是合理的:教师的隐喻不需要学生’真的感受到’某种情绪,而只需要学生把它’编码’到演奏里。它同时也把教学与表演心理学的研究锚定在一个共享的理论框架上。
补充说明
本段的破折号引导下一段(P0035)对’编码’过程的直接引文,因此本段实际是两段叙述的前半部分,需把’coding’概念视为下一段才完整铺陈的理论术语。
第3段(P0035)
原文复述
It is only occasionally that performers are truly expressing their own emotions during the performance – perhaps because optimal performance requires a certain state (e.g. relaxed concentration; see Williamon 2004) that is incompatible with experiencing certain emotions. Usually what the performer presents in a music performance is not the emotion itself but rather its ‘expressive form.’ (598)
中文讲解
这是 Juslin 与 Lindström(2016)原文的引文(页 598),用来细化上一段提到的’编码’过程。
第一层逻辑是用’only occasionally’这种强限定语来收窄范围:演奏者真正在舞台上表达’自己的情绪’只是偶发情况。紧接着给出原因——最佳表演状态(如 Williamon 2004 提出的’relaxed concentration’放松性专注)与某些情绪体验是不相容的。也就是说,从生理与心理状态上看,表演中的情绪释放反而干扰演奏稳定性。
第二层由此推出关键术语:表演者在舞台上呈现的通常不是’情绪本身’,而是情绪的’expressive form’(表达形式)。这一术语为’为什么可以用隐喻/意象去教表达’提供了最终的解释:隐喻不是在要求学生去经历那种情绪,而是在引导学生塑造情绪的表达形式;只要’形式’做到位,听者就会接收到情绪信号。
因此这段引文既是 P0034 ‘coding’概念的实质内容,也是后文 P0036 讨论教师为何采用意象/隐喻教学的逻辑桥梁。
补充说明
Williamon(2004)的’relaxed concentration’(放松性专注)作为表演心理学的经典概念被援引,用来支撑’表演状态与情绪体验不兼容’这一因果链,但作者并未在本段进一步展开这一概念。
第4段(P0036)
原文复述
In accordance with this idea, teachers often use metaphorical or figurative language to help student performance be expressive of emotions, moods, or gestural motions (McPhee 2011; Wolfe 2019; Zorzal 2020). Zorzal and Soares-Quadros Jr. (2021) suggested that teachers may use images and metaphors ‘in unequal measure when dealing with male and female students’ and that such language may be used based on students’ performance levels (508). With more advanced music students, metaphorical verbal instruction may be more efficient than using ‘technical’ language focusing on musical sound properties (Arrais and Rodrigues 2007). Based on a study of the imagery and metaphors used by college-level music performance instructors, Woody (2002) concluded that emotional aspects of music are often the focus of imagery and metaphor examples and that there may be a ‘shared and relatively limited affective vocabulary’ used by instructors to elicit expressive performance in students (213). It appears, however, that musicians must learn the coding process for themselves, that is, how to translate metaphor/imagery examples into musical sound (Meissner 2017; Woody 2006a). Students must know how to turn an instructor’s metaphor into a plan for their expressive performance; students may be unmoved – or worse yet, confused or discouraged – by metaphorical instruction if they have not yet acquired the translation skill or when a teacher’s metaphor example is vague or unfamiliar to them (Karlsson and Juslin 2008; Persson 1996; Woody and McPherson 2010).
中文讲解
本段是 P0034–P0035 理论铺垫之后的实践落地,分三层把’用意象/隐喻教学’这一主张的成效、条件与风险讲清楚。
第一层:做法与分配。承接前段’编码’理论,本段指出教师经常使用隐喻或形象化语言,目的不是诱发学生真去体验情绪,而是帮助演奏传达情绪、心境或姿态动作(McPhee 2011;Wolfe 2019;Zorzal 2020)。Zorzal 与 Soares-Quadros Jr.(2021)补充两个变量:教师对男女生使用意象/隐喻的’剂量’可能并不对等,使用频率也与学生演奏水平挂钩(页 508)。这暗示隐喻/意象并非普适的教学中立工具,而是被教师的成见、教学经验与学生水平塑形。
第二层:何时更有效。Arrais 与 Rodrigues(2007)的发现是,对于更高级的音乐学生,隐喻式语言比聚焦于声音属性的’技术性’语言更高效。这与 P0033 提到的’年龄/性别/主修乐器’调节项相呼应:当学生的认知水平更高时,隐喻能更快唤起内在编码;但’更高效’并不意味着对所有学生都更优。
第三层:词汇与限制。Woody(2002)对高校器乐教师使用意象/隐喻进行研究后得出两点结论:其一,隐喻/意象的例子往往聚焦于音乐的情感维度;其二,教师在诱发学生表达时可能共享一个’相对有限的情感词汇库’(页 213)。这等于把教师课堂上的隐喻工具箱’清单化、可量化’了——教师之间所用的表达词汇比通常以为的更收敛。
第四层:关键的转折(‘however’)。作者紧接着指出问题所在:编码过程不是教师能直接传递给学生的东西,学生必须自己学会如何把隐喻/意象’翻译’成具体的音乐声响(Meissner 2017;Woody 2006a)。这段翻译能力的缺失会直接导致负面后果:学生可能对隐喻式教学无感,更糟的情况是被弄糊涂或受打击(Karlsson & Juslin 2008;Persson 1996;Woody & McPherson 2010)。‘unmoved—confused—discouraged’三个词构成从轻到重的递进,凸显了’看似温和的隐喻教学若使用不当反而会反咬一口’的风险。
因此本段在论证结构上承担双重任务:既为前文’用意象/隐喻教学’提供经验支撑,又通过’翻译能力’与’词汇有限’两个限定把它推向下一节要解决的实证问题——学生侧的处理究竟是不是教师教学语言的一个镜像?
补充说明
段中’technical’加引号,与前文的’encoding’、’expressive form’共同构成作者对术语的明确标记,提示读者这些是来自特定理论的概念而非通用词。Zorzal and Soares-Quadros Jr. (2021) 与 Woody (2002) 的页码(508、213)为原文页码引用,而非本手册的页码。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节位于第 3 页(P0033–P0036),其内容全部为正文叙述,无页眉、页脚、表格或图示;无独立脚注、注释或边栏。所有参考文献(Leech-Wilkinson & Prior 2014;Karlsson & Juslin 2008;Lindström et al. 2003;McPhee 2011;Schippers 2006;Juslin & Lindström 2016;Williamon 2004;Wolfe 2019;Zorzal 2020;Zorzal & Soares-Quadros Jr. 2021;Arrais & Rodrigues 2007;Woody 2002;Meissner 2017;Woody 2006a;Persson 1996;Woody & McPherson 2010)均以正文形式嵌入相应主张,未单独成注。
💡 本节核心要点
- Leech-Wilkinson 与 Prior(2014)的补注:与’shape’概念相关的表达性变化受演奏者年龄、性别和主修乐器调节,说明同一个’指引意象’在不同演奏者身上会产生不同的表达效果。
- Juslin 与 Lindström(2016)提出的’coding(编码)‘过程是本节理论支柱:演奏者在舞台上表达的是’与音乐相关联的情绪’,而非演奏者自身的情绪体验。
- 借由’relaxed concentration’等表演心理学概念,作者论证:最佳表演状态与许多情绪体验不相容,因此表演通常呈现的是情绪的’expressive form(表达形式)‘而非情绪本身。
- 教学实践上,教师广泛使用意象与隐喻来引导学生表达情感、心境或姿态动作;但 Zorzal 与 Soares-Quadros Jr.(2021)指出,这种语言在男女学生间使用剂量可能不对等,并随学生演奏水平而变化。
- Arrais 与 Rodrigues(2007):对水平较高的学生而言,隐喻式语言比聚焦音响属性的’技术性’语言效率更高,但前提是学生已具备相应的解码能力。
- Woody(2002):教师用以诱发表达的意象/隐喻例子往往聚焦于情感维度,且教师群体之间共享一个’相对有限的情感词汇库’;Meissner(2017)、Woody(2006a)等进一步指出编码/翻译能力必须由学生自行习得,否则学生可能无感、困惑甚至受挫。
🔑 关键术语
- shape concept(‘shape’概念):一种指引演奏表达的结构性意象,指演奏者对整段音乐’形态走向’的内在感知;本节指出它对不同年龄、性别、主修乐器的演奏者会产生不同的表达性变化。
- coding process / coding(编码过程):Juslin 与 Lindström(2016)提出的概念,指演奏者把’与音乐相关联的情绪’转化为可听表达形式的过程;它解释了表演为何可以’表达情绪而不必亲自经历情绪’。
- expressive form(表达形式):演奏者呈现给听者的内容——并不是其内心正在经历的情绪本身,而是该情绪的可演奏、可感知的’形式’;是隐喻/意象教学所要塑造的对象。
- imagery and metaphor(意象与隐喻):音乐教育中教师用以引导学生’编码’表达的语言工具,包括形象化的画面与比喻性说法;属于非技术性、偏感受性的教学媒介。
- shared and relatively limited affective vocabulary(共享且相对有限的情感词汇库):Woody(2002)的提法,指教师在诱发学生表达时实际使用的情感描述词集合比通常以为的更收敛、更接近;提示教学用语的标准化与局限性。
- translation skill / decoding(翻译/解码能力):学生把教师的隐喻/意象例子转化为具体演奏动作与声响的能力;Meissner(2017)等强调该能力必须由学生自我习得,缺乏时会导致教学失效甚至反效果。
S8 [描述性拆分] 引言:意象教学效果与本研究目的
第1段(P0037)
原文复述
Metaphor and imagery-based instruction is common in music teaching and is considered to be effective at producing improved expressive performance in students (Bonastre and Timmers 2021; Woody 2006b). Relatively little research, however, has gone beyond musician’s beliefs to examine measurable qualities of performance to establish the effectiveness of certain types of instruction for emotional communication (i.e. listeners hear what performers intended to express). Juslin and colleagues have shown that concrete verbal instruction about the sound properties of performance – that is, specific feedback on musicians’ use of tempo, dynamics, and articulation – can reliably change expressive performances to be more perceivable by listeners (Juslin et al. 2006; Juslin and Laukka 2000). Woody (1999, 2003) has demonstrated that the nonverbal instructional strategy of aural modelling and imitation can produce improved expressive performance, especially when the listening musicians explicitly identify features in the model to incorporate into their own plan for performing.
中文讲解
本段的中心主张可以拆成两个层次。第一层是现象描述:隐喻与意象教学在音乐教学中很常见,教师普遍相信它能让学生演奏得更富表情(Bonastre and Timmers 2021; Woody 2006b),但作者随即用 “Relatively little research, however” 进行转折,强调过去的实证证据大多停留在音乐家自己的主观信念层面,而真正用可测量的演奏结果去检验某种教学法是否真正有效、并且听者能否准确解码演奏者想要传达的情绪——即所谓 emotional communication——的研究还很稀少。括号中 “i.e. listeners hear what performers intended to express” 把 “emotional communication” 这个抽象说法锚定为可观察的判断标准:听者所听到的,是否就是演奏者原本想表达的。
第二层是为本研究做铺垫的两条已有证据线索。Juslin 及其合作者的工作(Juslin et al. 2006; Juslin and Laukka and 2000)证明,针对演奏的声音属性——速度(tempo)、力度(dynamics)、咬字/奏法(articulation)——给出具体、可测的言语反馈,能够可靠地让演奏的表情更被听者辨识。这意味着,只要教学的措辞落在声音参数上,效果是较稳健的。Woody(1999, 2003)则证明了另一条非言语路径:让学生听范奏(aural modelling)并加以模仿,也能改善表情演奏,但条件是听者必须显式(explicitly)识别出范奏中的具体特征,并把这些特征纳入自己的演奏计划。换言之,模仿不是被动的,而是需要主动分析。
这两条线索并列,其实暗示了一个关键区分:言语/具体声音反馈 vs. 非言语/意象类教学。前者在 Juslin 的研究中效果明确,后者正是本研究要进一步追问的对象。作者通过 “however” 把意象教学的常见信念与稀薄的客观证据并置,正是为下一段提出本研究的设计动机。
补充说明
本段引用的研究在原文中只出现作者-年份的简略形式,详细的文献信息属于输入范围之外的背景,本节不予补写。“expressive performance” 与 “emotional communication” 在作者笔下是两个相关但不等同的概念:前者是演奏侧的输出,后者强调听者能否成功解码,两者构成教学法是否有效的判定条件。
第2段(P0038)
原文复述
The present study examined whether university musicians improved their expressive performance after receiving metaphor and imagery-based instruction. It partially replicated and extended an Woody (2006a) study, in which collegiate musicians reported their thought processes while practicing after receiving imagery-based instruction. That study found that many of the musicians used a cognitive translation process by which they used the imagery instruction to generate explicit plans for the musical sound properties in their own performance. The most advanced musicians (as indicated by most years of private instruction) seemed to carry out the translation process automatically, with less explicit thought. Woody (2006a) did not, however, collect any performance data to determine the extent to which the musicians’ performances actually changed after receiving the instruction. Based on past research, there is reason to suspect that students’ perceptions of learning do not always equate to actual improvement in performance (Dunning et al. 2003; Persky, Lee, and Schlesselman 2020), including with respect to music performance specifically (Bergee 1997; Larrouy-Maestri et al. 2023). In the current study, in addition to reporting their thoughts while practicing, participants collected recordings of their performances before and after receiving imagery-based instruction.
中文讲解
本段承担了典型的引言末段功能:交代本研究的具体问题、研究设计依据和与既有工作的关系。它一开篇就锁定了核心研究问题——大学阶段的音乐生在接受了隐喻与意象类指导之后,是否真的在表情演奏上有所改善。注意这里问的是 “improved”,而不是 “changed”,意味着基线期待是积极结果,但研究中通常仍保留中性检验的可能性。
接着,作者说明本研究是对 Woody(2006a)的 “partially replicated and extended”。这一短语要拆开读:replicated 意味着沿用原研究的某些做法(让学生在练习时报告思维过程),extended 意味着加入新的测量维度。原研究的关键发现是:学生在收到意象指导后,会经历一个作者称之为 “cognitive translation process” 的步骤——把意象层面的提示,转化为对演奏声音属性的明确计划。这是一个很有理论意义的机制,它假设意象并不是直接、自动地引发相应的声音动作,而是先被 “翻译” 成可执行的声音参数规划。原文还揭示出一个个体差异:水平更高的音乐生(以私人教学年限衡量)几乎自动化地完成这一翻译,所需要的显性思考更少。也就是说,专家可能把意象处理内化成了隐性的程序性知识。
然而,原研究存在一个被作者明确点出的缺口:Woody(2006a)没有收集演奏数据,也就是说,她只能推断意象引发了某种思维上的翻译,但无法判断这一翻译是否真的让演奏变得更可被听者感知。这正是本研究要补上的环节。作者随后引用 Dunning 等(2003)、Persky 等(2020)、Bergee(1997)和 Larrouy-Maestri 等(2023)等多条文献,支持一个一般性的元假设——学生的主观学习感受并不必然等同于客观表现的提升;这一点在音乐演奏领域同样成立。这条元假设为后续设计双重测量(思维报告 + 演奏录音前后对比)提供了方法论上的正当性。
综上,本段的论证链是:原研究的思维报告发现 → 但缺少演奏数据 → 一般文献支持 “感觉改善 ≠ 实际改善” → 因此本研究增加前后两次演奏录音。这一链条把本研究的扩展(extension)部分清楚地锚定在了补足证据类型这一个具体维度上。
补充说明
原文 “extended an Woody (2006a)” 在介词搭配上存在轻微的口语或排版瑕疵,但在本节范围内按原文如实复述即可,不作修改。“cognitive translation process” 是作者用以刻画意象教学内部机制的关键概念,本节后文会进一步引用该术语。“most years of private instruction” 被作者用作专家程度的操作化指标,这是一种常见的以训练年限代理专业水平的做法。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节(S8)位于第 3 页,由两个正文段落组成,无脚注、无图表、无边栏。引用文献以作者-年份格式出现在正文括号内,如 Bonastre and Timmers 2021、Woody 2006b、Juslin et al. 2006、Juslin and Laukka 2000、Woody 1999/2003、Woody 2006a、Dunning et al. 2003、Persky, Lee, and Schlesselman 2020、Bergee 1997、Larrouy-Maestri et al. 2023。这些文献在引言中发挥三种功能:支持意象教学的常见性(Juslin 系列、Woody 1999/2003 等被作为有效教学的证据基础);为原研究的方法缺口做铺垫(Woody 2006a);以及支撑 “感知学习 ≠ 实际进步” 的元假设(Dunning 等、Bergee、Larrouy-Maestri 等)。
💡 本节核心要点
- 意象与隐喻教学在音乐教育中虽被广泛使用并被教师视为有效,但过去对其客观效果的实证检验,尤其是围绕听者能否感知演奏者情绪这一标准的研究,仍然有限。
- 已有证据呈现两条相对成熟的路径:Juslin 一系的针对速度、力度、奏法等声音属性的具体言语反馈;以及 Woody 一系的非言语范奏模仿,且后者以听者显式提取范奏特征为有效条件。
- Woody(2006a)提出 “cognitive translation process”:意象被翻译为对声音属性的明确演奏计划;高水平音乐生的这一翻译趋于隐性与自动化。
- Woody(2006a)的研究缺口在于只测量思维报告而未收集演奏前后数据,使得意象教学是否真能改变演奏表现悬而未决。
- 一般文献支持 “学习者主观感受到的进步” 与 “客观表现的进步” 之间存在落差,音乐演奏领域亦然。
- 本研究的设计由此明确:在沿用思维报告的基础上,额外收集接受意象教学前后的演奏录音,从而把研究从纯认知层面扩展到可观测的表情演奏表现层面。
🔑 关键术语
- metaphor and imagery-based instruction:以隐喻和意象作为教学媒介的音乐教学方式,教师借助非声音性的描述(例如把某段旋律比作某种景象或情绪)引导学生的演奏表现,是本研究所聚焦的教学干预。
- expressive performance:本节中指演奏侧的表情性输出,是与声音属性(速度、力度、奏法等)相关的可观察演奏特征,而非泛指任何演奏行为。
- emotional communication:作者把它操作化为 “listeners hear what performers intended to express”,即听者能否准确解码演奏者想要传达的情绪,是判断教学法是否真正有效的判定标准。
- sound properties of performance:在本节特指 tempo、dynamics、articulation 三类演奏参数,是 Juslin 等研究中言语反馈所指向的对象,也是意象被 “翻译” 成的目标层面。
- aural modelling and imitation:Woody 1999/2003 提出的非言语教学策略:通过让学生听范奏并进行模仿来改善表情演奏,前提是学生显式识别范奏中的特征。
- cognitive translation process:Woody 2006a 提出的机制假设:学生把意象层面的教学语言转化为对演奏声音属性的明确计划;越是高水平音乐生,这一过程越自动化、越不需显性思考。
- private instruction:在本节中以学生接受私人教学的年限作为专家程度的操作化指标,用来把音乐生区分为不同水平层次。
S9 [描述性拆分] ## Participants
第1段(P0039)
原文复述
Method — a top-level section heading that opens the Method portion of the paper, signaling the transition from the introductory / literature background into a description of how the study was carried out.
中文讲解
这段原文仅为一个二级标题「## Method(方法)」。它的功能是开启论文的“方法”章节,把读者从前文的问题背景与文献综述带入到具体的研究设计与执行细节中。该标题之下,作者将依次说明参与者、材料/刺激、程序、变量与测量等研究方法要素。本节边界内紧随其后的第一个子标题即为「## Participants(参与者)」。
第2段(P0040)
原文复述
Participants — a subsection heading under the Method section, marking the start of the description of the study’s sample: who the participants were, why they were chosen, and how they were recruited.
中文讲解
这段原文是方法章下的子标题「## Participants(参与者)」,其作用是把读者的注意力从“方法”这一上位概念收窄到研究的样本本身:研究招募了谁、人数与构成如何、为什么是这群人、以及是否通过了伦理审查。它是研究方法报告中常见的第一项内容,位于程序(Procedure)、材料(Materials)等其他方法子节之前。
第3段(P0041)
原文复述
Because of our interest in the learning of expressive performance, for our participants, we sought student musicians who were not so advanced as to have expressive performance skills that were already highly learned and refined; Woody (2006a) suggested that the most experienced musicians in that study used a cognitive process that had ‘become automatized for the most part’ and therefore out of their conscious attention (135). Accordingly, we targeted the younger undergraduate music majors for this study by making brief announcements to lower-division music classes inviting students to participate.
中文讲解
本段说明参与者的招募逻辑:研究者关心的是「表现性演奏(expressive performance)」的学习过程,因此需要尚未把表现性技巧学得「高度精熟与自动化」的学生音乐家。引用 Woody (2006a, p. 135) 是为了支撑这一选择——该研究发现最熟练的音乐家所使用的心智过程「在很大程度上已经自动化」(become automatized for the most part),从而脱离了有意识的注意。换句话说,如果被试已经是专家,他们加工表现性演奏的认知过程将不再能被研究者清楚观察,因此不适合作为「学习」的样本。基于此,研究者把目标锁定在「较年轻的本科生音乐专业学生」,具体做法是到低年级(lower-division)音乐课上做简短的口头招募通知。这是一种「理论驱动 + 现实可操作性」的招募策略:既符合研究目的对「尚未自动化」的需要,又利用了大学低年级课程作为可接触的招募渠道。
补充说明
本段中 Woody (2006a) 的引用是支撑招募标准的关键外部依据,作者用引文(带页码 135)明确点出其结论以避免研究者自身判断被质疑;「lower-division」在美国大学语境中指大一、大二阶段的本科课程,对应「未达到高级专业水平」的招募意图。
第4段(P0042)
原文复述
The participants were 24 undergraduate music majors at the lead researchers’ university, which is a large public university in the Midwestern United States. Across the entire sample of 24 participants, the average age was 19.8 years old, and 14 of the participants were female, and 10 were male. Regarding primary area of performance, the instruments represented across the sample were: 7 voice, 3 strings, 7 woodwind, 5 brass, and 2 piano/percussion. The study received ethical approval from our university’s Institutional Review Board and we conducted the research in full compliance with the IRB’s expectations related to participant informed consent, welfare, rights, and privacy.
中文讲解
本段给出样本的具体人口学与乐器分布信息:24 名本科生音乐专业学生,来自主研究者所在的一所美国中西部大型公立大学;平均年龄 19.8 岁;女性 14 人、男性 10 人。从主修乐器看,声乐 7 人、弦乐 3 人、木管 7 人、铜管 5 人、钢琴/打击乐 2 人,分布相对均衡,涵盖了主要的演奏专业方向。最后一段说明本研究获得了大学机构审查委员会(IRB)的伦理批准,并完全遵守 IRB 关于知情同意、福祉、权利与隐私的要求。这一信息承担三个作用:① 让读者判断样本对研究问题是否具有代表性;② 交代招募与施测的伦理合规性;③ 为后续报告研究程序、变量与结果提供必要前提。值得注意的是,年龄均值 19.8 岁印证了上一段「以低年级本科生为对象」的招募策略——这正是研究者想要的「尚未把表现性演奏自动化」的群体。
补充说明
本节描述与前段的招募标准在数字上相互印证:招募「younger undergraduate music majors」与平均年龄 19.8 岁一致;「lower-division」学生人数应略多于 24 人(实际仅 24 人进入研究);乐器分类「voice / strings / woodwind / brass / piano/percussion」是美国音乐院校常用的主修分类法,piano/percussion 合并计为 2 人。
脚注 / 边栏 / 图表 / 附加信息(如有)
无(本节范围内未出现图表、脚注、边栏等附加材料;P0039、P0040 为层叠的章节标题,已在对应条目中说明其功能)。
💡 本节核心要点
- 本节开启了论文的「Method」部分,其下第一个子节是「Participants」,说明研究如何界定并招募被试。
- 招募标准由研究问题驱动:研究关心的是「表现性演奏的学习」,因此排除已把表现性技巧自动化的高级音乐家,引用 Woody (2006a, p. 135) 作为理论依据。
- 具体招募策略是到「低年级音乐课」(lower-division music classes)做简短口头邀请,对应「younger undergraduate music majors」的样本定位。
- 样本构成:24 名本科生音乐专业学生,来自美国中西部一所大型公立大学,平均年龄 19.8 岁,女性 14 人、男性 10 人。
- 样本的主修乐器分布较为均衡:声乐 7、弦乐 3、木管 7、铜管 5、钢琴/打击乐 2,涵盖了主要的演奏方向。
- 研究获得了所在大学机构审查委员会(IRB)的伦理批准,并完全遵守 IRB 关于知情同意、福祉、权利与隐私的要求。
🔑 关键术语
- expressive performance:「表现性演奏」,指演奏者在音高、节奏、力度等方面加入诠释与情感表达的演奏方式;本研究关心的是这一能力的「学习」过程,而非纯熟的演奏结果。
- automatized cognitive process:「自动化的认知过程」,即经过大量练习后不再需要有意注意即可执行的加工;本节以 Woody (2006a) 的结论说明:高度熟练的音乐家其表现性加工已脱离意识层面,难以作为「学习」的研究对象。
- lower-division music classes:「低年级音乐课」,在美国大学语境下指大一、大二阶段的本科音乐课程;这是本研究面向「较年轻、未达高级水平」的本科生音乐专业学生的具体招募渠道。
- Institutional Review Board (IRB):「机构审查委员会」,美国高校负责审查涉及人类被试的研究是否符合伦理规范的委员会;本节通过声明获得 IRB 批准并遵守其要求,确认研究的伦理合规性。
- undergraduate music majors:「音乐专业的本科生」,本研究的样本群体;与「younger」和「lower-division」共同构成招募定位的三个互证维度。
S10 [描述性拆分] ## Materials and procedure
第1段(P0043)
原文复述
Materials and procedure
中文讲解
本行为二级小节标题,标志着文章"方法"部分的开始。作者在这一节中将说明研究中使用的音乐材料与实验程序。标题使用复数形式"Materials and procedure",提示读者后文会分别交代实验材料(materials)和实验程序(procedure)两个层面。
第2段(P0044)
原文复述
The music materials used in the study consisted of the two short melodies shown in Figure 1. Melody 1 was written for use in an experiment by Clarke and Baker-Short (1987) and was used in the Woody (2006a) study of expressive performance. Melody 2 is from the Schubert song cycle Die schöne Müllerin and has also been used in past studies regarding expression in musical performance (Clarke 1993; Woody 2006a).
中文讲解
本段交代实验所采用的刺激材料:两段短旋律,展示于图 1 中。作者分别交代了两段旋律的来源与既有使用记录——旋律 1 由 Clarke 与 Baker-Short(1987)为某次实验所写,并被 Woody(2006a)用于"表现性演奏"(expressive performance)研究;旋律 2 取自舒伯特声乐套曲《美丽的磨坊女》(Die schöne Müllerin),也曾出现在 Clarke(1993)和 Woody(2006a)关于音乐演奏表现力的研究中。这样交代材料的作用有二:一是告知读者刺激物的身份与来源,二是把当前研究与既有文献衔接起来,使读者能够依据前人研究理解本实验对刺激物的选择依据(即两段旋律在表现性演奏研究中已有验证基础)。本段未给出旋律的具体主题、长度、调性或拍号等细节,这些信息须通过图 1 查阅。
补充说明
Die schöne Müllerin 为舒伯特声乐套曲德文原题;图 1 的具体乐谱内容在本节文本中不可见,需查阅原图。
第3段(P0045)
原文复述
The imagery-based descriptions that served as expressive instruction were taken from a past research study in which college professors of applied music performance contributed examples of descriptive imagery that they would use to elicit improved expressive performance from their students; the resulting examples were then evaluated by a panel of expert music educators to
中文讲解
本段开始介绍另一类实验材料——作为"表现性指令"(expressive instruction)的"基于意象的描述"(imagery-based descriptions)。作者交代了这些描述的来源:取自一项既有研究,在该研究中,高校的"应用音乐演奏"教授(college professors of applied music performance)各自提供他们在教学中用以引导学生在演奏中获得更佳表现力的"描述性意象"(descriptive imagery)范例;随后这些范例由一组"专家音乐教育工作者"(expert music educators)构成的评审小组进行评估。本段在所提供的文本范围内以介词 “to” 收尾,句子未完整呈现,因此评审小组评估后的具体处理方式(如筛选标准、保留条数、如何改编成本研究指令等)在本节内不可见,需结合原文后续段落补全。
补充说明
本段在所提供的文本范围内不完整,原句以 “to” 结束,未给出评估之后的具体处理。
第4段(P0046)
原文复述
中文讲解
此处为第 4 页的图像或乐谱占位符,原图具体内容(按上下文推断,应为图 1 中两段旋律的乐谱示例)在所提供的文本中已被省略。其在版面中的位置紧接 P0044 对图 1 的引用,意在以可视化方式呈现研究所用的两段旋律。读者若要核对旋律的音符、节奏、调号或拍号等信息,须查阅原始文献的图 1。
补充说明
占位符仅保留位置与图注信息;具体乐谱细节须以原文图 1 为准。
第5段(P0047)
原文复述
Melody 2
中文讲解
此为图 1 内(或紧邻图 1)出现的子标题"Melody 2",用以在图中把第二段旋律与第一段区分开来,对应 P0044 中所提到的 Melody 2——即来自舒伯特《美丽的磨坊女》的旋律。该子标题承担的是图内分段标识的功能,而并非文章中的独立小节标题。
补充说明
本子标题作为图内标签出现,与 P0048 的图注配合使用。
第6段(P0048)
原文复述

中文讲解
此处为图 1 的整体图注:“The two melodies used in the study”(本研究使用的两段旋律)。图注以英文给出,再次明确该图的用途是呈现 P0044 所提及的两段旋律。结合前文,读者可由此将图中内容与 Melody 1(Clarke 与 Baker-Short,1987)和 Melody 2(舒伯特《美丽的磨坊女》)建立对应。图内乐谱数据在所提供的文本中已被省略,需以原图核对。
补充说明
图注内乐谱内容因图像数据省略而无法在本节内核对,需以原图为准。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节范围内的附加材料:第 4 页包含一处图像占位符,并附图注 “Figure 1 The two melodies used in the study.",其作用是直观呈现研究所用的两段旋律;图内另含子标题 “Melody 2”,用以在图 1 内部区分第二段旋律。本节文本范围内无可定位的脚注、边栏或表格说明。
💡 本节核心要点
- 本节标题 ‘Materials and procedure’ 开启了方法部分,承担介绍研究材料与实验程序的功能。
- 研究的音乐材料为两段短旋律,分别源自 Clarke 与 Baker-Short(1987)以及舒伯特《美丽的磨坊女》,两段旋律在 Clarke(1993)与 Woody(2006a)的表现性演奏研究中均有使用先例。
- 研究所用的’意象化描述’指令取自一项既有研究——由应用音乐演奏教授提供示例,再经专家音乐教育工作者评审;评审后的处理在本节文本内未完整呈现。
- 图 1 在版面中承担展示两段旋律的功能,并通过子标题 ‘Melody 2’ 在图内区分第二段旋律,整体图注明确该图呈现的是’本研究使用的两段旋律’。
- 本节通过交代材料来源与既有研究使用记录,把当前研究与表现性演奏方向的前人文献衔接起来。
🔑 关键术语
- expressive performance:表现性演奏,指演奏者在演奏中通过速度、力度、节奏、句法等手段塑造音乐表现力;本节中作为 Melody 1 与 Melody 2 已被前人研究应用的语境。
- imagery-based descriptions:基于意象的描述,指用语言唤起演奏者内心图像或感受,从而引导其获得更具表现力演奏的提示语;本节中作为’表现性指令’的来源。
- Die schöne Müllerin:舒伯特的声乐套曲《美丽的磨坊女》,本研究中 Melody 2 的素材来源。
- Figure 1:本研究中的图 1,用于直观呈现两段旋律;图内附 ‘Melody 2’ 子标题与图注 ‘The two melodies used in the study.’。
S11 [描述性拆分] 两首旋律的意象描述与研究包分发
第1段(P0049)
原文复述
determine the most efective imagery for each melody (Woody 2002). The two descriptions used in the present study were:
中文讲解
这段是上一句的延续(因换页而从段中开始):作者说明他们通过某种方式——引用 Woody 2002 的方法——为每段旋律确定最有效的意象(mental imagery),并将在本研究中使用的两段意象描述引出。括号中的 Woody 2002 是文献引用,提示该意象确定方法有据可循,并非作者随意拟定。冒号之后紧接的两段(即 P0050 与 P0051)就是这两条意象描述。理解本段的关键在于:它把研究方法(如何挑选意象)与材料(具体用哪两条意象)连接起来,起到过渡句的作用。
补充说明
原文拼写为 “efective”(应为 effective),按原文保留。冒号暗示接下来的两条以并列项形式呈现。
第2段(P0050)
原文复述
. Melody 1: Play with sadness and intensity as you would when expressing the loss of a loved one. There’s the bittersweet remembrance of great tenderness and great loss.
中文讲解
本段是研究中第一条意象指令的中文复述与解释:「旋律 1:以悲伤与强度来演奏,就像你在表达失去亲人的那种感受。其中交织着对巨大温柔与巨大丧失的苦乐参半的追忆。」这是一段典型的情感—情景式表演指令:它不规定具体音高、力度或节奏,而是给演奏者/歌者一个可代入的情感模板——哀恸、苦乐参半(bittersweet)。这种意象的功能在于:第一,让表演者迅速锁定统一的情绪基调和强度等级;第二,将抽象的「悲伤」与具体的「失去亲人」经验绑定,避免不同被试把「悲伤」诠释为程度不一的状态;第三,bittersweet 一词同时容纳 tender(温柔)与 loss(丧失)两端,正好提示演奏中力度与表情张力的对比与张力,这往往是研究者希望在该旋律上激发的表演特征。
补充说明
行首的句点是该项目符号化列表的格式残留,说明这是两条意象描述中的第一条。“bittersweet” 一词的双重意味对演奏的表情幅度有引导作用。
第3段(P0051)
原文复述
. Melody 2: Bouncy and happy. Rustic, as if you’re a happy peasant with no cares or worries, strolling along, singing a song.
中文讲解
本段是研究中第二条意象指令:「旋律 2:轻快而欢快。乡土气息,仿佛你是一位无忧无虑的快乐农夫,边走边唱。」它与 Melody 1 形成鲜明的情绪对照——前者内敛、悲伤、强度高,后者外放、欢快、节奏活泼(bouncy)。“bouncy” 在英文表演语境中常指弹性、轻巧且带有上抛感的节奏处理,对应到演奏上意味着更短促的断句、更有弹性的速度与更轻盈的力度。“rustic” 与 “happy peasant strolling along, singing a song” 给出一个具象的角色与动作图景,使被试在节奏律动、身体姿态乃至呼吸上获得一个统一的角色参照,而不仅仅停留在「开心」这一抽象情绪。这两条意象共同确保了两段被试旋律在情绪色彩上的最大反差,使后续任何表演差异都能更明确地归因于意象的影响。
补充说明
行首句点同样是列表格式残留。Rustic + peasant 的设定同时锁定了地域感(乡土)与角色状态(无忧无虑),便于被试稳定地再现一种轻快的步态节奏。
第4段(P0052)
原文复述
With their permission, participants were added to a ‘group’ on the institution’s learning management system (LMS), through which they electronically received the research packet that instructed them how to participate in the procedure in an individual practice session on their own time. Participants were able to choose whether the notation in the research packet would be in treble, bass, or alto clef. The packet instructions encouraged them to perform the melodies in a diferent octave if the melodies were not suited to their instrument or voice as notated; vocalists were instructed to sing the melodies on a neutral syllable of their choice. The research packet was a Microsoft Word document which allowed participants to respond to written prompts by typing directly into the document.
中文讲解
本段说明研究材料的发放与使用方式,应从四个层次理解:
- 发放渠道:经被试同意后,他们被加入所在机构学习管理系统(LMS)的一个「小组」,通过该平台电子化地收到研究材料包(research packet),并被要求在「自己时间的个人练习时段」完成。这一安排体现了远程、非实验室控制的研究设计,强调生态效度(让被试在熟悉的练习情境中演奏)。
- 记谱适配:被试可以自选高音谱号、低音谱号或中音谱号——这是为了让研究材料适应不同乐器或人声音域,避免谱号本身成为演奏的障碍。
- 八度与唱名灵活性:若记谱的八度不适合被试的乐器或人声,鼓励他们改用其他八度演奏;声乐被试被要求用「自己选择的中性音节」演唱(如「da」「la」之类)。这两条规则共同保证:被试的演奏反映的是意象对音乐本身的塑造,而不是被不合适的音域或语言音节所干扰。
- 回应方式:研究材料包是 Microsoft Word 文档,被试可以直接在其中键入对开放式问题的回答,省去了额外数据录入环节,也保留了完整的书面回应。 整体来看,本段交代了「材料如何到达被试手中、被试被允许做什么样的灵活调整、如何回写答案」三个程序细节,目的是让后续的演奏与口述/书写数据可归因于意象变量,而非谱面或工具限制。
补充说明
原文拼写 “diferent”(应为 different)按原文保留。LMS 即 learning management system,文中已自行展开缩写。“neutral syllable” 指不带语义内容、不带具体元音色彩的哼唱用音节,用于排除歌词或语言特征对演唱音色的干扰。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节内无脚注、图表或边栏。P0049 中括号内的 (Woody 2002) 是引文标记,提示意象确定方法的出处,但相关文献细节本节未给出。P0050、P0051 起首的句点为原文项目化列表的格式残留。
💡 本节核心要点
- 作者以 Woody 2002 的方法为两段旋律分别确定了最有效的表演意象,并将其作为研究材料的核心。
- Melody 1 的意象锁定在 ‘悲伤而强烈 + 失去亲人 + 苦乐参半’ 这一情感坐标上,暗示演奏需要强度与张力对比。
- Melody 2 的意象锁定在 ‘轻快、欢快、乡土、无忧无虑的农夫边走边唱’ 这一角色图景上,提示弹性节奏与轻盈音色。
- 两条意象在情绪色彩与表演姿态上形成最大反差,使后续任何表演差异更可能归因于意象而非旋律本身。
- 材料通过机构 LMS 电子发放,允许被试在个人练习时段完成,体现了远程、低干预的研究取向。
- 谱号可自选、允许调整八度、声乐用中性音节、Word 文档直接回写——这些灵活安排共同降低了工具与谱面对演奏的干扰,确保意象成为主要自变量。
🔑 关键术语
- imagery (表演意象):在本节中指给演奏者/歌者的情感或情景提示,用于引导其诠释与表现音乐;本节中具体化为两条分别对应悲伤/苦乐参半与欢快/乡土的角色描述。
- bittersweet:本节用于 Melody 1 的意象词,同时包含 ‘温柔(great tenderness)’ 与 ‘丧失(great loss)’ 两种成分,提示演奏在力度与表情上需要张力对比。
- rustic / happy peasant:本节用于 Melody 2 的意象词与角色设定,提供乡土气与无忧无虑的角色图景,使被试在节奏律动与音色选择上获得统一参照。
- research packet (研究材料包):本节中通过电子方式发放的研究材料合集,含意象指令、乐谱与开放式问题提示;为 Microsoft Word 文档,被试可直接键入回答。
- LMS (learning management system):机构的学习管理系统,本节中用于在获得被试同意后将其加入特定小组并电子分发研究材料包。
- neutral syllable:中性音节,本节规定声乐被试自选一个不带语义内容的哼唱音节(如 da、la),用于排除具体元音或歌词对音色与发音的干扰。
S12 [描述性拆分] 研究包第一页指令
第1段(P0053)
原文复述
The first page of the packet performed the following actions.
中文讲解
这句是引领句,用来引出后面编号列表的内容。它本身不携带实质信息,只承担结构提示的功能:告诉读者接下来要按顺序列出研究包第一页所承担的若干任务。理解了这一点,就不会把它误读为对第一页内容的概述。
补充说明
本句在原文中独立成段,仅作为下文编号列表的引子,不含其他可补充的细节。
第2段(P0054)
原文复述
(1) It instructed participants to conduct the procedure by themselves and at the start of a practice session (or following a warm-up).
中文讲解
第一条指令锁定两个关键变量:一个是"alone”(独自进行),另一个是时机——“at the beginning of a practice session"或热身之后。“alone"是为了排除同伴或教师在场的暗示效应,保证后续录像与文字记录的独立性;指定"练习开始时或热身之后"则是为了控制生理与心理状态,避免练习疲劳或已经形成的演奏习惯污染数据。括号中的"or after warming up"是对前者的同义补充,把刚结束热身这种现实中常见的练习起点也纳入可接受范围。
第3段(P0055)
原文复述
(2) It displayed the two melodies in an unmarked musical expressive notation (as shown in Figure 1) and asked participants to rehearse the melodies until they had correctly mastered all pitches and rhythms (vocalists being permitted to use a piano for pitch assistance).
中文讲解
这条指令包含两层动作与一个例外限定。核心动作一是把两段旋律以"unmarked music expressive notation”(无标注表情记号的乐谱)呈现,意即不附带力度、速度、连线、踏板等任何演奏提示的"裸谱”;这样做是为了把后续页面中由"音乐教师"给出的表情指导塑造成唯一的表情信息源,使表情改变可以干净地归因于实验干预。核心动作二是要求参与者先学对所有音高与节奏,这是在把基线建立为"音准与节奏正确但无表情"的状态。括号里的例外承认歌唱者不像器乐演奏者那样可以直接校准音高,因此允许借助钢琴辅助,体现了研究设计对不同乐器背景参与者的现实包容。
补充说明
文中提到"as appearing in Figure 1",但Figure 1的图像本身并未包含在本小节文本中,读者需结合原图查看乐谱的具体面貌。
第4段(P0056)
原文复述
(3) It required participants to use a smartphone, tablet, or laptop to video-record themselves playing both melodies in a ’normal musical way, without doing anything special’, and to save the recording.
中文讲解
第三条指令确立了录像基线。设备要求(智能手机、平板或笔记本电脑)是为了降低参与门槛,避免因缺乏专业录音条件而被排除。真正重要的是"normal musical way, without doing anything special"这一限定:它实质上把这次录音的功能界定为对照样本,而非表演展示。若没有这条说明,参与者面对镜头时可能会本能地加入表情处理,从而与后续在表情指导下的演奏录像无法构成有效对比。“save the recording"则为后续可能进行的回看与对比保留材料。
第5段(P0057)
原文复述
(4) It offered a preview of the content on the following pages, specifically stating: ‘Each page presents one of these melodies, accompanied by a music teacher’s instructions for making your performance of the melody more expressive. After seeing the melody and its expressive instructions, there are step-by-step directions that guide you through practicing the melody and writing down what you are thinking about as you do it’.
中文讲解
第四条是面向参与者的流程预告。它揭示了整份研究包的三段式结构:先呈现一段旋律并附上音乐教师的表情指导(experiment treatment),再给出分步骤的练习指引(practice scaffold),最后引导参与者把练习过程中的想法写下来(reflection capture)。其中"writing down what you are thinking about"是整个数据采集的关键一环,说明研究不仅收集演奏行为(录像),也收集内省性的语言记录,属于典型的混合方法设计。预告的存在本身也具有方法学意义:它降低了参与者面对陌生材料时的认知不确定性,使后续任务负荷更可控。
补充说明
原文引号内为作者直接引用研究包第一页面向参与者的话,措辞上保留了第一人称(“your performance”、“you”),在转述时需注意这一面向受试者的语域。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节中P0055引用了Figure 1,但原图未包含在本节文本范围内,仅作为参照被提及;若需核对乐谱,需查看原文中Figure 1的具体位置。本小节无脚注、无边栏、无其他图表说明。
💡 本节核心要点
- 第一页通过四条递进式指令分别规定了实践时机、谱面状态、录像基线和后续流程预告,构成本研究的起点程序。
- 旋律以无标注表情记号呈现、并先要求学对音高与节奏,是为了把后续表情指导的效果从基线演奏中干净地分离出来。
- 录像要求中特别强调"normal musical way, without doing anything special”,这是为后续表情指导下的演奏提供可比较的对照样本。
- 流程预告揭示了研究为混合方法设计:既采集演奏行为视频,也采集参与者在练习过程中的反思性文字记录。
- 对歌唱者允许借助钢琴确认音高,体现了研究在控制基线的同时对不同乐器背景参与者的实际包容。
🔑 关键术语
- unmarked music expressive notation:无标注表情记号的乐谱,指不附带力度、速度、连线、踏板等演奏提示的"裸谱",目的是使后续表情指导成为唯一的表情信息源,以便对其效果进行归因。
- normal musical way, without doing anything special:以正常的、不做任何特别处理的方式演奏,是研究者对基线录像设定的限定语,用以保证录像可作为表情干预前后的对照样本。
- step-by-step directions:逐步操作指引,指后续页面中引导参与者分步骤练习旋律并同步写下思考的详细指令,是研究采集反思性数据的过程支架。
S13 [描述性拆分] 研究包第二、三页意象练习与记录流程
第1段(P0058)
原文复述
The second and third pages of the research packet each contained one of the melodies and its imagery example, presented as a music teacher’s instructions for making a performance of the melody expressive. Below the notated melody, each page contained step-by-step instructions for reading and considering the imagery example, practicing the melody in light of the expressive instructions, and giving a final performance. More specifically, participants reported their thought processes at three points while working with each melody, responding to the prompts:
中文讲解
本段交代了研究包第二、三页的整体结构与流程,是接下来三条编号提示(5、6、7)的引子。要点有四。第一,研究者没有把意象例子作为孤立材料抛出,而是把它包装成"音乐教师关于如何使演奏富有表现力的指导"——这种包装方式赋予了意象一个具体的演奏目的,参与者不是在做抽象联想,而是在用意象作为塑造演奏的工具。第二,每页在乐谱下方有"逐步操作说明",它把活动切成三步:阅读并思考意象例子 → 依据表现力指导练习旋律 → 给出最终演奏,这是一个清晰、可重复的操作链。第三,“在三个时点报告思维过程"是这套材料的核心数据收集策略,时点由本段引出、具体内容由后面三条提示承担。第四,“thought processes"这个词值得注意——研究者关心的是认知层面的内容,而不只是行为或结果,因此后面才会让参与者用第一人称口语化地讲述自己在想什么。
第2段(P0059)
原文复述
- After reading the teacher’s expressive instructions to improve the performance of the melody: ‘What are you thinking about as you prepare to perform the melody?’
中文讲解
这是三时点报告中的第一个,发生在参与者刚读完教师意象化表现力指导、尚未实际演奏之前。提示语使用现在进行时(“are you thinking about”)和动词"prepare”,对应的是预期、计划阶段的认知——研究者想捕捉的是演奏开始前参与者激活了什么样的心理内容:是意象本身、技术安排、解释意图,还是其他杂念。由于这是演奏之前的瞬间,这份回答相当于"基线”,可以与后续演奏过程中的思维内容做对比,看预期与实际是否一致。
第3段(P0060)
原文复述
- After first performing the melody in light of the teacher’s expressive instructions: ‘What did you think about as you first performed this melody?’
中文讲解
这是三时点报告中的第二个,安排在参与者首次按教师意象指导演奏完旋律之后。提示语改用过去时(“did you think about”),问的是演奏过程中同步发生的思维,目的是看准备阶段的预期在真实演奏中是否兑现、是否偏移。需要特别留意"first"这个词:它把这次回答与后续反复练习区分开,使研究者能够对比"首次尝试"与"经过多次练习"时思维内容的差异——意象是否被坚持使用?是否在首次演奏后被放弃或调整?这是研究"意象在演奏中的实际作用"的关键证据来源。
第4段(P0061)
原文复述
- After practicing the melody – as many times as needed – to work up their best expressive performance of it: ‘As you practiced the melody, what did you think about?’
中文讲解
这是三时点报告中的第三个,安排在练习阶段结束之后。三个细节值得说明。其一,“as many times as needed"表明练习次数由参与者自主决定,研究者没有硬性规定几次,这是一种自我节奏设计,让"表现力提升"以参与者自身的判断为准。其二,练习的终点被定义为"best expressive performance”——强调表现力质量,而非技术准确度,这和研究的核心关切一致。其三,提示语用现在时(“As you practiced”)回顾整个练习过程,让参与者报告的是贯穿多次重复的思维轨迹,而不是某一瞬间的快照。与前两条提示合在一起,三时点形成了一个发展性时间轴:准备期 → 首次执行 → 持续练习,看意象化思维如何在重复演奏中被维持、修改或舍弃。
第5段(P0062)
原文复述
Each melody page of the packet also prompted participants to report the number of times they practiced the melody and to indicate how effective they thought the teacher’s instructions were in making their performance of this melody expressive. The final instruction at the bottom of each melody page was ‘Now, video record your best expressive performance of this melody, and save the recording’.
中文讲解
本段在思维过程报告之外补了两项量化/自评材料,并交代了每页的最终动作。第一,“练习次数"是可计量的行为指标,可与思维内容做相关分析,回答"投入更多练习的参与者,思维报告是否有所不同"这类问题。第二,“教师指导是否有效"是参与者层面的元认知评价,捕捉的是他们主观上认为意象指导是否帮到了自己——这与外部评分者的表现力判断形成内、外两类评价的对照。第三,页面底部的最终指令要求参与者录像保存"最佳表现性演奏”,这一动作的意义在于:研究者拿到的不只是参与者的口头报告,还有一个可被评分者事后独立评定表现力的外部演奏样本,从而把"参与者说自己在想什么"与"演奏听起来如何"联系起来。“save the recording"一词说明录像被留存用于分析,而不是走个过场。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节片段中未出现脚注、图表或边栏。编号提示以 5、6、7 起头,说明这是某条提示序列的延续,编号 1–4 应出现在研究包的更前面页面(不在本节范围)。
💡 本节核心要点
- 研究包第二、三页把"意象例子"包装为"音乐教师关于如何使演奏富有表现力的指导”,赋予意象明确的演奏目的,避免参与者做无目的联想。
- 每页结构分三层:乐谱与意象输入、逐步操作步骤、三个时点的思维过程提示,配合页面底部的录像指令形成完整流程。
- 三个思维报告时点构成时间序列——准备期(演奏前)、首次演奏后、反复练习后——用于追踪意象化思维在准备、执行、重复三阶段的演变。
- 练习设计为自我节奏:参与者自行决定重复次数,达标点定义为"最佳表现性演奏”,强调表现力质量而非技术准确度。
- 每页同时收集量化/元认知数据(练习次数、对指导有效性的自评)与质性数据(思维过程口语报告),并以录像形式留下可被外部评分者独立评级的演奏样本,形成"内省—行为—表现"三重证据。
🔑 关键术语
- imagery example:与每条旋律配对的意象材料;在本节中它不是抽象刺激,而是被设计为教师的演奏指导,用以引导表现性演奏。
- expressive instructions:教师层面、以意象为载体、用于指导演奏者如何使演奏富有表现力的指引;构成意象与演奏之间的桥梁。
- thought processes:参与者在准备、首次演奏、练习三个时点所报告的内部思考内容;是本节数据收集的核心对象。
- best expressive performance:练习的目标终点,以表现力质量而非纯技术准确度为衡量标准,由参与者自行判断是否达到。
- video record:在练习结束后对"最佳表现性演奏"进行视频保存的最终动作,目的是为研究者留下可供外部评分者评级的演奏样本。
S14 [描述性拆分] 研究包第四页提交与表现录音收集
第1段(P0063)
原文复述
The fourth page of the packet, which was also marked as the final page, instructed participants first to save the document containing the responses they had typed in. It then told them to submit, on the LMS, both that document and the video recordings they had produced.
中文讲解
本段说明的是研究包最后一页(即第四页)所给出的操作指令,其作用是收尾而非引入新的研究内容。这一页对参与者提出了两项连续动作:第一,先保存包含其键入作答内容的文档;第二,把该文档连同参与者录制的视频一并通过 LMS 提交给研究者。换言之,前几页分别采集了文本形式的回答与表现形式的视频,本页则把这两类材料统一汇总并发出,由此构成整个研究材料链的闭环。从研究者材料设计的角度看,此处隐含两个判断:其一,文字反应与视频表现被视为同等重要的产出,因此被要求在同一提交动作中一并上交;其二,提交被集中到 LMS 这一既有平台,便于研究者归档与后续处理。理解本段的关键不在于页面上的具体提问,而在于它点明了参与者在完成研究后必须执行的最后两步——保存与提交——以及提交的内容范围与提交渠道。
补充说明
LMS 在本节语境中即原文出现的 LMS,结合 ‘submit … on the LMS’ 的表述可理解为机构内部用于收取作业或研究材料的在线平台;该缩写本身在本段未给出展开释义,故不补充外部信息。
💡 本节核心要点
- 研究包第四页是最后一页,其功能是收尾而不是新增研究刺激或问题。
- 该页对参与者给出两项连续操作:先保存包含键入回答的文档,再通过 LMS 提交。
- 提交的材料包含两类:参与者键入作答的电子文档与其录制的视频。
- 把文本作答与视频表现集中提交,提示研究同时关注文字反应与表现反应两类数据。
- 借助 LMS 统一提交,便于研究者集中归档与后续分析。
🔑 关键术语
- LMS:在本节中指参与者用于提交文档与视频的在线平台(学习管理系统);仅依据原文 ‘submit the document and their video recordings on the LMS’ 的语境确认,不补充外部信息。
- packet:在本节中指由研究者分发给参与者、包含多页操作指引与题目的整套研究材料;本段所涉为其第四页(也是最后一页),承担保存与提交两项收尾指令。
S15 [描述性拆分] ## Data analysis
第1段(P0064)
原文复述
Data analysis
中文讲解
本段为小节标题“Data analysis”(数据分析),用于引出作者对表现性演奏数据所采用的处理方式,包括音频提取、评分流程与评分者一致性检验等。该标题标志着方法部分从“参与者”“材料”等描述转向实证数据处理阶段。
第2段(P0065)
原文复述
To analyse expressive performance data, we extracted the audio from the participants’ video recordings of their performances. Because each participant musician produced two performances for each melody – one before receiving the expressive instruction and one after – each musician contributed four performances: a pretest performance of Melody 1, a pretest performance of Melody 2, a posttest performance of Melody 1 and a posttest performance of Melody 2.
中文讲解
本段说明了数据分析的素材来源及其结构。研究者从参与者演奏的视频录像中提取音频,这样做的好处是在保留演奏动作的同时,把后续评分的工作对象限定在音频上,便于盲听与控制。关键信息是每位参与者对每首旋律都演奏了两次——一次在接受表现性指导之前(pretest),一次在之后(posttest),因此每位参与者共贡献四次演奏:Melody 1 的前测、Melody 2 的前测、Melody 1 的后测、Melody 2 的后测。这种“旋律 × 教学时机”的 2×2 设计是后文所有比较(教学前后的变化、两条旋律之间的一致性等)的统计基础。需要注意的是,作者在此段只交代了演奏产出的结构,并未涉及评分者或具体评分工具。
第3段(P0066)
原文复述
The rating of performance expressiveness was accomplished using a panel of five judges, each of whom was a music educator with at least one graduate degree in music education and experience serving as an adjudicator for music festivals or contests. Each judge listened to the audio recording of all 96 participant performances, i.e. 24 participants × 2 melodies × 2 performances (both a pretest and posttest condition). The presentation order of the 96 performances was randomised for each judge and their rating was completed over four different administration times to avoid listening fatigue. The judges were instructed to rate each performance independently (not compared to one another) and because they did not know whether a heard performance was from a pretest or posttest condition, each performance was evaluated for expressiveness on its own. Judges rated each performance by choosing a location on a 100-point horizontal line, anchored on the left by ‘Not Expressive’ and on the right by ‘Very Expressive’. Thus, each judge’s work produced an expressiveness rating, on a possible range of 0–100, for each participant’s performance.
中文讲解
本段交代了“表现性”这一因变量的具体测量方式。要点有四:
- 评分者构成与资质:五人组成的评分小组,每人均为音乐教育者,至少拥有一个音乐教育研究生学位,并具有在音乐节或比赛中担任评审的经验。这一资质要求是为了保证“表现性”这一概念由具备专业判断力的人来界定,而非外行的主观印象。
- 评分工作量与构成:每位评分者需听完全部 96 段演奏,即 24 位参与者 × 2 首旋律 × 2 次演奏(前测与后测)。这一数字与上一段每位参与者四次演奏的结构相对应(24 × 4 = 96),是前后两段的衔接之处。
- 控制偏差的程序:(a) 96 段演奏的呈现顺序对每位评分者均单独随机化,以避免顺序效应;(b) 评分分四个不同时间点进行,以避免长时间听音造成的疲劳;(c) 评分者不知道所听演奏属于前测还是后测,使评分对教学条件保持盲法;(d) 评分者被要求对每段演奏独立评分(不与其他演奏做比较),从而每次评分都基于该演奏本身。
- 评分工具:使用一条 100 点的水平线,左端标注 “Not Expressive”,右端标注 “Very Expressive”,评分者在其上选取位置,每位评分者对每段演奏产出一个 0–100 范围内的表现性评分。这种“视觉模拟量表(VAS)”式评分比 Likert 五点或七点量表更细,且仍是连续型数据,便于后续做相关与方差分析。
综上,本段不仅说明了“谁来评”“评什么”,还说明了研究者为了保证评分有效性而采取的多重控制。
第4段(P0067)
原文复述
Table 1 shows the correlation matrix between the five judges’ expressiveness ratings. As shown in the table, judges’ ratings were well correlated with each other, with no two judges’ ratings having a correlation lower than r = .5. Analyses of participant expressive performance used the average rating across all five judges.
中文讲解
本段交代评分者一致性检验及由此得到的分析单元。Table 1 呈现了五位评分者表现性评分的相关矩阵:作者报告所有评分者两两之间的相关系数均不低于 r = .5,说明五位评分者对“表现性”的判断方向一致且关联较强。这是对评分者间信度(inter-rater reliability)的一种表述,满足了将五人评分合并为单一指标的前提。
在确认评分者之间具有可接受的一致性之后,作者决定在后续分析中使用五位评分者的平均评分作为每位参与者每次演奏的表现性分数。这一做法的作用有两层:(1) 通过平均降低个别评分者的随机误差;(2) 把数据从“5 人 × 96 段”压缩为“1 个综合分数 × 96 段”,便于后续对教学前测–后测变化进行统计检验。
因此本段是上一段评分程序的“收束”:它告诉读者,评分并不是孤立的五个分数直接进入分析,而是先经过一致性验证,再合成一个聚合指标。
补充说明
“correlation matrix”(相关矩阵)在此特指评分者两两配对后的 Pearson 相关系数所组成的方阵,用于评估评分者间信度;r = .5 是作者给出的最低成对相关阈值,意味着不存在低于该值的评分者配对。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节包含一处表格占位:Table 1(评分者表现性评分相关矩阵)。该表位于第 7 段(P0067)所引之处,其作用是支撑“五位评分者评分高度一致”这一主张,进而为将五人评分取平均提供依据。表本身的具体数值需查阅原图。
💡 本节核心要点
- 小节阐明表现性演奏数据来自参与者演奏视频中的音频,每位参与者贡献 2 首旋律 × 前测/后测 = 4 次演奏。
- 表现性评分由 5 位具备研究生学历与评审经验的音乐教育者完成,每人需听完全部 96 段演奏。
- 评分流程通过顺序随机化、分四次施测、前后测盲法、独立评分以及 0–100 视觉模拟量表,控制了顺序、疲劳、条件知晓与量表粒度等潜在偏差。
- Table 1 显示五位评分者两两相关系数均不低于 r = .5,表明评分者间一致性良好,因此每位演奏的表现性分数取五人评分的均值用于后续分析。
🔑 关键术语
- pretest / posttest performance:前测/后测演奏,分别指参与者在接受表现性指导之前与之后对同一旋律的演奏,用于比较教学效果。
- inter-rater reliability:评分者间信度,指不同评分者对同一对象评分的一致程度;本节通过 Table 1 的两两相关(均 ≥ r = .5)加以体现。
- 100-point horizontal line (visual analogue scale):100 点水平线(视觉模拟量表),左端 “Not Expressive”、右端 “Very Expressive”,评分者在线上选点得到 0–100 之间的连续评分。
- correlation matrix:相关矩阵,由若干变量两两之间的相关系数组成的方阵;此处指五位评分者评分之间的 Pearson 相关矩阵。
- average rating across all five judges:五位评分者的平均评分,作为每位参与者每次演奏表现性的聚合指标进入后续统计分析。
S16 [描述性拆分] 认知翻译过程编码与评分者信度
第1段(P0068)
原文复述
To analyse participants’ cognitive processes while preparing their expressive performances, the researchers first extracted participants’ typed-in responses describing their thought processes from the documents they had submitted. This text was stored with non-identifying participant codes so that coding could proceed more objectively. Using the same coding scheme as Woody (2006a), participants’ responses to questions about their thinking were coded according to the degree to which their reported thought processes reflected translating the given imagery instruction into plans for musical properties in their own performance. To do this, the authors developed a coding guide in which the coder answered three yes/no questions about whether a musician’s reported thoughts: mentioned specific musical elements (e.g. articulation, dynamics/loudness, tempo); used descriptive adjectives for musical elements versus feelings/emotions; and reiterated or developed the original imagery example (see Table 2). The coding produced a four-level score, so that a value of 0–3 was assigned to a participant’s thoughts for each melody. With two melodies and 24 participants, a total of 48 thought-process responses were available for coding. One member of the research team served as
中文讲解
本段交代研究方法的第一步:如何把参与者口中/笔下的"想法"转化为可量化打分。
-
数据来源:研究者从参与者提交的文档中提取出他们打出的、关于思维过程的回答(即被试对"你在想什么"这类问题的自陈文字),并用去标识化的编号保存,以保证编码者的判断尽可能客观、不被身份信息干扰。
-
编码框架的来源:直接借用 Woody (2006a) 的编码方案。Woody 早期研究关注的是演奏者如何把意象(imagery)这种非音乐信息"翻译"成可操作的演奏参数,本研究延续这一思路。
-
核心评判标准:编码所衡量的,是被试的思维过程在多大程度上体现了"把给出的意象指令翻译成自己演奏中的音乐属性计划"。换言之,编码者要判断的是:被试说的那些话,是在做"意象→音乐参数"的转换,还是只停留在意象本身、或泛泛而谈感受。
-
三个是/否问题(Yes-No Questions):为了把这个抽象标准操作化,编码者就每位被试的思维回答依次判断三个问题——
- 是否提到了具体的音乐元素(articulation 咬字/运音、dynamics/loudness 强弱、tempo 速度等);
- 是否使用了描述音乐元素的形容词,而非仅描述感受/情绪(这是为了区分"音乐性思维"和"情绪性思维");
- 是否对原始意象例子进行了复述或进一步发展(说明被试真正在加工那个意象,而非忽略或替换)。
-
0–3 分的形成逻辑:三个问题各自为 0 或 1,加总后恰好得到 0、1、2、3 共四个等级(four-level scoring),所以每首旋律的"思维过程"得到一个 0–3 的整数分数,分数越高代表"认知翻译"做得越深。
-
样本量:每位被试处理两条旋律,24 位被试 × 2 条旋律 = 48 个思维回答需要编码。
-
与下段的衔接:本段末尾"One member of our research team served as"是断句,引出下一段的"Coder 1 and coded all responses"。说明这 48 份回答将由团队中一名成员担任主编码者进行打分。
本段在全节中的功能:交代"认知翻译"这个变量的产生方式——把质性文字回答通过三题 0/1 评分量化成 0–3 的整数分数,为后续的相关分析提供因变量型数据。
补充说明
Table 2 在原文中被引用,用以呈现完整的编码指南(包括三个是/否问题的具体判定细则),但其内容不在本节输入范围内,故此处不展开。三个是/否问题的设计体现了对"认知翻译"概念的三维度操作化:音乐元素识别、形容词 vs. 感受的区分、意象的复述/发展。
第2段(P0069)
原文复述
Coder 1 and coded all responses using the coding scheme. To establish the reliability of the coding process, 30% of the responses were randomly selected for coding by a second coder, another member of the research team. With these 15 responses, each coded on the three yes-no questions, there were 45 points of comparison. Interrater reliability between the first and second coder was 97.82%. Cohen’s kappa coefficient indicated a very good strength of agreement, κ = .954. Coder 1’s scoring of all responses served as the ‘cognitive translation index’ (CTI), the term suggested by Woody (2006a).
中文讲解
本段紧接上段,交代编码的执行者、信度检验过程,以及最终变量的命名。
-
主编码者(Coder 1):研究团队中的一名成员担任 Coder 1,对全部 48 份回答独立编码。
-
信度检验的设计:随机抽取 30% 的回答(48 × 30% ≈ 14.4,实取 15 份)交给团队中的另一名成员(Coder 2)独立编码。这一步骤的目的不是检验结果,而是检验"打分过程本身"是否稳定可重复——不同人按同一标准打出的分数是否一致。
-
45 个比较点的由来:15 份回答 × 每份回答的 3 个是/否问题 = 45 个独立的判断点。信度统计以这 45 个点为基本单元计算。
-
两项信度指标:
- 一致率(Interrater reliability)= 97.82%,即 45 个判断点中两位编码者答案相同的比例;
- Cohen’s κ(kappa 系数)= .954。kappa 在一致率基础上扣除了"碰巧猜对"的概率,.954 在心理学/行为科学领域通常被解读为"非常好"(very good)的一致性,远高于 .75 的常用可接受门槛。
- 同时报告百分比一致率和 kappa,是为了让读者既能直观感受一致性,又能确认这种一致不是偶然。
-
“认知翻译指数(CTI)“的命名:所有 48 份回答最终只采用 Coder 1 的得分,作为每位被试在每首旋律上的认知翻译指数(Cognitive Translation Index, CTI)。这一术语沿用 Woody (2006a) 的命名,意味着本研究在概念层面完全承袭 Woody:把演奏者把意象"翻译"成演奏计划的认知加工深度,用 0–3 这个量化指标来代表。
本段在全节中的功能:为上段建立的编码方案提供信度证据,并把这个 0–3 的整数分数正式命名为 CTI,使其成为后续统计分析中可直接使用的因变量型变量。
补充说明
Cohen’s κ = .954 在常用 Landis & Koch 等级中位于 “almost perfect” 区间(> .81),但本文作者采用 “very good” 的措辞,应以原文表述为准。30% 抽样是行为科学编码信度研究中常见的比例,兼顾统计可行性与代表性。
💡 本节核心要点
🔑 关键术语
- Cognitive translation index (CTI) / 认知翻译指数:本研究的核心因变量型指标。由 Coder 1 对每位参与者在每条旋律上的思维回答进行 0–3 编码后得到,代表演奏者把意象指令翻译成具体演奏计划这一认知加工的深度;术语及概念均沿用 Woody (2006a)。
- Coding scheme / 编码方案:指 Woody (2006a) 提出的、用于评判"思维过程是否体现意象→音乐属性翻译"的标准化打分框架。本研究完整沿用,并通过三个是/否问题将其操作化。
- Imagery instruction / 意象指令:实验中提供给参与者的非音乐提示(如文字意象),要求其据此准备演奏。本研究关注的是被试如何把这种意象转译为演奏层面的音乐参数。
- Interrater reliability / 评分者一致性:两位编码者对同一批材料独立打分后的一致程度。本研究通过百分比一致率(97.82%)和 Cohen’s κ(.954)双重报告来衡量。
- Cohen’s kappa (κ) / Cohen 一致性系数:在两位评分者都做二元(是/否)判断时,对一致率进行"机遇校正"后的统计量;取值越接近 1 表示排除偶然后的一致性越强。本研究 κ = .954,作者描述为 “very good strength of agreement”。
- Three yes-no questions / 三个是/否问题:编码指南中的三项判定:是否提及具体音乐元素、是否使用音乐性形容词(而非仅描述情绪)、是否对原意象进行复述或发展;每题 0 或 1,加总构成 0–3 的 CTI 分数。
S17 [描述性拆分] 非参数统计方法的选用理由
第1段(P0070)
原文复述
For the statistical analyses we carried out to test for differences in measures and with tests that divided our sample into smaller groups, we used nonparametric statistics. Nonparametric tests are better suited for small sample sizes and with those for which it is difficult to establish a normal distribution and homogeneity of variance. Also, because nonparametric statistics are based on fewer assumptions, they are understood to better handle variables that have used novel measurement instruments (and may come with some imprecision). Admittedly, nonparametric statistics are thought to be less powerful than their parametric analogues, but this may only be the case with normal probability distributions (Zimmerman and Zumbo 2014).
中文讲解
【中文译文】在我们所开展的、用以检验各测量指标差异的统计分析中——尤其是那些将样本进一步拆分为更小子组的检验——我们采用了非参数统计方法。非参数检验更适用于样本量较小、以及难以确认其数据符合正态分布与方差齐性的情况。此外,由于非参数统计所依赖的假设更少,因而一般被认为更能妥善处理那些使用了新型测量工具(并因而可能带有一定测量误差)的变量。诚然,非参数统计通常被认为效力低于其对应的参数版本,但这种效力劣势可能只有在数据服从正态概率分布时才会真正显现(Zimmerman and Zumbo 2014)。
【教学性精讲】本段是方法学说明中的一段"方法选择理由”(methodological justification),作者在此集中回答一个审稿人或读者最常追问的问题:你们为什么不直接用更常见的参数检验(如独立样本 t 检验、ANOVA)?作者给出的理由可以拆成三个层次:
-
数据层面的客观限制:样本量较小,且难以确认正态分布与方差齐性这两个参数检验的前提。在小样本中,对正态性的检验本身效力就很低,强行套用参数检验反而风险更大;非参数检验恰好绕开了这一陷阱。
-
测量层面的预防性考虑:当变量来自"新型测量工具"时,作者用括号补充了"可能带有一定误差”——这是一种谨慎表态:与其假定新工具的测量精度与经典工具等价,不如采用假设更少、对异常值与轻微分布偏离更稳健的方法。这是一种"防御性统计策略"。
-
对潜在批评的预先回应:作者坦承非参数检验通常被认为"统计效力较低"(less powerful),这是学界公认的传统观点。但随即用 “may only be the case with normal probability distributions” 进行了关键限定,并引用 Zimmerman and Zumbo (2014) 作为佐证——其论点是:当数据本身就不满足正态分布时,非参数检验的实际效力未必低于参数检验。换言之,作者承认通则,但主张在自己的数据情境下,该弱点并不构成实质问题。
整段的论证策略是"先立后破":先说明非参数检验在本研究情境下的合理性,再主动承认其一般性弱点并通过限定条件予以化解,从而让方法选择显得既贴合数据特征,又经过批判性反思。
补充说明
本段中的脚注/引文(Zimmerman and Zumbo 2014)在原文中以括注形式给出,作用是为"非参数检验在非正态情境下未必效力更低"这一限定主张提供文献支撑,属于旁证型引用,而非数据来源。括号内 “may come with some imprecision” 是作者对"新型测量工具"风险的主动声明,提示读者后续测量学指标的解释应保持审慎。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节仅含一段方法学说明性正文 P0070,内含一处对 Zimmerman and Zumbo (2014) 的括注式引用,用于支撑作者关于非参数检验效力条件的限定论断,无独立的脚注、图表或边栏。
💡 本节核心要点
- 作者选择非参数统计的根本原因是数据特征(小样本、难以确认正态性与方差齐性)而非单纯的统计偏好。
- 作者进一步以"新型测量工具可能带有误差"为依据,强化了非参数方法在低假设条件下更稳健的理由。
- 作者主动承认非参数检验的传统弱点(统计效力较低),但通过限定条件(仅在正态分布情境下成立)和文献支持(Zimmerman and Zumbo 2014)化解了这一批评。
- 整段采用了"先建立合理性、再回应潜在批评"的论证结构,是研究方法部分常见的防御性写作策略。
🔑 关键术语
- nonparametric statistics(非参数统计):不依赖数据服从特定概率分布(如正态分布)的一类统计检验方法,本研究中用于在小样本、分布不明及使用新型测量工具的情境下检验组间差异。
- homogeneity of variance(方差齐性):参数检验(如 ANOVA、t 检验)的关键前提之一,要求各比较组的总体方差相等;在小样本中难以验证,因此作者转向非参数检验以规避此假设。
- statistical power(统计效力):指在真实存在效应时检验能够检出该效应的概率;非参数检验通常被认为效力低于其参数对应版本,但作者借助 Zimmerman and Zumbo (2014) 指出该劣势主要在正态分布下成立。
- Zimmerman and Zumbo (2014):本段括注中引用的文献,用于支撑"非参数检验在非正态情境下未必效力更低"的限定主张,在本节中作为旁证出现。
S18 [描述性拆分] ## Results 与 ## Expressive performance
第1段(P0071)
原文复述
Results(二级章节标题,标志着论文由研究方法过渡到结果报告部分)。
中文讲解
这是一个二级章节标题,原文为英文"Results",意为"结果"。它开启了论文的Results章节,将叙述从研究设计(方法部分)切换到对实验数据的呈现与统计推断。在论文结构中,Results章节通常承载作者对核心假设的实证检验,是随后Discussion(讨论)部分的前置环节。
第2段(P0072)
原文复述
Expressive performance(三级小节标题,位于Results章节之下,聚焦演奏表现力相关的实验结果)。
中文讲解
这是一个三级小节标题,原文为英文"Expressive performance",意为"演奏表现力"。它位于Results章节之下,预示作者将集中报告与"演奏表现力"这一因变量有关的结果。读者由此知道:本小节围绕参与者演奏表现力的评分变化展开,而非音准、节奏、记忆等其他表现维度。
第3段(P0073)
原文复述
A summary of the participants’ performance expressiveness ratings is shown in Table 3. With both melodies, the performance expressiveness increased after participants received the imagery-based instruction and practiced in light of it. The performance improvement with Melody 1 (an average gain of over 30 points on the 100-point rating scale) was greater than that of Melody 2 (average gain of 9.4). The improvement was, however, statistically significant with both Melody 1, pretest M = 34.5, posttest M = 68.2, paired-sample Wilcoxon test Z = -4.29, p < .001, and Melody 2, pretest M = 38.2, posttest M = 47.6, paired-sample Wilcoxon test Z = -3.49, p < .001. In general, this finding suggests that the imagery-based instructions were efective in producing improved expressive performance among the musicians in the sample.
中文讲解
本段是本小节的核心段落,报告了意象训练对演奏表现力的实证结果,可分四层来理解。
第一层是描述统计。作者指出参与者表现力评分的汇总见表3,并对两条旋律分别报告了前测—后测均值:Melody 1 由 34.5 升至 68.2,Melody 2 由 38.2 升至 47.6。两条旋律的均值方向都呈上升。
第二层是效应大小对比。作者特别强调 Melody 1 的平均增益超过 30 分(68.2 − 34.5 = 33.7,与原文"over 30 points"一致),而 Melody 2 的平均增益为 9.4 分(47.6 − 38.2 = 9.4)。也就是说,两条旋律虽然方向都向上,但提升幅度差距显著:Melody 1 的增益约为 Melody 2 的 3 倍以上。
第三层是统计推断。两条旋律各自采用配对样本 Wilcoxon 检验——一种用于成对样本的非参数检验,原文以 Z 统计量与 p 值报告:Melody 1 的 Z = −4.29,p < .001;Melody 2 的 Z = −3.49,p < .001。Z 为负反映差值方向使统计量取负,但此处更关键的是 p 值均小于 .001,说明两种情况下前后测差异都高度显著,即使在 Melody 2 这样较小的增益上也拒绝"无差异"的零假设。
第四层是作者结论。作者据此判断:基于意象(imagery-based)的教学对样本中音乐家提升演奏表现力是有效的。
本段在小节论证中承担"方向一致 → 效应大小悬殊 → 但两者均统计显著 → 结论仍成立"的标准实证报告结构。容易产生的误读是把"两条都显著"等同于"两条提升幅度相当"——作者专门用转折词"however"引出统计显著性,正是为了在两条效应量差异悬殊的情况下强调结论依然成立。
补充说明
段末"efective"为原文中的拼写形式(疑为"effective"的录入或OCR错误,本处忠实保留)。原文中统计学符号采用 LaTeX 排版呈现,本复述已将其转写为常规形式,数字与p值本身未作改动。表3的具体数值未出现在本节正文中,读者需查阅原表以获得完整描述统计。
脚注 / 边栏 / 图表 / 附加信息(如有)
段落P0073中提及Table 3汇总评分数据,但表3的具体内容不在本节文字范围内,需查阅原图以获取完整描述统计与分布信息。本节无脚注。
💡 本节核心要点
- 本节是Results下的Expressive performance子节,集中报告意象训练对演奏表现力的影响结果。
- 两条旋律在前后测均值上都呈上升方向:Melody 1 由 34.5 升至 68.2,Melody 2 由 38.2 升至 47.6。
- Melody 1 的平均增益超过30分,远大于 Melody 2 的9.4分,提升幅度存在显著差距。
- 两条旋律在配对样本 Wilcoxon 检验下均达到 p < .001 的统计显著性水平。
- 作者结论:基于意象的指导对提升样本中音乐家的演奏表现力是有效的。
- 完整评分汇总见 Table 3,正文中只给出关键均值与检验量。
🔑 关键术语
- Expressive performance:演奏表现力,指演奏中对音乐情感与结构的表达质量;本节中作为因变量,由评审按100分量表打分。
- Imagery-based instruction:基于意象的教学,即通过心理意象(mental imagery)引导练习的指导方式;本节报告其对表现力的提升效果。
- Paired-sample Wilcoxon test:配对样本 Wilcoxon 符号秩检验;本节用于检验每条旋律前后测评分之差是否显著,原文以 Z 值与 p 值报告。
- 100-point rating scale:100分量表;本节中用于量化演奏表现力的评分尺度,使前后测变化可直接以"分"为单位比较。
S19 [描述性拆分] 练习次数补充结果
第1段(P0074)
原文复述
In the research packet that participants completed, they reported how many times they practiced each melody in order to prepare their best expressive performance. The average number of practice times for Melody 1 was M = 6.3. For Melody 2, the average number of practice times was M = 6.1.
中文讲解
本段是研究结果的描述性补充,说明参与者在研究材料(research packet)中自报了每首旋律的练习次数,目的是为了准备出他们最好的富于表情的演奏(best expressive performance)。Melody 1 的平均练习次数为 M = 6.3,Melody 2 的平均练习次数为 M = 6.1。
从本节小标题"练习次数补充结果"可以看出,这一段属于描述性拆分(descriptive split),并非核心实验结论,而是对参与者行为的一组补充统计。它的论证意义在于:两首旋律的平均练习次数非常接近(6.3 对 6.1),说明两组旋律在演奏前所投入的熟悉度大致相当;这从另一个层面控制了"旋律熟悉度"或"难度差异"可能带来的混淆作用,为后文比较两首旋律在表情演奏表现上的差异提供了更公平的对比基础。换言之,作者借此向读者保证:两首旋律在最终分析中的差异不能简单地归因于参与者练习其中一首的次数远多于另一首。
补充说明
小标题为"[描述性拆分] 练习次数补充结果",其中"描述性拆分"暗示本节属于将主分析中的某一项结果拆出、单独报告其描述统计;此处拆出的是练习次数。两首旋律的 M 值仅差 0.2 次,可视为练习暴露量(practice exposure)大致均衡。无额外补充。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节无脚注、无图、无表,仅为正文中的描述性数据段落。标题中的"[描述性拆分]“提示该结果是从主结果集中拆分出来单独呈现的描述统计。
💡 本节核心要点
- 参与者在完成的研究材料中自报了每首旋律的练习次数。
- 自报练习次数的目的是为了练出最好的表情演奏。
- Melody 1 的平均练习次数为 M = 6.3。
- Melody 2 的平均练习次数为 M = 6.1。
- 两首旋律的平均练习次数非常接近,说明参与者对两首旋律的熟悉度大致相当。
- 这一补充结果的作用是排除练习量差异作为后续旋律间比较的混淆变量。
🔑 关键术语
- research packet:研究者分发给参与者的书面材料或问卷包,参与者在其中自报各项信息(如练习次数)。在本节中用于收集每位参与者对每首旋律的练习次数。
- expressive performance:富于表情的演奏,即在音准、节奏正确之外加入音乐表现力的演奏。本研究中参与者的练习目标即是为了产出"最好的表情演奏”。
- M (mean):平均数的常用统计符号。本段中 M = 6.3 与 M = 6.1 分别表示 Melorody 1 与 Melody 2 参与者自报练习次数的算术平均。
S20 [描述性拆分] ## Participants’ cognitive processes
第1段(P0075)
原文复述
Participants’ cognitive processes
中文讲解
这是本节(page 8)的小节标题,用以开启一个独立议题:报告并分析被试在演奏任务中所使用的认知加工过程。该标题将小节焦点从先前的行为或结果层面(performance expressiveness 之类)转向内部认知层面的个体差异,为下面 P0076 与 P0077 两段中关于认知翻译分数、组别划分与组间比较的论述提供主题框架。
第2段(P0076)
原文复述
Scoring of the musicians’ reported thought processes used the full 0–3 range of the coding scheme. The average cognitive translation scores were M = 1.38 for Melody 1 and M = 1.54 for Melody 2. The cognitive translation scores across the sample were correlated between Melody 1 and Melody 2, r(22) = .464, p < .05, suggesting that participants tended to use the same cognitive strategy with both melodies when working with the imagery-based instruction.
中文讲解
本段的核心主张是:在意象引导(imagery-based instruction)条件下,被试在两首旋律上展现出的认知翻译分数彼此相关,说明个体在两次任务中倾向于沿用同一种认知策略。
关键信息可拆为三层:
- 计分范围:研究者使用了编码方案的完整 0–3 区间,而非压缩到子区间,因此分数差异具有可比性。
- 平均水平:Melody 1(M = 1.38)与 Melody 2(M = 1.54)的均值都落在 0–3 区间中段偏下,提示整体被试仅是中等程度地使用了认知翻译策略,而非普遍高强度使用。
- 跨任务一致性:r(22) = .464, p < .05 表示两首旋律上的认知翻译分数呈中等程度显著正相关,自由度 22 对应 N = 24 的样本。作者据此推断,被试在基于意象的指导语下,对不同旋律大体沿用同一种认知策略——这是把后续分析从“每首旋律分别看”推进到“把被试按 CTI 得分高低分组”的关键过渡。
作者给出这一相关,是为了论证个体差异在跨任务间是稳定的,从而后续按 CTI 分组才是有意义的分类方式,而非随机切分。
补充说明
“imagery-based instruction”指本研究语境下引导被试使用心理意象而非纯动作或纯技术操作的指导方式;它是本段乃至下一段分组比较得以成立的实验条件前提。
第3段(P0077)
原文复述
To further explore the cognitive translation process, for each melody, we divided the sample into two groups based on score on the cognitive translation index (CTI): those who scored 0 or 1 were categorised as Low CTI (Melody 1 n = 13, Melody 2 n = 12) and those who scored 2 or 3 as High CTI (Melody 1 n = 11, Melody 2 n = 12). Figure 2 presents a graph of the change in performance expressiveness ratings from pretest to posttest for the two groups. A comparison of the gain scores (i.e. difference from pretest to posttest) by group revealed that with Melody 1, the High CTI musicians (M = 42.20) improved their performance significantly more than the Low CTI musicians (M = 27.64), Mann–Whitney U = 28, p < .05. Similarly with Melody 2, the High CTI group (M = 14.45) outgained the Low CTI group (M = 4.25), U = 37, p < .01. An additional analysis showed that instrumentalists were more likely to be in the High CTI group than vocalists, χ²(1, N = 24) = 4.74, p < .05.
中文讲解
本段承接 P0076 已论证的“被试两首旋律间策略一致”,把分析推进到“策略强度高低是否真的影响训练收益”这一关键问题。其论证由四个紧密相连的步骤组成:
- 组别划分与样本量交代:以 CTI 0–1 为 Low CTI、2–3 为 High CTI;Melody 1 上 Low n = 13、High n = 11,Melody 2 上 Low n = 12、High n = 12。这一划分把连续的 CTI 分数转化为可供组间比较的分类变量。
- 结果变量说明:Figure 2 呈现的是两组从 pretest 到 posttest 在 performance expressiveness rating 上的变化量(即 gain scores),因此后文比较的就是“训练后比训练前多了多少”,而非绝对水平。
- 核心比较(Mann–Whitney U,非参数检验,因样本小且分布可能不正态):
- Melody 1:High CTI(M = 42.20)显著高于 Low CTI(M = 27.64),U = 28, p < .05。
- Melody 2:High CTI(M = 14.45)同样高于 Low CTI(M = 4.25),U = 37, p < .01。 两个旋律上的方向一致——认知翻译策略用得越深,表演表达性的训练增益越大——这构成跨任务的可重复证据。值得注意的是两组在 Melody 2 上的均值都比 Melody 1 小(差距约一个数量级),作者并未解释这一悬殊,可能是不同旋律本身的难度或评分尺度差异,但作者把焦点放在组间比较而非绝对量级上。
- 额外分析:χ²(1, N = 24) = 4.74, p < .05 显示器乐演奏者(instrumentalists)比声乐演唱者(vocalists)更可能落在 High CTI 组。这条结果把认知策略使用强度的差异溯源到被试的专业类别上,为讨论“哪种训练背景更容易调动认知翻译”提供了入口。
容易误解之处:gain scores 是“前后测之差”,不是 posttest 本身的分数;M = 42.20 等是增益均值,不是绝对得分。
补充说明
Mann–Whitney U 在本研究中是比独立样本 t 检验更合适的选择,因为它对小样本与潜在非正态分布更稳健;CTI 即 cognitive translation index,是 P0076 中 0–3 编码的量化名称,本段首次展开缩写。Figure 2 的具体图样需查看原图,本节未提供图中数据点细节。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节涉及 Figure 2,其图题为 pretest 到 posttest performance expressiveness rating 的变化量按 Low CTI / High CTI 分组的展示,文中未给出图内逐点数值;脚注未出现于本小节三段之中。
💡 本节核心要点
- 认知翻译分数(CTI)使用 0–3 的完整编码区间,Melody 1 与 Melody 2 的均值分别为 1.38 与 1.54,整体处于中等偏低水平。
- CTI 分数在两首旋律之间呈中等正相关 r(22) = .464, p < .05,表明被试在意象指导条件下倾向于跨任务沿用同一种认知策略。
- 按 CTI 0–1(Low)与 2–3(High)分组后,High CTI 组在两首旋律上的表达性增益均显著大于 Low CTI 组(Melody 1: U = 28, p < .05;Melody 2: U = 37, p < .01)。
- 组间比较针对的是 gain scores(前后测差值),而非后测绝对水平。
- 额外 χ² 分析显示器乐演奏者比声乐演唱者更可能属于 High CTI 组,χ²(1, N = 24) = 4.74, p < .05。
- 认知翻译策略强度与训练收益之间的关联在两首独立旋律上得到重复验证,提升了该结论的内部可推广性。
🔑 关键术语
- Cognitive Translation Index (CTI):认知翻译指数,对被试报告的思维过程按 0–3 编码所得的量化分数,用以衡量被试在意象指导条件下将意象转化为演奏动作的认知加工深度;本节将其分为 Low(0–1)与 High(2–3)两组。
- Gain scores:增益分,即 posttest 评分减去 pretest 评分,反映被试从训练前到训练后的变化量;本节用它衡量训练效果。
- Mann–Whitney U:一种非参数的两独立样本比较检验,适用于样本量小或分布不明的情况;本节用以检验 High CTI 与 Low CTI 两组在 gain scores 上的差异是否显著。
- Imagery-based instruction:基于心理意象的指导方式,即引导被试通过内心意象而非纯技术指令来加工音乐;是本节讨论 CTI 策略一致性与组间差异得以成立的实验条件。
- Instrumentalists vs. vocalists:器乐演奏者与声乐演唱者两类被试的划分;额外分析显示前者更可能落在 High CTI 组,提示专业训练背景与认知翻译策略强度可能相关。
S21 [描述性拆分] “误判表现力”案例与认知翻译分组
第1段(P0078)
原文复述
We were particularly interested in better understanding situations in which musicians think they have improved their musical expressiveness, but the sound qualities of their performance do not bear it out. To explore this, we identified cases in which performance gain scores were minimal, such that any change would be so small as to risk being imperceptible to listeners. With each melody, we divided the sample into quartiles based on gain scores and focused on the lowest quartile (Q1) as representatives of musicians who were non-improvers. For a comparison group, we chose cases with the greatest gain scores (the highest quartile, Q4) to represent expressive performance improvement that would almost certainly be perceived by listeners. For this analysis we pooled together Melody 1 and Melody 2 cases. A chi-square analysis indicated that participant cases that had scored low in the cognitive translation were more likely to be categorised as non-improvers, χ²(1, N = 24) = 10.78, p < .01. Table 4 presents a crosstabulation of these two variables. As is clearly shown in the table, whereas most of the cases in the High CTI group (n = 10, 91%) were categorised as most improved, the majority of those in the Low CTI group (n = 11, 85%) were categorised as non-improvers. Interestingly, of the 12 non-improver cases, the participants seemed to believe that they had effectively improved: all gave a positive appraisal of the effectiveness of the instruction they received in making their performance more expressive, with several of them using an amplifying adjective, e.g. ‘very effective’, ‘highly successful’, and ‘absolutely helped me’.
中文讲解
本段是整篇研究最关键的发现之一,揭示了“主观感受上的提升”与“声音实际变化”之间的脱节。
一、研究问题。作者特别关心的是一种有趣的认知偏差:演奏者自己觉得表现力提升了,但听感层面上的表现力增益(performance gain)却没有支持这一判断。也就是说,自我评估的进步与可被听众感知的进步之间存在落差,这是音乐教学和音乐心理学中长期讨论的“元认知偏差”问题。
二、分析策略。作者没有平均地看所有被试,而是用四分位法把样本切成四等份:Q1(最低增益分)代表“未提升者”(non-improvers),Q4(最高增益分)代表“显著提升者”。这种极值对比比均值比较更有力,因为Q1几乎可以肯定是听众听不出变化的,而Q4则“几乎确定能被听众感知”(almost certainly be perceived),两端信号最强。为了增加统计样本量,作者把Melody 1和Melody 2的样本合并分析。
三、关键统计结果。卡方检验结果 χ²(1, N=24) = 10.78, p < .01,说明低认知翻译(Low CTI)与被归类为“未提升者”之间有显著的统计关联。Table 4的交叉表把这层关系可视化:高CTI组10个案例中91%被判为“显著提升”,而低CTI组12个案例中85%被判为“未提升”。两个方向的比例反差极为明显,构成了论文的实证支点。
四、最值得玩味的发现——认知—行动落差。在12位“未提升者”中,所有人(all)都对自己获得的指导给予了正面评价,认为它让演奏更有表现力;甚至有人用了“非常有效”“非常成功”“绝对有帮助”等强化形容词。这意味着:即使声音输出几乎没变,演奏者依然相信改进发生了。这正是“认知翻译”这一概念要捕捉的核心现象——演奏者的内部心理表征没有充分转化为外在的声音行为,但演奏者本人对此并不自知,反而误以为已经完成。
五、论证作用。本段为整个研究提供了“误判表现力”的典型证据,与前文关于认知翻译和表现力之间关系的主张形成呼应:能进行高质量认知翻译的演奏者倾向于真正提升表现力,而认知翻译弱的演奏者既无法提升表现力,也对自己的提升产生了错觉。这一发现支撑了论文关于“认知翻译是连接意图与声音之间关键桥梁”的理论定位。
补充说明
无额外补充。Table 4 的具体数字已在本段中完整呈现;CTI 即 cognitive translation 的缩写,本段对其分组判据(lowest vs. highest quartile of performance gain)已自洽交代,不需要外部信息补充。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段指引读者参见 Table 4 的交叉表(crosstabulation),该表展示了 CTI 分组(High vs. Low)与表现力提升分组(most improved vs. non-improvers)的二维频次分布;表格内容已在本段正文中以 n 与百分比形式完整复述。文中引用的演奏者自评原话(‘very effective’、‘highly successful’、‘absolutely helped me’)属于定性证据,与定量卡方结果互为印证。
💡 本节核心要点
- 研究关注的不是平均效应,而是“演奏者自以为提升、但听感并未支持”的认知偏差情形。
- 采用 Q1(最低增益)与 Q4(最高增益)的极值对比策略,并将 Melody 1 与 Melody 2 样本合并,以增强分析样本量。
- 卡方检验 χ²(1, N=24) = 10.78, p < .01 表明 Low CTI 与“未提升”分类之间存在显著关联。
- Table 4 交叉表显示 High CTI 组 91% 被判为显著提升,Low CTI 组 85% 被判为未提升,方向反差极为强烈。
- 在 12 名“未提升者”中,所有人均对所受指导给予正面评价,并使用强化形容词,说明主观改进感与客观声音改进之间存在脱节。
- 该发现支撑了“认知翻译是连接内部意图与外部声音行为之关键桥梁”的核心论点。
🔑 关键术语
- performance gain score:表现力增益分数,指演奏者在训练/指导后表现力变化的量化指标。本段中以“分数极小、几乎不可被听众感知”为标准来界定“未提升者”。
- quartile (Q1 / Q4):四分位。本段将样本按表现力增益分由低到高切分为四等份,Q1 为最低 25%(用于代表 non-improvers),Q4 为最高 25%(用于代表显著提升者)。
- cognitive translation (CTI):认知翻译,指演奏者将内在的音乐意图/理解转化为外在声音行为的过程。本段按其得分划分 High CTI 与 Low CTI 两组,用于检验认知翻译与表现力提升之间的关系。
- chi-square analysis (χ²):卡方检验,用于判断两个分类变量之间是否存在显著关联。本段用以检验 Low CTI 与被归类为 non-improvers 之间的关联,结果 χ²(1, N=24) = 10.78, p < .01,达到显著水平。
- non-improver:未提升者,本段中特指落入表现力增益最低四分位(Q1)的被试,即其表现力变化小到几乎不可被听众感知。
- amplifying adjective:强化形容词,本段特指 ‘very effective’、‘highly successful’、‘absolutely helped me’ 等程度副词加形容词的结构,用于强调演奏者对指导效果的高度肯定。
S22 [描述性拆分] ## Discussion
第1段(P0079)
原文复述
Discussion
中文讲解
本条为小节标题,原文为"## Discussion"(讨论)。它标志着论文从"结果"(Results)转向"讨论"(Discussion):作者将在此对前文给出的实验数据进行解释、将其与既有文献对话、并对研究范围与适用边界作出限定。本小节内含两段实质论述,因此该标题相当于下文两段共同论域的总入口。
第2段(P0080)
原文复述
The most important result of our study is empirical evidence that imagery-based instruction can efectively lead to improved expressive performance. While past research has established that many musicians like imagery-based teaching and believe it works, the results of the present study suggest that this approach can be efective. Participants’ pretest performances – that is, a normal musical rendition before receiving any instruction – were judged by our panel of experts to be significantly less expressive than their posttest performances. As a whole, the musicians successfully received expressive instruction stated in descriptive imagery form, and turned it into musical sound qualities that listeners heard as expressive of emotion. In understanding this finding, it is important to note that, although our participants were not highly advanced as university music students go, they were also far from being beginning performers.
中文讲解
本段开篇点明全文最核心的研究贡献:提供了"基于意象(imagery)的教学能够有效提升表现性演奏(expressive performance)“的实证证据。这一主张分两层与既有研究形成对照:第一层是"主观层面 vs. 实证层面”——以往研究只停留在"音乐家喜欢意象教学并相信它有效"的态度调查上,本研究则给出了客观数据支撑;第二层是"前测 vs. 后测"——经专家组盲评判定,未接受任何指导的常规演奏(前测)在表现力上显著弱于接受意象式描述指导之后的演奏(后测)。
作者用破折号插入语对"pretest performance"作出内嵌式操作定义(“a normal musical rendition before receiving any instruction”),目的是让读者理解:前测即在没有额外干预下的自然演奏,这是判断"提升"是否由意象教学引起的关键对照基线。
随后作者补充了一个关键限定:本研究的参与者并非顶尖水平的大学音乐生,但也不是完全的初学者,处于中间水平。这一限定并非自我贬低,而是在为结果的外推范围划界——它意味着研究只对类似发展阶段的演奏者作出有效性主张,而未声称对所有水平都同样有效。
从论证功能看,本段承接前文的结果数据(“后测表现力高于前测”),用一句话将其升格为整篇研究的中心结论,并通过限定样本范围为下一段关于"发展阶段"的讨论作铺垫。
补充说明
本段中"efective"为原文拼写,已忠实保留;其规范形式为"effective"。
第3段(P0081)
原文复述
The developmental stage of musicianship is important because our study corroborated past research that has suggested that expressive performance is a learned skill (e.g. Juslin and Laukka 2000; Meissner 2021). We sought to exclude the most advanced university musicians from our participant pool in order to study this very issue. Our findings indicated that an explicit cognitive process of translating imagery ideas into musical sound properties facilitated improvement of expressive performance. Decades of psychological research have shown that skills that began as highly conscious and efortful can, with much experience and practice, become automatically executable, i.e. done without explicit attention (e.g. Fitts and Posner 1967; Hallam 2010). It appears that this principle of skill acquisition applies to expressive performance, including that carried out with an imagery-based approach.
中文讲解
本段围绕一个核心问题展开:演奏者的发展水平为何在解释本研究结果时至关重要?
第一层逻辑:作者援引 Juslin and Laukka 2000 与 Meissner 2021 的观点——“表现性演奏是一种习得技能”(learned skill)。既然表现力是后天学得的,那么研究对象的训练水平就直接决定了"是否还有可被教学改善的空间"。作者据此说明本研究的样本设计选择:在招募时有意排除最顶尖的大学音乐生,正是为了让研究聚焦在"表现力尚在学习阶段、仍可能被外部指导推动"的演奏者群体上。换言之,“排除最顶尖者"不是样本缺陷,而是服从研究问题的设计。
第二层逻辑:作者将研究结果嵌入更一般的技能习得心理学框架。Fitts and Posner 1967 与 Hallam 2010 代表技能习得的经典模型(认知—联结—自动化):起初高度有意识、需要付出努力的技能,经大量练习后可被自动化执行、不再需要显性注意。作者主张该原则同样适用于表现性演奏,包括通过意象路径所完成的表现性演奏。
本段还指明了提升表现力的中介机制:“an explicit cognitive process of translating imagery ideas into musical sound properties”——即演奏者需要有意识地把意象概念翻译为具体的音乐声音属性。这种显性认知加工正是意象教学起作用的途径。
论证意义:本段把"意象教学对中间水平学习者有效"这一具体发现,放进一个更大的理论解释框架。它暗示:今天被本研究观察到的、需要显性认知投入的意象加工过程,未来可能通过长期练习走向自动化;因此意象教学不仅在当下有效,而且契合技能发展的一般规律。
容易误解之处:作者并未声称"意象教学应替代技术训练”,也未主张"对所有演奏者效果相同"。其结论的适用边界被"learned skill"这一前提和"非顶尖、非初学"的样本条件所共同限定。
补充说明
本段中"efortful"为原文拼写,已忠实保留;其规范形式为"effortful"。本段引用的 Juslin and Laukka 2000、Meissner 2021、Fitts and Posner 1967、Hallam 2010 均为正文内的文献提及(supporting evidence),未单独以脚注或参考文献列表的形式出现于本节。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节由一个小节标题("## Discussion")和两个实质段落组成,正文中所引文献(Juslin and Laukka 2000;Meissner 2021;Fitts and Posner 1967;Hallam 2010)作为支撑性证据直接嵌入段落文字内,未以脚注、图、表或边栏形式单独出现。原文中的两处拼写异体(“efective"两处、“efortful"一处)均按原文保留。
💡 本节核心要点
- 本节的核心贡献是提供了"基于意象的教学能够有效提升表现性演奏"的实证证据,区别于以往仅停留在主观态度层面的研究。
- 研究通过专家评委会的前测/后测盲评,确认了意象式描述指导可以转化为听者可感知的表现性声音,“a normal musical rendition before receiving any instruction"是对前测的内嵌式操作定义。
- 样本设计上有意排除最顶尖的大学音乐生,聚焦于中间水平的演奏者;这与"表现性演奏是习得性技能”(Juslin and Laukka 2000;Meissner 2021)这一前提一致,而非样本局限。
- 意象教学起作用的中介机制被界定为一种显性认知加工:演奏者把意象概念翻译为具体的音乐声音属性。
- 作者将研究结果与技能习得经典理论(Fitts and Posner 1967;Hallam 2010)对接,说明高度有意识的技能可经长期练习走向自动化,意象教学契合这一一般原则。
- 本节并未对顶尖演奏者或完全初学者的效果作出主张,结论的适用范围被"learned skill"前提与"非顶尖、非初学"的样本条件共同限定。
🔑 关键术语
- imagery-based instruction:基于意象的教学,即用描述性的意象语言(而非纯粹的技术指令)引导演奏者表达音乐情感与表现力,是本研究中考察的自变量教学手段。
- expressive performance:表现性演奏,即演奏者在音乐声音中传达情感与表现意图的能力;本研究的核心因变量,由专家评委会通过盲评前测/后测录音来衡量。
- learned skill:习得性技能。作者援引 Juslin and Laukka 2000 与 Meissner 2021,主张表现性演奏并非天生固有、而是通过学习获得,这构成本研究选取中间水平学习者作为样本的理论前提。
- explicit cognitive process:显性认知加工。本研究指参与者需要有意识地把意象概念翻译为具体的音乐声音属性,该加工过程被作者认定为表现力提升的中介机制。
- skill acquisition:技能习得。Fitts and Posner 1967 与 Hallam 2010 所代表的经典框架:起初高度有意识、费力的技能可经大量练习走向自动化;本节将该原则拓展应用到表现性演奏与意象教学中。
S23 [描述性拆分] 讨论:旋律熟悉度与“误判表现力”案例
第1段(P0082)
原文复述
Our study also identified instances in which musicians believed they were playing expressively, yet listeners did not judge the sound properties of their performance as expressive. This serves as a reminder that a performer’s inner emotional state or expressive intention is not automatically transmitted into the actual sound of the music they produce. The authors suggest that this may explain why Melody 2 had a much smaller improvement rate than Melody 1 in their study. As a group, the musicians appeared more readily able to translate ’loss of a loved one’ into music than ‘a happy peasant with no cares or worries’. It is possible that this difference arose because the participants were more familiar with the idea of losing a loved one than with the image of a rustic peasant; perhaps this familiarity was the key to their ability to produce expressive sound properties that the judges could perceive.
中文讲解
本段正式提出本节的核心现象——“误判表现力”(mistaken expressivity):演奏者主观上认为自己富有表现力地演奏,但听者却没有从声音属性中作出同样的判断。
作者由此做出两点推论:
- 现象学层面的提醒——演奏者的内在情绪状态或表现意图,并不会自动外化为声音;这中间存在一道从意象到声音的转化过程;
- 经验层面的解释——这可能正是 Melody 2 改善幅度明显小于 Melody 1 的原因:相比"无忧无虑的快乐农夫”,演奏者作为一个群体似乎更容易把"失去挚爱"翻译成音乐。
关键的因果假设是"熟悉度”:参与者对"失去挚爱"这一意象的内心图式(情感经验、想象资源)远比对"田园农夫"丰厚,因此能把熟悉的内容更可靠地转化为听者可感知的"expressive sound properties"。换言之,熟悉度—可调用的情感资源—声音转译能力,这条链一旦断裂,再多的"意象使用"也可能在声音层面落空。
这也是对前文实验结果的回扣:上一节展示了 Melody 1 效果好、Melody 2 效果差,本段给出一种"为什么"的解释,而不是把差异归于教学方法的失败。
补充说明
本段中 Melody 1 与 Melody 2 的指代需结合前文实验设计理解(“失去挚爱"对应 Melody 1,“无忧无虑的快乐农夫"对应 Melody 2);原文用"it is possible"“perhaps"明确把熟悉度因果标记为推测性解释,而非已证结论。
第2段(P0083)
原文复述
Such cases of ‘mistaken expressivity’ are particularly interesting from a music-education perspective. More than ever before, internet and recording technology now allows teachers to assess the musical sounds of student performance, including through computer programs that automatically score performance and provide feedback. The visual cues of expressivity (e.g. facial expression, bodily gesture) are particularly impactful in live performance and in solo performance settings (Davidson and Broughton 2016). With audio recordings, because no performer visual cues are available, the acoustic sound properties stand alone, so expressivity must be readily perceivable to listeners. Also, it seems likely that with live performance in large ensemble settings, the expressive visual cues of individual performers are much less salient, compared to the expressive sound properties of the ensemble as a whole. Rather than this being a deterrent from using imagery-based teaching, it should serve as a reminder to educators that this expressive performance process must be taught and learned in order to be effective.
中文讲解
本段把"误判表现力"从实验观察转入教学场景,论证其教育意涵。
论证逻辑分四步:
- 技术背景——互联网、录音技术以及自动评分反馈软件,使教师越来越多地仅凭声音评估学生演奏;
- 视觉线索的原本作用——在独奏和现场表演中,面部表情、身体姿态等视觉线索对"表现力感知"有强烈加持(援引 Davidson and Broughton 2016);
- 视觉缺失后的代价——录音里没有视觉线索,大合奏中个体演奏者的视觉线索又会被整体淹没,因此表现力必须落到声音属性上、让听者"直接可听”;
- 反向结论——这并不意味着要放弃意象教学(imagery-based teaching),而是提示教育者:从意象到声音表现力的转化过程本身,是需要被教、被学的。
教学上要注意的关键反差:作者没有否定意象的价值,而是在原有教学法之上补一层要求——意象只是起点,真正要训练的是学生能否在声音中"实现"它。这把责任从"用不用意象"前移到"意象能否被声音化”。
补充说明
“visual cues of expressivity” 与 “expressive sound properties” 是本段的对照轴:前者依赖看(facial expression、bodily gesture),后者依赖听;作者认为一旦前者缺席,后者必须独自承担表现力的传达。Davidson and Broughton 2016 在正文中以括号引注形式出现,为视觉线索在独奏/现场场景中更具影响力的判断提供文献支撑。
第3段(P0084)
原文复述
Further research is needed to better understand the cognitive mechanisms underlying cases of mistaken expressivity. Anecdotally, the two members of our research team who extracted the audio from participants’ self-made videos agreed that there were instances when participants’ posttest expressive performances showed highly expressive facial countenance and body movement in the video, even though the sound properties of the audio did not seem to change much. Perhaps from the standpoint of attentional resources, these musicians are so focused on their intended emotional expression that they are unable to accurately monitor the sound of their own performance.
中文讲解
本段把讨论推到机制层面,并对前两段的现象提出一个试探性理论解释。
论证结构:
- 主张空白——认知机制尚未清楚,需要后续研究;
- 轶事性证据——两位负责从自拍视频中抽取音频的研究者观察到:参与者后测演奏时,视频中面部和身体动作高度富有表现力,但音频的声音属性几乎没变;视觉和听觉通道出现了脱钩;
- 假设性机制——以"注意资源”(attentional resources) 框架猜测:演奏者把注意资源过度集中于"想要的情感表达"上,因而牺牲了对自身声音输出的监控。
需要注意措辞的克制:作者用 “Anecdotally”(轶事性)和 “Perhaps” 来明确标记证据等级——这不是量化结果,而是加工过程中的主观观察加推测。这种节制恰恰提示读者:表现力意象教学的失效,可能不仅来自教学法,更可能源自演奏者实时认知分配的结构性限制。
因此本段既为后续研究留下入口,也为前两段"误判表现力"提供了第一种可能的认知解释。
补充说明
本段中的 “posttest”、“self-made videos” 需与前文实验流程对应理解:参与者自录演奏视频,研究者从同一视频中分别取出画面与音频进行比较,故 “视频里富有表现力而音频几乎没变” 的判断可以直接成立。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节内含一处正文引注:P0083 提及 “Davidson and Broughton 2016”,括号引注形式出现,用于支持"视觉线索在独奏和现场表演中影响尤为显著"这一主张;该引注本身未提供摘要,属于支持性文献指向。除此之外,本节无脚注、图表或边栏材料。
💡 本节核心要点
- 本节核心概念——“误判表现力”(mistaken expressivity):演奏者主观认为自己富有表现力,但听者并未从声音属性中感知到同样的表现力。
- 熟悉度假设被用作解释 Melody 1 与 Melody 2 改善率差异:演奏者对"失去挚爱"的内在图式比对"田园农夫"更丰富,因此能更稳定地把意象翻译成可听的表现性声音属性。
- 在录音评估与自动评分软件普及的背景下,视觉线索(面部、身体)逐渐缺席或被稀释,因此声音属性必须独立承担表现力的传达责任。
- 作者明确反对"据此否定意象教学"的推论:意象教学应保留,但意象→声音表现力的转化过程本身需要被教、被学。
- 轶事性观察提示视觉与听觉通道脱钩的可能:演奏者的表情动作与声音输出未必同步变化。
- 基于注意资源(attentional resources) 提出试探性认知机制——演奏者可能因过度聚焦于情感意图而无法同步监控自身声音,该机制尚需进一步研究验证。
🔑 关键术语
- mistaken expressivity(误判表现力):本节核心术语,指演奏者主观认为自己演奏得富有表现力,但听者并未从声音属性中作出同样判断的情形;强调内部意图与外部可感知声音之间的脱节。
- expressive sound properties(表现性声音属性):听者可从声音本身(不依赖视觉线索)感知为"表现力"的声学特征;在视觉线索缺席(录音、大合奏)时承担表现力传达的唯一载体。
- visual cues of expressivity(表现力的视觉线索):包括面部表情、身体姿态等依赖视觉通道的表现性信号;在独奏和现场表演中影响尤为强烈,但不影响录音评估。
- imagery-based teaching(意象教学法):以心理意象(含情感场景、画面)引导演奏表现的教学方法;本节作者主张其价值不应被视觉线索缺失的现实否定,但需补上"意象→声音"的转化训练。
- attentional resources(注意资源):本节用作试探性解释框架的认知概念;指演奏者有限的认知容量可能因集中于情感意图而无法同时监控自身声音输出。
S24 [描述性拆分] 讨论:研究的可推广性与对音乐教育的启示
第1段(P0085)
原文复述
Also, additional research on imagery-based instruction is needed to know how generalisable the findings of this study are. For example, would our imagery examples be effective with music students younger than college-aged? In the same vein, more insight is needed to know what kinds of metaphors and descriptive imagery are most effective with different types of student musicians. Leech-Wilkinson and Prior (2014), in discussing the difficulty that musicians face when talking about their art, explained that ‘sound has a tiny descriptive vocabulary of its own – arguably only two words in English, loud and quiet, with everything else borrowed from other domains (34). It would be beneficial to know how musicians learn to apply such borrowed terminology, for example, the descriptors of ‘bright’ and ‘dark’ for musical timbre (e.g., see Holmes 2012; Van Elferen 2020; Wallmark 2019). Despite potential shortcomings of an imagery-based approach to teaching expressive performance, it appears to be a prominent and valued contributor to quality music education.
中文讲解
这段话把讨论从研究本身的发现推向更宏观的可推广性问题,承接前文对教学效果的肯定,开始为读者勾勒后续研究方向。
第一层主张是:本研究的结论能否推广仍未可知,需要更多研究。作者举出两个具体的可推广性问题:一,年龄更小的音乐学生(低于大学年龄段)是否同样能从这些意象教学示例中受益;二,对不同类型的音乐学生来说,哪种隐喻和意象最有效。这两个例子共同表明,作者承认教学效果可能因学习者特征而变化,单一样本不足以覆盖这些差异。
第二层主张关注一个更深层的语言学问题:为什么音乐教学要依赖意象(borrowed terminology)?作者引用 Leech-Wilkinson 和 Prior (2014) 强调,英语中专门描述声音本身的词汇极少(只有 loud 和 quiet 两个),其余描述都借用自其他领域。这解释了为何“意象式语言”几乎不可避免——它本质上是用别处的词汇来描述声音体验,因为本族词不够用。
紧接着,作者把“借用”这一抽象命题落到一个具体的音色(timbre)用例上:明亮(bright)与黑暗(dark)。这两个词本来属于视觉和触觉领域,被借来形容音色;并通过 Holmes 2012、Van Elferen 2020、Wallmark 2019 这三个参考文献为这种跨感官隐喻的研究提供文献支撑。
最后一句带有转折意味:尽管意象教学法存在潜在不足(potential shortcomings),但它仍然是有价值且突出的音乐教育手段。这既呼应了开头的“需要更多研究”,也给意象教学法一个总体上正面的评价,使整段话在承认局限的同时维持对方法的肯定。
补充说明
本段中的引用 (Leech-Wilkinson and Prior 2014, 34) 是作者原文页码的文献引证,引文以页内引号形式出现,强调音乐描述词汇稀缺这一关键论点。Holmes 2012、Van Elferen 2020、Wallmark 2019 是作者用来支撑音色跨感官隐喻研究的参考文献。这些信息均直接来自本段文本,未补充外部内容。
第2段(P0086)
原文复述
It should be noted that our study had limitations because it essentially used a one group pretest-posttest design. As a pre-experimental design, it does not allow determination of causality, at least with a high degree of confidence. Threats to validity were, however, mitigated by the fact that the participants carried out the pretest and posttest in the same practice session, thereby minimising the possible influence of time-related threats, namely history (i.e. extraneous events), maturation, and attrition. We also must acknowledge that our study prioritised ecological validity over internal validity and experimenter control. There was no researcher monitoring to ensure compliance with the protocol as participants carried it out. On the other hand, though, from the written documentation and video recordings that participants submitted, we found no reason to doubt that participants completed the task as instructed. These university music students possessed the musicianship, maturity, and motivation to carry out the research process. As practice tasks go, it was quite modest in the time and effort requested, thereby lessening the likelihood that participants would rush through the process or carry it out improperly. Despite limitations, the findings of our study reported here have provided further evidence of the value of imagery-based teaching. At the very least, this instructional approach reminds us – teachers and students, alike – that music primarily exists to affect the emotions and imaginations of human beings. If music education is dominated by technical instruction only, it can lead to students understanding musicianship as a technical and objective exercise, rather than the affective, and personally subjective art form that it is. Increasing and improving expressive musical instruction would likely benefit music education as a whole.
中文讲解
这段话系统交代了本研究的局限,并在承认局限的同时重申意象教学法的价值,最后把它提升为对音乐教育整体方向的呼吁。它承担着收束全文的任务:既要有方法论上的诚实,又不能削弱结论的意义。
先交代方法学局限:采用的是单组前后测设计(one group pretest-posttest design)。作者明确指出,这是一种前实验设计(pre-experimental design),无法高置信度地推断因果关系。这一自我批评至关重要,因为前文的许多主张若没有对照组支撑,就不能完全归因于意象教学干预。
接着作者用“然而”转入对效度威胁的减弱论证:前测与后测在同一次练习时段内进行,因此与时间相关的三类威胁——历史(额外事件)、成熟(自然发展)和被试流失(attrition)——被最小化。这是作者对“为什么这种较弱的范式仍然可以接受”的关键辩护。
随后作者交代了一项设计上的价值取向选择:本研究优先考虑了生态效度(ecological validity)而非内部效度(internal validity)和实验者控制。这意味着实验情境接近真实课堂,代价是没有研究者现场监督来强制遵守实验流程。
针对这一弱点,作者给出三重补偿论据:一,书面材料和视频记录没有显示违规的迹象;二,被试是具备音乐素养、成熟度和动机的大学生音乐学生;三,练习任务在时间和精力上要求适中,不会诱使被试草率完成或执行不当。三条论据合起来回应了对“无法亲自监督”这一弱点的质疑。
最后两段从局限性讨论转入对音乐教育的宏观启示。核心命题是:即便有局限,本研究仍为意象教学的价值补充了证据;至少这种教学方法提醒师生,音乐本质上是影响人类情感与想象的艺术。若音乐教育被纯技术性训练主导,会把学生引向把音乐理解为“技术与客观练习”,而非“情感性、个人化的艺术形式”。作者以一句总括性主张结束:增加并改进表现性音乐教学,整体上将使音乐教育受益。
整段话的结构是:承认局限—正面辩护—重申价值—扩展到一般性教育主张。它与上一段在“尽管……但”这一转折结构上呼应,共同把意象教学法放回到一个有保留但积极的位置上。
补充说明
本段内部出现多个实验方法学术语:one group pretest-posttest design(单组前后测设计)属于前实验设计的一种;history、maturation、attrition 是 Campbell & Stanley 等人提出的对内部效度的经典威胁类别,作者用括号解释 history 为“extraneous events”,并以“namely”把三者作为时间相关威胁的代表列出;ecological validity 与 internal validity 是心理学研究中一对经典权衡。这些术语均属本段直接使用,无外部扩展。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节无独立脚注、图表或边栏。段内脚注式引用包括:Leeech-Wilkinson and Prior (2014, p. 34) 关于英语中描述声音的本土词汇数量极少的关键引语,以及 Holmes (2012)、Van Elferen (2020)、Wallmark (2019) 支撑明亮/黑暗等跨感官隐喻被用于描述音色(timbre)。这些引用直接出现在正文中,作用分别是提供理论支持和引导后续研究方向。
💡 本节核心要点
- 意象教学法的可推广性仍需进一步研究,特别是对低于大学年龄段的学生以及对不同类型音乐学习者最有效的隐喻类型。
- 音乐描述词汇本身稀缺,迫使教学法不得不借用其他领域的词汇(如“bright”与“dark”描述音色),这构成了意象式教学的认知基础。
- 研究采用单组前后测设计,无法高置信度推断因果,但通过同一练习时段内的前后测减小了历史、成熟与被试流失三类时间相关威胁。
- 研究在生态效度与内部效度之间作出权衡,牺牲实验者现场控制以贴近真实课堂情境,并以书面/视频证据、被试成熟度和适度的任务要求作为补偿。
- 尽管存在局限,研究仍为意象教学法的价值补充了证据,并把讨论提升为对音乐教育方向的呼吁:避免被纯技术训练主导,重视音乐作为情感与想象的艺术。
🔑 关键术语
- generalisability:可推广性,指向研究结论能否延伸到本研究样本之外的其他人群与情境;作者用它框定下一步研究的方向。
- borrowed terminology:借自其他领域(如视觉、触觉)的描述性词汇,被用于形容声音与音色;Leech-Wilkinson 与 Prior (2014) 用来说明音乐本身缺乏专属描述词。
- one group pretest-posttest design:单组前后测设计,仅对同一组被试在干预前后进行测量;属于前实验设计,因缺少对照组,难以高置信度地确立因果关系。
- ecological validity vs. internal validity:生态效度指研究情境与真实场景的接近程度;内部效度指对额外变量的控制程度;本段说明研究刻意优先前者、牺牲后者。
- history, maturation, attrition:作者用“namely”并列提出的三组时间相关效度威胁——历史(额外事件)、成熟(自然发展)和被试流失;通过同一次练习内完成前后测被减弱。
- expressive musical instruction:表现性音乐教学,指在演奏中发展情感表达与想象力的教学;本节用它与“技术性、客观的训练”对照,作为收束全文的核心教育主张。
S25 [描述性拆分] ## Disclosure statement
第1段(P0087)
原文复述
Disclosure statement
中文讲解
这是一个二级小节标题,文字为 “## Disclosure statement”(披露声明)。在学术论文的版面结构中,二级标题(以两个井号标记)通常用于标示一个独立的小节,本节的功能是告知读者本节将要披露与研究相关的利益关系信息。“Disclosure statement”(披露声明)是学术期刊普遍要求的标准栏目,要求作者公开任何可能影响其研究客观性的经济或非经济利益关联。该标题本身不包含实质性主张,仅起到开启和命名该小节的作用,下一段文字才是具体披露内容。
第2段(P0088)
原文复述
No potential conflict of interest was reported by the author(s).
中文讲解
本句逐字复述为:作者们报告不存在潜在的利益冲突。这句话是披露声明部分的核心内容,明确告诉读者:在本研究的撰写与发表过程中,没有任何作者向期刊披露存在潜在的利益冲突。关键词是 “potential”(潜在的)和 “reported”(被报告的)——前者表示即便尚未构成实际冲突、仅在可能性层面也无须披露的事项,后者则表明披露依据来自作者本人的主动报告,而非编辑部的独立核查。括号中的 “author(s)” 表示作者为单数或复数均适用,这一写法是期刊对作者人数未定时采用的通用格式。就本节整体论证而言,该句不参与正文研究结论的推导,而是论文出版伦理链条中的必要环节:它向读者和编辑确认研究的中立性与可信度不因外部利益关联而受到损害。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为论文末页的标准披露声明,不含脚注、图表、公式或边栏附加材料。其版面属性为单一标题加一段声明文字,无其他附加信息。
💡 本节核心要点
- 本节是学术期刊出版伦理要求的标准栏目,与正文研究内容没有论证关系,仅履行信息披露义务。
- 小节标题 “## Disclosure statement” 起命名和分隔作用,标识该节专门用于利益关系披露。
- 核心声明以 “No potential conflict of interest was reported by the author(s).” 一句完成,含义是作者主动确认不存在任何需要披露的潜在利益冲突。
- “potential” 一词将披露范围扩展到可能性层面,体现披露标准高于实际冲突发生与否的门槛。
- 本节体现学术出版的透明性原则,使读者能够据此评估研究结论的可信度。
🔑 关键术语
- Disclosure statement:披露声明,学术论文中由作者声明是否存在利益冲突的固定栏目,本节即为该栏目的具体内容。
- Potential conflict of interest:潜在利益冲突,指可能影响作者研究客观性或客观性的经济、商业、人际关系等关联,本节明确声明不存在此类冲突。
S26 [描述性拆分] ## Notes on contributors
第1段(P0089)
原文复述
Notes on contributors
中文讲解
本段为章节标题,原文 ‘## Notes on contributors’ 可译为’## 撰稿人简介’。该标题开启了一个独立栏目,其功能不在于推进论证,而在于向读者逐一交代本书各章撰稿人的学术身份、任职机构、研究方向与代表著作,目的是为后续章节的论述提供人物背景与权威性线索。本节体量较短(仅含一段标题与四段人物简介),因此阅读时不必从中提取实质观点,而应作为索引性信息快速浏览。
第2段(P0090)
原文复述
Robert H. Woody is Steinhart Foundation Distinguished Professor at the University of Nebraska – Lincoln, where he teaches courses in music education and music psychology. He is the author of the 2nd edition of Psychology for Musicians: Understanding and Acquiring the Skill and the forthcoming book Music Learning and Development: A Guide to Educational Psychology for Music Teachers.
中文讲解
Robert H. Woody 是内布拉斯加大学林肯分校(University of Nebraska – Lincoln)的 Steinhart 基金会杰出教授(Steinhart Foundation Distinguished Professor),在该校讲授音乐教育(music education)与音乐心理学(music psychology)课程。他是《Psychology for Musicians: Understanding and Acquiring the Skill》(《音乐家心理学:理解与习得技能》)第二版的作者,以及即将出版的《Music Learning and Development: A Guide to Educational Psychology for Music Teachers》(《音乐学习与发展:面向音乐教师的教育心理学指南》)一书的作者。
本段把 Woody 定位为本卷撰稿人中资历最深的一位。‘杰出教授’头衔反映其在所在高校的资深学术地位;‘音乐教育’与’音乐心理学’双重教学方向显示其研究跨越教学实践与心理机制两个层面;两本著作的书名——《音乐家心理学》与《面向音乐教师的教育心理学指南》——更精确地把他的研究锁定在’音乐技能习得的心理过程’与’教师视角下的音乐学习与发展’这两个主题上。这一身份与本卷所讨论的’学习—评估—效能’系列主题在学科归属上高度吻合。
第3段(P0091)
原文复述
Mary Beth Hilbers serves as the Coordinator of Music Field Experiences and an instructor of courses in music education at the University of Nebraska – Lincoln. Fully certified in both Orf Schulwerk and the Kodály method, she has extensive teaching experience in PreK-12 classroom settings.
中文讲解
Mary Beth Hilbers 在内布拉斯加大学林肯分校担任音乐实践教学协调员(Coordinator of Music Field Experiences),同时也是该校音乐教育课程的授课教师。她已完整获得 Orf Schulwerk(奥尔夫教学法,原文写作 Orf Schulwerk,按原文保留)与 Kodály method(柯达伊教学法)两项资格认证,并拥有从学前班至高中阶段(PreK-12)课堂的丰富教学经验。
本段突出 Hilbers 的两个特点。第一,她兼具行政与教学双重角色:既要协调音乐实践教学(field experiences),又直接承担授课任务,这与一般仅承担教学或仅承担行政的教师不同。第二,她在两大主流儿童音乐教学法上同时具备完整认证。PreK-12 的覆盖范围进一步说明其专长横跨整个基础教育阶段的课堂实施,而非仅限于某一学段。综合来看,Hilbers 是本卷中’教学法应用与一线课堂经验’方面的代表人物。
(注:原文写作 ‘Orf Schulwerk’,按原文保留拼写;‘Kodály method’ 即以匈牙利音乐教育家名字命名的柯达伊教学法。)
第4段(P0092)
原文复述
Jessica Schreiner is an instrumental music educator in the Seward Public Schools in Nebraska, USA. She holds a PhD in Music from the University of Nebraska–Lincoln and has done previous research on the efect of self-assessment on secondary band students’ musical growth.
中文讲解
Jessica Schreiner 是美国内布拉斯加州 Seward 公立学校系统(Seward Public Schools)的器乐音乐教师(instrumental music educator)。她持有内布拉斯加大学林肯分校授予的音乐学博士学位(PhD in Music),并曾就自我评估(self-assessment)对中学阶段管乐学生(secondary band students)音乐成长的影响这一课题开展过前期研究。
本段把 Schreiner 定位为’一线在职教师 + 博士研究者’的复合身份。她既身处公立中小学承担器乐教学职责,又具备博士学术训练;其先前研究方向——‘自我评估对中学生管乐学习的影响’——与本卷中讨论学习者自主评估、自我调节学习等主题的章节形成直接呼应,因此读者在阅读与’评估’相关的章节时可将其视为首要的现场经验来源。
(注:原文写作 ’efect’,按原文保留拼写。)
第5段(P0093)
原文复述
Aaron D. Schuck teaches instrumental music in the Sioux City Community Schools of Iowa, USA and previously earned a PhD in Music from the University of Nebraska – Lincoln. His research interests include the role of self eficacy in pre-service music educators
中文讲解
Aaron D. Schuck 在美国爱荷华州苏城社区学区(Sioux City Community Schools)教授器乐课程(instrumental music),并已获得内布拉斯加大学林肯分校授予的音乐学博士学位。其研究兴趣包括自我效能感(self-efficacy)在职前音乐教师培养过程中的作用。
本段强调 Schuck 的两个信息点。其一,与 Schreiner 类似,他也是’在职器乐教师 + 博士’的复合身份;其二,他的研究聚焦在’自我效能感(self-efficacy)‘与’职前音乐教师(pre-service music educators)‘这两条线索的交叉地带——即尚未入职的教师在培养阶段的信心判断问题。将 Schreiner 的’自我评估’与 Schuck 的’自我效能感’并置阅读,可以看出本卷撰稿人群体围绕’学习者主体性’这一主题形成了紧密的研究合力。
(注:原文写作 ‘self eficacy’,按原文保留拼写;句末未出现句号,按原文保留。)
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为撰稿人简介,节内未出现脚注、图表、边栏或其他附加材料,仅由一段小节标题与四段人物简介组成。
💡 本节核心要点
- 本节属于撰稿人简介栏目,本身不构成论证,其作用在于为读者评估后续章节的学术权威性提供人物背景。
- 四位撰稿人中,Robert H. Woody、Mary Beth Hilbers、Jessica Schreiner、Aaron D. Schuck 均与内布拉斯加大学林肯分校有直接关联:前两位为该校现任教师,后两位为该校博士校友,显示出本卷明显的学术地域归属。
- Robert H. Woody 在四位中资历最显赫,拥有 Steinhart 基金会杰出教授头衔;其代表著作《Psychology for Musicians》与即将出版的《Music Learning and Development》均聚焦于’音乐技能心理’与’教师视角下的音乐学习’两条主线。
- Mary Beth Hilbers 是本卷中唯一明确具备 Orff Schulwerk 与 Kodály method 双重教学法认证的撰稿人,且专长覆盖 PreK-12 整个基础教育阶段,反映本卷对基础音乐教育课堂实施层面的关注。
- Jessica Schreiner 与 Aaron D. Schuck 均为’在职器乐教师 + 博士’的复合身份,研究方向分别聚焦于’自我评估对中学生管乐学习的影响’与’自我效能感对职前音乐教师的作用’,二者在’学习者主体性’主题上构成呼应。
- 撰稿人群体在角色上形成了’资深教授—教学协调员—一线在职教师—研究型在职教师’的多元搭配,对应理论建构、教学法应用与课堂实证三类不同视角。
🔑 关键术语
- Steinhart Foundation Distinguished Professor:由 Steinhart 基金会资助冠名的高校杰出教授荣衔,本节用于标识 Robert H. Woody 在内布拉斯加大学林肯分校的资深学术地位。
- Orff Schulwerk(原文写作 Orf Schulwerk):一种以节奏与动作律动为核心的儿童音乐教学法名称,本节用来说明 Mary Beth Hilbers 已获得该教学法的完整资格认证。
- Kodály method:一种以歌唱、首调唱名与循序渐进的音乐读写训练为核心的音乐教学法名称,本节用来说明 Mary Beth Hilbers 已获得该教学法的完整资格认证。
- PreK-12:涵盖学前班(Pre-Kindergarten)至高中 12 年级的整个基础教育阶段,本节用来说明 Mary Beth Hilbers 的课堂覆盖范围。
- self-assessment(原文写作 efect of self-assessment):学习者对自身学习表现进行的评价活动,本节指出 Jessica Schreiner 此前的研究聚焦于该机制对中学管乐学生音乐成长的影响。
- self-efficacy(原文写作 self eficacy):个体对自己能否完成特定任务的信心判断,本节指出 Aaron D. Schuck 关注其在’职前音乐教师’群体中的作用。
- pre-service music educators:职前音乐教师,指尚处于培养阶段、尚未正式入职的音乐教育专业学生,本节与自我效能感一同作为 Aaron D. Schuck 的研究对象。
- secondary band students:中学阶段的管乐学生,本节用来说明 Jessica Schreiner 自我评估研究的具体对象群体。
S27 [描述性拆分] ## ORCID
第1段(P0094)
原文复述
ORCID
中文讲解
这是一个二级标题(Markdown 写法中以两个井号标记),其文字内容仅为 “ORCID”。它单独成段,紧随其后给出的是作者 Robert H. Woody 及其 ORCID 链接,因此该标题的功能是引入作者身份标识信息:在正式章节内容之后,单独划出一小段,用以声明作者的 ORCID 编号及其可解析链接。
补充说明
此段本身只是一个分节标题,没有更多正文信息,因此补充说明以解释其版式与功能为主。
第2段(P0095)
原文复述
Robert H. Woody http://orcid.org/0000-0002-5175-975X
中文讲解
该段给出作者姓名 “Robert H. Woody” 以及对应的 ORCID 标识符链接 “http://orcid.org/0000-0002-5175-975X"。ORCID(Open Researcher and Contributor ID)是一类面向研究者的唯一持久标识符,其形如 16 位数字组成的 ID,并可通过 orcid.org 域名解析到对应的研究者公开档案。出现在此处的链接表明,作者在投稿时按照期刊或出版方的要求公开声明了自己的 ORCID,以方便读者、编辑系统或索引数据库对该作者身份进行唯一且无歧义的识别。本段与上一段 “## ORCID” 的小节标题配合,共同构成一段简短的作者标识声明,属于正文之外的元信息。
补充说明
本段可视为上一标题的正文式落款:标题声明此处展示的是 ORCID 信息,本段则具体给出人名与可点击的 ORCID URL,二者共同闭合该小节。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为页眉式作者标识区块:先以二级标题 “## ORCID” 引出话题,再以一行文本给出作者姓名与 ORCID 链接,未包含脚注、图表或边栏。
💡 本节核心要点
- 该小节以二级标题 “## ORCID” 单独划分作者标识信息。
- 作者署名为 Robert H. Woody。
- 作者公开提供 ORCID 链接 http://orcid.org/0000-0002-5175-975X,以声明其唯一的持久研究者标识。
- ORCID 编号由 16 位数字构成,可通过 orcid.org 解析到研究者公开档案,用于解决同名作者之间的歧义问题。
- 本节属于出版元信息,不承载论证内容,而是作者身份可验证性的辅助声明。
🔑 关键术语
- ORCID:Open Researcher and Contributor ID 的缩写,是面向研究者与学术贡献者的唯一持久数字标识符,形如 0000-0002-5175-975X 这样的 16 位编号,可通过 orcid.org 域名解析。在本节中用于标识作者 Robert H. Woody 的身份。
- http://orcid.org/0000-0002-5175-975X:作者 Robert H. Woody 的 ORCID 唯一标识符的可解析 URL,点击后可跳转到该作者在 ORCID 平台上的公开档案页面。
S28 [描述性拆分] ## References
第1段(P0096)
原文复述
References
中文讲解
这是二级标题,标志文章正文结束、参考文献列表开始。学术写作惯例下,References(或 Bibliography)按作者姓氏字母顺序列出文中引用的全部来源,方便读者核查与回溯。
第2段(P0097)
原文复述
Arrais, N., and H. Rodrigues. 2007. “Cognitive Feedback and Metaphors in Emotional Communication Instruction of Musical Performance.” In Proceedings of the International Symposium on Performance Science 2007, edited by A. Williamon and D. Coimbra, 265–270. Utrecht: The Association Européenne des Conservatoires, Académies de Musique et Musikhochschulen (AEC).
中文讲解
Arrais 与 Rodrigues 于 2007 年发表的会议论文,题为《音乐演奏情感交流教学中的认知反馈与隐喻》,收录于 Williamon 与 Coimbra 主编的《2007 年国际表演科学研讨会论文集》第 265–270 页,由位于乌得勒支的欧洲音乐学院联盟(AEC)出版。文献类型为会议论文集章节。研究主题指向“认知反馈”与“隐喻”在音乐演奏情感交流教学中的应用。
补充说明
出版方名称原文混合了法语(Association Européenne des Conservatoires, Académies de Musique)与德语(Musikhochschulen),括号内 AEC 为其英文缩写。
第3段(P0098)
原文复述
Bergee, M. J. 1997. “Relationships among Faculty, Peer, and Self-Evaluations of Applied Performances.” Journal of Research in Music Education 45 (4): 601–612. https://doi.org/10.2307/3345425
中文讲解
Bergee 1997 年发表于《音乐教育研究学刊》(Journal of Research in Music Education)第 45 卷第 4 期第 601–612 页,题为《主科演奏中教师评价、同伴评价与自我评价之间的关系》。文献类型为期刊论文,研究主题聚焦于演奏评估中三方评价主体(教师、同伴、自我)之间的关系。
第4段(P0099)
原文复述
Bonastre, C., and R. Timmers. 2021. “Comparison of Beliefs About Teaching and Learning of Emotional Expression in Music Performance Between Spanish and English HE Students of Music.” Psychology of Music 49 (1): 108–123. https://doi.org/10.1177/0305735619842366.
中文讲解
Bonastre 与 Timmers 2021 年发表于《音乐心理学》(Psychology of Music)第 49 卷第 1 期第 108–123 页,题为《西班牙与英国音乐专业大学生对音乐演奏中情感表达教与学信念的比较》。文献类型为期刊论文,研究主题为不同国家高等教育(HE = Higher Education)背景下学生对情感表达教学的信念差异。
补充说明
原文中 “ofMusic” 之间无空格,疑为排版或 OCR 问题,未予改动;HE 为 Higher Education(高等教育)缩写。
第5段(P0100)
原文复述
Clarke, E. F. 1993. “Imitating and Evaluating Real and Transformed Musical Performances.” Music Perception 10 (3): 317–341.
中文讲解
E. F. Clarke 1993 年发表于《音乐知觉》(Music Perception)第 10 卷第 3 期第 317–341 页,题为《对真实与变形音乐演奏的模仿与评价》。文献类型为期刊论文,研究主题是受试者对原版与经过处理的音乐演奏进行模仿再现和评价判断时的行为。
第6段(P0101)
原文复述
Clarke, E. F., and C. Baker-Short. 1987. “The Imitation of Perceived Rubato: A Preliminary Study.” Psychology of Music 15 (1): 58–75.
中文讲解
Clarke 与 Baker-Short 1987 年发表于《音乐心理学》(Psychology of Music)第 15 卷第 1 期第 58–75 页,题为《对所感知自由节奏的模仿:一项初步研究》。文献类型为期刊论文,研究主题为受试者对所听 rubato(弹性速度,即演奏中节拍的伸缩处理)的听辨与再现。
补充说明
rubato 为意大利语借词,指演奏中对节拍进行的有意伸缩以增强表现力。
第7段(P0102)
原文复述
Davidson, J. W., and M. C. Broughton. 2016. “Bodily Mediated Coordination, Collaboration, and Communication in Music Performance.” In Oxford Handbook of Music Psychology, edited by S. Hallam, I. Cross, and M. Thaut, 2nd ed., 573–595. Oxford: Oxford University Press.
中文讲解
Davidson 与 Broughton 2016 年发表的章节《音乐演奏中身体中介的协调、协作与交流》,收录于 Hallam、Cross、Thaut 主编的《牛津音乐心理学手册》(第 2 版)第 573–595 页,由牛津大学出版社出版。文献类型为手册章节,研究主题为身体动作在合奏与演奏交流中的中介作用。
补充说明
原文中 “Oxford Handbook ofMusic” 之间无空格,疑为排版或 OCR 问题,未予改动。
第8段(P0103)
原文复述
Dunning, D., K. Johnson, J. Ehrlinger, and J. Kruger. 2003. “Why People Fail to Recognize Their Own Incompetence.” Current Directions in Psychological Science 12 (3): 83–87. https://doi.org/10.1111/1467-8721.01235.
中文讲解
Dunning、Johnson、Ehrlinger 与 Kruger 2003 年发表于《心理科学当前方向》(Current Directions in Psychological Science)第 12 卷第 3 期第 83–87 页,题为《人们为何未能识别自身的无能》。文献类型为期刊论文,研究主题为“邓宁—克鲁格效应”:低能力者因缺少元认知能力而难以识别自身不足。
第9段(P0104)
原文复述
Fingerhut, J., and J. J. Prinz. 2018. “Wonder, Appreciation, and the Value of Art.” Progress in Brain Research 237: 107–128. https://doi.org/10.1016/bs.pbr.2018.03.004.
中文讲解
Fingerhut 与 Prinz 2018 年发表于《脑研究进展》(Progress in Brain Research)第 237 卷第 107–128 页,题为《惊奇、欣赏与艺术的价值》。文献类型为期刊论文,研究主题为审美体验中“惊奇”(wonder)与“欣赏”(appreciation)在艺术价值判断中的作用。
第10段(P0105)
原文复述
Fitts, P. M., and M. I. Posner. 1967. Human Performance. Belmont, CA: Brooks/Cole.
中文讲解
Fitts 与 Posner 1967 年出版的专著《人类操作绩效》(Human Performance),由位于加州 Belmont 的 Brooks/Cole 出版社出版。文献类型为专著,主题为人类动作技能的获得与绩效,属于经典认知—运动心理学教材。
第11段(P0106)
原文复述
Hallam, S. 2010. “Transitions and the Development of Expertise.” Psychology Teaching Review 16 (2): 3–32. https://doi.org/10.53841/bpsptr.2010.16.2.3.
中文讲解
Hallam 2010 年发表于《心理学教学评论》(Psychology Teaching Review)第 16 卷第 2 期第 3–32 页,题为《过渡阶段与专长的发展》。文献类型为期刊论文,主题为个体在不同发展阶段过渡中如何逐步获得专业能力。
补充说明
原文中 “https:// doi.org” 之前多一个空格,疑为 OCR 问题,未予改动。
第12段(P0107)
原文复述
Holmes, P. A. 2012. “An Exploration of Musical Communication Through Expressive use of Timbre: The Performer’s Perspective.” Psychology of Music 40 (3): 301–323. https://doi.org/10.1177/0305735610388898.
中文讲解
Holmes 2012 年发表于《音乐心理学》(Psychology of Music)第 40 卷第 3 期第 301–323 页,题为《通过音色表现性运用探索音乐交流:演奏者的视角》。文献类型为期刊论文,研究主题为演奏者如何通过音色(timbre)的表现性运用实现音乐交流。
补充说明
原文中 “ofMusic” 之间无空格,疑为排版或 OCR 问题,未予改动;timbre 指音色,即不同乐器/人声在音质上的辨识性特征。
第13段(P0108)
原文复述
Juslin, P. N., J. Karlsson, E. Lindström, A. Friberg, and E. Schoonderwaldt. 2006. “Play It Again with Feeling: Computer Feedback in Musical Communication of Emotions.” Journal of Experimental Psychology: Applied 12 (2): 79–95. https://doi.org/10.1037/1076-898X.12.2.79.
中文讲解
Juslin、Karlsson、Lindström、Friberg 与 Schoonderwaldt 2006 年发表于《实验心理学杂志:应用》(Journal of Experimental Psychology: Applied)第 12 卷第 2 期第 79–95 页,题为《带感情再奏一遍:音乐情感交流中的计算机反馈》。文献类型为期刊论文,研究主题为通过计算机系统向演奏者提供反馈以改善情感交流。
第14段(P0109)
原文复述
Juslin, P. N., and P. Laukka. 2000. “Improving Emotional Communication in Music Through Cognitive Feedback.” Musicae Scientiae 4: 151–183. https://doi.org/10.1177/102986490000400202.
中文讲解
Juslin 与 Laukka 2000 年发表于《音乐科学》(Musicae Scientiae)第 4 卷第 151–183 页,题为《通过认知反馈改善音乐中的情感交流》。文献类型为期刊论文,研究主题为认知反馈对演奏者传达音乐情感能力的提升作用。
补充说明
Musicae Scientiae 为期刊正式名称,使用拉丁语;该刊是欧洲音乐心理学领域的核心期刊之一。
第15段(P0110)
原文复述
Juslin, P. N., and E. Lindström. 2016. “Emotion in Music Performance.” In The Oxford Handbook of Music Psychology, edited by S. Hallam, I. Cross, and M. Thaut, 2nd ed., 597–614. Oxford: Oxford University Press.
中文讲解
Juslin 与 Lindström 2016 年发表的章节《音乐演奏中的情感》,收录于 Hallam、Cross、Thaut 主编的《牛津音乐心理学手册》(第 2 版)第 597–614 页,由牛津大学出版社出版。文献类型为手册章节,主题为演奏过程中情感的产生、表达与知觉。
第16段(P0111)
原文复述
Kaimal, G. 2022. The Expressive Instinct: How Imagination and Creative Works Help us Survive and Thrive. New York: Oxford University Press.
中文讲解
Kaimal 2022 年出版的专著《表现的本能:想象与创意作品如何助我们生存与繁荣》,由纽约牛津大学出版社出版。文献类型为专著,主题为表现性冲动(即人类通过艺术与想象进行表达的内驱力)及其对身心健康与社会适应的价值。
第17段(P0112)
原文复述
Karlsson, J., and P. N. Juslin. 2008. “Musical Expression: An Observational Study of Instrumental Teaching.” Psychology of Music 36 (3): 309–334. https://doi.org/10.1177/0305735607086040.
中文讲解
Karlsson 与 Juslin 2008 年发表于《音乐心理学》(Psychology of Music)第 36 卷第 3 期第 309–334 页,题为《音乐表现:器乐教学的观察研究》。文献类型为期刊论文,研究方法为对器乐课堂教学的观察,主题为教师在课堂上实际使用的音乐表现性教学策略。
第18段(P0113)
原文复述
Larrouy-Maestri, P., X. Wang, R. V. Nunes, and D. Poeppel. 2023. “Are you Your Own Best Judge? On the Self-Evaluation of Singing.” Journal of Voice 37 (4): 633.e7–633.e14. https://doi.org/10.1016/j.jvoice.2021.03.028
中文讲解
Larrouy-Maestri、Wang、Nunes 与 Poeppel 2023 年发表于《嗓音杂志》(Journal of Voice)第 37 卷第 4 期第 633.e7–633.e14 页,题为《你是自己最好的评判者吗?论歌唱的自我评价》。文献类型为期刊论文,研究主题为歌唱者自我评价与外部评价之间的吻合程度。
补充说明
页码中 “e7–e14” 表示该篇文章在期刊中的电子页编号(electronic pagination)。
第19段(P0114)
原文复述
Leech-Wilkinson, D. 2009. The Changing Sound of Music: Approaches to the Study of Recorded Musical Performances. London: Centre for the History and Analysis of Recorded Music.
中文讲解
Leech-Wilkinson 2009 年出版的专著《不断变化的声音:研究录音演奏的方法》,由伦敦录音音乐历史与分析中心出版。文献类型为专著,主题为对录音中历史演奏的方法论研究,关注录音技术与社会审美如何共同塑造演奏风格的变迁。
第20段(P0115)
原文复述
Leech-Wilkinson, D., and H. M. Prior. 2014. “Heuristics for Expressive Performance.” In Expressiveness in Music Performance: Empirical Approaches Across Styles and Cultures, edited by D. Fabian, R. Timmers, and E. Schubert, 34–57. Oxford: Oxford University Press.
中文讲解
Leech-Wilkinson 与 Prior 2014 年发表的章节《表现性演奏的启发式》,收录于 Fabian、Timmers、Schubert 主编的《音乐演奏中的表现性:跨风格与跨文化的实证方法》第 34–57 页,由牛津大学出版社出版。文献类型为手册章节,主题为演奏者在表现性处理中所使用的启发式(heuristics)规则。
补充说明
heuristics 指启发式,即个体在复杂任务中用以简化决策的经验法则。
第21段(P0116)
原文复述
Lindström, E., P. N. Juslin, R. Bresin, and A. Williamon. 2003. “Expressivity Comes from Within Your Soul’: A Questionnaire Study of Music Students’ Perspectives on Expressivity.” Research Studies in Music Education 20: 23–47. bttps://doi.org/10.1177/1321103X030200010201.
中文讲解
Lindström、Juslin、Bresin 与 Williamon 2003 年发表于《音乐教育研究》(Research Studies in Music Education)第 20 卷第 23–47 页,题为《“表现力来自你的内心”:音乐学生表现力观念的问卷研究》。文献类型为期刊论文,研究方法为问卷调查,主题为音乐学生对表现力的理解与表述。
补充说明
原文 DOI 链接写作 “bttps://",疑为 OCR 将 “https” 误读,未予改动;DOI 格式显示该文章编号含 “X” 字符。
第22段(P0117)
原文复述
McPhee, E. A. 2011. “Finding the Muse: Teaching Musical Expression to Adolescents in the one-to-one Studio Environment.” International Journal of Music Education 29 (4): 333–346. https://doi.org/10.1177/0255761411421084.
中文讲解
McPhee 2011 年发表于《国际音乐教育杂志》(International Journal of Music Education)第 29 卷第 4 期第 333–346 页,题为《寻找缪斯:一对一工作室环境中青少年音乐表现教学》。文献类型为期刊论文,研究主题为在一对一器乐工作室情境中向青少年教授音乐表现性的方法。
补充说明
原文中 “https://doi.org/10.1177/ 0255761411421084” 之间有一空格,疑为 OCR 问题,未予改动;one-to-one studio 指一对一个别课教学,常见于西方器乐教学传统。
第23段(P0118)
原文复述
Meissner, H. 2017. “Instrumental Teachers’ Instructional Strategies for Facilitating Children’s Learning of Expressive Music Performance: An Exploratory Study.” International Journal of Music Education 35 (1): 118–135. https://doi.org/10.1177/0255761416643850.
中文讲解
Meissner 2017 年发表于《国际音乐教育杂志》(International Journal of Music Education)第 35 卷第 1 期第 118–135 页,题为《器乐教师促进儿童学习表现性音乐演奏的教学策略:一项探索性研究》。文献类型为期刊论文,研究主题为器乐教师在儿童表现性演奏教学中所使用的具体教学策略。
补充说明
原文中 “ofMusic” 之间无空格,疑为排版或 OCR 问题,未予改动。
第24段(P0119)
原文复述
Meissner, H. 2021. “Theoretical Framework for Facilitating Young Musicians’ Learning of Expressive Performance.” Frontiers in Psychology 11: 584171. https://doi.org/10.3389/fpsyg.2020.584171
中文讲解
Meissner 2021 年发表于《心理学前沿》(Frontiers in Psychology)第 11 卷(文章编号 584171),题为《促进年轻音乐家学习表现性演奏的理论框架》。文献类型为开放获取期刊论文,主题为面向年轻音乐家表现性演奏学习的综合性理论框架建构。
补充说明
Frontiers in Psychology 为开放获取期刊,文章以编号 “584171” 标识而非传统页码;DOI 中年份 2020 与期刊年份 2021 不一致,提示文章系 2020 年接收/上线、2021 年正式刊出。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为参考文献列表(References),无脚注、无图、无表、无边栏文本;所列文献按作者姓氏字母顺序排列,每条均含作者、年份、标题、出版载体(期刊/书章/专著)、卷期页码或文章号,以及必要的 DOI 链接。原始 PDF 提取中存在少量 OCR/排版瑕疵(如 “ofMusic” 缺空格、“bttps” 误写、个别 DOI 含多余空格),均在复述中如实保留。
💡 本节核心要点
- 本节为单一参考文献列表,按作者姓氏字母顺序组织,共收录 24 条文献(含 1 个二级标题段落),涵盖期刊论文、手册章节、会议论文集章节与专著四种类型。
- 文献的来源学科以音乐心理学为主(《Psychology of Music》《Music Perception》《Musicae Scientiae》《JEP: Applied》等),并辅以音乐教育期刊(如 IJME、RSME、JRMME)与综合心理学/认知期刊。
- 按主题聚类,文献主要围绕五个反复出现的轴心:音乐演奏中的情感表达与交流(Juslin 系列、Bonastre & Timmers、Holmes)、表现性演奏的教学与学习(Meissner 2017/2021、Karlsson & Juslin、McPhee、Arrais & Rodrigues)、演奏中的自我评价与元认知(Bergee、Dunning 等、Larrouy-Maestri 等)、演奏中的身体—动作协调(Davidson & Broughton、Fitts & Posner)以及演奏表现性的解释与历史研究(Leech-Wilkinson 及其合作者、Fingerhut & Prinz)。
- 若干文献明显居于该领域的核心地位并被多次引用:Juslin、Lindström、Meissner 三位作者在本参考列表中各出现两次以上,构成方法论与实证层面的主要引用骨架。
- 列表中混入了少量音乐领域之外的跨学科文献(Dunning et al. 2003 的“邓宁—克鲁格效应”、Fitts & Posner 1967 的动作技能理论、Fingerhut & Prinz 2018 的审美惊奇与价值论),提示本文论题在自我评价与表达性方面具有跨学科理论支撑。
🔑 关键术语
- Cognitive feedback(认知反馈):指以受控、可意识化的方式向演奏者提供关于其表现性处理的信息,多用于研究如何改善音乐中的情感交流(Juslin & Laukka 2000;Juslin 等 2006;Arrais & Rodrigues 2007)。
- Rubato:源自意大利语,指演奏中对节拍速度进行的有意伸缩,是表现性演奏中最常被研究的处理手法之一(Clarke & Baker-Short 1987)。
- Timbre:音色,即不同乐器或人声在音质上的辨识性特征;本列表中 Holmes 2012 研究演奏者如何通过音色实现音乐交流。
- Heuristics(启发式):个体在面对复杂任务时用以简化决策的经验法则;Leech-Wilkinson & Prior 2014 探讨表现性演奏中所使用的启发式。
- Self-evaluation(自我评价):个体对自身表现的评估行为;本列表中 Bergee 1997、Larrouy-Maestri 等 2023 直接研究演奏/歌唱的自我评价,并与 Dunning 等 2003 关于元认知缺陷的经典理论相呼应。
S29 [描述性拆分] 参考文献续
第1段(P0120)
原文复述
Persky, A. M., E. Lee, and L. S. Schlesselman. 2020. “Perception of Learning Versus Performance as Outcome Measures of Educational Research.” American Journal of Pharmaceutical Education 84 (7), Article 7782. https://doi.org/10.5688/ajpe7782.
中文讲解
Persky、Lee 与 Schlesselman(2020)发表于《American Journal of Pharmaceutical Education》84 卷第 7 期,文章编号 7782,DOI 为 10.5688/ajpe7782。这是一篇药学教育领域的研究,主题是“学习”与“表现”两种指标在教育研究中的差异,即研究者、被研究者(教师和学生)常会把“以为自己学到了”的主观感受(perception of learning)与“实际表现出来的能力”(performance)混淆。该篇虽不属于音乐学,但属于教育研究方法学文献,对主论文区分“自我报告式学习感受”与“可测量的演奏表现”很有支撑作用:它提醒作者,在量化“教学干预是否真的改善了演奏”时,不能只问学生“你觉得学到了吗”,而需要独立测量其表现。这一区别对评估隐喻教学、元认知训练等干预效果至关重要。
补充说明
该条目提供了 DOI,便于核实。属于“非音乐类但教育研究方法学”参考,作用是支持论文中“区分学习感受与表现结果”这一方法论立场。
第2段(P0121)
原文复述
Persson, R. 1996. “Brilliant Performers as Teachers: A Case Study of Commonsense Teaching in a Conservatoire Setting.” International Journal of Music Education 28:25–36. https://doi.org/10.1177/025576149602800103.
中文讲解
Persson(1996)发表于《International Journal of Music Education》第 28 期,页码 25–36,DOI 为 10.1177/025576149602800103。该文是一篇音乐学院情境下的案例研究,研究对象是“技艺精湛的演奏家作为教师”时,凭借“常识式教学”(commonsense teaching)所做的事情。它聚焦资深演奏家在教学中所依赖的、未必被理论化的实践知识与口传经验,是研究专家型教师教学语言(包括隐喻)的重要经验来源。对主论文而言,这篇参考为“演奏家教师使用直觉性语言”这一现象提供了经典文献基础。
补充说明
该条目提供的期刊卷期为 28(而非年号),是 IJME 早期卷号编号方式。需注意 DOI 前缀 10.1177 对应 SAGE 出版平台。
第3段(P0122)
原文复述
Schippers, H. 2006. “As if a Little Bird is Sitting on Your Finger … ’: Metaphor as a key Instrument in Training Professional Musicians.” International Journal of Music Education 24 (3): 209–217. https://doi.org/10.1177/ 0255761406069640.
中文讲解
Schippers(2006)发表于《International Journal of Music Education》第 24 卷第 3 期,页码 209–217,DOI 为 10.1177/0255761406069640。文章标题中的引语“就好像一只小鸟停在你的手指上……”直接取自音乐教学中常见的隐喻实例,其核心论点是:隐喻是训练职业音乐家的关键工具(key instrument)。Schippers 主张音乐教师普遍借助隐喻把抽象的声音感受、动作感觉、身体姿态传达给学生,隐喻因此承担了“无法直接说出的知识”的传递功能。此条目对主论文关于“音乐教学中隐喻的功能与机制”的论证是直接相关的核心理论来源。
补充说明
标题中出现了孤悬的右单引号 ’,疑为左单引号在排版时丢失,是 OCR/排版瑕疵。DOI 行内出现了一个多余的空格(10.1177/ 0255761406069640),并非作者本意。
第4段(P0123)
原文复述
Van Elferen, I. 2020. Timbre: Paradox, Materialism, Vibrational Aesthetics. Bloomsbury.
中文讲解
Van Elferen(2020)由 Bloomsbury 出版的专著《Timbre: Paradox, Materialism, Vibrational Aesthetics》(《音色:悖论、唯物论、振动美学》)。这是一本研究“音色”(timbre)的理论性著作,从悖论、唯物论与振动美学三种角度切入,探讨音色在音乐、美学与物质性中的复杂地位。该参考为主论文中涉及“声音的质感如何被感知、被谈论、被教学”这一议题提供了更宏观的美学—哲学背景,使音色不仅是声学参数,也是可被体验、可被隐喻化的对象。
补充说明
该条无 DOI,属专著类引用。出版地默认伦敦(Bloombury 总部)。
第5段(P0124)
原文复述
Wallmark, Z. 2019. “A Corpus Analysis of Timbre Semantics in Orchestration Treatises.” Psychology ofMusic 47 (4): 585–605. https://doi.org/10.1177/0305735618768102.
中文讲解
Wallmark(2019)发表于《Psychology of Music》第 47 卷第 4 期,页码 585–605,DOI 为 10.1177/0305735618768102。该文对配器法论著(orchestration treatises)中的“音色语义”进行了语料库分析(corpus analysis),即系统统计作曲家与配器者用什么词汇来描述音色,以揭示音色语义的语言学结构。该研究是从语言学/计量方法角度处理“如何谈论音色”这一主题的代表性工作,呼应了主论文关于“教学中如何用语言描绘声音”的关切,并提供了实证方法学范例(语料库方法)。
补充说明
原文期刊名 Psychology ofMusic 中 “Music” 前缺一空格,属 OCR 造成的版式瑕疵;正确刊名为 Psychology of Music。
第6段(P0125)
原文复述
Williamon, A.2004. Musical Excellence: Strategies and Techniques to Enhance Performance. Oxford: Oxford University Press.
中文讲解
Williamon(2004)由牛津大学出版社出版的专著《Musical Excellence: Strategies and Techniques to Enhance Performance》(《音乐卓越:提升演奏的策略与技术》)。该书综合了音乐表演心理与训练方法的研究成果,是音乐表演研究领域的经典教科书/参考书之一。它对主论文的意义在于:它为“如何系统提升演奏表现”提供了框架性参考,文中所讨论的策略与技术涉及练习、表现焦虑、自我调节、元认知等内容,与隐喻教学、表达性演奏教学等议题有直接交集。
补充说明
作者名与年份之间缺一空格(Williamon, A.2004),属排版/OCR 瑕疵;正式书写应为 Williamon, A. 2004。
第7段(P0126)
原文复述
Wolfe, J. 2019. “An Investigation Into the Nature and Function of Metaphor in Advanced Music Instruction.” Research Studies in Music Education 41 (3): 280–292. https://doi.org/10.1177/1321103X18773113.
中文讲解
Wolfe(2019)发表于《Research Studies in Music Education》第 41 卷第 3 期,页码 280–292,DOI 为 10.1177/1321103X18773113。该文研究高级音乐教学中隐喻的本质与功能,正是主论文最直接对应的主题之一:什么样的隐喻在高级教学中出现、它们起到何种教学功能、它们如何把抽象的演奏意图传达给学生。该文献可作为主论文实证部分的对照来源(comparison)或佐证。
补充说明
该条目提供的 DOI 与 SAGE 期刊一致,可核实。注意页码区间 280–292 与年份 2019 共同确定了文章在该卷中的位置。
第8段(P0127)
原文复述
Woody, R. H. 1999. “The Relationship Between Advanced Musicians’ Explicit Planning and Their Expressive Performance of Dynamic Variations in an Aural Modeling Task.” Journal of Research in Music Education 47:331–342. https://doi.org/10.2307/3345488.
中文讲解
Woody(1999)发表于《Journal of Research in Music Education》第 47 卷,页码 331–342,DOI 为 10.2307/3345488。该文研究高级音乐家在听觉示范任务(aural modeling task)中“显性规划”(explicit planning,即演奏前有意识地对力度变化等表达参数进行规划)与“表达性演奏表现”之间的关系。它属于 Woody 对“演奏中的认知—表达”研究系列的开端,对主论文中关于“表达性演奏受何种认知因素驱动”的部分提供早期实证依据。
补充说明
该卷仅给到卷号 47,未列期号(issue number),是 JRME 在某些年份的排版惯例。DOI 前缀 10.2307 对应 JSTOR 平台。
第9段(P0128)
原文复述
Woody, R. H. 2002. “Emotion, Imagery and Metaphor in the Acquisition of Musical Performance Skill.” Music Education Research 4 (2): 213–224. https://doi.org/10.1080/1461380022000011920.
中文讲解
Woody(2002)发表于《Music Education Research》第 4 卷第 2 期,页码 213–224,DOI 为 10.1080/1461380022000011920。该文讨论情感、意象与隐喻在获取演奏技能中的作用,把“情感(emotion)、心理意象(imagery)、隐喻(metaphor)”三者并置为核心教学/学习机制。该条目对主论文至关重要:它直接对应主论文的主题(隐喻在表达性教学中的作用),并把隐喻置于情感与意象的更大学习机制网络中,提示隐喻并非孤立现象,而是与情感唤起、心理意象相互交织。
补充说明
该条目提供的 DOI 前缀 10.1080 对应 Taylor & Francis 平台。该文是 Woody 系列中对隐喻作为学习机制论述最集中的一篇。
第10段(P0129)
原文复述
Woody, R. H. 2003. “Explaining Expressive Performance: Component Cognitive Skills in an Aural Modeling Task.” Journal of Research in Music Education 51:51–63. https://doi.org/10.2307/3345648.
中文讲解
Woody(2003)发表于《Journal of Research in Music Education》第 51 卷,页码 51–63,DOI 为 10.2307/3345648。该文在 1999 年听觉示范任务研究的基础上,进一步把“表达性演奏”分解为若干组成性认知技能(component cognitive skills),考察演奏者在听觉示范任务中各项子技能如何共同导致表达性表现。该条目为“表达性演奏并非单一能力,而是多成分认知加工的合成结果”这一立场提供证据,与主论文在解释“为何隐喻能促成表达性表现”时可能涉及的认知成分分析形成呼应。
补充说明
同样仅给卷号未给期号。DOI 前缀 10.2307 表明文献存档于 JSTOR。
第11段(P0130)
原文复述
Woody, R. H. 2006a. “Musician’s Cognitive Processing of Imagery-based Instructions for Expressive Performance.” Journal of Research in Music Education 54 (2): 125–137. https://doi.org/10.1177/002242940605400204.
中文讲解
Woody(2006a)发表于《Journal of Research in Music Education》第 54 卷第 2 期,页码 125–137,DOI 为 10.1177/002242940605400204。该文研究音乐家对“基于意象的指导”(imagery-based instructions)的认知加工,关注当教师给出心理意象式教学语言时,演奏者是如何在认知层面处理这些语言并将其转化为表达性演奏的。它为主论文提供了“意象—隐喻教学—表达性演奏”这一链条的实证证据,区别于 2006b 的“不同教学条件效应”研究。
补充说明
“2006a”标记说明同年有两篇文献并列,下一条 2006b 即为另一篇。DOI 中期刊前缀 00224294 即 JRME 的 ISSN。
第12段(P0131)
原文复述
Woody, R. H. 2006b. “The Efect of Various Instructional Conditions on Expressive Music Performance.” Journal of Research in Music Education 54 (1): 21–36. https://doi.org/10.1177/002242940605400103.
中文讲解
Woody(2006b)发表于《Journal of Research in Music Education》第 54 卷第 1 期,页码 21–36,DOI 为 10.1177/002242940605400103。该文研究“不同教学条件”对表达性演奏的影响,通过对比若干教学情境来评估哪种条件最能提升演奏的表达性。与 2006a 偏认知加工分析不同,2006b 偏教学干预效应,二者形成方法学互补。该条目对主论文在讨论“什么样的教学语言/方法真正有效”这一问题时是关键实证来源。
补充说明
原文标题中 “Efect” 系 “Effect” 的拼写错误或 OCR 错误,正式出版中应为 Effect。
第13段(P0132)
原文复述
Woody, R. H., and G. E. McPherson. 2010. “Emotion and Motivation in the Lives of Performers.” In Handbook of Music and Emotion: Theory, Research, Applications, edited by P. N. Juslin and J. A. Sloboda, 401–424. Oxford: Oxford University Press.
中文讲解
Woody 与 McPherson(2010)合著的章节《Emotion and Motivation in the Lives of Performers》(《演奏者生活中的情感与动机》),收录于 Juslin 与 Sloboda 主编的《Handbook of Music and Emotion: Theory, Research, Applications》(《音乐与情感手册:理论、研究、应用》),由牛津大学出版社出版,章节页码 401–424。该章概述演奏者如何在日常练习与舞台表演中体验情感与动机,是该手册中最直接涉及演奏者主体的章节之一。该条目对主论文在“演奏者主体如何被情感与动机驱动”这一层面提供综述性参考。
补充说明
该条是图书章节(book chapter)而非期刊文章,故无 DOI。该手册是音乐情感研究领域的标志性参考文献。
第14段(P0133)
原文复述
Zimmerman, D. W., and B. D. Zumbo. 2014. “The Relative Power of Parametric and Nonparametric Statistica Methods.” In A Handbook for Data Analysis in the Behavioral Sciences: Methodological Issues, edited by G. Keren and C. Lewis, 481–517. Psychology Press.
中文讲解
Zimmerman 与 Zumbo(2014)合著的章节《The Relative Power of Parametric and Nonparametric Statistical Methods》(《参数与非参数统计方法的相对检验效力》),收录于 Keren 与 Lewis 主编的《A Handbook for Data Analysis in the Behavioral Sciences: Methodological Issues》(《行为科学数据分析手册:方法学问题》),由 Psychology Press 出版,章节页码 481–517。该章比较参数统计与非参数统计方法在行为科学研究中的相对检验效力(power),为“在不满足正态假设或样本较小的情况下应选用何种统计方法”提供方法学指导。该条目对应主论文中可能涉及的统计决策,是其方法学基础文献。
补充说明
标题中“Statistica”系“Statistical”的拼写错误或 OCR 错误,正式出版中应为 Statistical。该章是行为科学统计方法学的经典文献。
第15段(P0134)
原文复述
Zorzal, R. C. 2020. “Emotion-related Words and Emotional Analogies as Teaching Strategies for Expressivity.” Research Studies in Music Education, https://doi.org/10.1177/1321103X19899169.
中文讲解
Zorzal(2020)发表于《Research Studies in Music Education》,DOI 为 10.1177/1321103X19899169。该文研究“情感相关词汇与情感类比”(emotion-related words and emotional analogies)作为教授表达性演奏(expressivity)的教学策略。它把“用情感语言描述音乐”作为教学手段之一加以检验,与主论文关于“语言/隐喻如何促成表达”的议题直接相关,可作为重要对比或参考。
补充说明
该条目中未列出卷期与页码,仅有 DOI 与期刊名,符合 SAGE 的“先在线发表(OnlineFirst)”引用格式;卷期信息将在论文正式刊出后补全。
第16段(P0135)
原文复述
Zorzal, R. C., and J. F. Soares-Quadros Jr. 2021. “Taste the Value of Each Note’: Verbal Teaching Strategies in Guitar Masterclasses.” Music Education Research 23 (4): 498–511. https://doi.org/10.1080/14613808.2021.1949271.
中文讲解
Zorzal 与 Soares-Quadros Jr.(2021)合著发表于《Music Education Research》第 23 卷第 4 期,页码 498–511,DOI 为 10.1080/14613808.2021.1949271。该文研究吉他大师课(guitar masterclasses)中教师使用的口头教学策略(verbal teaching strategies),标题中“品尝每个音符的价值”即为典型口头策略的实例。该文献属于“大师班语境下的口头教学语言”这一最新研究,是对主论文核心议题(教学中的语言/隐喻策略)的重要近期参考。
补充说明
该 DOI 前缀 10.1080 对应 Taylor & Francis 平台。文献标题中的左单引号在原条中缺失(仅出现右单引号 ’),属排版/OCR 瑕疵。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为参考文献列表的延续部分(页 13),共 16 条文献条目(P0120–P0135),全部为英文文献条目(其中 P0120 为药学教育期刊文献,其余主要为音乐表演、音乐教育、统计方法等领域)。条目类型涵盖期刊文章(P0120–P0122、P0124、P0126–P0131、P0134、P0135)、专著(P0123、P0125)、图书章节(P0132、P0133)。存在若干 OCR/排版瑕疵:P0122 DOI 内多一空格;P0124 期刊名 Psychology ofMusic 缺空格;P0125 作者与年份之间缺空格;P0131 标题 Efect 应为 Effect;P0133 标题 Statistica 应为 Statistical;P0135 标题左单引号缺失。
💡 本节核心要点
- 本节文献以音乐表演研究与音乐教育研究为核心,辅以一两条教育方法学(P0120)与统计方法学(P0133)文献,说明主论文跨越学科边界。
- 隐喻与意象作为教学/学习机制是本节文献的明显主线:P0122、P0126、P0128、P0130、P0134、P0135 均直接讨论音乐教学中隐喻或类比语言的功能与效果。
- 表达性演奏(expressive performance)及其认知与情感基础是本节的另一条主线:P0127–P0131、P0132 共同构成 Woody 等人对演奏者认知加工、情感、动机的系统性研究链。
- R. H. Woody 是本节文献中最集中出现的作者(共 6 条),体现其作为“演奏认知—表达”研究领域核心学者的地位。
- 音色(timbre)的语义与教学语言构成本节的第三主题:P0123、P0124 从美学与语料库方法两方面进入音色如何被谈论的问题。
- 本节末尾条目(P0134、P0135)为 2020–2021 年最新文献,表明主论文梳理了至 2021 年的相关研究进展。
🔑 关键术语
- 隐喻(metaphor):在本节多篇文献中作为音乐教学语言的核心机制出现,被理解为把抽象声音感受、演奏意图传达给学生的工具(P0122、P0126、P0128)。
- 表达性演奏(expressive performance):指演奏中超越音符准确性的力度、节奏、表情等表达维度,是本节多篇实证研究(P0127–P0131)的因变量或核心议题。
- 意象(imagery):指音乐家在心理上对声音、动作或情感的表征;P0128、P0130 把意象与隐喻、情感并列视为演奏技能获得与表达的关键心理机制。
- 听觉示范任务(aural modeling task):Woody 系列研究(P0127、P0129)中使用的实验范式,要求演奏者在听示范后重现表达性处理,是研究“听觉—表达”转化的标准任务。
- 音色(timbre):指声音的质感或“颜色”,是 P0123 与 P0124 的研究对象;在本节语境中与“如何用语言描述声音”相关。
- 参数统计与非参数统计(parametric vs. nonparametric statistics):P0133 所讨论的两种统计方法选择问题,关系到主论文在样本较小或不满足正态假设时如何选择合适分析方法。