目录
CH1 Introduction and Research Purpose
- CH1_S1 [描述性拆分] Abstract Overview of the Study
- 页码:1-1
- CH1_S2 [描述性拆分] Author Affiliation and Article Title
- 页码:1-1
- CH1_S3 [描述性拆分] The Challenge of Teaching Musical Expressivity
- 页码:1-1
- CH1_S4 [描述性拆分] Author Note
- 页码:1-1
- CH1_S5 [描述性拆分] Concrete Musical Instruction as an Alternative to Imitation
- 页码:2-2
- CH1_S6 [描述性拆分] Mental Imagery and Metaphor in Expressivity Instruction
- 页码:2-3
- CH1_S7 [描述性拆分] Underlying Beliefs About Musical Expression
- 页码:3-3
- CH1_S8 [描述性拆分] Purpose of the Study
- 页码:3-3
CH2 Method
- CH2_S1 [描述性拆分] Method Overview and Participants
- 页码:3-3
- CH2_S2 [描述性拆分] Musical Materials Figure
- 页码:4-4
- CH2_S3 [描述性拆分] Selection and Provenance of the Melodies
- 页码:5-5
- CH2_S4 Creation of Instructional Materials
- 页码:5-5
- CH2_S5 Procedure
- 页码:6-6
CH3 Results
- CH3_S1 [描述性拆分] Data Analysis Plan
- 页码:6-6
- CH3_S2 [描述性拆分] Practice and Listening Frequencies Across Conditions
- 页码:7-7
- CH3_S3 [描述性拆分] Melody 1: Mean Levels and Salient Properties
- 页码:7-7
- CH3_S4 [描述性拆分] Melody 1: Baseline Correlations and RMSE Changes
- 页码:7-7
- CH3_S5 [描述性拆分] Melody 1: Advanced Versus Competent Pianists
- 页码:8-8
- CH3_S6 [描述性拆分] Melody 1: Explaining the Tempo Worsening
- 页码:9-9
- CH3_S7 [描述性拆分] Melody 2: Mean Levels and Salient Properties
- 页码:9-9
- CH3_S8 [描述性拆分] Melody 2: Overall Improvements and Mode Comparisons
- 页码:9-9
- CH3_S9 [描述性拆分] Melody 2: Advanced Versus Competent Pianists
- 页码:9-9
- CH3_S10 [描述性拆分] Melody 3: Mean Levels and Salient Properties
- 页码:10-10
- CH3_S11 [描述性拆分] Melody 3: Articulation and Loudness Performance
- 页码:10-11
- CH3_S12 [描述性拆分] Melody 3: Advanced Versus Competent Pianists
- 页码:12-12
- CH3_S13 Additional Analysis of Verbal Reports
- 页码:12-12
CH4 Discussion
- CH4_S1 [描述性拆分] General Comparison of the Three Instructional Approaches
- 页码:12-12
- CH4_S2 [描述性拆分] Differences Between Advanced and Competent Pianists
- 页码:13-13
- CH4_S3 [描述性拆分] Implications for Teaching Expressive Performance
- 页码:13-13
- CH4_S4 [描述性拆分] Limitations and Generalizability to Younger Students
- 页码:13-13
- CH4_S5 [描述性拆分] Cognitive Translation of Metaphor and Imagery
- 页码:14-14
- CH4_S6 [描述性拆分] Combining Approaches in Authentic Teaching
- 页码:14-14
CH5 Note and References
- CH5_S1 Note
- 页码:14-14
- CH5_S2 References
- 页码:15-16
CH1_S1 [描述性拆分] Abstract Overview of the Study
第1段(P0001)
原文复述
This study is a comparison of the effectiveness of three approaches used to elicit expressivity in music students’ performances: (a) aural modeling, (b) verbal instruction addressing concrete musical properties, and (c) verbal instruction using imagery and metaphor. Thirty-six college pianists worked with three melodies, one in each instructional condition. With each, subjects first gave a baseline performance, then received instruction for performing more expressively, and then gave a final performance. Subjects also verbally reported their thoughts during the process. Results confirmed that musicians can accommodate all three types of instruction used in the study and that each has strengths and weaknesses related to the characteristics of the music being performed and the musicians themselves. Additionally, analysis of the verbal reports suggested that musicians may use a cognitive translation process whereby they convert metaphor/imagery information into more explicit plans for changing the expressive musical properties of their performance (e.g., loudness, tempo, articulation).
中文讲解
这是论文的摘要段落,集中交代了研究的设计与核心发现,需分四层拆解:
-
中心主张:研究比较了三种用来"诱发音乐学生演奏表现力"的教学法的有效性。关键词是 effectiveness 与 elicit——研究关注的是哪种方式更能让学生做出更具表现力的演奏,而不是看学生是否理解了指令本身。
-
三种教学条件:
- (a) aural modeling,听觉示范:通过范本演奏让学生模仿以获得表现力;
- (b) verbal instruction addressing concrete musical properties,针对具体音乐属性的口头指导:直接以响度、速度、咬字等技术参数为对象的语言指令;
- (c) verbal instruction using imagery and metaphor,使用意象与隐喻的口头指导:借助形象化语言(如"像叹息一样"“像说话那样”)传达表现意图。 (a) 与 (b)(c) 分属不同模态(听觉 vs. 语言),而 (b) 与 (c) 同属语言模态但抽象层级不同——一种是参数式的,一种是形象化的。这构成了研究的自变量结构。
-
被试、材料与程序:36 名大学钢琴学生,每人对应一段旋律、共三段,覆盖三种条件(被试内设计,让每位被试都接受全部三种处理)。流程为"基线演奏 → 接受指导 → 最终演奏",前后比较可衡量每种指导带来的表现力变化量。同时收集口语报告(verbal reports / think-aloud),用于追踪学生的内部加工过程。
-
结果分两层:
- 表层结论:学生能够接纳全部三种指导,且每种方法各有优势与局限,优劣取决于乐曲特征与演奏者个体特征。这意味着不存在单一"最优方法",教学应视情境选择。
- 深层结论:口语报告分析提示学生可能经历一种"认知翻译过程"——当接到隐喻/意象指令时,他们在内部将其转化为对具体演奏参数(响度、速度、articulation)的修改计划。这一点对理解"隐喻为何有效"具有理论意义:隐喻之所以奏效,并非直接作用于肌肉动作,而是被学习者先翻译成了显性技术操作。
-
在本节中的作用:作为论文开篇的摘要,预告了研究问题、方法、结果与理论含义,让读者快速定位后文将要详细展开的内容。
补充说明
无额外补充。artuculation 在钢琴语境中指触键方式与音符之间的衔接方式(断奏、连奏等),在原文中已通过"loudness, tempo, articulation"这一并列结构给出功能定位。
💡 本节核心要点
🔑 关键术语
- aural modeling:听觉示范:通过教师或范本演奏来传递表现力、让学生通过模仿获得更具表现力演奏的教学方式
- verbal instruction addressing concrete musical properties:针对具体音乐属性的口头指导:直接以响度、速度、咬字等技术参数为对象的语言指令
- verbal instruction using imagery and metaphor:运用意象与隐喻的口头指导:以形象化、比喻性语言而非技术参数传达表现意图
- cognitive translation process:认知翻译过程:本研究提出的机制假设,指学习者将隐喻/意象类信息在内部转化为对显性演奏参数修改计划的过程
- baseline performance / final performance:基线演奏与最终演奏:同一段旋律在接受指导前后的两次演奏,用于测量指导带来的表现力变化量
- articulation (music):音乐中的咬字/发音方式:在钢琴语境下指触键方式与音符之间的衔接方式(如断奏、连奏)
CH1_S2 [描述性拆分] Author Affiliation and Article Title
第1段(P0002)
原文复述
Robert H. Woody, University of Nebraska–Lincoln
中文讲解
本段是论文首页的作者署名行,以二级标题(##)的版式呈现。冒号前的"Robert H. Woody"是作者姓名,冒号后逗号分隔的"University of Nebraska–Lincoln"是作者所属机构,表明该研究者任职于美国内布拉斯加大学林肯分校。在学术论文的首页版式中,这类署名行同时承担两项功能:一是明确论文的责任作者,二是通过机构归属为研究提供学术语境(读者可据此判断作者所处的学术传统与可调用资源)。本节作为论文的起始标识,先告诉读者"谁在写",下一段标题再告诉读者"写的是什么",两者构成首页的基本导航信息。
补充说明
“University of Nebraska–Lincoln"中的连接符在原文中为长破折号(en-dash, –),而非普通连字符(hyphen, -),这是该机构英文官方写法的一部分,复述时已按原文保留。
第2段(P0003)
原文复述
The Effect of Various Instructional Conditions on Expressive Music Performance
中文讲解
本段是论文的主标题,以一级标题(#)呈现:“The Effect of Various Instructional Conditions on Expressive Music Performance”,可译为"不同教学条件对表现性音乐演奏的影响”。标题本身就是对全文研究问题的浓缩:自变量为"Various Instructional Conditions"(多种教学条件,即多种不同的教学情境或干预方式),因变量为"Expressive Music Performance"(表现性音乐演奏,即演奏者在音乐表演中所呈现的情感与表达性要素,而非仅指技术准确性)。“The Effect of … on …“这一经典句式暗示研究关心的是因果性或相关性影响关系,而非单纯描述。标题中的"Various"一词提示作者会比较不止一种教学条件,从而使该研究在方法上具有对照或多组实验的色彩。综上,这一节把首页的两块元信息(作者+机构、标题)合在一起,完成了对论文身份的标识,并为后续摘要、引言中将要展开的研究问题设定了方向。
补充说明
“Expressive Music Performance"在音乐表演研究领域通常指演奏中超越音符准确性的表达层面(如力度变化、速度处理、句法、情感投射等),但本段并未在标题内展开定义;标题中的"Various"既可指数量的多种,也可指类型的多样,其确切含义需要结合后续正文才能确定,因此此处不进一步猜测。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节仅包含两个首页标识性段落,不含脚注、图表、公式或边栏。两段在原文中分别使用 Markdown 的二级标题(##)和一级标题(#)层级标记,对应论文首页"作者署名 + 机构"与"论文标题"两个标准版块。除正文复述与讲解中提到的连接符用法外,无其他附加材料需要汇总。
💡 本节核心要点
- 本节是论文首页的元信息标识段,由作者署名行和论文标题两行构成。
- P0002 明确论文唯一作者为 Robert H. Woody,所属机构为 University of Nebraska–Lincoln(内布拉斯加大学林肯分校)。
- P0003 给出论文标题,点明研究主题:不同教学条件对表现性音乐演奏的影响。
- 标题的句式"The Effect of A on B"揭示了自变量(多种教学条件)与因变量(表现性音乐演奏)之间的影响关系。
- “Various"暗示研究将比较多种教学条件,而非单一条件,这为后续方法部分的多组设计埋下伏笔。
- 作为开篇两段,本节不承担论证功能,而是为读者提供论文的"身份卡”——谁写的、写什么。
🔑 关键术语
- University of Nebraska–Lincoln:作者所属机构,美国内布拉斯加大学林肯分校;标题行通过这一信息为研究提供机构语境与学术归属。
- Expressive Music Performance:论文标题中的核心因变量概念,指演奏者在音乐表演中所呈现的表达性层面,区别于纯技术性演奏;本节标题未对其作进一步定义。
- Various Instructional Conditions:论文标题中的核心自变量概念,指多种不同的教学条件或干预方式;“Various"暗示研究将进行多组比较。
- The Effect of … on …:标题采用的句式,用于表达自变量对因变量的影响关系,提示研究关注条件与结果之间的因果或相关联系。
CH1_S3 [描述性拆分] The Challenge of Teaching Musical Expressivity
第1段(P0004)
原文复述
Victor Hugo, a writer and poet of the Romantic period, famously declared: “Music expresses that which cannot be said and on which it is impossible to be silent.“1 More contemporary arts philosophers have continued to underscore the thesis of ineffability—the claim that music can convey aspects of human experience, including emotional states, that words are unable to communicate. This question matters greatly to music educators, whom studies show regard expressivity as the most important quality of performance (Laukka, 2004; Woody, 2000) and whose teaching strategies are frequently dominated by teacher talk (e.g., Young, Burwell, & Pickup, 2003).
中文讲解
本段的功能是为整个小节奠定问题意识。作者先用维克多·雨果那句被广泛援引的名言——“音乐表达的是不可言说之物”——把"音乐表达情感而语言难以企及"这一观点带入读者视野;接着用"thesis of ineffability”(不可言说性论题)这一学术术语,把浪漫主义诗人的直觉表述转化为可被研究讨论的命题。
关键在于作者怎样把这一哲学命题与音乐教育现实对接:他援引 Laukka(2004)和 Woody(2000)的研究,指出教师把"表现力"视为演奏最重要的属性;紧接着又引用 Young、Burwell 与 Pickup(2003),指出教师的教学策略却主要由"教师讲授(teacher talk)“占据。这两条事实被并置后,就形成本节的核心张力——
最被看重的属性,却是最依赖语言来教的东西。
也就是说,表现力本身被认为极为重要,但教学手段却恰恰是用效果最值得怀疑的语言讲授。读者理解了这一点,就抓住了本节后文将要讨论"为什么要转向非语言教学"以及"非语言教学又有哪些局限"的根本动因。结尾的"1"是雨果名言的脚注引用标记,表明这句话的出处,并非正文编号。
补充说明
无额外补充。脚注标号"1"仅指向雨果原话出处,本段对其内容不展开讨论。
第2段(P0005)
原文复述
Possibly because emotional expressiveness in music is hard to put into words, it is regarded as elusive both to research and to instructional practice (Juslin & Persson, 2002). The hesitancy to attempt to articulate expressivity may explain why the nonverbal approach of aural modeling and imitation is so widely used (Dickey, 1992; Lindström, Juslin, Bresin, & Williamon, 2003), and why it has been affirmed as a component of effective music teaching (Ebie, 2004; Sang, 1987). Advanced music students are capable of imitating expressive models with striking precision, yet they encounter difficulty when the expressive features of a model do not align well with the music’s structural properties (Clarke, 1993; Woody, 1999). The modeling approach, however, is not without its limitations. Listening students cannot simply record the model and replay it from memory. Prior musical knowledge, expectations, and preferences always shape—and at times disrupt—hearing and encoding a model (Lisboa, Williamon, Zicari, & Eiholzer, 2005; Woody, 2002b).
中文讲解
本段承接前段揭示出的"语言难以教授表现力"这一困境,并把它推向具体的方法论后果。
第一层:为什么表现力显得"难以捉摸”。 作者用 Perhaps because…(或许正因为……)这一缓和的因果表述,将研究界和教学界对表现力的回避,与"情绪表达难以言说"这一前段建立的命题直接挂钩,引证 Juslin & Persson(2002)。注意作者并未把因果说成必然,而是用"或许"保留了推断性。
第二层:非语言教学的兴起。 由于不愿或难以用语言讲清表现力,“听觉示范—模仿(aural modeling and imitation)“这一非语言路径被广泛采用,并被 Ebie(2004)与 Sang(1987)等研究确认为有效教学的组成部分。
第三层:示范法的边界——结构匹配问题。 作者援引 Clarke(1993)和 Woody(1999),指出高水平学生虽能精确模仿示范,但当示范中的表情特征与乐曲结构特征不相吻合时,便出现困难。这一点很关键:它说明模仿并非机械复制,示范的"表达"必须与乐谱的"结构"相互契合才能被学生成功吸收。
第四层:示范法的根本局限——听者不是空白磁带。 作者用"However, is not without limitations"明确转折,再用"cannot simply tape-record the model into their memories and then play it back"这一生动比喻点出认知中介的必然存在。Lisboa 等(2005)和 Woody(2002b)的研究表明:学生先前的音乐知识、期待和偏好总是介入并有时干扰对示范的听觉编码与记忆存储。这也就意味着,即便绕开"语言"这一最弱的工具,听者自身的认知框架仍会介入教学过程——这正是本节标题"教音乐表现力的挑战"之所以是"挑战"而非"问题"的原因。
理解本段的关键,是抓住作者层层递进的逻辑:表达难以言说 → 转向示范模仿 → 示范有效但受结构匹配制约 → 模仿仍受学习者既有认知过滤 → 因此没有单一万全之法。
补充说明
段中"tape-record … play it back"是作者借磁带录音的日常经验做比喻,用来说明学习者不可能像空白媒介那样被动地、完全保真地存储示范;这一比喻与紧跟其后的"preexisting musical knowledge, expectations, and preferences"在认知层面相互印证。
脚注 / 边栏 / 图表 / 附加信息(如有)
无。P0004 中雨果名言后的上标"1"为脚注引用标记,其具体出处属于本节输入范围之外,本节不予展开。
💡 本节核心要点
- 音乐表达的"不可言说性(ineffability)“不仅是浪漫主义诗人的修辞,也是当代艺术哲学的核心论题,它奠定了本节讨论教学困难的理论起点。
- 音乐教育者把表现力视为演奏最重要的属性(Laukka, 2004; Woody, 2000),但其教学策略却主要由"教师讲授(teacher talk)“承担(Young et al., 2003),形成了"最重要的属性—最受限的工具"之间的张力。
- 正因为表现力难以言说,它在研究与教学中都被视为"难以捉摸(elusive)"(Juslin & Persson, 2002),这推动了非语言的"听觉示范—模仿(aural modeling and imitation)“方法的流行。
- 听觉示范法虽被证实有效(Ebie, 2004; Sang, 1987),但高水平学生在示范的表情特征与乐曲结构特征不相吻合时会出现困难(Clarke, 1993; Woody, 1999)。
- 示范法的根本局限在于学习者并非被动的"录音磁带”:先前的音乐知识、期待与偏好始终介入并有时干扰对示范的听觉编码(Lisboa et al., 2005; Woody, 2002b)。
- 本节由此确立的核心命题是:无论依赖语言讲授还是非语言示范,音乐表现力的教学都不可避免地受到某一中介——语言或听者既有认知——的塑造,因而是一个持续的挑战。
🔑 关键术语
- thesis of ineffability:不可言说性论题。指音乐能够表达语言所无法传达的人类经验(包括情绪状态)的观点。本节用它来说明音乐表现力难以通过语言教授的哲学根源。
- expressivity:(音乐)表现力。指演奏中对情感、结构和音乐意蕴的外在呈现。在本节中是被音乐教师视为最重要的演奏属性,同时也是最难以通过语言讲授的对象。
- teacher talk:教师讲授。在本节中用以描述音乐课堂中以语言讲解为主的教学方式,作者援引研究指出其主导地位,并暗示其对教授表现力的局限。
- aural modeling and imitation:听觉示范与模仿。指教师通过演奏示范、学生通过听觉模仿来学习的非语言路径;本节将其呈现为针对表现力教学的语言困境所采取的替代方案,同时指出其自身局限。
- structural properties:乐曲结构特征。指旋律、和声、节奏、曲式等作品本体层面的属性。在本节中与"expressive features”(表情特征)相对,用来界定学生模仿示范时可能出现困难的来源:当示范的表情处理与作品结构不相吻合时,即便高水平学生也难以成功迁移。
- preexisting musical knowledge, expectations, and preferences:先在的音乐知识、期待与偏好。指学习者在聆听示范之前已具备的认知与审美倾向。在本节中被作者用来论证:示范并非被动的"录音—回放"过程,学习者的既有认知始终介入并有时干扰对示范的编码与记忆。
CH1_S4 [描述性拆分] Author Note
第1段(P0006)
原文复述
Robert H. Woody is identified as an assistant professor of music education in the School of Music, University of Nebraska, with an institutional address at 354 Westbrook Music Building, Lincoln, NE 68588-0100, and an electronic-mail contact at rwoody2@unl.edu. The notice further states that the copyright for the work is held under Copyright © 2006 by MENC: The National Association for Music Education.
中文讲解
这段是学术期刊文章首页常见的「作者署名注」(Author Note),属于文章正文之外的身份、联系方式与版权信息,不参与文章的学术论证。
逐项来看原文传达的信息:
- 作者身份:Robert H. Woody(罗伯特·H·伍迪),担任音乐教育方向的助理教授(assistant professor),这是北美学术体系中级别的教职,介于讲师与副教授之间。
- 所属机构:University of Nebraska(内布拉斯加大学)的 School of Music(音乐学院),说明作者所在的学科单位是音乐而非教育学或心理学等。
- 通讯地址:354 Westbrook Music Building, Lincoln, NE 68588-0100,这通常是作者所在的具体办公楼、房间所在地,便于读者寄送纸质信函或复印件。
- 电子邮箱:rwoody2@unl.edu,unl 是 University of Nebraska–Lincoln 的常用缩写,供读者通过电子邮件联系作者。
- 版权信息:Copyright © 2006 by MENC: The National Association for Music Education,表明本文发表于 2006 年,版权归属于 MENC 这一机构。
学习提示:在阅读学术论文时,作者署名注提供的是「元数据」——它告诉我们是谁写的、在哪里、怎样联系,以及该文章受哪一机构版权保护。它的作用主要是建立作者的可追溯性,并不构成论文论证链的一部分,因此在评估文章观点时应与正文内容分开对待。
补充说明
本段信息全部为作者身份与出版归属的事实陈述,本身不包含需要进一步解释的概念或例证。MENC 一词在本段中仅作为版权归属机构出现,其全称已由作者注本身给出,无需补充。
💡 本节核心要点
🔑 关键术语
- MENC: The National Association for Music Education:本段中作为版权持有者出现的机构名称,全称为 The National Association for Music Education(美国国家音乐教育协会),本文 2006 年版权归其所有。
- Assistant Professor:本段中指作者 Robert H. Woody 在 University of Nebraska 所担任的教职级别,即「助理教授」,是北美高校学术职称体系中的一个层级。
- Author Note:本小节的整体类别,即「作者署名注」,是期刊文章首页用以标注作者身份、所属机构、联系方式及版权归属的版面元素,不属于正文论证。
CH1_S5 [描述性拆分] Concrete Musical Instruction as an Alternative to Imitation
第1段(P0007)
原文复述
While many teachers employ modeling to convey how to perform expressively, a different approach involves articulating the characteristics of the desired performance itself. This alternative, which may be labeled concrete musical instruction, directs attention to the sound properties of a performance, including variations in loudness, tempo, and articulation. Such expressive devices can be communicated either verbally or symbolically, the latter through markings placed on the printed notation of the music. Juslin and Persson (2002) developed a code of expressive performance that specifies the acoustic means by which performers convey basic emotions such as happiness, anger, and fear. Juslin and Laukka (2000) applied this code to deliver performance feedback to student musicians, and the intervention effectively enhanced the students’ communication of basic emotions to listeners. Johnson (2000) reported comparable gains with college students who received short lessons—presented both graphically and in prose—on the use of rubato by professional musicians.
中文讲解
本段在论证结构上完成一次关键转向:上一节铺垫了"模仿”(modeling)作为传递表现性演奏的主要途径,本段则提出另一种替代路径——“具体化音乐教学”(concrete musical instruction)。理解这一对比要抓住"做什么"与"怎么做"的区分:模仿法是教师先演奏一遍让学生照着做,依赖听觉与动作的复制;具体化教学则把"表现"拆解成可描述、可标注的声学参数(如响度变化 loundess、速度变化 tempo、发音方式 articulation),再以口头语言或符号记号(写在乐谱上的演奏提示)传达给学生。换言之,模仿是整体传递,具体化是把整体拆成可命名的成分再传递,这对学生意味着可以从"听对了但说不出为什么"走向"听懂每个参数并主动调控”。
本段给出的三条实证支撑要分别理解其承担的角色。Juslin & Persson(2002)提供的是理论工具——一套"表现性演奏编码”,把基本情绪(喜悦、愤怒、恐惧)对应到具体的声学手段。Juslin & Laukka(2000)证明了这套编码可以作为教学反馈的工具,用于学生演奏后给出的针对性指导,并确实改善了他们向听者传达基本情绪的能力。Johnson(2000)则把视角从"情绪传达"延伸到"节奏弹性”(rubato,即演奏中对速度的伸缩处理),并以图形与散文两种形式授课,同样观察到大学学生表现力的提升。三项研究的共同结论是:用语言/符号描述表现参数的做法,可以独立于模仿法而取得教学效果,这为后文将"具体化教学"纳入更系统的教学设计奠定了证据基础。
补充说明
段落中三项研究的分工可在本段内直接定位:Juslin & Persson(2002)建立编码,Juslin & Laukka(2000)将编码用于反馈,Johnson(2000)则把同类思路应用到 rubato 教学,三者构成"理论—反馈应用—另一参数验证"的递进。无其他可定位的补充信息。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节仅含一段正文,无脚注、图表、边栏或图像占位符等附加材料,故无额外汇总。
💡 本节核心要点
- 具体化音乐教学被提出作为模仿法的替代路径,核心在于用语言或符号描述演奏的表现性特征,而非通过示范让学生复制。
- 具体化教学所指涉的声学参数明确包括响度、速度、发音方式三类变化。
- 传达方式分为口头描述与在印刷乐谱上做符号标注两种。
- Juslin 与 Persson(2002)提出的"表现性演奏编码"为该方法提供了把基本情绪对应到声学手段的理论框架。
- Juslin 与 Laukka(2000)以及 Johnson(2000)分别从情绪传达与 rubato 两个角度,为具体化教学的有效性提供了实证支持。
🔑 关键术语
- Modeling(模仿教学法):指教师先示范演奏,让学生通过听与看进行复制;本段把它作为参照系,用来凸显具体化教学的差异。
- Concrete musical instruction(具体化音乐教学):本段提出的替代方法,核心是把"想要的演奏"拆解为可命名的声音属性(响度、速度、发音方式),并以语言/符号方式传达给学生。
- Articulation(发音法):本段列举的声学参数之一,指音符被演奏或演唱时的衔接与处理方式(如连奏、断奏),属于表现性的可控维度。
- Code of expressive performance(表现性演奏编码):由 Juslin 与 Persson(2002)建立的一套规则体系,将基本情绪映射到具体的声学手段;本段把它作为具体化教学可借助的理论工具。
- Basic emotions(基本情绪):本段在论证中特指 happiness、anger、fear 一类基础情绪,是表现性演奏编码所要传达的对象。
- Rubato(自由速度/弹性速度):演奏中对速度的弹性伸缩处理;Johnson(2000)以此为教学内容,证明具体化教学在节奏维度上同样有效。
CH1_S6 [描述性拆分] Mental Imagery and Metaphor in Expressivity Instruction
第1段(P0008)
原文复述
An alternative verbal strategy consists in the use of mental imagery and metaphor. This kind of instruction is capable of addressing technical performance problems—one example being Barten (1998), who proposes that asking a young flutist to imagine a hot potato in the mouth is more efficient than providing an anatomical description of an expanded oral cavity—but its principal target is improvement in expressive performance. The images and metaphors employed by music teachers can typically be sorted into two kinds: those that convey mood (e.g., “sing like you’ve just fallen in love”) and those that depict motion (e.g., “imagine skipping a stone across a lake”) (Woody, 2002a). Music educators strongly endorse this approach (Lindström et al., 2003; Woody, 2000), and musicians have demonstrated comfort in using it (Sheldon, 2004; Woody, 2002a). Other researchers, nonetheless, have identified potential drawbacks, including confusion and discouragement among students who find a teacher’s metaphorical language difficult to grasp (Persson, 1996).
中文讲解
本段在前文讨论分析性与命令式语言策略的基础上,提出第三种口头的表达性教学策略——心理意象与隐喻。作者首先承认,这类教学也能解决技术问题(Barten 1998的例子说明对长笛初学者而言,用“嘴里含着烫土豆”这种意象比“口腔扩张的解剖学描述”更高效),但紧接着用"but mostly targets"明确把重心转向表现性演奏的改进。Woody (2002a) 的二分法是本段的核心分类:传达情绪的隐喻(如“像初恋那样歌唱”)与描绘动作的隐喻(如“想象往湖面上打水漂”),前者指向内心状态,后者指向动作/声音想象。紧接着用四项研究从教师与演奏者两端给出正面的接受度证据(教师赞同:Lindström 等 2003、Woody 2000;演奏者自如运用:Sheldon 2004、Woody 2002a),但作者并未止步于此,而是以"however"转折,引出 Persson (1996) 的反面证据:理解隐喻失败的学生会产生困惑和受挫感。这种"赞成+保留"的写法提示读者:隐喻策略虽受欢迎,却并非普适,它依赖学生的认知能力与先验经验。
补充说明
本段内部存在一个值得注意的对照:作者用 Barten (1998) 的"烫土豆"例子说明隐喻同样可以服务于技术训练,从而避免读者把"mental imagery and metaphor"误认为仅与情感表达有关;但作者随即用 “but mostly targets” 把焦点拉回到表现性演奏,强调隐喻的主要阵地仍是表达维度。
第2段(P0009)
原文复述
Although imagery and metaphor are often employed to illustrate the desired sound of an expressive performance, at other times these devices are aimed at the performing musicians themselves.
中文讲解
这是一个承上启下的过渡句,功能是细分隐喻/意象所指向的对象。前一句P0008展示的隐喻例子(如“歌唱、声音、运动”)都是描述"演奏应当发出什么样的声音”,即指向外部听感;而本句引出另一类隐喻/意象,其作用对象不是"声音”,而是"演奏者本人”。“at other times"和"themselves"这两个措辞非常关键:它们预告了下文(P0010)将讨论的"诱发学生体验到的情感"这一策略类别,说明隐喻既可以描述目标声音,也可以作用于演奏者的内在状态。
第3段(P0010)
原文复述
Inducing a felt emotion in students is a common teaching strategy (Laukka, 2004; Lindström et al., 2003). Implicit in this approach is the assumption that if performers actually feel, for example, sadness as they play, the sound properties of the performance will emerge automatically, so that the melody will sound sad. It may be the case that singers, who work with lyrics, are more inclined to adopt a felt-emotion approach to expressivity (Woody, 2000). Whether a teacher’s use of figurative language is intended to induce felt emotion or to depict the expressive qualities of a performance, music research has provided little insight into the cognitive processes that enable students to use the approach successfully.
中文讲解
本段承接P0009的过渡,正式展开"隐喻指向演奏者本人"这一分支——诱发学生感受到的情感(felt emotion)。作者首先用 Laukka (2004) 与 Lindström 等 (2003) 两项研究确立这种教学策略的普遍性。紧接着剖析其底层假设(“Implicit in this approach is the idea that…"):只要演奏者内心真实地感到悲伤,其演奏的声音属性会自动涌现,使旋律听起来悲伤。这是一个典型的"由内而外"的表演模型,把情感视为声音的因,音质视为果。作者用"may be"与"It may be the case that"作出条件性推断:歌手因为处理歌词,更可能采用诱发情感的策略(Woody, 2000),这暗示歌词作为语义媒介为情感诱发提供了天然通道。本段最后一句是本节乃至本章论证的关键收束:无论教师的隐喻是要诱发情感,还是要描绘表现性质,音乐研究至今对"学生究竟如何成功运用这种方法"背后的认知过程都知之甚少。这一句既承认了隐喻/意象策略在实践中的流行,又指出研究在解释机制上的空白,为后文提出研究问题或理论框架留下空间。
补充说明
本段"Implicit in this approach is the idea that…“是一种元理论表述,作者并不直接评价这种因果假设是否成立,而是把它作为教师实践的隐性前提呈现给读者,这表明作者的立场是描述性的而非规范性的——她记录音乐教师"做什么"以及"相信什么”,而非断言"应该相信什么”。
脚注 / 边栏 / 图表 / 附加信息(如有)
无附加材料(脚注、图表或边栏)出现在本节边界范围内。
💡 本节核心要点
- 心理意象与隐喻是除分析与命令式语言之外的第三类口头教学策略,虽偶用于技术训练(如 Barten 1998 的长笛"烫土豆"例子),但主要服务于表现性演奏的改进。
- Woody (2002a) 的二分法将教师使用的隐喻划分为"传达情绪”(如"像初恋般歌唱”)与"描绘动作"(如"想象打水漂")两类,分别指向演奏者的内在情感与外化的声音/动作想象。
- 尽管音乐教育者与演奏者普遍接受隐喻/意象策略(Lindström 等 2003;Woody 2000;Sheldon 2004),但 Persson (1996) 揭示了其反面效应:学生可能因难以解码隐喻语言而感到困惑与气馁。
- 隐喻与意象的作用对象存在二分:既可描述目标声音的听感,也可指向演奏者本人——后者最典型的形式是"诱发学生感受到的情感"(felt emotion)。
- 诱发情感策略的隐含假设是:演奏者若内心真实地体验到某种情感,其声音属性会自动产生相应变化(Lindström 等 2003;Laukka 2004);Woody (2000) 推测,因歌词承载语义,歌手更可能采用此策略。
- 无论隐喻/意象的目标是诱发情感还是描绘声音,音乐研究都尚未解释清楚学生成功运用此类方法所依赖的认知过程——这一空白是本章论证收束的关键。
🔑 关键术语
- mental imagery:心理意象;指让学习者在脑海中形成特定画面或感觉的认知手段,在本节中用于替代解剖学或技术性描述,引导演奏者获得特定的声音或情感体验。
- metaphor:隐喻;借用其他领域(情绪、动作、自然现象等)的描述来指代目标声音或演奏状态,是本节讨论的口头教学策略的核心载体。
- mood metaphor / motion metaphor:Woody (2002a) 的隐喻分类:前者传达情绪状态(如"像初恋般歌唱"),后者描绘动作意象(如"想象打水漂"),二者在教学中分别作用于演奏者的情感层与动作/声音层。
- felt emotion:感受到的情感;指演奏者在演奏过程中真实体验到的情绪,而非仅在外观上模仿情绪的外部表征;本节将其作为隐喻策略作用于演奏者自身的典型形式。
- figurative language:比喻性/形象化语言;本节用作意象与隐喻的上位概念,涵盖一切非字面、依赖想象或类比来传达表达性意图的语言形式。
CH1_S7 [描述性拆分] Underlying Beliefs About Musical Expression
第1段(P0011)
原文复述
Among the three instructional approaches discussed here—namely, aural modeling, verbally describing concrete musical properties, and verbally presenting mental imagery—how frequently a teacher employs each one is likely shaped by that teacher’s beliefs about what musical expression fundamentally is (Laukka, 2004). One such belief holds that verbal instructions focusing on concrete performance properties merely produce a simulated expressivity that is missing the required emotional component. A second belief maintains that the capacity to perform music expressively is an innate talent and therefore cannot be taught by any method. As a consequence of the second view, some instructors may steer clear of addressing expressivity directly because they worry that doing so could interfere with a student’s natural potential. Although empirical research has discredited these traditional “mystical” views about expressivity, they nonetheless continue to be widespread in certain music education circles (Juslin & Persson, 2002).
中文讲解
这段话承接前文对三种教学方式(听觉示范、用语言描述具体的音乐属性、用语言呈现心理意象)的介绍,把讨论焦点从"用什么方法"转向"老师为什么倾向于用某些方法",引出本章小节的关键词:关于音乐表现本质的潜在信念。
-
核心主张:教师对这三种方法的使用程度,“很可能”(likely,注意这是推测性副词而非确定结论)受到他对"音乐表达究竟是什么"这一根本问题所持信念的左右。这里没有说信念是唯一决定因素,只说它是重要影响之一。
-
作者归纳出两种具体信念:
- 第一种:有人认为用语言描述演奏中的具体属性,只能造出"模拟出来的表达性"(simulated expressivity),缺少真正的情感成分。这里的关键词是"模拟"与"情感成分"的对立——批评者担心语言化的技术指导只触及外在形式,无法触及内在情感。
- 第二种:另一些人认为富有表现力地演奏音乐是一种天生才能,“以任何方式都不可教”(cannot be taught in any way)。这是一个极强的全称判断,排除了所有教学干预的可行性。
-
由第二种信念推出的行为后果:因为相信表达力是天赋,一些教师为了"不损害学生天然潜能",反而刻意避开直接讨论表现性问题。这一行为在逻辑上是从"不可教"的前提得出的回避策略。
-
作者的立场:作者指出这些观点属于已被研究结果"证伪"(discredited)的传统"神秘主义"(“mystical”,带引号表示批判性引用)观念,但同时承认它们"在某些音乐教育圈子里仍然普遍"(nevertheless remain pervasive in some music education circles)。这里的"nevertheless"是关键的转折让步词:即便被证伪,仍广泛存在——这正是下一节需要继续讨论的现实问题。
-
在小节论证结构中的作用:本段以"潜在信念"为桥梁,解释了教师教学方式差异背后的认知/观念原因,并设置了一个辩论性的起点:流行的"神秘主义"观点与研究证据之间存在张力,为后续讨论研究证据如何反驳这些观念、为何它们仍持续存在做了铺垫。
补充说明
本段中的两个引用 Laukka (2004) 与 Juslin & Persson (2002) 在文中分别承担不同功能:前者支持"教师信念影响教学方式"这一推断性主张,后者支持"传统神秘观念虽被研究驳倒却仍普遍"这一经验性主张。“simulated expressivity"与"mystical ideas"是文中核心的对立概念标签,前者由赞成语言描述具体属性者所暗含的担忧而生(担心技术化描述仅产表面表达),后者指代将表达力视作不可教天赋的传统观念。两种概念在原文上下文中构成对照。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节为描述性拆分产生的小节(标题前缀”[描述性拆分]“指明此小节是从原书某处切分而来),仅含正文段落 P0011 一段,因此本节无独立的脚注、图表说明或边栏内容;段中所引文献(Laukka, 2004;Juslin & Persson, 2002)属于正文内引用而非脚注。
💡 本节核心要点
- 教师对三种教学方式(听觉示范、描述具体属性、呈现心理意象)的使用程度,受其对"音乐表达本质"的潜在信念影响(Laukka, 2004)。
- 第一种信念:语言描述具体演奏属性只能产生缺乏情感成分的"模拟表达性”。
- 第二种信念:音乐表现力是与生俱来的天赋,“以任何方式都不可教”。
- 持第二种信念的部分教师会回避直接讨论表现问题,以免妨碍学生的天然潜能。
- 上述观点属于"神秘主义"传统观念,已被研究结果证伪,但在部分音乐教育圈子里仍相当普遍(Juslin & Persson, 2002)。
- 本段构成研究与实践之间的张力:证据已驳倒的观念仍持续影响教学选择,是后续讨论的现实起点。
🔑 关键术语
- aural modeling:听觉示范:通过亲自演奏或播放范例,让学生用耳朵"听"到应该如何表现,而非用语言加以解释。是文中与"语言化教学"对立的非语言教学方式。
- verbally describing concrete musical properties:用语言描述具体音乐属性:指教师用词汇提示演奏中可观测的技术或乐谱参数(如力度、速度、弓法等),而不是解释音乐的情感或意象意义。文中批评者认为这种做法易导致"模拟表达性"。
- verbally presenting mental imagery:用语言呈现心理意象:指教师用比喻、场景或情感意象引导学生的内心感受,是介于纯技术描述与纯听觉示范之间的语言化方式。
- simulated expressivity:模拟的表达性:文中指仅在外在技术层面像有表现力地演奏、但缺乏真实情感内核的状态;是批评"描述具体属性"教学方式者所担忧的负面结果。
- mystical ideas about expressivity:关于表现力的神秘主义观念:指将音乐表现力视为不可教、不可言传的先天天赋(innate talent)这一类传统观点;作者用引号标记以示对其的非认同立场,但承认其在音乐教育界仍有影响。
CH1_S8 [描述性拆分] Purpose of the Study
第1段(P0012)
原文复述
This study set out to compare the effectiveness of three instructional approaches aimed at improving expressive performance. The researchers did not anticipate that the comparison would demonstrate the superiority of any single approach; instead, they expected that, when the results were considered alongside the attributes of the musical materials and alongside the attributes of the musicians themselves, the relative strengths of each approach would become clearer. In addition, participants’ verbal reports, gathered during the musical task, were used to provide insight into the cognitive processes that were engaged in each of the three conditions.
中文讲解
这段是典型的"研究目的陈述段",需要读者特别注意它的语气和限定。
第一句点明研究的总体设计:比较三种教学方法在提升"表达性演奏(expressive performance)“上的效果。也就是说,研究的核心因变量是演奏中的表达性,而不是技术准确性、速度或其他指标。
第二句是理解整段的关键限定:作者明确预期比较结果不会揭示出某一种方法全面优于另外两种。这里传递了两层信息——一是作者有意避免了一个"哪种方法最好"式的结论;二是研究的真正兴趣在于相对优势(relative strengths)的浮现。所谓"相对优势”,要通过两类属性才能看清:一是乐曲本身的属性(material attributes),二是演奏者本人的属性(musician attributes)。换句话说,没有一种方法在所有乐曲、所有演奏者身上都最强;某种方法之所以显得更有效,取决于它与什么样的材料、什么样的学习者相匹配。这种写法把研究定位成"探索条件—方法匹配"的研究,而不是"判定最优方法"的实验。
第三句引入了第二条数据来源:在演奏过程中收集口头报告(verbal reports),用来透视被试在每一种条件下所使用的认知过程(cognitive processes)。这意味着研究不只是比较行为结果(演奏的表达性),还要进入被试在演奏时的主观思路——他/她在想什么、如何处理乐谱、怎么做出表达决定等。
整体来看,本段同时回答了三个问题:要做什么(比较三种方法)、预期会看到什么(相对优势而非单一最优)、以及怎么观察(演奏效果 + 任务中的口头报告)。这三条线索直接决定了后文方法、结果与讨论的走向。
补充说明
段中"three instructional approaches"与"each of the three conditions"在数量上一一对应,可以在本节内互相参照;“relative strengths"的出现意味着读者应避免期待"最优方法"类的单一结论。
💡 本节核心要点
- 研究目的是比较三种教学方法对表达性演奏的提升效果,主因变量是演奏的表达性。
- 作者明确预期不会出现"某一种方法全面优于其他方法"的结论,将研究定位为条件—方法匹配的探索。
- 相对优势的显现需要结合两类属性审视结果:乐曲本身的属性与演奏者本人的属性。
- 研究还收集演奏过程中的口头报告,作为洞察各条件下认知过程的第二条数据来源。
- 整体研究取向是探索性、对比性的,而非验证单一最优教学法。
🔑 关键术语
- expressive performance:表达性演奏,指本研究关注的因变量——通过教学方法干预所要改善的音乐演奏中的表现力与情感表达维度,而非技术准确性等指标。
- instructional approaches:教学方法,本研究中特指被比较的三种干预方式,用以改善表达性演奏。
- relative strengths:相对优势,强调各方法在不同乐曲与不同演奏者条件下的局部长处,而非绝对优劣。
- attributes of the musical materials and the musicians themselves:乐曲属性与演奏者属性,是研究者审视各方法相对优势时的两类参照维度,提示读者关注条件—方法的匹配关系。
- verbal reports:口头报告,指演奏过程中收集的参与者口头陈述,是本研究中用于观察认知过程的第二条数据来源。
- cognitive processes:认知过程,指在三种教学条件下被试为完成表达性演奏所动用的内部思维与决策过程,是口头报告所要揭示的对象。
CH2_S1 [描述性拆分] Method Overview and Participants
第1段(P0013)
原文复述
METHOD
中文讲解
这是论文的方法部分总标题(“##” 为二级标题标记),用以开启方法章节。紧随其后的内容将依次说明研究对象、实验程序、测量工具与统计方法等。该标题本身不包含论证信息,其作用是为读者标示“此处开始进入方法描述”,从而把后续的参与者信息、流程设计与数据分析等条目与前面综述或问题陈述在结构上区分开。
第2段(P0014)
原文复述
The subjects in this study were 36 pianists who were undergraduate- and graduate-level music majors at the researcher’s institution; they volunteered to participate in the study, having been recruited by the researcher through advertisements posted around the music building and announcements made in music courses. The sample consisted of 24 women and 12 men; their ages ranged from 19 to 52 with a mean age of 24.1 years. Half the subjects were identified as advanced pianists who considered piano their main area of applied performance (i.e., students with majors of music performance, music education, or music theory/composition), and half were classified as competent pianists, for whom piano was not their primary performance instrument (also comprising a variety of specific majors with in music). The results of a questionnaire (administered after the procedure) supported the self-assigned groupings. Members of the advanced group reported practicing the piano an average of 11 hours a week, and those in the competent group, only 3 hours, t (34) = 4.84, p < .001. Also, the advanced pianists had received significantly more years of private piano lessons (M = 16.8) than the competent pianists (M = 9.3)—a significant difference even when controlling for the variable of age, F (1, 33) = 17.67, p < .01.
中文讲解
本段是方法小节的主体,详细交代了被试构成与分组依据,为后续实验结果的解释提供基线。中心主张是:研究招募了 36 名来自同一所院校的音乐专业本科生与研究生,按其是否以钢琴为主修演奏专业,自评划分为“高级组”(advanced)和“熟练组”(competent)各 18 人,并通过问卷与练习量、课时量等客观指标对自评划分进行交叉验证。逐层来看:
第一层交代样本来源——单一院校的 36 名钢琴演奏者,通过音乐楼内的广告与课堂口头公告招募,为自愿参与。这一来源限定意味着结果不宜直接推广到非音乐专业人群或其它院校,但能保证被试具备基本音乐素养,且被试是自选而非随机抽样,理论上可能存在自我筛选偏差。
第二层给出人口学信息:女性 24 人、男性 12 人(男女比 2:1),年龄跨度 19–52 岁但平均仅 24.1 岁,说明样本以年轻在校生为主,年龄右偏(少数年长者拉高上限)。这一结构提示后续若涉及年龄变量需注意其分布特征。
第三层是分组定义的关键——“高级”指钢琴是其“applied performance”主修方向,专业涵盖音乐表演、音乐教育与音乐理论/作曲;“熟练”指钢琴并非其主修演奏乐器,专业为音乐类其他方向。两组人数对半设计,意味着每组的统计权重均衡;按是否主修钢琴来分组而非按绝对水平,巧妙地把“专攻钢琴的人”和“学过钢琴但另有专攻的人”区分开,使本研究关心的变量是钢琴在其训练中的核心地位,而不是抽象的绝对水平。
第四层是分组有效性的客观佐证:实验后问卷支持自评归属;高级组每周平均练琴 11 小时,熟练组仅 3 小时,t(34)=4.84, p<.001,差异极其显著;高级组累计私人钢琴课时长(M=16.8 年)显著多于熟练组(M=9.3 年),即使把年龄作为协变量加以控制,F(1,33)=17.67, p<.01,差异仍显著。这里使用两类统计量:t 检验用于两组均值比较,F(结合协变量)属于协方差分析(ANCOVA),用于排除“年长者练得多、学得久”的年龄混淆——即便控制年龄,两组的课时积累差异依然显著,说明该差异反映的更可能是钢琴在其训练中的中心地位而非单纯的年龄累积效应。
综上,本段在论证链中起到“界定研究对象与确立组别操作定义”的作用:它不仅描述了 36 个人的基本特征,更通过练习时间与课时年数这两项可量化指标,让“高级 / 熟练”这一自评分组获得了行为与训练史上的客观支撑,使后续两组在实验任务上的差异可被合理归因于钢琴训练投入与专业定位的不同。
补充说明
原文中“specific majors with in music”疑为排印残留多余的“with”,复述已按原文照录。该段同时给出三项统计量——t(34)=4.84 用于比较两组每周练习时数,F(1,33)=17.67 用于在控制年龄后比较两组私人钢琴课时长——分别对应“未控制协变量”与“控制协变量”两种分析层次,作者用这种并列写法来回应潜在的年龄混淆质疑。
💡 本节核心要点
- 本段进入方法小节,开门见山地界定研究被试:36 名来自同一院校、涵盖本科与研究生层次的钢琴演奏者,均为自愿参与。
- 样本按是否以钢琴为主修演奏方向自评分为“高级组”(18 人,主修含音乐表演、音乐教育、音乐理论/作曲)与“熟练组”(18 人,其他音乐专业,钢琴为副修),每组人数相等。
- 样本在性别(女 24、男 12)和年龄(19–52 岁,M=24.1)上有一定跨度,但整体以年轻在校生为主。
- 两组在两个客观指标上差异显著:每周平均练琴时数(11 vs. 3 小时,t(34)=4.84, p<.001)与累计私人钢琴课时长(M=16.8 vs. 9.3)。
- 课时差异在控制年龄后仍显著(F(1,33)=17.67, p<.01),说明组别差异反映的是钢琴在其训练中的中心地位,而非仅仅由年龄/经验累积造成。
- 实验后问卷结果支持被试的自评分组,使“高级 / 熟练”这一操作性划分获得了行为与训练史层面的外部效度。
🔑 关键术语
- advanced pianists:本研究中对“以钢琴为主修演奏方向”的音乐专业学生的自评分组;专业涵盖音乐表演、音乐教育、音乐理论/作曲,其操作性指标为每周练琴时数高(M=11 小时)且累计私人课时多(M=16.8 年)。
- competent pianists:本研究中对“钢琴非主修演奏乐器、但具备一定钢琴训练”的音乐专业学生的自评分组;其专业为音乐类其他方向,操作性指标为每周练琴时数低(M=3 小时)且累计私人课时较少(M=9.3 年)。
- applied performance:指“应用演奏方向”,即学生在主修声明中所选择的演奏专业;在本节中用来界定“以钢琴为应用演奏主修”的高级组身份。
- t(34)=4.84, p<.001:独立样本 t 检验结果,自由度 34,对应两组每周练琴时数均值的差异;该统计量在文中用于支撑高级组与熟练组在练习投入上的显著差别。
- F(1,33)=17.67, p<.01:协方差分析(ANCOVA)的 F 值,分子自由度 1,分母自由度 33,协变量为年龄;该统计量用于检验在排除年龄影响后,两组累计私人钢琴课时长的差异是否仍然显著。
CH2_S2 [描述性拆分] Musical Materials Figure
第1段(P0015)
原文复述
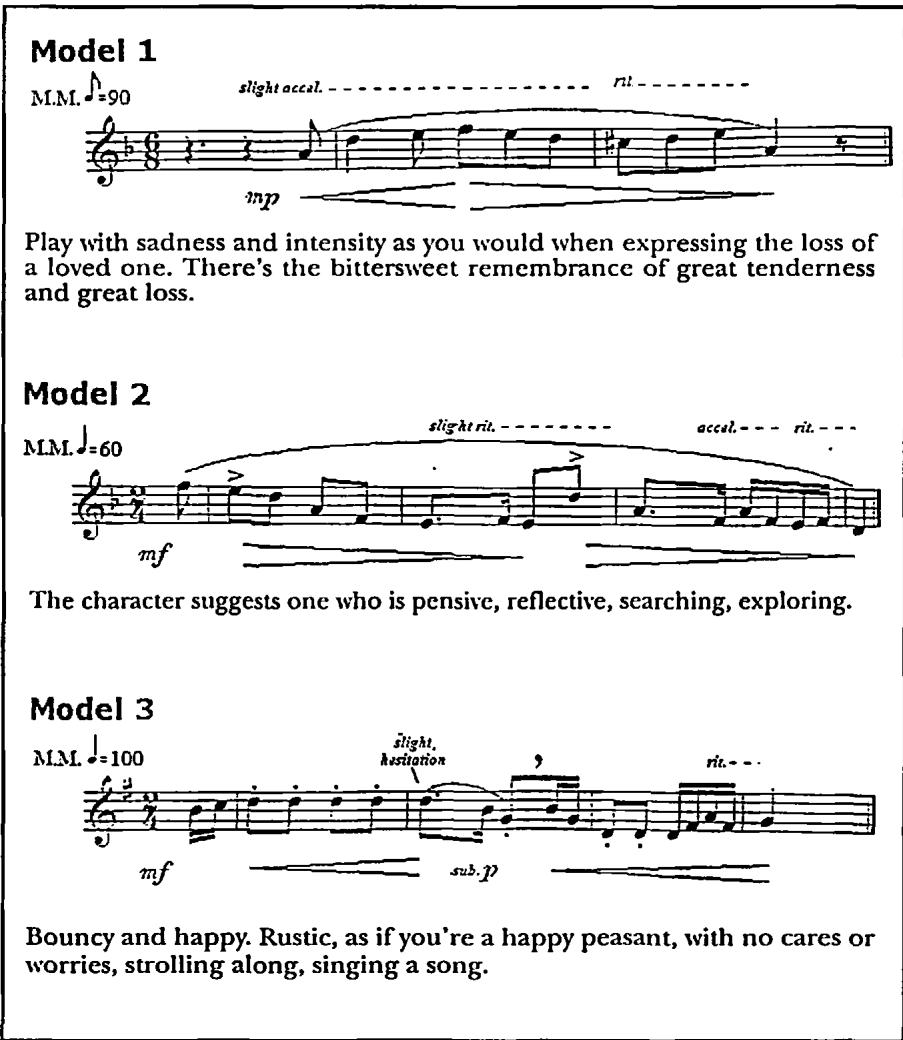
Figure 1 shows a composite of the musical materials used in the study. In the AM condition, subjects saw only the melody in unmarked notation. In the CM condition, they viewed the melody with all expressive markings. In the MI condition, subjects saw the melody in unmarked notation, with the metaphor/imagery-based instruction printed below it. ([内嵌图像数据已省略;位置与图注保留])
中文讲解
这是一段图注,作用不是提出音乐理论主张,而是界定研究中使用的音乐材料及其三种呈现条件。AM条件下,受试者只看到旋律的无标记记谱;CM条件下,看到的是带有全部表现性标记的旋律;MI条件下,记谱本身不加表现性标记,但旋律下方印有基于隐喻或意象的指导语。图注因此明确区分了“旋律的无标记记谱”“增加全部表现性标记”以及“无标记记谱加意象/隐喻指导语”这三种材料组合。需要注意的是,当前输入省略了内嵌图像,仅保留图注和图像位置,所以无法据图确认具体的音符、表现性标记种类或版式细节;这些内容需要查看原图。
补充说明
当前输入明确说明内嵌图像数据已省略,仅保留图像位置和图注;因此,具体音符、表现性标记和视觉排版需查看原图确认。
脚注 / 边栏 / 图表 / 附加信息(如有)
图1及其图注涉及研究中使用的音乐材料。当前输入保留了图注和图像位置,但省略了内嵌图像数据;具体音符、表现性标记及版式需查看原图,不能由图注进一步确定。
💡 本节核心要点
- 图注的主要功能是说明研究材料的构成,而不是展开音乐分析或理论论证。
- AM条件只呈现旋律的无标记记谱。
- CM条件在旋律上加入全部表现性标记。
- MI条件保留无标记记谱,并在旋律下方加入基于隐喻或意象的指导语。
- 由于图像数据被省略,当前只能确认三种条件的文字描述,无法确认其具体视觉内容。
🔑 关键术语
- AM condition:图中说明的一种材料呈现条件:受试者只看到旋律的无标记记谱。
- CM condition:图中说明的一种材料呈现条件:受试者看到带有全部表现性标记的旋律。
- MI condition:图中说明的一种材料呈现条件:受试者看到无标记的旋律记谱,记谱下方印有基于隐喻或意象的指导语。
- unmarked notation:指没有表现性标记的旋律记谱;图注将其用于AM和MI条件。
- expressive markings:指图注所称的全部表现性标记;当前输入没有列出这些标记的具体种类。
- metaphor/imagery-based instruction:指MI条件下打印在无标记旋律记谱下方的、基于隐喻或意象的指导语。
CH2_S3 [描述性拆分] Selection and Provenance of the Melodies
第1段(P0016)
原文复述
The three melodies employed in this study (shown in Figure 1 on the facing page) were not newly composed for the present work but have already appeared in earlier expressive-performance research. The first melody was composed specifically for an experiment conducted by Clarke and Baker-Short in 1987. The second and third melodies come respectively from Schubert’s two song cycles Die Winterreise and Die schöne Müllerin, and had been used in studies by Clarke (1993) and Woody (1999).
中文讲解
本段交代了研究所用三段旋律的来源与谱例位置,功能是说明材料选择的延续性和可对比性,而非临时编凑。
首先要区分两类来源:Melody 1 是专为实验而写的新作,由 Clarke 和 Baker-Short 于 1987 年编创,目的是排除演奏者对作品的预先熟悉;Melodies 2 与 3 则来自舒伯特的两部声乐套曲——《冬旅》(Die Winterreise)和《美丽的磨坊女》(Die schöne Müllerin),它们是公认的钢琴伴奏艺术歌曲文献,演奏者对其有较深的既有诠释传统。
将其与 Clarke (1993) 和 Woody (1999) 的既有研究挂钩,意味着本研究的结果可以与同一旋律在先前实验中的发现进行比较和累积,这种谱例复用是音乐表演研究中建立外部效度与可比性的常见做法。
承接前文,该段解释了作者为什么用"对比熟悉度"或"演奏风格"作为变量:正因为三段旋律分别对应"实验原创 / 经典曲目"的差别,刺激材料本身已带有不同的演奏惯例与熟悉度差异,这正是后续分析所要考察的对象。
容易忽略的一点是:作者只列出材料出处,并未在此处说明被试是否熟悉这些作品,这一信息通常在后文的方法部分才会给出。
补充说明
本段末尾提到的 Figure 1(facing page)即本节的乐谱占位符,其实际内容需查看原图以确认调号、拍号与具体旋律;本节范围内不展开。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段提及 Figure 1(facing page)这一乐谱占位符,承载三段旋律的实际谱例,需结合原图阅读,无其他脚注或边栏材料。
💡 本节核心要点
- 研究所用三段旋律并非新作,全部来自既有音乐表演研究,体现材料复用以保证可比性。
- Melody 1 为 Clarke 与 Baker-Short (1987) 实验而专门创作,用以控制先验熟悉度。
- Melody 2、3 分别取自舒伯特的《冬旅》与《美丽的磨坊女》,此前已被 Clarke (1993) 和 Woody (1999) 使用。
- 原创旋律与经典曲目的并置,为后文考察"熟悉度/演奏惯例"对表达性演奏的影响提供了材料基础。
- Figure 1 为三段旋律的谱例载体,位置在对页,需结合原图阅读。
🔑 关键术语
- expressive performance:指音乐演奏中对乐谱进行速度、力度、时值等方面的非随意性偏离,是表演心理学的核心研究对象;本节旋律均来自该领域的既有实验。
- Die Winterreise / Die schöne Müllerin:舒伯特的两部联篇艺术歌曲集,前者为《冬旅》(D. 911),后者为《美丽的磨坊女》(D. 795),本研究中作为已知熟悉度的高经典性曲目使用。
- song cycle:由若干首歌词、情境彼此关联的声乐作品连续组成的套曲;本研究选取的曲目均属此类,钢琴声部具有独立的艺术表现传统。
CH2_S4 Creation of Instructional Materials
第1段(P0017)
原文复述
Creation of Instructional Materials
中文讲解
本段为二级章节标题,标志着论述从实验设计概述正式转入对三种教学材料(MI、AM、CM)具体制作流程的说明。该标题所开启的论题是:在研究方法层面,作者如何为三种教学条件生成内容等价却形式不同的教学材料,以服务于前文已提出的内部效度目标。
第2段(P0018)
原文复述
To ensure the internal validity of the study, it was essential to guarantee that the instructional content delivered through the three modes was equivalent. This goal was accomplished through a defined procedure: first, high-quality examples of imagery or metaphors used in expressive performance instruction were gathered; the best of these examples were then given to expert pianists, who used them to produce equivalent aural models. Finally, based on precise quantitative measures of the performance properties of those expert models, the concrete musical instruction was generated.
中文讲解
本段的中心主张是:本研究的内部效度依赖于三种教学条件在内容上保持等价,而这种等价是通过一条三阶派生链条实现的。逻辑链为:(1) 收集高质量的意象/隐喻样本 → (2) 让专家钢琴家根据这些样本演奏出等价的听觉示范 → (3) 基于对示范演奏表现参数的精确测量,反向生成具体的音乐记谱教学材料。换言之,MI 是种子,AM 从 MI 衍生,CM 又从 AM 衍生——三种条件虽形式不同,但内容同源。这一同源性是作者解决"教学内容不等价"这一潜在混淆变量的核心策略:若三种条件都溯源至同一组意象样本,那么受试表现的差异就只能归因于呈现形式本身,而非内容差异。该段在本节中起到总纲作用,后两段(P0019、P0020)分别展开 MI 与 AM 材料的制作细节,P0021 完成 CM 材料的说明。
补充说明
“内部效度"在此指实验设计原则:观察到的组间差异应归因于自变量(教学形式),而非其他混淆因素(如教学内容不同)。“三种模式"对应前文已介绍的 MI(隐喻/意象)、AM(听觉示范)、CM(具体音乐记谱)三种教学条件。
第3段(P0019)
原文复述
Seven college professors of applied music performance, drawn from a variety of instrumental specialties, each received a sheet containing the three melodies along with written instructions to provide an example of imagery or descriptive metaphor they might use to teach that melody. The professors completed their examples on the sheet independently and at their own pace, without contact with one another. A separate panel of 12 experienced musicians—each holding a college degree in music—then evaluated all submitted examples by rating how effective each would be for eliciting an expressive performance from a college-level instrumentalist. The example receiving the highest effectiveness rating for each melody was designated as the official Metaphor/Imagery (MI) instructional material.
中文讲解
本段详细说明 MI(隐喻/意象)材料的制作过程,其论证结构是"两阶段专家筛选”。第一阶段:七位来自不同器乐方向的实用音乐教授各自独立(在互不沟通、自身时间安排下)为三首旋律提出一个意象或描述性隐喻样本;强调"来自多种器乐方向"是为了保证意象风格的多样性,强调"独立完成"是为了避免专家之间互相影响或趋同。第二阶段:一个完全独立的、由 12 位持有音乐院校学位的经验丰富演奏者组成的小组,对所有提交样本按"是否能有效引导大学生器乐学习者产生表情演奏"的标准进行评分,最终每首旋律得分最高的样本被确定为 MI 教学材料。设置独立第二阶段的关键意义在于:让"具有教学经验的人生成内容"与"具有演奏评价经验的人筛选内容"两者分离,从而提高所选材料在教学效用维度上的可信度。这一过程服务于 P0018 的内部效度目标——确保 MI 条件所含内容经过领域专家认定,具有高质量与教学有效性。
补充说明
“来自多种器乐应用方向"意味着七位教授并非清一色钢琴家或单一专业,扩大了意象风格的覆盖范围。“有效性"评分标准(“能引发大学生演奏者的表情演奏”)将隐喻选择与本研究的因变量(演奏的表情性)直接挂钩,而非泛泛的"好坏"判断。
第4段(P0020)
原文复述
Three expert pianists, each a university faculty member, independently performed the three melodies guided by the imagery examples provided. After ample practice, each pianist produced three performances of each melody, yielding nine recorded performances per melody. All performances were captured on a Korg Concert 3500 electric piano—a full-sized keyboard with weighted keys—connected to a computer equipped with a MIDI sequencer. This setup allowed the MIDI performance data to be analyzed along three expressive dimensions: key velocity (corresponding to loudness), interonset interval (corresponding to tempo), and relative note duration (corresponding to articulation). Across the nine performances, the performance data were highly consistent: interperformer correlations exceeded r = .70 and intraperformer correlations exceeded r = .90. For each melody, the MIDI values for the three expressive properties were averaged across the nine performances, and the single actual performance whose data most closely matched this average profile across all three properties simultaneously was selected for use in the Aural Modeling (AM) instructional condition.
中文讲解
本段详细说明 AM(听觉示范)材料的构建,论证可分解为六个衔接紧密的步骤:(1) 三位专家钢琴家各自独立地依据 MI 意象样本演奏旋律——“独立"保证每位钢琴家基于同一意象提示产生各自的诠释;(2) 每位钢琴家每首旋律演奏三次,共九次演奏,样本量足以支撑后续统计;(3) 演奏通过与计算机相连的 MIDI 电钢琴(Korg Concert 3500,配重键盘)记录,MIDI 可将每次按键转化为可量化的力度、时间、时值数据;(4) 沿三个表情维度分析数据——琴键速度(响度)、音起始间隔(速度)、相对时值(断连/articulation),这三个维度恰好是传统记谱法难以精确传达的表情要素;(5) 报告一致性指标:演奏者间相关系数 r > .70,演奏者内 r > .90,前者表示不同钢琴家之间彼此一致,后者(更高)表示同一钢琴家多次演奏之间更加稳定——这种"内高于间"的格局是可靠性证据,证明同一意象提示能够在不同演奏者身上引发可比较的表情演奏,从而再次服务于等价性目标;(6) 将九次演奏的三个维度数据取均值,挑选实际演奏中 MIDI 数据与该平均轮廓最接近(同时考虑三个维度)的那一次,作为正式 AM 材料。指定 Korg Concert 3500 是因为 MIDI 录制需要电子乐器,但其配重键盘保留了真实钢琴的触感,避免演奏过于机械化而失真。
补充说明
“演奏者间”(interperformer)指不同钢琴家之间的相关,“演奏者内”(intraperformer)指同一钢琴家多次演奏之间的相关;通常内相关高于间相关,是行为科学研究中可靠性的常见模式。r > .70 与 r > .90 在行为科学中分别被视作可接受与高可靠性的阈值。Korg Concert 3500 的"配重键盘"是模拟真钢琴触感的设计,对演奏者的力度控制至关重要,否则 MIDI 速度数据可能无法反映真实的力度表现。
第5段(P0021)
原文复述
The MIDI data from the performances selected for the AM condition were additionally analyzed in order to generate the Concrete Musical (CM) instructional materials. Specifically, the deviations in tempo, loudness, and articulation revealed in the MIDI data were translated by the researcher into conventional expressive markings on a printed score of the melodies, as shown in Figure 1.
中文讲解
本段说明 CM(具体音乐)材料的制作,完成了三阶派生链条的最后一步。核心主张是:AM 条件中已经选定的演奏 MIDI 数据被二次利用,作为 CM 材料的来源——研究者将 MIDI 所揭示的速度、响度、断连三个维度的偏离,转化为传统乐谱上的表情记号(如渐快、渐慢、渐强、渐弱、跳音、连音等),并以印刷乐谱形式呈现(见图 1)。这段看似简短,实际承担了重要的方法论闭环功能:CM 不再是一个独立构造的新内容,而是 AM 演奏数据的符号化翻译结果。如此一来,MI(文字意象)、AM(实际演奏)、CM(记谱符号)三种形式在内容上同源——都源自同一组专家认可的意象样本——所不同的只是信息载体。这一安排使作者能够将实验结果中的差异稳健地归因于教学形式本身,而非内容差异。需要注意的是,从 MIDI 数值到记谱符号的转换是由研究者本人完成的,这一步涉及一定的人为判断,是该方法链条中相对主观的环节。
补充说明
图 1(不在本节文本范围内)应为印有表情记号的旋律乐谱,作为 CM 教学条件的具体载体。“传统表情记号"在西方音乐记谱传统中包括速度术语(如 accelerando、ritardando)、力度术语(如 crescendo、decrescendo)以及断连符号(如 staccato、legato)等。
脚注 / 边栏 / 图表 / 附加信息(如有)
图(Figure 1):在本节末尾 P0021 中被引用,展示三首旋律印有由 MIDI 数据转换而来的表情记号的乐谱,作为 CM 教学条件的可视化产物,用以证明 MIDI 偏离量如何被翻译为传统记谱。脚注:本节文本范围内未出现脚注。边栏/方框/表格:本节无此类附加材料。
💡 本节核心要点
- 本节的总目标是建立研究的内部效度,即保证 MI、AM、CM 三种教学条件在内容上等价,仅在呈现形式上不同。
- MI 材料的制作采用两阶段专家筛选:七位实用音乐教授独立提出意象/隐喻样本,再由 12 位有音乐学位的演奏者按"能否引发大学生演奏者的表情演奏"标准独立评分,每首旋律得分最高的样本入选。
- AM 材料的制作由三位专家钢琴家基于 MI 意象演奏,经 MIDI 录制九次演奏,沿速度(响度)、音起始间隔(速度)、相对时值(断连)三维度分析,演奏者间相关 r > .70、演奏者内相关 r > .90,最后选取 MIDI 数据最接近九次平均轮廓的那一次演奏作为教学材料。
- CM 材料由研究者将同一份 MIDI 数据中的偏离量翻译为印刷乐谱上的传统表情记号(图 1),从而使三种教学形式在内容上同源于同一组意象样本。
- 三阶派生链(意象样本 → 专家听觉示范 → 记谱符号)的同源性是本实验归因逻辑的关键:受试表现的差异可被稳健地归因于教学形式本身,而非内容差异。
🔑 关键术语
- Internal validity:实验内部效度;在本研究中特指三种教学条件(MI、AM、CM)在教学内容上是否等价,从而保证观察到的差异可归因于教学形式而非内容差异。
- Metaphor/Imagery (MI) condition:隐喻/意象教学条件;本研究三种教学条件之一,使用文字意象或描述性比喻来指导演奏者进行表情演奏。
- Aural Modeling (AM) condition:听觉示范教学条件;本研究三种教学条件之一,使用专家钢琴家的实际演奏录音作为教学材料,让学习者通过聆听与模仿获得表情演奏的范例。
- Concrete Musical (CM) condition:具体音乐教学条件;本研究三种教学条件之一,使用印有表情记号的印刷乐谱作为教学材料。
- Key velocity (loudness):琴键速度(响度);MIDI 所记录的每个音符的敲击力度,对应音乐中的响度或强弱变化。
- Interonset interval (tempo):音起始间隔(速度);相邻音符起始时刻之间的时间间隔,对应音乐中的速度或节奏快慢。
- Relative note duration (articulation):相对音符时值(断连/发音法);各音符实际持续时值之间的比例关系,对应音乐中的断连方式。
- MIDI:乐器数字接口(Musical Instrument Digital Interface);电子乐器与计算机之间传输演奏数据(力度、时间、时值等)的标准通信协议,可将演奏转化为可量化的数据用于分析。
CH2_S5 Procedure
第1段(P0022)
原文复述
Procedure
中文讲解
这是本章小节标题「Procedure(实验流程)」。它标志着文章从先前对研究目的、刺激材料与被试的描述,转入方法学核心:研究者具体如何安排被试、刺激与三类教学条件,以便后续可以比较不同教学方式对表现力的影响。整节的任务是为读者提供一份足以重复实验或评估内部效度的操作说明。
第2段(P0023)
原文复述
The researcher administered the procedure to one subject at a time. Subjects were first seated at the Korg Concert 3500 piano, shown the unmarked printed notation of the melodies, and given opportunity to practice. Subjects then performed the melodies in a “normal musical way, without doing anything special.” These baseline performances were recorded via MIDI and saved as computer files. The order of the melodies was counterbalanced among subjects.
中文讲解
本段描述的是正式教学干预之前所发生的「基线阶段」。其设计要点有三:(1) 逐个施测,避免群体互动对个人演奏的污染;(2) 先看无标记乐谱并允许练习,再要求被试以「正常音乐方式」演奏,目的是在没有任何表现力指导的情况下,捕获每人对每段旋律的默认处理方式;(3) 用 MIDI 记录并保存为计算机文件,使后续能够逐音符地量化力度、时值等参数,为比较「基线—教学后」的变化提供可分析的客观数据。「旋律顺序在被试间进行平衡(counterbalanced)」则是为了排除顺序效应——例如某旋律先弹会让被试对后弹旋律更熟悉——从而确保观察到的差异更可能来自教学条件本身,而非呈现次序。
补充说明
本段中 Korg Concert 3500 是被试实际演奏所用的电钢琴型号;「MIDI」指乐器数字接口协议,可在不录制音频的情况下保存每个按键事件的时间戳与力度等离散参数,从而便于后续量化分析。
第3段(P0024)
原文复述
Subjects then received instructions regarding the procedure. They were told that they would receive instruction for making their performance of the melodies more expressive, and that they would be asked to “think aloud” as they received the instruction and practiced their performance in light of it. Subjects were then given additional explanation of the think-aloud verbal reporting they would do and provided with several practice tasks to become comfortable with it.
中文讲解
本段紧接基线阶段,引入本实验的方法学核心——「出声思考(think-aloud)」协议。作者在此承担两项工作:一是让被试知道接下来会被给予使演奏「更有表现力」的教学,并把口头报告嵌入「接收教学」与「依教学练习」两个时点;二是先用额外解释加若干练习任务,让被试熟悉出声思考的运作方式。这两步设计的功能在于:出声思考对普通被试并不自然,若不在数据采集前加以训练,被试的报告可能流于碎片化或被教学刺激所中断;通过预练习把这一报告方式常规化,研究者才能把后续收集到的话语视为对教学理解与加工过程的可靠窗口。同时,让被试事先了解「目标是更有表现力地演奏」,避免在真正接受教学时把表现力处理当作临时偶发行为。
补充说明
本段提到被试要在「接收教学」与「依教学练习」两个时点进行出声思考,这一边界划分在 P0025 中得到具体落实——前者对应「考虑教学的口头报告」,后者对应「练习过程中的口头报告」。
第4段(P0025)
原文复述
Then for each melody, subjects experienced a single different instructional condition, the order of which was counterbalanced across the sample. Subjects encountered the melodies in the same order in which they gave their baseline performances. With each, they received the expressive instruction, then verbally reported their thoughts while considering it and practicing their performance of the melody; subsequently they gave a final expressive performance of the melody, which was recorded as a MIDI computer file. When in the AM instructional condition, subjects viewed the unmarked printed notation of the melody while hearing the expert model on the keyboard before them. They could listen to the model and practice their own performance as many times as desired. While in the CM instructional condition, subjects viewed the printed scores with expressive markings (as in Figure 1). In the MI instructional condition, they viewed unmarked notation of the melody above the printed text of the imagery/metaphor example. In the CM and MI conditions, subjects could view the instruction as long as they wanted and practice as much as they wished. With respect to their practicing in all conditions, subjects were asked to practice melodies only in complete run-throughs (i.e., no fragments of a melody), to track the amount of practicing done per melody and per instructional mode; given the technical simplicity of the melodies, subjects abided by this stipulation with very few exceptions.
中文讲解
本段是整节「Procedure」的核心,描述三类教学条件如何施加以及被试在每种条件下做了什么。可以从四个层面理解:
(1) 整体结构。对每段旋律,被试只经历一种教学条件;旋律在样本间平衡;同一被试接触旋律的顺序与其基线演奏顺序一致,以保证「同一旋律在基线—教学后」形成真正的配对比较。每段旋律内部,被试经历「接收教学 → 边考虑边出声思考 → 边练习边出声思考 → 给出最终表现力演奏(以 MIDI 文件保存)」四步。
(2) 三类教学条件分别是什么。AM(Auditory Model,听觉示范):被试看着无标记乐谱,同时听到专家在面前键盘上弹出的示范,可反复听并自行练习。CM(Conventional expressive Markings,传统表现力标记):被试看的是带有人工表现力记号的乐谱,对应 Figure 1。MI(Metaphorical/Imagery Instruction,隐喻/意象教学):被试看到的是无标记乐谱上方附带的意象/隐喻教学文本。三种条件在「呈现通道」上分别是听觉、视觉符号、视觉文字;在「外部参照」上分别是声音模型、记号模型、概念提示。
(3) 控制项。CM 与 MI 条件允许被试自行决定查看教学与练习的时长;AM 条件允许反复聆听与练习——这使各条件下被试接触教学的「机会」大致对等,避免因某条件强制时间不足或某条件过度练习而混淆教学效果与练习量。
(4) 练习方式的统一约束。所有条件下,被试被要求只做完整通篇(complete run-throughs)练习,不可只练片段,目的是使「练习量」可以用通篇次数直接度量;同时考虑到旋律技术简单,这一约束几乎没有被违反,从而保证了练习计数与教学条件之间关系的清洁度。
整体上,本段用对照式的条件描述,把「教学类型」这一自变量与其他可能影响因素(顺序、练习量、片段化练习)隔离开,为后续比较三种教学条件对演奏表现力的相对有效性提供了方法学基础。
补充说明
本段中的 AM、CM、MI 三种教学条件缩写以及 Figure 1 所展示的传统表现力记号示例,均对应前文所介绍的三种表现力教学方式(听觉示范、传统记号、意象/隐喻);被试在每段旋律上仅接受一种条件,是典型的被试内×被试间混合设计——旋律在被试内,教学条件在被试间平衡。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节附加材料仅有 Figure 1(被 P0025 提及),用于展示 CM 条件下被试所看到的「带表现力记号的乐谱」形态,作为传统记号教学条件的视觉参照。脚注未出现于本节范围内。
💡 本节核心要点
- 实验按被试逐一施测,先采集每位被试对所有旋律的「正常演奏」基线,并以 MIDI 文件保存,作为后续比较的参照点。
- 旋律呈现顺序在被试间进行平衡(counterbalanced),并将教学阶段中旋律顺序与基线顺序保持一致,使同一旋律在「基线—教学后」形成配对,控制顺序效应。
- 教学干预阶段统一嵌入「出声思考」协议:被试在「考虑教学」与「依教学练习」两个时点口头报告;事先通过解释与练习任务让被试熟悉该方法,以保证报告质量。
- 三种教学条件——AM(听觉示范)、CM(传统表现力记号)、MI(意象/隐喻)——分别通过听觉通道、视觉符号通道、视觉文字通道呈现,每段旋律仅施加一种条件,且在被试间平衡。
- 为隔离「教学类型」这一自变量,研究者在各条件下都允许被试按自身节奏查看与练习,并把练习方式统一限定为完整通篇,以便按旋律、按条件统计练习量。
🔑 关键术语
- Korg Concert 3500:本实验使用的电钢琴型号;为被试演奏与 MIDI 录制提供一致的键盘与接口硬件。
- MIDI:乐器数字接口协议;在本实验中以离散事件(按键时间、力度等)形式保存演奏数据,便于后续对表现力参数进行量化分析。
- counterbalanced:平衡设计;本节在两个层级使用:一是旋律顺序在被试间平衡以排除顺序效应,二是三种教学条件在被试间平衡以使每个被试只贡献一种条件下的观察。
- think-aloud (verbal reporting):出声思考协议;要求被试在「考虑教学」与「练习」过程中实时说出自己的思路,本节用专门解释与练习任务对该方法加以规范。
- AM (Auditory Model) instructional condition:听觉示范教学条件;被试看无标记乐谱并反复聆听专家在键盘上的示范,自行练习。
- CM (Conventional expressive Markings) instructional condition:传统表现力记号教学条件;被试查看带有表现力记号的乐谱(对应 Figure 1),并依此练习。
- MI (Metaphorical/Imagery Instruction) instructional condition:意象/隐喻教学条件;被试查看无标记乐谱上方所附的意象或隐喻教学文本,并依此练习。
- complete run-throughs:完整通篇练习;本节对所有条件统一要求被试只做整段练习、不练片段,以便把练习量按「通篇次数」直接量化。
CH3_S1 [描述性拆分] Data Analysis Plan
第1段(P0026)
原文复述
RESULTS
中文讲解
This paragraph is the top-level section heading “RESULTS,” which signals the beginning of the Results section of the paper. Its function is structural rather than substantive: it marks the point at which the article transitions from the Introduction and Method to reporting what the data analysis revealed. For the purposes of this subsection (“Data Analysis”), the heading indicates that the authors are about to describe, first, how they analyzed the collected MIDI data (the present subsection) and, subsequently, what the analysis found. The heading itself does not advance any claim; it only opens the论题 of reporting results.
第2段(P0027)
原文复述
Data Analysis
中文讲解
This paragraph is the subsection heading “Data Analysis,” which falls within the Results section. Its role is to mark the start of a focused, method-oriented description: although it appears under “Results,” the subsection enumerates the statistical procedures applied to the MIDI recordings rather than presenting outcome statistics. It therefore functions as a bridge between the Method section (where data were described) and the subsequent reporting of findings. Within the subsection, the authors preview the four analytical tools they will use — arithmetic means, root mean square error (RMSE), Pearson correlation coefficients, and Fisher’s z transformation — and thereby orient the reader to the structure of the analysis that follows. The heading itself makes no empirical claim.
第3段(P0028)
原文复述
The MIDI computer files containing subjects’ baseline and expressive performances provided measures of the expressive performance properties of loudness (key velocity), tempo (interonset interval), and articulation (relative note duration). For each property, several statistics were computed for subjects. To determine overall levels for entire melodies, an arithmetic mean was computed for baseline and expressive performances. Also, a root mean square error (RMSE) statistic was used to assess subjects’ absolute change from baseline to expressive renditions. Because the MIDI loudness, tempo, and articulation data use different scales, the RMSE values for each were normalized for presentation in tables, allowing comparison between the properties. However, hypothesis testing used the raw RMSE values. Finally, Pearson product-moment correlation coefficients assessed similarity to an accepted expressive interpretation by correlating the MIDI data of subject performances to those of the expert model performances used in the AM condition. In other words, this allowed for a pretest-posttest comparison, with the pretest showing how similar a subject’s baseline performance was to the expert model and the posttest indicating how similar the final expressive performance was to the same model. For computing group statistics (e.g., averages) and testing for statistical significance, Fisher’s z transformation was applied to correlation coefficients.
中文讲解
本段是「Data Analysis」小节的核心段落,逐项交代了对MIDI数据所做的统计分析。其论证逻辑可拆为四步:
-
数据来源与三维度的映射。 作者首先指明数据来自受试者基线(baseline)与表达性(expressive)演奏的MIDI计算机文件,并将MIDI可直接读取的三类参数对应到三个音乐表现维度——响度对应键速(key velocity)、速度对应音符起始间隔(interonset interval)、 articulation对应相对音符时值(relative note duration)。这一步为后续所有统计提供了具体可观测的量化对象。
-
总体水平的刻画——算术平均。 为了描述整段旋律的整体水平,分别对基线演奏与表达性演奏在每个维度上计算算术平均,得到受试者整体表现的概貌。
-
绝对变化的刻画——RMSE及其归一化。 为了衡量受试者从基线到表达性演奏的「绝对变化量」,作者采用均方根误差(RMSE)。但MIDI三个维度量纲不同(键速、起始间隔、时值各有自己的数值范围),直接比较RMSE没有意义,因此作者做了一个区分:表格中展示的RMSE经过归一化以便跨维度并列阅读;然而,假设检验(hypothesis testing)则使用原始、未归一化的RMSE值。这一限定语「However, hypothesis testing used the raw RMSE values」至关重要——它防止读者误以为归一化后的数值被用于统计推断,体现了方法上的严谨。
-
与专家模型的相似性——Pearson相关与Fisher z转换。 最后,作者用Pearson积差相关系数把受试者的MIDI数据与AM条件下使用的专家模型(expert model)的MIDI数据做相关,得到一个「与公认表达性诠释相似度」的指标。作者明确把它解释为前测—后测设计:前测反映基线演奏与专家模型的相似度,后测反映最终表达性演奏与同一专家模型的相似度。这一前后对比恰恰是本研究检验「听专家示范后受试者是否变得更接近专家表达」这一核心问题的关键。
由于后续需要对相关系数做组统计(例如求平均)并进行显著性检验,而相关系数本身的抽样分布并非正态,作者因此对r值施加了Fisher’s z转换,使其近似正态以便做参数统计。
整段在本节中的作用是:先界定分析对象(三个MIDI维度),再分别给出描述性统计(平均)、变化量统计(RMSE)、以及与外部标准(专家模型)的相关分析,并对每一步所采用的统计工具的适用条件(量纲归一化展示但原始值检验、相关需z转换)都做了说明,为后续呈现具体结果奠定方法基础。
容易误解之处:不要把表格中展示的「归一化RMSE」当作统计推断的输入;归一化只服务于跨属性的视觉比较,真正进入假设检验的仍是原始RMSE。同样地,「pretest-posttest comparison」中的「pretest」并非一个独立实验阶段,而是指同一个被试的基线演奏这一时间点相对于专家模型的距离——它是纵向上的「前」。
补充说明
关于AM条件中的「expert model performances」:该术语在前文方法部分已有设定,本段将其作为与受试者表现做相关比较的参照标准,故此处无需补充外部信息。关于「Fisher’s z transformation」:本段仅交代其用途为使相关系数满足组统计与显著性检验所需的近似正态性,并未提供公式,故无需补写公式或历史背景。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节无脚注、无图表、无边栏文本。仅包含两层级标题(## RESULTS、## Data Analysis)和一段方法描述。
💡 本节核心要点
- 分析对象是MIDI文件中的三个参数,分别映射响度(key velocity)、速度(interonset interval)与articulation(relative note duration)三个表达性维度。
- 整体水平用算术平均刻画,绝对变化量用RMSE刻画。
- 表格中展示的RMSE经过归一化以便跨属性比较,但假设检验使用未经归一化的原始RMSE——展示与推断必须区分。
- 通过Pearson积差相关将受试者MIDI数据与AM条件所用的专家模型MIDI数据做相似度比较,被作者明确定义为前测(基线对专家)—后测(最终表达性演奏对专家)设计。
- 对相关系数施加Fisher’s z转换,以便后续做组平均与显著性检验。
🔑 关键术语
- MIDI (Musical Instrument Digital Interface):一种音乐设备数字接口协议,能以数字方式记录键速、起始时间、时值等演奏参数;本研究中它是用作量化受试者演奏的原始数据载体。
- key velocity:MIDI中表示按键速度的参数,本研究将其作为响度(loudness)的量化指标。
- interonset interval:相邻音符起始时刻之间的间隔时长,研究中用作速度(tempo)的量化指标。
- relative note duration:音符实际时值相对于其标称时值的比例,研究中用作articulation(断连、连奏程度)的量化指标。
- RMSE (root mean square error):均方根误差,研究中用于衡量同一受试者从基线演奏到表达性演奏之间的绝对偏离量。
- Pearson product-moment correlation coefficient:皮尔逊积差相关系数,研究中用于度量受试者演奏数据序列与专家模型演奏数据序列之间的线性相似度。
- AM condition:指研究中使用听觉示范(Auditory Model)条件的专家演奏数据,作为相关分析的参照标准。
- Fisher’s z transformation:对相关系数r的一种数学转换,使r的抽样分布近似正态,从而可对其做组统计(平均)和参数化的显著性检验。
CH3_S2 [描述性拆分] Practice and Listening Frequencies Across Conditions
第1段(P0029)
原文复述
Tape recordings of the research sessions allowed subjects’ verbally reported thoughts to be transcribed into computer text files for analysis. Session tapes were also used to compute the following information: subjects practiced each melody an average of 3.8 times, with no statistical difference between Melodies 1, 2, and 3. However, practicing in the CM condition was significantly greater, averaging 4.8 run-throughs, as compared to 3.3 in both the AM and MI conditions, F(2, 35) = 12.66, p < .001. In the AM condition, subjects listened to the expert model an average of 3.5 times, with no statistical difference between melodies.
中文讲解
本段交代了研究行为数据的来源及两组关键描述性统计。
第一,录音材料被双重利用:一是把被试的口头报告转写成计算机文本文件用于后续分析,二是从中统计练习与聆听次数。因此读者理解后续所有行为指标的原始数据基础都建立在这批录音带之上。
第二,练习次数(practice frequency)的描述统计分两层呈现:①跨条件、跨旋律平均为 3.8 次,且 Melodies 1、2、3 之间无统计差异——说明三首旋律在难度或可练习性上是等价的,排除了“旋律差异”这一混淆变量;②但在不同实验条件之间出现显著差异:CM 条件下平均练习 4.8 次,而 AM 与 MI 条件下均为 3.3 次。F(2, 35) = 12.66, p < .001 表明这一条件间差异在统计上极其稳健,远远超出 .05 的常用门槛。换句话说,CM 条件下被试练得明显更多。
第三,在 AM 条件内部,被试平均聆听专家示范 3.5 次,且不同旋律之间无差异。这一数字为后续讨论“AM 条件是否因为提供了外部模型而被试听够了”提供了参照。
本段在小节论证中的作用:它属于描述性/操作性的控制信息,目的是让读者了解三组被试在暴露量(练习次数、聆听次数)上并非完全对等——CM 组练习量高于另外两组。这一不对等是后续解释学习结果差异时必须考虑的潜在混淆因素,作者提前披露出来,为下一步结果的解读奠定基础。读者若忽略 CM 组多练 1.5 次这一事实,就可能把纯粹的学习差异错误归因于模型/条件本身的优越性。
补充说明
- “run-throughs”指被试完整地从头到尾演奏或跟弹一遍旋律,区别于片段练习或重复同一小节。
- F(2, 35) 的自由度为 2(条件数 − 1)和 35(误差自由度),提示总样本在条件内约 12 人/组左右,但确切人数需参照本段之外的样本信息。
- CM、AM、MI 是三种实验条件的缩写标签,其完整含义定义在前文方法部分,本段并未给出,故在此不展开释义。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节除正文段落外无独立脚注、图表或边栏内容。文中出现的 F(2, 35) = 12.66, p < .001 属于正文内嵌的统计报告,并非独立脚注。
💡 本节核心要点
- 录音材料在本研究中具有双重功能:转写口头报告与量化练习/聆听次数。
- 三首旋律在平均练习次数上无差异(均为 3.8 次),保证了旋律之间的等价性。
- CM 条件下的练习次数(4.8 次)显著高于 AM 与 MI 条件(均为 3.3 次),F(2, 35) = 12.66, p < .001,条件间暴露量不对等。
- AM 条件下被试聆听专家示范平均 3.5 次,且不同旋律之间无差异。
- 描述性数据揭示了 CM 组练习量更大的潜在混淆因素,为后续学习结果差异的解释提供必要的对照背景。
🔑 关键术语
- run-throughs:指被试完整地从头到尾演奏或跟弹一遍旋律的次数,是本段衡量“练习量”的基本单位。
- F(2, 35) = 12.66, p < .001:方差分析的 F 统计量报告形式,自由度为 2 和 35,p 值小于 .001 表明三组练习次数均值差异在统计上极其显著。
- CM / AM / MI conditions:三种实验条件的缩写标签(具体含义需参照本段之外的方法部分),本段仅显示其在练习和聆听次数上的差异比较。
- expert model:在 AM 条件下提供给被试聆听的专家示范演奏,是 AM 条件区别于 CM 与 MI 条件的关键外部资源。
CH3_S3 [描述性拆分] Melody 1: Mean Levels and Salient Properties
第1段(P0030)
原文复述
Melody 1
中文讲解
这是一个二级小节标题,标示下面内容专门讨论第一段旋律(Melody 1)。它在该研究中起到分块作用:把针对第一段旋律的描述性统计结果集中呈现,与后续其他旋律的小节形成并列结构。该标题本身不包含论述,只承担导航与分节功能。
第2段(P0031)
原文复述
Of the data presented in Table 1, the strong positive r values suggest that loudness and tempo, in that order, were the most salient expressive properties of Melody 1. Comparing the mean levels of the sample’s baseline performances with those of the expressive performances (first and second columns) shows that the instruction resulted in final performances that were softer, slower, and slightly more legato. The overall reduction in loudness from 75.5 to 70.3 was significant, and although the AM mode actually produced a small increase in loudness, it finished with a level closest to the expert model. The slowing in average tempo across the sample was also significant, with the MI condition eliciting greater change than the other two conditions. The AM and CM conditions, however, yielded final tempi much closer to the model. Clearly, articulation was not an important property of Melody 1 (not surprising, as the CM print materials included a slur/phrase marking across the entire melody and the expert pianist of the AM stimulus performed all notes in a consistently legato style).
中文讲解
本段围绕第一段旋律(Melody 1)展开描述性结论,论证结构分为三层:先用相关性证据判定“哪些属性最突出”,再用基线与表现后均值对比说明“指令产生了什么方向的变化”,最后对每个属性逐一交代统计意义与不同条件(AM、CM、MI)下的差异。
第一层结论:“强烈的正 r 值”提示,按显著程度排序,响度(loudness)排第一、速度(tempo)排第二,是 Melody 1 最突出的两个表现性属性。这意味着在让演奏变得更“富有表现力”时,被试主要调动了这两项参数。
第二层结论:把基线演奏(baseline)列与表现性演奏(expressive performances)列的均值对照,可看到指令带来的总体方向——更轻(softer)、更慢(slower)、略微更连贯(slightly more legato)。这是均值层面的整体变化趋势,而不是单个被试的描述。
第三层对各属性逐一说明:
- 响度方面:样本整体响度由 75.5 降至 70.3,下降显著。值得注意的是,AM 条件下的响度反而略有上升,但其最终值最接近专家示范(expert model)。这说明“样本均值方向”与“最接近专家”这两件事并不一定一致——AM 组虽然小幅变响,却比别的组更贴示范的响度水平。
- 速度方面:样本整体速度的减慢也是显著的;其中 MI 条件(即“mental imagery”或类似意象条件,由本节上下文可知)所引起的速度变化幅度大于其余两种条件。但若以“接近专家示范”为标准,则 AM 和 CM 条件最终得到的速度比 MI 更贴近示范。这与响度上的结论形成呼应:均值变化最大者,未必是距离专家最近者。
- 连奏(articulation)方面:作者明确指出“连奏并非 Melody 1 的重要属性”,并给出材料层面与示范层面的解释——CM 印刷谱在整条旋律上印有一条连奏/乐句线(slur/phrase marking),而 AM 刺激中的专家钢琴家通篇以一致的连奏风格演奏所有音符。换言之,乐谱和示范本身已经把“连贯”钉死,留给被试在 articulation 维度上的可操作空间本来就很小,所以它没成为显著变量。
本段在论证链上的作用是:先回答“最突出属性是什么”,再回答“指令带来了什么均值变化”,最后用材料事实解释“为何某属性未起重要作用”。这样既给出数据驱动的结论,也为反直觉或非显著的结果(如 articulation 不显著)提供了基于乐谱与示范的理由,避免读者误读为“被试没学到 articulation”。
补充说明
本段多次出现的 AM、CM、MI 是三种不同的示范/条件类型缩写(具体含义需结合前文方法部分确认,本节未给出定义,故不在此处补写)。r 值指的是相关分析中的相关系数,作者用它判定属性是否“突出”(salient)。文中“expert model”指作为参照标准的专家示范演奏。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节未出现脚注、图、边栏或表格正文;Table 1 在文中被引用,但本节范围仅包含对其内容的文字描述与解读,不含表格本体的版面元素。
💡 本节核心要点
- 依据 Table 1 中强烈的正相关 r 值,Melody 1 的最显著表现性属性依次为响度和速度。
- 与基线演奏相比,指令使演奏整体变得更轻、更慢、略微更连奏,这是均值层面的方向性变化。
- 样本整体响度从 75.5 显著下降到 70.3;AM 条件下响度反而略升,却最接近专家示范。
- 样本整体速度减慢显著,其中 MI 条件引起的速度变化幅度大于 AM 和 CM,但 AM 与 CM 的最终速度更接近专家示范。
- articulation 在 Melody 1 中不是重要属性,原因在于 CM 谱面带有跨越整段旋律的连奏/乐句标记,且 AM 刺激中的专家示范全段都保持一致的连奏风格,留给被试的操作空间很小。
🔑 关键术语
- salient expressive properties:在表现性演奏中最突出、最具区分性的属性;本节依据 Table 1 的正相关 r 值排序,得出响度与速度是 Melody 1 最显著的两项属性。
- r values:相关分析中的相关系数;作者用“强烈的正 r 值”来判定某项属性是否属于最突出的表现性属性。
- baseline performances:被试在没有表现性指令时的演奏,作为对照基线;本节将其与“表现性演奏”列的均值进行比较。
- expert model:作为参照标准的专家示范演奏,本节用它衡量 AM、CM、MI 各条件下被试最终演奏与示范之间的接近程度。
- articulation:指音符的连奏/断奏等发音方式属性;本节说明其在 Melody 1 中不显著,并归因于谱面与示范已统一为连奏风格。
CH3_S4 [描述性拆分] Melody 1: Baseline Correlations and RMSE Changes
第1段(P0032)
原文复述
As shown in the third column of Table 1, subjects’ baseline performances correlated well with the expert model used in the AM condition in terms of tempo and especially loudness. The fourth and fifth columns together reveal how performances changed from baseline to expressive. The normalized RMSE values show that subjects changed their performances most in tempo, then loudness, and least in articulation. The tempo profiles of the expressive performances tended to change away from an expert-like interpretation, including in the AM condition, in which subjects actually heard the expert model. Only the CM mode resulted in a higher tempo correlation coefficient in the expressive performance. In contrast, correlation coefficients for loudness improved across the sample, with no differences between the instructional modes.
中文讲解
本段是Melody 1小节对表1核心数据的概括性叙述,承担两个论证功能:一是报告基线(baseline)状态,二是刻画从基线到表现性演奏(expressive)的变化方向与幅度。
第一层主张(基线相关性):被试在AM条件下未受干预时的演奏,其节拍(tempo)与专家模型的相关系数已经较高,尤其是响度(loudness)。这意味着起点上被试的演奏并非随机或毫无章法,而是与专家模型存在可观的自然一致性,从而缩小了后续可能观察到的变化空间。
第二层主张(变化幅度,按RMSE排序):作者用归一化的均方根误差(normalized RMSE)衡量被试从基线到表现性演奏的偏离幅度,结果呈现稳定的等级:tempo变化最大,loudness居中,articulation(发音/咬字)变化最小。这一顺序告诉我们哪个维度对“表现性”这一操纵最敏感、最容易被被试主动改造。
第三层主张,也是本段最值得深入理解的发现——关于tempo变化的方向出现了一个反直觉的结果:被试在表现性演奏中的tempo曲线整体上是背离专家式诠释的。值得注意的是,即便在AM条件下——被试明确听到了专家模型——tempo也并未向专家靠拢。唯一使tempo相关系数在表现性演奏中升高的,是CM模式。结合前文,只有CM反而让表现性演奏更贴近专家,这一现象构成与一般预期(听到专家就应学得更像)的张力,作者在此明确点出而非回避。
第四层主张(响度方向相反):与tempo相反,响度的相关系数在整个样本范围内在表现性演奏中普遍提升,且不同教学模式之间没有差异。也就是说,响度维度上的“向专家靠拢”是普遍存在的、不依赖具体教学模式的现象。
综上,本段通过tempo与loudness的对照,揭示了教学/诱导对不同音乐维度的不对称效应:响度上的改善具有普遍性,而tempo上的变化不仅幅度最大、且方向常常是背离专家的——这一点是后文讨论为何“听到专家”并不等于“模仿专家”、以及CM模式为何在tempo上独树一帜的关键铺垫。
补充说明
本段多次出现的“AM”和“CM”是指该实验中的不同教学/指导条件(instructional modes),其中AM条件中被试确实听到了专家模型的演奏,CM则为对照或其他条件;本段中两者的具体全称未在此处展开,读者应结合上下文或表1表头确认。normalized RMSE在这里用作“变化量”的指标:值越大表示从基线到表现性演奏的偏离越大,但本段报告的是其相对排序,不是绝对阈值。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节范围内无独立脚注、图注或边栏需要单独汇总;段落P0032本身即对表1第3、4、5列数据的小结性叙述。
💡 本节核心要点
- 基线状态并非零相关:被试在tempo与尤其loudness上已与AM条件所用专家模型呈现较高相关,说明起点并非随机。
- 按归一化RMSE衡量,从基线到表现性演奏的变化幅度排序为:tempo最大、loudness居中、articulation最小。
- tempo在表现性演奏中整体背离专家式诠释,甚至在听到专家模型的AM条件下也是如此,构成本段最核心的反直觉发现。
- 只有CM模式使表现性演奏的tempo相关系数高于基线,是tempo维度上唯一“向专家靠拢”的条件。
- loudness的相关系数在表现性演奏中普遍上升,且各教学模式之间无差异,呈现与tempo完全相反的格局。
- tempo与loudness在方向和模式敏感性上的不对称,是本节论证的关键张力点。
🔑 关键术语
- normalized RMSE:归一化的均方根误差;在本段中用作“被试演奏从基线到表现性演奏的偏离量”的衡量指标,作者按其大小对tempo、loudness、articulation三个维度排序,而非报告绝对阈值。
- baseline performance:基线演奏,指被试在接受任何表现性诱导之前、未被要求“有表现力地”演奏时的状态;是衡量后续变化的参照点。
- expressive performance:表现性演奏,指被试被要求或受引导作出更具音乐表现力诠释后的演奏状态;本段比较的是其与基线以及与专家模型的差距。
- AM condition:本研究的一种教学/指导条件;本段明确指出在该条件下被试能够实际听到专家模型。
- CM mode:本研究的另一种教学模式;本段强调唯有此模式下表现性演奏的tempo相关系数高于基线。
- articulation:音乐演奏维度之一,指音符的起音、连断、清晰度等发音方式;本段指出该维度从基线到表现性演奏的变化最小。
CH3_S5 [描述性拆分] Melody 1: Advanced Versus Competent Pianists
第1段(P0033)
原文复述
Additional analyses (not shown in Table 1) compared the performances of the advanced pianists to those of the competent pianists. The advanced group’s baseline performances (average r = .794) were significantly more similar than those of the competent group (average r = .662), F(1, 35) = 4.21, p < .05. With the expressive performances, however, the instruction allowed the competent pianists to close the gap (advanced r = .891; competent r = .853, n.s.). The tempo data exhibited a different change; the advanced group’s baseline performances were more expert-like (advanced r = .644; competent r = .606), but, within the overall worsening in correlations across the sample, the disparity increased with expressive performances (advanced r = .552; competent r = .484).
中文讲解
本段是对Table 1的额外补充分析(作者明确标注"not shown in Table 1”),目的是在两组内部(高级组与熟练组)之间进行比较,考察"表达性指令"如何改变两组在不同维度上的差异。
整段围绕两个分析维度展开。第一维是"演奏之间的相互相似性”,用演奏两两之间的相关系数r表示。基线条件下(无表达性指令),高级组内部r=.794,熟练组r=.662,F(1,35)=4.21,p<.05,说明高级组彼此演奏风格更接近、更像"专家范式”,且这种组间差距是统计显著的。然而,引入表达性指令后,高级组r上升到.891,熟练组r上升到.853,作者用n.s.(不显著)标明两者差异已不再显著——也就是说,表达性指令使熟练钢琴家"缩小了差距”(close the gap),他们的演奏一致性追上了高级组。
第二维是节奏(tempo)数据,呈现了相反的趋势。基线时两组都更"专家化”,但绝对值都较低(高级r=.644,熟练r=.606);进入表达性演奏后,两组的相关系数都不升反降(高级r=.552,熟练r=.484),作者称之为"overall worsening in correlations across the sample”(全样本相关性的整体恶化),并且两组的差距反而扩大——高级组的节奏一致性比熟练组相对更高。
作者在此用具体数字说明两件事:其一,高级与熟练钢琴家的差异不是单维的,而是随着测量维度(演奏相似性 vs 节奏)和演奏条件(基线 vs 表达性指令)发生方向不同的变化;其二,表达性指令对两组的影响不对称——它在演奏风格维度上帮助熟练者追平高级者,但在节奏维度上不仅没有缩小差距,反而加大了组间分化。这一不对称模式暗示,表达性指令可能调动的是两组演奏者不同的处理机制。
由于这些分析被作者特别注明不在Table 1中,可见其在原研究叙述中属于支持性、补足性的证据,用来强化主分析中关于"专家化演奏"和"表达性指令效果"的论点。
补充说明
本段统计符号说明:r为皮尔逊相关系数(此处指被试两两演奏之间的相似程度);F(1,35)为自由度(1,35)的方差分析F统计量;n.s.即not significant,差异未达统计显著水平;“baseline"指未给出表达性指令的标准演奏条件,“expressive performances"指加入表达性指令后的演奏条件,二者形成本节比较的核心对照。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节为描述性小节,仅含一段正文(带括号统计报告),无脚注、无图表、无公式块、无引用列表;唯一的图示性编号为Table 1,作者明确说明此处分析"not shown in Table 1”,因此本段是正文叙述中的补充统计报告。
💡 本节核心要点
- 本段是Table 1之外的额外分析,专门比较高级组(advanced)与熟练组(competent)两组钢琴家在不同条件下的表现差异。
- 在基线演奏的相互相似性上,高级组(r=.794)显著高于熟练组(r=.662),F(1,35)=4.21, p<.05。
- 加入表达性指令后,两组演奏相似性都上升且差异不再显著(高级r=.891,熟练r=.853, n.s.),即表达性指令让熟练组"close the gap”。
- 节奏(tempo)数据呈现不同模式:基线时高级组更"expert-like"(.644 vs .606),但表达性演奏下两组相关系数都下降(.552 vs .484),整体一致性恶化且组间差距扩大。
- 作者由此说明:高级与熟练演奏者的差异随维度和条件而变化,表达性指令对两组的影响不对称,在风格维度上有助于追平,在节奏维度上反而分化。
🔑 关键术语
- advanced pianists:高级钢琴家——本研究中被界定为演奏水平更接近专家范式的受试组;本段用作与熟练组对比的参照方。
- competent pianists:熟练钢琴家——具备演奏能力但尚未达到专家水平的受试组;本段考察其是否能通过表达性指令缩小与高级组的差距。
- baseline performance:基线演奏条件,即未给出任何表达性指令时按乐谱演奏的情形;用于衡量演奏者本身的风格一致性。
- expressive performance:表达性演奏条件,即接受表达性指令后进行的演奏;本段考察其与基线的差异如何改变组间关系。
- r (Pearson correlation):皮尔逊相关系数,此处指被试两两演奏之间的相似度;值越高说明演奏风格越彼此接近。
- F(1, 35) = 4.21, p < .05:自由度为(1,35)的方差分析结果,F值4.21达到p<.05的显著水平,用以检验两组r均值差异是否显著。
- n.s.:not significant的缩写,表示组间差异未达统计显著;本段用以说明表达性演奏条件下高级与熟练组演奏相似性差异不显著。
- tempo:节奏/速度维度;本段单独考察这一维度的相关系数,发现其与"演奏相似性"维度的变化方向相反。
- overall worsening in correlations:全样本相关系数的整体下降——表达性指令下节奏维度的两组r都降低,作者用以强调节奏与风格维度受表达性指令的影响机制不同。
CH3_S6 [描述性拆分] Melody 1: Explaining the Tempo Worsening
第1段(P0034)
原文复述
A possible explanation for the worsening in tempo correlations emerged with an examination of the characteristics of the Melody 1 instruction. As seen in Figure 1, Melody 1’s ritardando and decrescendo had different starting points, resulting in several beats of simultaneous acceleration and quieting. Only with the CM condition, in which subjects were explicitly informed of this conflict, did the correlation improve from baseline to expressive performance (Table 1). The verbal reports of subjects in the CM condition provided additional evidence for this; they included mention of the loudness and tempo features as “difficult,” “awkward,” “weird,” “unusual,” and “poorly placed.”
中文讲解
本段是作者对前文报告的"节奏相关性反而下降"这一反常结果给出的第一种解释。中心主张是:Melody 1 的乐谱指令本身存在速度(ritardando,渐慢)与力度(decrescendo,渐弱)的起点错位,因此在演奏中前几个拍子里会出现"一边加速一边变轻"的内在冲突,这种冲突被试者若不加提示就难以协调,从而导致节奏维度的表现性表达被削弱,相关性下降。
关键推理链如下:(1) 作者回到乐谱本身(参看 Figure 1),发现 ritardando 和 decrescendo 的起点不同;(2) 这意味着在被试开始做出渐慢之前,乐曲已经在同时要求渐弱,两条表现性指令存在时间上的错位;(3) 在没有外部提示的条件下,被试难以同时处理两个冲突维度,因此节奏表现受到牺牲;(4) 只有在 CM 条件下,被试被明确告知这一冲突后,他们才可能在基础演奏与表现性演奏之间提高节奏相关性(参看 Table 1);(5) CM 条件被试的口头报告——“困难、别扭、古怪、不寻常、放置不当”——进一步佐证了被试确实感知到了这两个特征的不自然,验证了作者的归因。
本段在论证中起"回溯归因"的作用:前面小节报告了相关性的恶化,本段为其中节奏相关性变差提供具体、可观察的乐谱证据,并把口头报告与统计结果相互印证。它也引出了一个一般性方法论要点——在表现性演奏研究中,当一个维度的统计结果出人意料时,常常需要回到乐谱指令本身去检查是否存在内嵌冲突。
容易误解之处:作者并不是说 ritardando 与 decrescendo 本身有任何问题,而是说当二者的起点被错开安排时,会人为地制造一个被试必须解决的协调难题;CM 条件的"改善"是相对于同一条件下从基础到表现性演奏的内部变化,而不是跨条件的绝对比较。
补充说明
无额外补充。Figure 1 与 Table 1 的具体内容本段未展开,需查看原图与原表;本段对它们的引用仅作为支撑依据。
💡 本节核心要点
🔑 关键术语
- ritardando:渐慢的演奏指示。在本节中指 Melody 1 中起始点与 decrescendo 不一致的速度变化指令,是造成表现性冲突的速度维度来源。
- decrescendo:渐弱的演奏指示。在本节中指 Melody 1 中起始点与 ritardando 不一致的力度变化指令,是造成表现性冲突的力度维度来源。
- CM condition:本研究中的一种实验条件,被试被明确告知乐谱指令之间存在的冲突。在本段中用于解释为何只有在该条件下节奏相关性才从基础演奏提高到表现性演奏。
- correlation (tempo correlation):指基础演奏与表现性演奏之间在节奏维度上的相关程度。本段讨论其为何在多数条件下未提高甚至下降,以及为何在 CM 条件下得以改善。
CH3_S7 [描述性拆分] Melody 2: Mean Levels and Salient Properties
第1段(P0035)
原文复述
Melody 2
中文讲解
这是一个二级小节标题,用以开启对第二段旋律(Melody 2)实验结果的报告。该标题采用与前文 Melody 1 结果小节平行的命名结构,表明接下来的段落将汇报针对 Melody 2 的描述性统计与显著性发现,与 Melody 1 的小节形成对照与呼应,承担"分旋律汇报"的导航功能。
第2段(P0036)
原文复述
Similar to those for Melody 1, the changes made to Melody 2 baseline performances resulted in expressive performances that were quieter, slower, and more legato (Table 2). The decrease in loudness level across the sample, from 72.1 to 65.2, was significant, with the MI condition producing the largest drop. The mean overall dynamic levels produced by the three modes (AM = 67.4, CM = 65.9, MI = 62.4) were in each case very similar to that of the expert model (M = 64.6). The sample’s slowing in tempo was also significant, with the AM mode eliciting a greater reduction than the other conditions. Tempo and, to a lesser extent, loudness were the most salient expressive properties. As with Melody 1, articulation was not important in the performance of Melody 2.
中文讲解
本段报告 Melody 2 实验的描述性结果,与 Melody 1 的小节形成明确的平行对照结构。
中心主张是:对 Melody 2 基线演奏所做的修改同样使演奏变得更安静、更慢、更连奏(legato),其方向与 Melody 1 完全一致。这是通过显式的比较语句(“Similar to those for Melody 1”)建立起来的跨旋律一致性——作者意在说明同一实验操纵在不同旋律上产生了稳定的结果模式。
在具体数据层面,本段包含三个并行的统计要点:
- 响度层面:样本响度从 72.1 显著下降到 65.2(约 6.9 个单位的下降),其中 MI 条件造成的降幅最大。
- 与专家模型的接近度:三种模式(AM = 67.4,CM = 65.9,MI = 62.4)所产生的平均总体动态水平,作者均判定为"very similar"于专家模型的水平(M = 64.6)。从数值上看,CM(65.9)距专家模型最近(差 1.3),MI 次之(差 2.2),AM 最远(差 2.8)——但作者用统一的"very similar"统称三者,强调三种条件均能让演奏响度贴近专家水平。
- 速度层面:样本速度也显著放慢,但与响度的模式形成对照——AM 模式带来的减速幅度大于其他条件。这一对照(响度最大降幅在 MI,减速最大幅度在 AM)暗示速度与响度两个参数对不同实验模式具有不同的敏感性。
在显著性表达属性的排序上,作者明确给出:速度是最显著的表达属性,响度次之,断/连奏(articulation)则"不重要"。该排序与 Melody 1 的结论一致,从而再次强化跨旋律的可重复性。
本段在小节论证中承担"Melody 2 结果复述与跨旋律一致性证明"的功能:通过与 Melody 1 的对比,论证操纵—响应的关系不是某一首旋律的偶然现象,而是具有跨样本的稳健性。
补充说明
“the three modes"指 AM、CM、MI 三个实验条件;其各自全称在本段内未给出。Table 2 为本段所有数值提供数据出处。专家模型 M = 64.6 作为参照基准,用于评估三种条件下动态水平与人类专家演奏的接近程度。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节仅引用 Table 2 作为数值来源,未涉及脚注、图示、边栏等其他附加材料。
💡 本节核心要点
- 对 Melody 2 基线演奏的修改同样产生了更安静、更慢、更连奏的表达性演奏,方向与 Melody 1 一致,显示出跨旋律的结果稳定性。
- 样本响度由 72.1 显著下降至 65.2,其中 MI 条件造成的降幅最大。
- 三种模式(AM = 67.4,CM = 65.9,MI = 62.4)的平均总体动态水平都被作者判定为与专家模型(M = 64.6)“very similar”,说明三种条件下演奏响度均能贴近人类专家水平。
- 速度也显著放慢,但与响度结果形成对照——AM 模式在速度上造成的减速幅度最大,而非 MI。
- 在表达属性的显著性排序中:速度最为突出,响度次之,articulation(断/连奏)不重要,与 Melody 1 的结论一致。
🔑 关键术语
- legato:音乐演奏术语,指音符之间连贯、不断开的连奏方式,与 staccato(断奏)相对。本段用以描述修改后的演奏比基线更加连贯。
- salient:显著的、突出的。在本节中用于排序表达属性的显著性:速度最显著,响度次之,articulation 不显著。
- baseline performance:基线演奏,即未施加表达性修改的参照版本。本段将其与施加修改后产生的表达性演奏进行对比。
- expert model:人类专家演奏的参照样本,以 M = 64.6 的总体动态水平作为衡量各实验条件演奏接近度的基准。
- articulation:演奏中音符之间的衔接方式(连/断)。本段明确指出该属性在 Melody 2 的表达性演奏中不重要,与 Melody 1 的发现一致。
CH3_S8 [描述性拆分] Melody 2: Overall Improvements and Mode Comparisons
第1段(P0037)
原文复述
As a whole, subjects improved in all three performance properties, as seen by the increased correlation coefficients for expressive performances and the normalized RMSE values. A significant overall change was made in terms of loudness, but it was the tempo profiles of the sample that best correlated to the expert model. No significant differences among the three instructional modes were found among the RMSE values or correlation coefficients.
中文讲解
本段是 Melody 2 实验结果的总结性段落,对小节标题所承诺的"整体改进与教学模式比较"给出最终回答,包含三个层次的信息:
-
总体效果:三方面均有改进。 作者先用一个总括句(“As a whole”)将受试者在三个表现维度上的变化收束为一个积极结论,并用两类指标作为证据——其一是"expressive performances”(表达性演奏)的相关系数(correlation coefficients)有所提高,其二是归一化均方根误差(normalized RMSE, Normalized Root Mean Square Error)的数值变化。注意"归一化"意味着 RMSE 已被统一到可比较的量纲上,因此数值变化可直接用于跨被试、跨曲目的比较。
-
分维度细化:响度显著,速度曲线最贴合专家模型。 在"整体有改进"之后,作者用"but"作出区分:响度(loudness)维度出现了显著的总体变化(significant overall change),但真正与专家模型(expert model)相关性最高的并不是响度,而是样本的速度曲线(tempo profiles)。换言之,三个维度虽然都有改善,但改善幅度和性质并不相同——响度改变具有统计显著性,而速度曲线是与专家最为一致的那一项。“best correlated"意味着在相关性指标上它得分最高,而非绝对意义上的"完全一致”。
-
教学模式对比:三种教学方式之间没有显著差异。 最后一句以"No significant differences"明确否定了三种教学模式之间的差异:无论用 RMSE 还是相关系数衡量,组间都没有统计学意义上的差别。这是本节最关键的负面结论——它直接回应了小节标题中的"Mode Comparisons",说明在 Melody 2 这首曲目的整体表现上,实验所设的三种教学指导模式彼此不可区分。
综合来看,本段传达的论证结构是"先肯定整体效果,再揭示维度间的非均衡表现,最后以组间无差异收束",从而为后续可能的多重比较或效应量分析留下空间,同时也提示读者:即便整体教学有效,三种教学方式之间的优劣仍需更精细的指标才能分辨。
脚注 / 边栏 / 图表 / 附加信息(如有)
无附加材料。本段为正文段落,不含脚注、图表说明或边栏内容;小节内的图表与统计细节应在其他段落中处理。
💡 本节核心要点
- 受试者在 Melody 2 的三个表现维度上均出现了整体改进,证据来自表达性演奏相关系数的提高以及归一化 RMSE 数值的变化。
- 在三个维度中,响度产生了显著的总体变化,而速度曲线是与专家模型相关性最高的一项,二者改善的性质不同。
- 三种教学指导模式之间在 RMSE 和相关系数两类指标上均未发现显著差异。
- 本段同时承担"总结成效"与"否定模式差异"两个功能,是 Melody 2 小节的收束性陈述。
- 归一化 RMSE 的使用意味着误差已被统一量纲,跨被试与跨曲目的比较具备前提条件。
🔑 关键术语
- normalized RMSE:归一化均方根误差,把误差按相同尺度标准化后的指标;在本段中用来量化受试演奏与参考模型之间的偏离,数值越低代表越接近参考。
- correlation coefficients:相关系数,衡量两条曲线(如受试的表达性演奏曲线与专家模型曲线)走势一致程度的统计量;本段中其值升高被用作"表达性演奏改进"的证据。
- expert model:专家模型,由专业演奏者表现构成的参照基准;本段以"与之相关性最高"来衡量受试者最接近专家的维度。
- tempo profiles:速度曲线,描述演奏过程中节拍快慢随时间变化的轨迹;本段指出它在三个维度中与专家模型最为吻合。
- loudness:响度,演奏中声音强弱的变化维度;本段指出它在总体上发生了显著变化,但并非与专家最一致的那一项。
- instructional modes:教学指导模式,本实验所设置的三种不同的教学条件;本段明确报告三者在 RMSE 与相关系数上均无显著差异。
CH3_S9 [描述性拆分] Melody 2: Advanced Versus Competent Pianists
第1段(P0038)
原文复述
Supplementary analysis showed that the advanced pianists’ baseline tempo profiles (average r = .643) were significantly more similar to the model than those of the competent pianists (average r = .495), F(1, 35) = 5.76, p < .05. After instruction, however, the disparity lessened (advanced r = .671; competent r = .600, n.s.). With Melody 2’s property of secondary importance, loudness, the advanced group’s baseline performances were more expert-like (advanced r = .381; competent r = .280), but the gap widened with the expressive performances (advanced r = .661; competent r = .521).
中文讲解
本段报告了补充分析对两类结果的支持:其一是比较两组钢琴家在节奏速度方面与“模型”的接近程度,其二是比较他们在 Melody 2 的次要属性——响度——上的表现。
在未经教学处理的基础条件下,熟练组(advanced pianists)的速度侧面平均 r = .643,高于胜任组(competent pianists)的 .495。文中以 r 值表示与模型的相似程度,因此基础速度侧面的组间差异为 .148。F(1, 35) = 5.76、p < .05 表明,这个组间差异具有统计显著性,不能仅视为随机波动。
教学指令后,两组的 r 值分别为 .671 和 .600,差距缩小到 .071;原文标注“n.s.”,即这一差异未达到统计显著。因而,教学后不能说熟练组与胜任组仍然存在显著差异;只能说差距变小,而且现有结果没有证明该缩小后的差异显著。
响度被明确称为 Melody 2 的次要属性。基础表现中,熟练组的 r = .381,高于胜任组的 .280,说明熟练组的基础响度表现更接近专家模型;在表现性演奏中,两组分别为 .661 和 .521,差距反而扩大到 .140。这里的“差距扩大”不能理解为熟练组的 r 值下降:两组数值都提高了,但熟练组提高得更多。因此,响度在基础条件下已有一定组间区分,而表现性条件进一步放大了熟练组相对更接近模型的优势。由于本段没有为响度结果提供显著性检验,不能把这两个 r 值差异表述为统计显著差异。
补充说明
n.s.表示结果不显著;这里具体指教学后两组速度侧面 r 值的差异未达到显著水平。响度部分只报告了基础表现和表现性演奏的 r 值及其组间变化,段落未提供响度结果的统计检验。
💡 本节核心要点
- 补充分析首先比较了两组钢琴家的基础速度侧面与模型的相似程度:熟练组平均 r = .643,胜任组平均 r = .495,且组间差异达到 p < .05 的显著水平。
- 教学指令后,两组速度侧面的 r 值分别升至 .671 和 .600,差距由 .148 缩小为 .071,但该差异标注为 n.s.,即不再显著。
- 响度是 Melody 2 的次要属性;基础表现中,熟练组的 r = .381 高于胜任组的 .280。
- 在表现性演奏中,响度对应的 r 值升至熟练组 .661、胜任组 .521;虽然两组都提高,但熟练组提高更多,组间差距从基础表现中的 .101 扩大到 .140。
- 速度侧面的显著检验与响度侧面的描述性 r 值应区分理解:前者报告了 F 和 p 值,后者没有报告显著性检验。
🔑 关键术语
- baseline tempo profiles:钢琴家在基础演奏条件下的速度变化侧面。熟练组的平均 r = .643,胜任组为 .495,且这一组间差异显著。
- model:用于比较钢琴家表现、据相似程度来判断其是否具有专家式特征的参照对象。
- advanced pianists:文中与 competent pianists 相对照的熟练钢琴家组;其基础速度侧面和基础响度表现均更接近模型。
- competent pianists:文中与 advanced pianists 相对照的胜任钢琴家组;教学后其速度侧面与模型的相似程度提高至 r = .600。
- expressive performances:表现性演奏条件。在该条件下,两组的响度 r 值均高于基础表现,且熟练组与胜任组之间的差距扩大。
- n.s.:表示结果不显著。本段中指教学后熟练组与胜任组速度侧面 r 值的差异未达到统计显著。
CH3_S10 [描述性拆分] Melody 3: Mean Levels and Salient Properties
第1段(P0039)
原文复述
Melody 3
中文讲解
本段仅为小节标题“Melody 3”,在文中起到结构性标记的作用,标志作者从 Melody 1 和 Melody 2 的讨论转入第三首旋律的描述性拆分。该标题下专门聚焦 Melody 3 在不同演奏指令下的均值水平与最显著属性,因此它既是论题切换点,也限定了接下来 Table 3 数据的归属对象。
第2段(P0040)
原文复述
Table 3 shows that the instruction for Melody 3 resulted in expressive performances that were generally louder, faster, and more staccato than baseline performances. The overall changes were significant for loudness, tempo, and articulation. Unlike with the previous two melodies, the most salient property of Melody 3 was articulation. The AM condition’s shortening of note duration, from 76.8% to 66.6%, represented the greatest change in average articulation. With average tempo level, the AM mode produced the most accelerated overall tempo (+25.3), the MI condition generated a lesser increase (+5.1), and the CM instruction yielded the poorest result with a tempo decrease (-6.5).
中文讲解
本段围绕 Table 3 中 Melody 3 的均值数据展开,中心主张是:相较于基线演奏,针对 Melody 3 的演奏指令使整体演绎在响度(louder)、速度(faster)和断奏(more staccato)三个方向上都被强化,且这三项维度的整体变化均达到统计显著。这一句话同时回答了两个问题——变化方向(变响、变快、变得更断奏)和变化强度(全部显著)。承接前两首旋律的论述,本段在此引入了一个关键的对比性论断:不同于前两首旋律,Melody 3 最显著的属性是 articulation(断奏/音符时值),而不是响度或速度。作者通过举例给出量化证据:AM 条件把音符时长从 76.8% 缩短到 66.6%,这一缩短幅度被作者明确称为“平均 articulation 的最大变化」,借此把抽象的显著性(significance)落到具体的百分比差值上,让读者可以直观看到 articulation 这一维度被强化了多少。最后一句转向 tempo 维度的条件对比:在平均速度水平上,AM 模式产生最明显的加速(+25.3),MI 条件只带来较弱的加速(+5.1),而 CM 指令反而导致速度下降(-6.5),是三者中最差的反应。这一排序说明:不同指令在速度维度上的效果并不等价,AM 对速度的推动作用远超 MI,而 CM 对 Melody 3 没有起到加速作用。作者使用这组数字的意义在于同时呈现“显著特征”(articulation)和“条件分化”(tempo 维度上 AM/MI/CM 的梯度),从而支撑“Melody 3 的最显著属性是 articulation”这一小节核心论点。
补充说明
无额外补充。AM、MI、CM 三个条件的具体含义在当前段落中并未展开,不在本节范围内解释,以免引入输入以外的信息。
脚注 / 边栏 / 图表 / 附加信息(如有)
无。本节未提供独立脚注、图表说明文字或边栏材料;正文段落中提到的 Table 3 属于外部表格对象,本小节仅对其数据做文字引用。
💡 本节核心要点
- Melody 3 的演奏指令使整体演绎在响度、速度、articulation 三个方向上均显著偏离基线,且方向一致地更夸张。
- 与 Melody 1、Melody 2 不同,Melody 3 最显著的属性是 articulation,而非响度或速度。
- AM 条件将音符时长从 76.8% 缩短到 66.6%,被作者标记为平均 articulation 的最大变化,是支撑“最显著属性”这一论点的量化证据。
- 在 tempo 维度上三种条件呈梯度差异:AM (+25.3) 加速最显著,MI (+5.1) 加速较弱,CM (-6.5) 反而减速、效果最差。
- 本节核心论点是“articulation 是 Melody 3 的标志性变化维度”,同时附带指出 CM 指令在速度上效果不佳。
🔑 关键术语
- Melody 3:本节分析对象,即论文中第三首旋律;本小节围绕其在不同演奏指令下的均值水平和最显著属性展开。
- baseline performances:基线演奏,指未施加 expressive 指令时的演奏,本节所有比较都以它为参照点。
- salient property:“最显著属性”,指在多个维度中变化幅度或统计显著性最突出的那一项;本节中该词专门指向 articulation。
- articulation:演奏中的断奏/连音控制,在本节通过音符时长百分比(76.8%→66.6%)来量化;是 Melody 3 的标志性变化维度。
- staccato:断奏演奏风格,本节中以“more staccato than baseline”出现,指 Melody 3 的演奏相对于基线更倾向于断奏。
- AM condition / AM mode:本节中表现最强的演奏条件:在 articulation 维度上将音符时长从 76.8% 缩短到 66.6%,并在 tempo 上带来 +25.3 的加速。
- MI condition:本节中表现中等的演奏条件;在 tempo 维度上仅带来 +5.1 的较小加速。
- CM instruction:本节中表现最弱的演奏条件;在 tempo 维度上不仅没有加速,反而使速度下降 6.5,被作者称为“poorest result”。
CH3_S11 [描述性拆分] Melody 3: Articulation and Loudness Performance
第1段(P0041)
原文复述
Based on the average correlation coefficients in the third and fourth columns, it is clear that loudness was the second-most salient property of Melody 3. The low (and negative) tempo coefficients indicate that it was not an important property for Melody 3. The normalized RMSE values for articulation show that, although baseline performances were already highly expert-like, the property of articulation underwent the most change, leading up to even better correlated expressive performances. The MI condition was the poorest at effecting expert-like articulation change.
中文讲解
本段是Melody 3(旋律3)定量分析结果的总结。作者依据前面表格第三、第四列的平均相关系数,依次对三个音乐属性作出评价:响度(loudness)是该旋律第二显著的特征;速度(tempo)的系数偏低甚至为负,说明它在本旋律中并不重要;发音(articulation)的归一化均方根误差(normalized RMSE)显示,虽然基线演奏已经相当接近专家水平,但发音属性在从基线到表现性演奏的过程中变化幅度最大,因此最终呈现出与专家模型相关性更高的表现性演奏。在三种实验条件中,MI(动作想象,Motor Imagery)条件在驱动演奏向专家式发音靠拢方面效果最差。这一段的功能是为Melody 3确立一个层级化的属性排序:发音是最核心且最可塑的属性,响度次之,而速度几乎不构成区分点;同时为后续段落聚焦响度提供铺垫。
补充说明
本段中的"third and fourth columns"、“baseline”、“expressive conditions”、“MI condition"等表达都指向同章前几节已经呈现的实验数据表和四种实验条件(基线+三种指令条件)。读者应结合前文表格理解本段的判断。
第2段(P0042)
原文复述
Within the property of loudness, another poor showing for the CM condition is found in the sizeable deterioration in similarity to the expert model from baseline to expressive conditions. An explanation emerged through an examination of the verbal report transcripts, namely that the CM instruction included too much print information to accommodate in a brief practice session. Subject comments included: “Visually it looks a little extreme,” “It was kind of too much,” and “Uh, wow, it’s like this is Milton Babbitt or something.”
中文讲解
本段把焦点从Melody 3的整体属性排序收窄到响度属性,并揭示CM(Combined/Combined Modeling,具体含义需结合前文)条件表现不佳的原因。与上一段提到的MI条件形成呼应——在发音上MI最差,在响度上则是CM最差:被试在CM条件下从基线进入表现性演奏时,与专家模型的相似度反而出现明显下降。作者通过对口头报告(verbal report transcripts)的考察给出解释:CM指令包含的书面信息过多,无法在短暂的练习时间内消化吸收。三条被试原话依次从视觉观感(“看起来有点极端”)、整体感受(“有点太多了”)到风格判断(“像是米尔顿·巴比特的东西”)逐层递进地佐证了"信息过载"这一论点。其中巴比特(Milton Babbitt)是20世纪美国先锋序列音乐作曲家,以高度复杂、密集的谱面记谱闻名,被试借此比喻强调CM谱面在视觉上的繁复和陌生感。本段论证意义在于:将定量数据上的失败归因于具体的实验设计因素(信息量与练习时间的错配),而非被试能力本身,从而为后续讨论指令呈现方式的优化提供了依据。
补充说明
Milton Babbitt(1916–2011)的引文应理解为被试对CM谱面复杂度的形象化比喻,并非作者本人在评论巴比特作品;该引文与"too much print information"形成互证。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节的两段文字共同构成Melody 3分析的小结:P0041基于表格中的相关系数和归一化RMSE数据作出属性排序判断;P0042则引入口头报告这一质性数据,对CM条件在响度上的失败给出被试视角的解释。文中包含三处被试直接引语(“Visually it looks a little extreme”、“It was kind of too much”、“Uh, wow, it’s like this is Milton Babbitt or something."),它们不是装饰,而是论证CM条件失败原因的实证依据。
💡 本节核心要点
- Melody 3中,发音(articulation)是变化幅度最大、与专家模型相关性最高的属性,因此被视为最显著的属性。
- 响度(loudness)是Melody 3的第二显著属性,而速度(tempo)的相关系数偏低甚至为负,说明它在本旋律中不构成重要区分维度。
- 在三种指令条件中,MI条件在推动发音向专家水平靠拢方面效果最差,而CM条件在响度上导致被试演奏与专家模型的相似度从基线到表现性演奏反而下降。
- CM条件表现不佳的原因通过口头报告得到解释:CM指令包含过多书面信息,无法在短暂练习时间内被被试充分消化。
- 被试的引语从视觉感受、整体判断到风格类比三个层面佐证了"信息过载"这一论点。
🔑 关键术语
- loudness:响度,指演奏中音的强弱变化;在本节中是Melody 3的第二显著属性,也是CM条件表现最差的属性。
- articulation:发音方式,指音符之间连接、断开的处理(如连奏、断奏);在Melody 3中是变化幅度最大、最显著的属性。
- tempo:速度,指演奏的快慢;在Melody 3中相关系数偏低甚至为负,被判定为不重要属性。
- normalized RMSE:归一化均方根误差,用于衡量被试演奏曲线与专家演奏曲线之间的偏离程度;本节用其判断各属性从基线到表现性演奏的变化幅度。
- MI condition:动作想象(Motor Imagery)条件,本节中指在驱动发音向专家水平靠拢方面效果最差的实验条件。
- CM condition:本节中指在响度属性上反而导致与专家模型相似度下降的实验条件;失败原因被归因于书面信息过多与练习时间不足之间的错配。
- expert model:专家演奏模型,用作衡量被试演奏表现性的参照基准;本节中"与专家模型的相似度"是评价各条件效果的核心指标。
CH3_S12 [描述性拆分] Melody 3: Advanced Versus Competent Pianists
第1段(P0043)
原文复述
The comparison of advanced and competent pianists’ performances continued the trend shown with the first two melodies. For the most salient property, articulation, the advanced group’s baseline performances (average r = .868) were significantly more similar than the competent group’s (average r = .825), but the instruction provided narrowed the gap in the expressive performances (advanced r = .932; competent r = .905). However, with the property of secondary importance, loudness, the advanced group’s baseline performances were more expert-like (advanced r = .700; competent r = .661), and the gap widened with expressive performances (advanced r = .687; competent r = .605).
中文讲解
本段是 Melodie 3(第三首旋律)分析的总起段,把高级组与熟练组之间的对比与前两首旋律的结果衔接起来,并按"重要性等级"分层呈现两类性质上的差异。具体而言:作者在第一首与第二首旋律中已经观察到一种一致趋势,本段明确宣布该趋势在第三首旋律上"延续”,因此本段的功能不是引入新发现,而是第三次的重复验证。在最突出的性质 articulation(奏法/发音清晰度)方面,高级组在未接受表达性指令的 baseline(基线)演奏中与专家模型的相似度(r = .868)显著高于熟练组(r = .825),但一旦加入表达性演奏条件,两组的相似度都上升,且差距被压缩(高级 r = .932;熟练 r = .905)——这意味着对最显著性质而言,指令起到了"拉平"作用。其次重要的性质 loudness(力度/响度)则呈现相反模式:baseline 上高级组就已经更像专家(r = .700 vs .661),而加入表达性演奏后,两组的相似度都下降,且差距反而拉大(高级 r = .687;熟练 r = .605)。这种"最显著性质指令缩小差距、次重要性质指令拉大差距"的对立结果,是本段想要读者注意的核心论证:表达性指令的效果取决于该性质在演奏表达中的显著程度,不能一概而论。值得注意的是,r 值仍是与专家模型表演的相关系数,越接近 1 代表演奏越接近"专家式"的表达处理。
补充说明
本段中的 r 值延续了前两首旋律的统计口径,即各演奏与专家参照表演之间的相关系数;baseline 与 expressive 两种条件分别对应"无表达性指令"与"获得表达性演奏指示"两种情境。段落开头的"continued the trend"明确将本段定位为重复验证,而非新发现的提出,因此第二、第三小节中关于 articulation 缩小差距、loudness 拉大差距的具体数据,应与前两首旋律的对应数据对照阅读。
💡 本节核心要点
- Melodie 3 的高级组—熟练组对比延续了前两首旋律中已观察到的一致趋势,本段属于第三次重复验证而非新现象的提出。
- 在最突出的性质 articulation 上,baseline 条件下高级组相似度(r = .868)显著高于熟练组(r = .825),但表达性指令同时提升两组表现,使差距在 expressive 条件下被压缩(.932 vs .905)。
- 在次重要性质 loudness 上,baseline 条件下高级组已较接近专家(r = .700 vs .661),且表达性演奏反而使两组相似度下降并扩大两组差距(.687 vs .605)。
- 两性质呈现相反模式:表达性指令对最显著性质起"拉平"作用,对次要性质反而起"分化"作用,说明指令效应受性质层级调节。
- r 值始终是各演奏与专家参照表演之间的相关系数,统一了前三首旋律之间以及 baseline/expressive 条件之间的可比性。
🔑 关键术语
- baseline performance:指被试在未接受任何专门表达性演奏指示时按乐谱进行的演奏,用作与 expressive performance 对照的基线条件。
- expressive performance:指被试在获得研究者给出的明确表达性演奏指令后进行的演奏;本节用来检验指令是否会改变演奏与专家模型的相似度。
- most salient property vs. property of secondary importance:作者把奏法/发音清晰度(articulation)归为最重要、最突出的表现属性,把力度/响度(loudness)归为次重要属性;这一层级划分是解释为什么指令对两类性质产生相反效应的关键。
- r (correlation coefficient):各被试演奏与专家参照表演之间的相关系数;越接近 1 表示该演奏在所考察维度上越接近专家式的处理,本节所有数值都按此口径解释。
- advanced / competent pianists:高级组与熟练组两类被试;本节用高级组作"更接近专家"的参照,逐项比较两组在 baseline 与 expressive 两种条件下与专家演奏的相似度差异。
CH3_S13 Additional Analysis of Verbal Reports
第1段(P0044)
原文复述
Additional Analysis of Verbal Reports
中文讲解
本条目是小节标题“Additional Analysis of Verbal Reports”的占位符。该标题宣告本节将转入对被试言语报告(verbal reports)数据的进一步分析,并暗示这是相对于上一节(更偏定量分析)的一类补充性、较定性化的探讨。
第2段(P0045)
原文复述
A final series of analyses considered the verbal report transcripts more systematically. As described below, a somewhat qualitative approach was used to examine the verbal reports, and the following results should be considered more exploratory in nature than those in the previous section. For each subject’s experience in the MI condition, his or her verbalizations were categorized according to the extent to which his or her thought processes reflected the development of plans for the properties of loudness, tempo, and dynamics. For each of these properties, subjects were coded 1 if they explicitly mentioned concrete musical terms, or 0 if they did not. Then, based only on the data for the most salient expressive properties for each melody—loudness for Melody 1, tempo for Melody 2, and articulation for Melody 3—subjects’ codes were compared to their corresponding normalized RMSE values. This analysis showed that subjects who cognitively translated the imagery into explicit plans for concrete musical properties tended to make greater change in their performance, $F(1, 34) = 5.56$, $p < .05$.
中文讲解
本段宣告并展开了对小节标题所预告的“言语报告进一步分析”。作者明确交代了三件事来定位这段分析的方法学身份:(1)采取较为定性(somewhat qualitative)的方式;(2)因此其结果应被视为探索性的(more exploratory in nature),相对于前文的定量结果要谨慎解读;(3)分析对象限定于 MI 条件(这里指 mental imagery / 心理意象条件下)下被试在演奏过程中的口语化叙述。
分析的具体做法是:先把每位被试在 MI 条件下的言语陈述按其“思维过程是否反映出针对特定音乐属性的计划”来分类。最初列出的三个属性是 loudness(响度)、tempo(速度)和 dynamics(力度/强弱),对每个属性,若被试明确提到了具体的音乐术语则编码为 1,没有则编码为 0。
接着,作者并没有使用全部三个属性的编码,而是仅采用每条旋律“最显著的表达属性”(most salient expressive properties)所对应的编码——Melody 1 取 loudness、Melody 2 取 tempo、Melody 3 取 articulation(这里原文出现了与前文“dynamics”不一致的“articulation”,应忠实保留原文,但需理解 Melody 3 的核心表达属性在作者看来是 articulation(咬字/起断)而非笼统的 dynamics)。把这些二值编码与被试对应旋律的归一化 RMSE 值进行关联分析。
核心结论是统计显著的:那些在认知上把意象“翻译”为具体音乐属性计划(即在被试言语中明确说出相应术语)的被试,其演奏的实际变化幅度更大,$F(1, 34) = 5.56, p < .05$。
这一结论支持了一个理论主张——仅仅“拥有意象”不足以驱动可观测的演奏改变;只有当被试在意识层面把意象转化为针对具体声学/表演参数的计划,并能用相应的音乐术语表达出来时,意象才会更有效地转化为演奏上的真实变化。换言之,从意象到表演之间存在一个“认知翻译”的中介步骤,作者用言语报告的编码差异把这个中介步骤的强度与 RMSE(演奏变化幅度的客观指标)对接起来,从而为意象—表现关系提供了一个探索性的机制证据。
该段的功能在于:从客观绩效指标(RMSE)扩展到对过程层面(认知计划)的考察,弥补前一节可能只关注结果变量的不足;同时通过“探索性”的自我定位,提醒读者此处不能与前文的定量结论等量齐观,而应作为补充线索。
补充说明
原文在第一句列出的属性为“loudness, tempo, and dynamics”,而在后文指认 Melody 3 的最显著属性时用的是“articulation”,两者措辞并不完全一致。本节处理时按原文如实复述,不擅自统一;这暗示 Melody 3 的关键表达维度被作者更具体地界定为 articulation,而非泛泛的 dynamics。
脚注 / 边栏 / 图表 / 附加信息(如有)
无额外附加材料(本小节无脚注、图表或边栏说明)。
💡 本节核心要点
- 本节采用较为定性(qualitative)的方法处理言语报告转录,作者明确将其结果定位为探索性的,而非与上一节的定量分析等量齐观。
- 编码对象仅限于 MI 条件下的言语陈述,分类维度是被试思维过程是否反映出针对特定音乐属性(响度、速度、articulation 等)的计划。
- 每位被试在每项属性上得到 0/1 的二值编码,随后仅取每条旋律“最显著表达属性”所对应的编码,与归一化 RMSE 值进行比较。
- 核心发现是统计显著的:被试若在认知上把意象明确翻译为具体的音乐属性计划,其演奏的实际变化幅度更大,F(1, 34)=5.56, p<.05。
- 该结果支持一个机制性主张——意象对演奏的转化效果依赖于“认知翻译”这一中介步骤,仅有意象本身不足以驱动可观测的演奏变化。
🔑 关键术语
- verbal report (言语报告):指被试在实验过程中口头发出的、对自己思考或感受的陈述;本节把它作为分析对象,用以推断被试在 MI 条件下的认知过程。
- MI condition:指心理意象(mental imagery)条件,即让被试在演奏时依赖意象而非外部线索;本节仅在该条件下收集言语报告。
- normalized RMSE:归一化均方根误差,用以量化每位被试在某条旋律上演奏结果与其参考之间的偏离程度;本节将其作为“演奏变化幅度”的客观指标与言语编码相对应。
- most salient expressive properties:每条旋律各自最具代表性的表达属性;本节具体指 Melody 1 的 loudness、Melody 2 的 tempo、Melody 3 的 articulation,分析仅基于这三项对应编码进行。
- cognitive translation:作者用此概念描述被试把意象内容“翻译”为针对具体音乐属性的可表达计划的过程;本节的关键结论正是这种翻译越明确,演奏的实际改变越大。
CH4_S1 [描述性拆分] General Comparison of the Three Instructional Approaches
第1段(P0046)
原文复述
DISCUSSION
中文讲解
“DISCUSSION”是本小节的标题,标志着以下内容开始讨论研究结果。它所开启的核心问题是:不同教学法是否以及在何种意义上改变了大学水平音乐学习者的表现性演奏。标题本身不提出结论,但与随后两段从总体判断到三种教学法比较的论述结构相吻合。
第2段(P0047)
原文复述
Not surprising, the results confirm that collegiate level musicians can adapt to various approaches to teaching expressive performance. No one mode of instruction in the study was consistently most successful in effecting change from baseline performance, or in producing more expert-like expression. However, with a more detailed examination of the process considering characteristics of the musical materials, some interesting trends emerged.
中文讲解
本段首先确认,研究中的大学水平音乐家能够适应教授表现性演奏的不同方法。这里的“适应”不能直接等同于每种方法都取得了理想效果,而是说明学习者能够对不同教学处理作出反应。作者接着给出总体限制:没有任何一种教学方式在“促成相对于基线演奏的变化”和“产生更接近专家的表达”这两个判据上始终最成功。因此,这不是说各方法毫无作用或效果完全相同,而是说不能依据任何单一指标把其中一种认定为普遍最佳。段末的“However”改变了论证层次:作者不再停留在总体比较上,而要结合音乐材料本身的特征更细致地考察教学过程,从而揭示总体平均结果之下可能出现的趋势。
补充说明
“baseline performance”在本段中充当比较变化幅度的参照;“expert-like expression”则限定了变化所追求的方向,即更接近专家式表达。原文没有进一步界定具体的基线演奏、专家模型或二者之间的测量方式。
第3段(P0048)
原文复述
The generalizable results of the instructional approaches varied. Aural modeling did not always result in large changes in performance, but it was relatively consistent in producing performances quite similar to the expert model used in the instruction. It would seem that the musicians did not take the model they heard as an example to stimulate their own expressivity, but rather an exemplar to be duplicated exactly. The concrete musical instruction, as primarily seen in it inducing significantly more practicing, can be somewhat inefficient. For the most part, however, it showed good consistency in effecting change from baseline performance and more expert-like change at that. The metaphor/imagery approach often produced considerable change in performance, but not necessarily in the direction of an accepted expert-like interpretation.
中文讲解
本段把上一段提出的“若作一般性概括,各方法结果并不相同”具体落实到三种教学法上。听觉示范的变化幅度并不总是很大,但学习者演奏出的结果较稳定地接近教学所采用的专家模型。作者以“it would seem”谨慎推测:音乐家似乎把听到的模型当作需要精确复制的范本,而不是借它激发个人表现力;这是一种基于结果倾向的解释,而不是被单独证明的事实。具体的音乐教学虽然因显著诱导更多练习而可能效率不高,但多数情况下能较稳定地促成相对于基线演奏的变化,而且这种变化确实更接近专家式表达。因此,学习过程耗时更多,并不意味着演奏结果必然较差。隐喻/意象教学法则常引起显著变化,但变化未必朝向公认的专家式诠释。这一对比说明,变化幅度、变化的一致性、变化方向以及所付出的练习量是不同判据,不能把“改变很大”直接等同于“更接近专家表现”。本段因而完成了上一段预告的细化比较:三种方法各有不同优势与局限。
补充说明
本段可用四个相互关联的维度理解各方法:变化幅度、结果一致性、是否朝专家式表达变化,以及是否诱导显著更多练习。原文没有说明这些维度各自的测量方法,因此不能进一步推断其权重。
💡 本节核心要点
- 研究首先确认大学水平音乐家能够适应多种表现性演奏教学方法。
- 总体上,没有一种教学法在促成基线变化或形成专家式表达方面始终最成功。
- 听觉示范带来的变化未必很大,却较稳定地接近专家模型;作者谨慎推测学习者更倾向于精确复制示范。
- 具体音乐教学可能因诱导更多练习而显得效率不高,但多数情况下能稳定促成更接近专家表达的变化。
- 隐喻/意象教学法能够带来显著变化,但变化方向未必符合公认的专家式诠释。
- 三种教学法应在变化幅度、一致性、变化方向和练习量等不同判据下分别评价。
🔑 关键术语
- baseline performance:基线演奏,是本段比较教学效果时所参照的基础表现;原文没有说明其具体采集或测量方式。
- aural modeling:听觉示范教学,即让音乐家听取并依据教学中的专家模型进行表现性演奏。其突出特点是变化未必很大,但结果较稳定地接近该模型。
- concrete musical instruction:具体的音乐教学。它会显著诱导更多练习,因而可能显得效率不高,但多数情况下较稳定地促成相对于基线演奏且更接近专家表达的变化。
- expert-like expression:专家式表达,是评价变化方向的标准之一,强调演奏或诠释更接近专家模型,而非仅仅发生变化。
- metaphor/imagery approach:隐喻/意象教学法。该方法常产生显著变化,但这些变化未必朝向原作者所说的公认专家式诠释。
CH4_S2 [描述性拆分] Differences Between Advanced and Competent Pianists
第1段(P0049)
原文复述
Before applying these findings to music teaching practice, the author proposes first reviewing the study’s results on the differences between the advanced and competent pianist groups. The advanced pianists’ baseline performances were consistently more similar to the expert model. Previous research indicates that, through their training activities, more advanced musicians assimilate rules of expressivity to the point that they are virtually unable to suppress them in their performing, suggesting that they have something of a head start over less-skilled pianists in realizing a final expressive performance. Another consistent trend in the present study is that, with the single most salient expressive property for each melody, the instruction offered enabled the competent pianists to close the gap with the advanced group from baseline to expressive performance. However, with the secondary expressive property, the gap widened. The author interprets this finding as indicating that there is a limit to the breadth of change musicians can make in a brief session such as the present study’s procedure, attributing the limit to attentional capacity (Repp, 2000).
中文讲解
这一段在把研究结果推向教学应用之前,先插入一个比较性的小结,对照高级钢琴家和胜任级钢琴家两组之间的差异。段中提出两个一致的趋势:
第一,在尚未接受任何表现指导的基准演奏中,高级钢琴家的演奏与专家模型之间的相似度一贯高于胜任级钢琴家。作者援引既有文献解释这一现象:通过长期训练,高水平演奏者已经把"表现力规则”(rules of expressivity)内化到几乎无法抑制的程度,因此即使不主动要求,他们的演奏也会自动带上表达性的塑造。作者由此推论:他们相对低水平者具有一种先天优势。
第二,接受本研究给出的指导后,胜任级钢琴家能够在每首旋律"单一最显著的表现属性"上缩小与高级组的差距——也就是说,注意力被集中引导到一个明确的表达目标时,指导是有效的。然而,在"次级表现属性"上,差距反而扩大了。作者引用 Repp (2000) 解释这一现象:注意容量(attentional capacity)是有限的,演奏者在一次短暂的练习中能够做出的改变有上限——一旦胜任级演奏者把注意力全部投放到最显著的那个目标,留给次级目标的认知资源就不够了。
这一段的功能是:先把"高级组占优源于自动化规则"和"胜任组只能在主目标上追赶、在次目标上反而落后"两个事实摆出来,并给出注意容量的因果说明。这样做的目的是为后文讨论教学含义设定边界:教学干预既要面对长期自动化这一深层因素,也要面对短时注意瓶颈这一现实限制。
第2段(P0050)
原文复述
Whereas advanced pianists can rely on automatized (unconscious) rules of expressivity that manifest themselves in secondary properties, less-skilled performers cannot; consequently, the performance of less-skilled performers suffers outside their primary focus of attention — that is, outside the most salient property.
中文讲解
这一句是上一段趋势结论的因果机制说明,篇幅虽短但承担关键的解释功能。
核心对照是"自动化(无意识)规则"的有无:高级钢琴家之所以在次级表现属性上仍然能表现出与专家模型相似的表达塑造,是因为他们已经把这些规则自动化了,可以在意识不参与的情况下自行运行;而胜任级钢琴家尚未达到这种自动化程度,他们的表达塑造只能依赖意识控制,因此一旦偏离主目标——即注意力不再放在"最显著的表现属性"上——演奏就会变得不具表现力,或者显著退步。
这一句与上一段联起来读才能看清本节论证的真正用意:所谓"次级属性差距扩大",并不是胜任级演奏者在退步,而是高级组凭借自动化优势进一步拉开了距离。换言之,这是一个"守方被超越"的过程,而非"攻方失败"的过程。
教学含义在这里已经隐含:短时指导可以补足胜任者最显著的那一项表达塑造,但无法在一次课程里同时补足全部次级目标;要真正缩小整体差距,必须依赖长期训练把次级规则也变成自动化习惯。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节没有脚注、图表或边栏。P0049 中引用了 Repp (2000) 作为支持"注意容量限制"这一解释的来源,属于为正文主张提供理论依据的文献引用;除此之外无其他附加材料。
💡 本节核心要点
- 基准演奏阶段(未受指导时),高级钢琴家由于已经把表现力规则内化为自动化习惯,其演奏与专家模型更接近,对胜任组而言意味着一种由训练沉淀下来的"先天优势"。
- 接受指导后,胜任组能够在每首旋律的"单一最显著表现属性"上缩小与高级组的差距,说明聚焦的指导对胜任者确实有效。
- 但在"次级表现属性"上,差距不仅没有缩小,反而扩大——胜任组在一次短时课程里无法同时兼顾多个表达目标。
- Repp (2000) 提出的"注意容量限制"被作者用作解释:演奏者在一个时段内能主动调整的表达维度是有上限的。
- 其机制在于表现力规则的自动化程度不同:高级组的次级表达由无意识规则自动产生,胜任组则必须依赖意识控制,而意识资源不足以同时覆盖多个属性。
- 由此本节为后续讨论教学应用设定边界:教学干预既无法绕过长期训练所形成的自动化差异,也无法在一节课内一次性拓展表达塑造的宽度。
🔑 关键术语
- baseline performance:基准演奏,指在没有接受任何表现指导的情况下被试的演奏;在本节中用作与"指导后演奏"对照的起点。
- expert model:专家模型,指由高水平专家演奏的参照性表现样本;本研究中高级组与胜任组的演奏都以它作为衡量表现力接近程度的标准。
- rules of expressivity:表现力规则,指演奏者习得的、关于如何塑造节拍、力度、articulation 等表现性维度的规则;本节强调这些规则可以通过训练被内化甚至自动化。
- most salient expressive property / primary focus of attention:最显著的表现属性/首要注意焦点,指每首旋律中最为突出、最容易成为演奏者注意中心的那一项表现塑造维度;本节中指导主要集中于此。
- secondary expressive property:次级表现属性,指除最显著属性之外的、相对次要的表现塑造维度;本节指出胜任组在一次短时课程中难以兼顾这些维度。
- automatized (unconscious) rules:自动化(无意识)规则,指长期训练后无需意识参与即可自动运行的表现力规则;本节用其解释高级组为何能在次级属性上仍维持专家级的表达塑造。
- attentional capacity:注意容量,指演奏者在一次演奏或一次课程中可用于意识性控制表达塑造的有限认知资源;本节援引 Repp (2000) 用其解释为何短时课程中次级属性差距反而扩大。
- advanced vs. competent pianists:高级钢琴家与胜任钢琴家;本研究中以"高级"(训练更久、水平更高)和"胜任"(具备基本胜任能力但训练较少)区分两组被试进行比较。
CH4_S3 [描述性拆分] Implications for Teaching Expressive Performance
第1段(P0051)
原文复述
These findings suggest that music educators should carefully consider a number of factors when teaching expressive performance. Especially relevant are the teacher’s expressive goals, qualities of the music being performed, and characteristics of the students themselves. For example, if a teacher has a specific sound in mind that he or she wants a student to produce, an aural model would be appropriate. If, however, the goal is more generally to “add life” to an otherwise deadpan performance, a metaphor/imagery approach might be effective in eliciting a different response from the student. From this point, the teacher could then more specifically address the appropriateness of the expressive gestures contained therein. Although verbal metaphors and images seem best suited to convey broad expressive information, a concrete musical approach—perhaps used in conjunction with an aural model—can communicate much greater detail. However, especially with less-advanced students, this may require additional practice or rehearsal time, as their attention levels may be taxed.
中文讲解
本段是全章研究结果向教学实践的过渡推论。作者开门见山指出,音乐教师在教授“表现性演奏”(expressive performance)时,需要综合权衡三类因素:(1) 教师自身的表达目标(teacher’s expressive goals),即教师希望学生最终达到什么样的声音或情感效果;(2) 所演奏音乐本身的品质(qualities of the music being performed),即作品风格、难度、时代背景等客观属性;(3) 学生自身的特征(characteristics of the students),包括年龄、技术水平、抽象思维能力和音乐经验等。
接下来作者用两个“如果……那么……”的条件句,演示了教学法的选择逻辑:当教师脑中有一个明确、具体的音响目标时,使用“听觉示范”(aural model),即直接播放或演奏给学生听,让其模仿,是最直接、最有效的途径;而当目标较为笼统,比如只是想让原本平淡(deadpan)的演奏“活起来”(“add life”)时,则更适合用“隐喻/意象”(metaphor/imagery)来触发学生不同的反应。这两个例子并不是任意的,它们分别代表了教学光谱的两个端点:一是精确实在的听觉范本,二是开放联想的语义刺激。作者指出,隐喻/意象并不是终点,而是起点——教师可以借由学生被激发出的反应,进一步追问其中具体表现姿态(expressive gestures)的适切度,从而把模糊的启发转化为具体的演奏指导。
最后一句给出了方法间的权衡:语言性的隐喻和意象擅长传达“宽泛的表达信息”(broad expressive information),但若要传达更精细的细节,则需要“具体的音乐手段”(concrete musical approach)——例如示范演奏、节奏与力度标注、句法结构分析等,且最好与听觉示范配合使用。然而,这种细节层面的沟通会加重学生的认知负担,因此对于程度较低(less-advanced)的学生,可能需要额外的练习或排练时间,因为他们的注意力水平(attention levels)容易饱和(taxed)。
从论证结构看,本段在全文中的作用是把前文综述的实验发现转化为可操作的教学处方:它没有发明新理论,而是搭建了一座从“研究结论”到“课堂决策”的桥梁,核心论点是“教学方法的选择取决于目标、音乐和学生三者的交互匹配”,并提醒教师在追求细节沟通时要兼顾学生的认知容量。容易误解之处在于:作者并非在隐喻/意象和具体音乐手段之间二选一,而是主张二者互补——先用隐喻打开感知,再用具体手段校正执行;同时“taxed”一词并非指学生智力不足,而是指注意力作为有限资源被高强度加工任务消耗殆尽。
补充说明
本段中“expressive gestures”与前文讨论的音乐表现手段(力度、节奏、速度变化等)同义;“aural model”与“concrete musical approach”在作者的方法分类中互有重叠,文中用“perhaps used in conjunction with an aural model”明确允许组合使用,这呼应了前文综述中关于示范法与隐喻法可协同的结论。无额外补充。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为第13页单段小节,无脚注、图表或边栏等附加材料。段落开头的“these findings”起到承上启下的过渡作用,把前文综述的实证结果引向本节的教学推论。
💡 本节核心要点
- 教学表现性演奏需同时权衡教师的表达目标、音乐本身的品质以及学生个体特征三类因素。
- 当教师目标具体明确时,听觉示范最为直接;当目标较为笼统、旨在让演奏“活起来”时,隐喻/意象法更能激发学生反应。
- 隐喻/意象是教学起点而非终点,教师可借此进一步引导学生审视具体表现姿态的适切性。
- 语言性隐喻适合传达宽泛的表达信息,具体音乐手段(最好配合听觉示范)才能传达更精细的细节。
- 具体手段对认知资源要求更高,对程度较低的学生可能造成注意力饱和,因此需要额外的练习或排练时间。
🔑 关键术语
- expressive performance:表现性演奏,指演奏者在准确呈现乐谱基础上,通过力度、速度、音色、句法等手段传达音乐情感与结构的演奏方式,是本节教学讨论的核心对象。
- aural model:听觉示范,指教师通过亲自演奏或播放录音为学生提供可直接模仿的声音范例,在本节中适用于教师目标具体明确的场景。
- metaphor/imagery approach:隐喻/意象法,指教师用语言性的比喻、意象或故事激发学生对音乐的联想与情感反应,在本节中适用于目标较为笼统、欲改变学生情感投入度的场景。
- deadpan performance:平淡无表现力的演奏,本节用作隐喻/意象法的典型干预对象,即用语言手段唤醒其情感表达。
- expressive gestures:表现姿态,指演奏中具体可辨识的音乐表现手段(如渐强、渐慢、揉音等),本节中作为教师在隐喻启发之后需要进一步具体指导的内容。
- attention levels may be taxed:注意力被高强度加工任务消耗,提示教师:精细的音乐手段沟通对认知资源要求较高,低程度学生因此需要额外练习时间。
CH4_S4 [描述性拆分] Limitations and Generalizability to Younger Students
第1段(P0052)
原文复述
Generalizing the findings of this study to younger or less-advanced music students should in fact be undertaken with caution. The musicians who participated as subjects in this study differ in many ways from the learners typically found in school music programs. It is possible that the acquisition of expressive performance skills is best achieved through other means—means not reflected in this report—and that those means depend on the learners’ developmental level. Additional research conducted with younger musicians would supply the insight needed on this point.
中文讲解
这段是作者对本研究外部效度边界的明确限定。作者把结论的适用人群限制在受试群体上,并对向更年轻或更初学的学习者推广结论提出谨慎建议。
逐句来看:(1) 首句以"in fact"收束前面可能在暗示的乐观推论,提醒读者对"向更低龄、更低水平学习者外推"这一做法保持警惕;(2) 第二句给出理由——本研究的受试音乐家与学校音乐课程中的学习者在许多方面存在差异,年龄、训练经历和演奏成熟度都可能不同;(3) 第三句进一步承认本研究未覆盖的可能机制:表达性演奏技巧的获得,或许在不同发展水平上更适合借助本报告未反映的其他教学手段,作者并未把这一点断言为结论,而是保留为"it is possible";(4) 末句是建设性的补救建议:以更年轻的音乐学习者为对象开展后续研究,才能填补这块空白。
在章节功能上,本段是对整篇研究报告"推广性"的克制收束,把研究样本特征与教学实践对象做了显式对照,为教学法建议划出适用区间,并明确把扩展论证的责任指向后续研究。任何在弱化样本条件下引用本结论的读者,都应在这段提示下重新评估推论强度。
补充说明
段中"expressive performance skills"指演奏中速度变化、力度变化、踏板运用等塑造音乐表情的能力,与本节所讨论的核心变量直接对应;作者以"developmental level"一词把教学法差异归因于发展阶段,暗示推广问题不仅关乎年龄本身。
💡 本节核心要点
- 作者明确限定结论不宜直接外推至更年轻或更低水平的音乐学习者。
- 限定理由是受试音乐家与学校音乐课程学习者在多个维度上存在差异。
- 表达性演奏技巧的习得可能存在本报告未涉及的其他路径,并随发展水平而变化。
- 作者把对年轻学习者的进一步研究作为填补推广性空白的必要步骤。
🔑 关键术语
- expressive performance skills:演奏中塑造音乐表现力的处理能力,包括节奏伸缩、力度层次、踏板运用等;本研究的因变量即与此相关,因此限制其习得路径的结论会直接影响对教学方法推荐的边界。
- developmental level:学习者所处的发展阶段,作者用以解释教学手段可能与年龄或成熟度挂钩,从而为本结论的推广设置条件性前提。
- generalizability:研究结论向其他人群、条件或情境推广的适用程度;本段即是在为这项研究的外部效度划界。
CH4_S5 [描述性拆分] Cognitive Translation of Metaphor and Imagery
第1段(P0053)
原文复述
This study’s findings offered provisional support for the theory that musicians employ a cognitive translation process when engaging with certain kinds of expressive instruction. The investigation focused on whether subjects took the metaphor/imagery instruction and converted it into a more concrete musical representation. Subjects’ verbal reports suggested that metaphor/imagery instruction may have produced greater performance change when it was employed to construct an explicit performance plan that addressed the properties of loudness, tempo, and articulation. Because the verbal reports were not subjected to rigorous qualitative analysis, however, this line of inquiry remains only an exploratory part of the research. A theory of cognitive translation is reasonable on the basis of prior research which showed that an explicit “goal image” is a crucial element in the expressive performing of skilled musicians (Woody, 1999). Although concrete musical instruction may appear to be the most direct approach to this end, it may not be the most efficiently communicated. As an alternative, a teacher’s aural model accompanied by figurative language may be more practical. Sloboda’s (1996) theory of “extramusical templates” reinforces this, suggesting that the vast amount of aural performance information in a teacher’s model is made more manageable for a student’s memory by abstracting it into fewer extramusical analogies, gestures, or emotional expressions.
中文讲解
本段的功能是把前面几节的实验发现上升为理论层面的解释,并将其嵌入到既有音乐认知研究的框架内,因此既是"实验结果"的总结,也是"理论延伸"的起点。
逐层理解:
第一,本研究的发现"初步支持"(provisional support)一个理论假设:音乐家在面对某些表达性指令时,会经历一个"认知翻译"(cognitive translation)过程。这里的"认知翻译"是本段的核心概念——它指的不是语言间的翻译,而是把抽象的、非音乐的描述(隐喻、意象、情绪词)转换为具体的、可执行的声音表征(响度、速度、发音等动作参数)。作者用"provisional"而不是"confirmatory",并在后文补上"exploratory",说明这种解释尚处于探索阶段,作者对结论做了克制的限定,读者不应把它读成已确证的因果机制。
第二,研究聚焦的问题被精确表述为:被试是否把隐喻/意象指令"converted it to a more concrete musical representation"。也就是说,研究关心的不是隐喻/意象是否"好听",而是它是否在认知层面被转化为可操作的音乐属性。口头报告的证据显示,当隐喻/意象被用来建构一个明确的演奏计划(explicit performance plan),并指向响度、速度、发音这三个具体维度时,表演变化更显著。这一处需要特别注意"may have"——作者明确这是初步暗示而非定论,因为口头报告未经过严格的质性分析(rigorous qualitative analysis)。
第三,作者引出两条既有理论作为外部支撑:Woody (1999) 的"goal image"研究表明,熟练音乐家在表演中形成的明确目标意象是表达性演奏的关键要素;Sloboda (1996) 的"extramusical templates"理论则指出,学生在模仿教师示范时,会把教师示范中庞大的、难以全部记住的听觉信息,抽象为少量的"超音乐"类比、手势或情绪表达,以便记忆管理。这两条引用的功能不同:Woody 证明"明确的意象"是表达性演奏的内在必要条件;Sloboda 则解释为什么抽象化、隐喻化的语言反而可能比纯具体指令更高效——因为纯具体指令要求学生同时处理过多细节,而抽象化的"模板"压缩了信息量,降低了记忆负担。
第四,整段的论证逻辑可以重构为:实验显示隐喻/意象可能有助于表达 → 但需有明确的演奏计划作中介 → 这个机制可以用"认知翻译"来描述 → 该机制得到 Woody 和 Sloboda 的双重支持 → 因此,相比纯具体音乐指令,“教师示范 + 比喻性语言"的组合可能反而是更实用的教学路径。
易误解之处:读者不要把"concrete musical instruction may not be the most efficiently communicated"理解为作者否定具体教学,而是强调在"效率”(efficiency)和"记忆负荷"两个维度上,隐喻+示范可能更优。作者并没有否定具体教学的价值。
补充说明
本段内部关系提示:“cognitive translation"是本段的核心自创术语,与下文"goal image”(Woody, 1999)和"extramusical templates"(Sloboda, 1996)形成概念三角——三者分别描述同一过程的不同侧面:翻译过程的起点(隐喻/意象输入)、中间产物(目标意象)、记忆管理机制(超音乐模板)。三处出现的响度、速度、发音(loudness, tempo, articulation)在前文关于表演变化的章节中也已用作表达性维度的衡量指标,本段是它们首次被明确归入"具体音乐表征"的范畴。
脚注 / 边栏 / 图表 / 附加信息(如有)
无额外的脚注、图表或边栏材料。本段中提及的两条外部引用——Woody (1999) 的"goal image"研究以及 Sloboda (1996) 的"extramusical templates"理论——属于正文论证中直接引用的理论文献,而非脚注式补充信息,因此记入正文论证链而非附加材料。
💡 本节核心要点
- 本研究结果为"音乐家在表达性指令处理中存在认知翻译过程"这一理论提供了初步(provisional)支持,而非确证
- 认知翻译指把抽象的隐喻/意象指令转化为具体的音乐表征(响度、速度、发音)的心理中介过程
- 口头报告提示:当隐喻/意象被用来建构明确的演奏计划时,表演变化更显著;但因口头报告未经严格质性分析,此结论仍属探索性
- Woody (1999) 的"目标意象"研究为认知翻译理论提供合理性基础:明确的意象是熟练表达性演奏的关键要素
- Sloboda (1996) 的"超音乐模板"理论解释了抽象化教学的效率优势:教师示范中大量听觉信息被学生抽象为少量类比/手势/情绪,从而降低记忆负担
- 作者由此提出教学的替代路径:教师示范 + 比喻性语言,可能比纯具体音乐指令更高效地传达表达性意图
🔑 关键术语
- cognitive translation:认知翻译,指音乐家把抽象的隐喻/意象指令转化为具体的音乐表征(响度、速度、发音等可执行参数)的心理中介过程,是本段提出的核心理论概念。
- goal image:目标意象,Woody (1999) 提出,指熟练音乐家在表演前形成的明确表达性意象,被认为是表达性演奏中的关键内在要素,为本段的认知翻译理论提供合理性基础。
- extramusical templates:超音乐模板,Sloboda (1996) 提出,指学生用以抽象概括教师示范中大量听觉表演信息的外在类比、手势或情绪表达,其作用是把海量信息压缩为少量可记忆的表征,以降低记忆负荷。
- metaphor/imagery instruction:隐喻/意象指令,教学中所使用的比喻性或意象性语言(如"像在歌唱"“如流水般”),与纯具体音乐指令(如"渐强"“减速”)形成对照。
- explicit performance plan:明确的演奏计划,指学生针对响度、速度、发音等具体属性形成的可执行表达方案;本段的口头报告证据显示,当隐喻/意象被用于建构此类计划时,表演变化更显著。
CH4_S6 [描述性拆分] Combining Approaches in Authentic Teaching
第1段(P0054)
原文复述
Although this research was an examination of several different instructional modes individually, in reality, most music teachers use all three in varying proportions, and in conjunction with each other. This may in fact be the key to success. Certainly a goal of music education is to equip students for a lifetime of music-making. An adaptability to multiple approaches to musical expression would seem to be part of this. If students do cognitively carry out a translation process whereby they make expressive instruction useful for their performing, then it is important for teachers to facilitate the acquisition of this skill. This requires exposure to all modes of expressive communication and the combination thereof. If working with a developing musician, a teacher who asks for a melody to be performed “like liquid velvet” might do well to provide a model of what that sounds like, then explicitly direct attention to the salient musical properties of that model.
中文讲解
这段是全节的收束段落,核心主张是:虽然研究为分析需要把三种教学方式分开考察,但真实课堂中音乐教师往往是三种并用、按不同比例组合,这种综合运用可能就是成败的关键。要点拆解如下:
-
研究方法与真实教学之间的张力——作者承认研究设计上是把模式拆开来看(individual examination),但随即用 “in reality” 转折,指出实际教学是 “in varying proportions, and in conjunction with each other”。这是从实验室式的分类研究回到复杂教学实践的典型修辞。
-
综合即关键——“This may in fact be the key to success” 是一个温和但重要的主张:单独使用任何一种模式都不如组合使用效果好。“may in fact” 的措辞虽含推测意味,但用 “in fact” 强调了作者对其的信心。
-
终极目标的回归——“a lifetime of music-making” 和 “adaptability to multiple approaches” 把讨论拉回到音乐教育的长期目的。不是为了某一次表演,而是为了使学生具备跨情境的表达能力。这与前文提到的"翻译过程"(把表达性指令转化为自己的演奏)形成呼应:适应性就是这种翻译能力的体现。
-
教学推论——既然学生需要做这种翻译,教师就有责任 “facilitate the acquisition of this skill”。要做到这一点,“exposure to all modes” 与 “combination thereof” 是两条必要条件:既不能只教一种,也不能让学生零散地遇到各种模式而缺乏整合性体验。
-
具体例证 “like liquid velvet”——这个比喻式的表达指令形象生动,恰恰是学生难以直接"翻译"为演奏参数的典型情形。作者给出的教师应对策略分两步:(a) 先示范(provide a model),让学生听到目标声音;(b) 再把注意力明确引向那个示范中的显著音乐属性(salient musical properties)。这两步结合了"聆听模式"和"分析/概念模式",同时保留了比喻引发的审美联想,是"综合运用"原则的具体落地示范,也是本节标题 “Combining Approaches in Authentic Teaching” 的点题之笔。
理解上要注意:作者并不是说比喻指令不好,而是说单靠比喻不够;教师需要把比喻、示范、概念指引等不同模式串起来,才能帮学生完成从指令到演奏的认知翻译。
补充说明
本段内自含的术语关系:“three modes” 指向前几节分别讨论的三种教学方式(详见本节前段及前几节的论述),本段未再列举其名称。“expressive instruction” 与 “translation process” 的搭配,是承接前文关于学生如何把表达性言语转化为演奏行为的讨论。“salient musical properties” 与示范(model)的关系,体现了"先听后析"的综合教学序列。
脚注 / 边栏 / 图表 / 附加信息(如有)
无额外的脚注、图表或边栏内容。
💡 本节核心要点
- 本研究的实验设计虽把教学方式分别考察,但真实课堂中教师实际是综合使用、按比例搭配的。
- 综合运用(combination)可能正是教学成败的关键。
- 音乐教育的最终目标是使学生具备终生音乐活动的能力,而适应多种表达方式的能力是其中应有之义。
- 学生需要把表达性指令翻译为演奏行为,这一认知过程是教学应当促进的技能。
- 要促成这种翻译技能,学生必须同时接触所有表达性教学模式,并体验它们的组合运用。
- 以"like liquid velvet" 为例的教学建议是:先示范声音,再引导学生关注示范中显著的(salient)音乐属性——这一两步策略本身就是多种模式的综合应用。
🔑 关键术语
- instructional modes:指本节及前几节分别讨论的教学方式;本段虽未重新列举其名称,但明确指出真实教学中这些模式是按不同比例并用的。
- translation process:学生把表达性教学指令(口头或示范的)转化为可操作的演奏参数与表现行为的认知过程;是本段教学推论的核心对象。
- a lifetime of music-making:作者作为音乐教育终极目标的表述,强调学习成果应超越课堂情境,具有长期迁移性。
- salient musical properties:示范声音中最显著、最能体现表达意图的音乐要素(如音色、力度、节奏特征等);教师需要把学生注意力明确引向这些属性,才能促成认知翻译。
CH5_S1 Note
第1段(P0055)
原文复述
NOTE
中文讲解
这是一个二级标题,标记本节的小标题为“NOTE”(注)。在本小节的边界范围内,标题之后紧跟的是一条编号为 1 的脚注,因此本小节的功能是交代正文中某处引用或说法的来源出处。它不是正文论证段落,而是一个版面上的注释区段,提醒读者本节内容依赖于一条外部引文。
第2段(P0056)
原文复述
- Quoted by Mardy Grothe in Oxymoronica (New York: HarperCollins, 2004), p. 137.
中文讲解
这是一条编号为 1 的脚注,内容是完整的出版信息来源:相关引文转引自 Mardy Grothe 所著《Oxymoronica》一书,由纽约的 HarperCollins 于 2004 年出版,具体见第 137 页。它的作用是为正文中出现的某句话(很可能是一句带有矛盾修辞或悖论意味的引语)提供二次出处的可核查凭据——即作者本人并非直接读到原始出处,而是经由 Grothe 这本汇编性质的著作转引。对学术写作而言,这条脚注同时完成了三件事:注明转引作者、注明原书版本与出版社、注明页码,以便读者据以复核。
补充说明
脚注中出现的“Quoted by”表明这是转引关系:本书作者并未直接查阅原始文献,而是经由 Grothe 的《Oxymoronica》引述该句,因此该书是次级来源而非原始来源。
💡 本节核心要点
🔑 关键术语
- NOTE:本小节的小标题,表明其下的内容为注释/脚注,而非正文段落。
- Quoted by:表示转引关系:本书中的引文并非作者直接引自原始文献,而是经由所列中间来源引述,因此该中间来源是次级出处。
- Oxymoronica:脚注中所列的转引著作名,Mardy Grothe 所著,由 HarperCollins 于 2004 年在纽约出版,第 137 页载有本节正文所引用的那句话。
CH5_S2 References
第1段(P0057)
原文复述
REFERENCES
中文讲解
这是本文参考文献部分的二级标题,标识下方条目为正文所引用的全部文献清单。它开启的是一份按作者姓氏字母顺序排列的参考书目,覆盖音乐表达性、模仿、示范、rubato 与教学反馈等议题。
第2段(P0058)
原文复述
Barten, S. S. (1998). Speaking of music: The use of motor-affective metaphors in music instruction. Journal of Aesthetic Education, 32 (2), 89–97.
中文讲解
Barten (1998) 发表于《Journal of Aesthetic Education》第32卷第2期,第89–97页。篇名为《谈音乐:音乐教学中动觉—情感隐喻的使用》。该文考察音乐教学里教师借助动作与情感相关语言来中介学生理解与表达音乐,是关于“隐喻/语言中介表达性学习”的文献。
补充说明
“motor-affective metaphors”(动觉—情感隐喻)指将身体动作与情感反应联结起来的隐喻说法,是音乐口头示范与表达性教学中的常见策略。
第3段(P0059)
原文复述
Clarke, E. F. (1993). Imitating and evaluating real and transformed musical performances. Music Perception, 10 (3), 317–341.
中文讲解
Clarke (1993) 发表于《Music Perception》第10卷第3期,第317–341页。研究被试如何“模仿并评价真实与变换后的演奏”,是“模仿—表达性评价”研究的基础文献之一。
补充说明
“transformed musical performances”指对原演奏在时间或力度等维度上加以变换后的版本,常被用于剥离单一表达参数的作用。
第4段(P0060)
原文复述
Clarke, E. F., & Baker-Short, C. (1987). The imitation of perceived rubato: A preliminary study. Psychology of Music, 15 (1), 58–75.
中文讲解
Clarke 与 Baker-Short (1987) 发表于《Psychology of Music》第15卷第1期,第58–75页。该初步研究考察被试如何再现其所“听见的”rubato(弹性速度),关注从听觉感知到动作再现的速度迁移过程。
补充说明
“rubato”即演奏中对基本节拍的弹性偏离,是表达性时间维度的核心表现手段。
第5段(P0061)
原文复述
Dickey, M. R. (1992). A review of research on modeling in music teaching and learning. Bulletin of the Council for Research in Music Education, 113, 27–40.
中文讲解
Dickey (1992) 发表于《Bulletin of the Council for Research in Music Education》第113期,第27–40页。该文回顾了音乐教与学中“示范(modeling)”相关研究,是讨论教师示范与学生模仿之间关系的综述性文献。
补充说明
“modeling”在此特指教师以演奏或演唱为学生提供可模仿的表达性范例,是器乐/声乐教学中的关键中介。
第6段(P0062)
原文复述
Ebie, B. D. (2004). The effects of verbal, vocally modeled, kinesthetic, and audio-visual treatment conditions on male and female middle-school vocal music students’ abilities to expressively sing melodies. Psychology of Music, 32 (4), 405–417.
中文讲解
Ebie (2004) 发表于《Psychology of Music》第32卷第4期,第405–417页。该研究比较“言语、声音示范、动觉、视听”四种处理条件下男女中学生“有表达性地歌唱旋律”的能力差异,旨在区分不同示范方式对表达性歌唱的作用。
补充说明
该实验以中学生为被试,因此其结果对学校音乐课堂中的表达性教学具有直接意义。
第7段(P0063)
原文复述
Johnson, C. M. (2000). Effect instruction in appropriate rubato usage on the onset timings of musicians in performances of Bach. Journal of Research in Music Education, 48, 78–84.
中文讲解
Johnson (2000) 发表于《Journal of Research in Music Education》第48期,第78–84页。研究“rubato 使用方面的教学指导”如何影响演奏者在演奏巴赫作品时的“音符起始时间”,聚焦于rubato教学的因果效应。
补充说明
“onset timings”(起始时间)是表达性时间研究中常用的可量化指标,用以反映rubato对节奏结构的影响。
第8段(P0064)
原文复述
Juslin, P. N., & Laukka, P. (2000). Improving emotional communication in music through cognitive feedback. Musicae Scientiae, 4, 151–183.
中文讲解
Juslin 与 Laukka (2000) 发表于《Musicae Scientiae》第4卷,第151–183页。该研究关注如何通过“认知反馈”改进演奏中的情感交流,是表达性演奏“情感交流”路径下的代表性实证文献。
补充说明
Juslin 是音乐表现中情感交流研究的核心作者之一,本节多条引用围绕其工作。
第9段(P0065)
原文复述
Juslin, P. N., & Persson, R. S. (2002). Emotional communication. In R. Parncutt & G. E. McPherson (Eds.), The science and psychology of music performance: Creative strategies for teaching and learning (pp. 219–236). New York: Oxford University Press.
中文讲解
Juslin 与 Persson (2002) 在 Parncutt 与 McPherson 主编的《The science and psychology of music performance: Creative strategies for teaching and learning》(纽约:牛津大学出版社)第219–236页撰写“Emotional communication”(情感交流)一章,是同一议题的章节性综合论述。
补充说明
该章出现于“表演科学/心理学”领域被广泛引用的论文集中,常作为理论与教学的桥梁。
第10段(P0066)
原文复述
Laukka, P. (2004). Instrumental music teachers’ views on expressivity: A report from music conservatories. Music Education Research, 6 (1), 45–56.
中文讲解
Laukka (2004) 发表于《Music Education Research》第6卷第1期,第45–56页。该文报告音乐学院器乐教师对“表达性”的看法,是从教师视角出发理解表达性教学的访谈/问卷型研究。
补充说明
音乐学院(conservatoire)是专业器乐训练的关键场域,其教师对表达性的看法影响高级演奏人才的培养。
第11段(P0067)
原文复述
Lindström, E., Juslin, P. N., Bresin, R., & Williamon, A. (2003). “Expressivity comes from within your soul”: A questionnaire study of music students’ perspectives on expressivity. Research Studies in Music Education, 20, 23–47.
中文讲解
Lindström、Juslin、Bresin 与 Williamon (2003) 发表于《Research Studies in Music Education》第20期,第23–47页。题目引用学生原话《“表达性来自你的灵魂”:一项关于音乐学生对表达性看法的问卷研究》,呈现学生如何理解与表述表达性。
补充说明
该研究关注“学习者视角”,与Laukka (2004) 的教师视角形成互补。
第12段(P0068)
原文复述
Lisboa, T., Williamon, A., Zicari, M., & Eiholzer, H. (2005). Mastery through imitation: A preliminary study. Musicae Scientiae, 9 (1), 75–110.
中文讲解
Lisboa、Williamon、Zicari 与 Eiholzer (2005) 发表于《Musicae Scientiae》第9卷第1期,第75–110页。这是一项初步研究,聚焦“通过模仿获得精通”,即模仿在演奏技艺习得中的作用。
补充说明
原文中期刊名以斜体呈现,本处予以保留。
第13段(P0069)
原文复述
Persson, R. (1996). Brilliant performers as teachers: A case study of commonsense teaching in a conservatoire setting. International Journal of Music Education, 28, 25–36.
中文讲解
Persson (1996) 发表于《International Journal of Music Education》第28期,第25–36页。该文为音乐学院情境下“优秀演奏家如何教学”的案例研究,关注其“常识性教学(commonsense teaching)」实践。
补充说明
“commonsense teaching”强调教师基于演奏直觉而非显性教学法理论进行教学,是高水平表演者教师常见做法。
第14段(P0070)
原文复述
Repp, B. H. (2000). Pattern typicality and dimensional interactions in pianists’ imitation of expressive timing and dynamics. Music Perception, 18, 173–211.
中文讲解
Repp (2000) 发表于《Music Perception》第18卷,第173–211页。研究钢琴家对“表现性时间与力度”的模仿,考察“模式典型性”与多维度(时间、力度)之间的交互作用。
补充说明
Repp 是“表现性演奏的认知/运动控制”领域的核心作者,本研究在模仿任务下分离时间与力度维度。
第15段(P0071)
原文复述
Sang, R. C. (1987). A study of the relationship between instrumental music teachers’ modeling skills and pupil performance behaviors. Bulletin of the Council for Research in Music Education, 91, 155–159.
中文讲解
Sang (1987) 发表于《Bulletin of the Council for Research in Music Education》第91期,第155–159页。该研究考察器乐教师“示范能力”与学生“演奏行为”之间的关系,是教师示范与学生产出相关性的早期实证文献。
补充说明
该研究将“教师示范”作为可测量变量,与Dickey (1992) 的综述思路相互呼应。
第16段(P0072)
原文复述
Sheldon, D. A. (2004). Listeners’ identification of musical expression through figurative language and musical terminology. Journal of Research in Music Education, 52, 357–368.
中文讲解
Sheldon (2004) 发表于《Journal of Research in Music Education》第52期,第357–368页。该研究考察听者如何通过“比喻性语言”和“音乐术语”识别音乐表达,关注语言标签如何中介音乐表达的感知。
补充说明
与 Barten (1998) 共同构成“语言/隐喻—音乐表达”研究的两端:前者关注教学中的隐喻使用,后者关注听众识别。
第17段(P0073)
原文复述
Sloboda, J. A. (1996). The acquisition of musical performance expertise: Deconstructing the “talent” account of individual differences in musical expressivity. In K. A. Ericsson (Ed.), The road to excellence (pp. 107–126). Mahwah, NJ: Lawrence Erlbaum Associates.
中文讲解
Sloboda (1996) 在 Ericsson 主编的《The road to excellence》(Mahwah, NJ: Lawrence Erlbaum Associates)第107–126页撰写章节,讨论“音乐表演专长的获得”,并解构以“天赋”解释个体表达性差异的立场。
补充说明
该章属于“专长(expertise)”研究的经典论文集,与Ericsson的刻意练习理论相联系。
第18段(P0074)
原文复述
Woody, R. H. (1999). The relationship between advanced musicians’ explicit planning and their expressive performance of dynamic variations in an aural modeling task. Journal of Research in Music Education, 47, 331–342.
中文讲解
Woody (1999) 发表于《Journal of Research in Music Education》第47期,第331–342页。该研究在“听觉示范任务”条件下考察高级音乐家“明确规划”与“力度变化的表达性演奏”之间的关系。
补充说明
“aural modeling task”即“听觉示范任务”,指通过聆听示范进行模仿的学习情境,是Woody多篇研究的实验范式。
第19段(P0075)
原文复述
Woody, R. H. (2000). Learning expressivity in music performance: An exploratory study. Research Studies in Music Education, 14, 14–23.
中文讲解
Woody (2000) 发表于《Research Studies in Music Education》第14期,第14–23页。该研究为一项探索性研究,聚焦演奏中“表达性的学习”问题。
补充说明
该文是对Woody (1999) 的延伸与初步扩展,仍以听觉示范与表达性学习为核心。
第20段(P0076)
原文复述
Woody, R. H. (2002a). Emotion, imagery and metaphor in the acquisition of musical performance skill. Music Education Research, 4, 213–224.
中文讲解
Woody (2002a) 发表于《Music Education Research》第4卷,第213–224页。该文考察“情感、意象与隐喻”在演奏技艺获得中的作用,是Woody对“内部心理中介因素”的集中论述。
补充说明
与 Barten (1998) 在“隐喻”议题上形成直接呼应,本节作者亦可能据此构建其教学中介模型。
第21段(P0077)
原文复述
Woody, R. H. (2002b). The relationship between musicians’ expectations and their perception of expressive features in an aural model. Research Studies in Music Education, 18, 53–61.
中文讲解
Woody (2002b) 发表于《Research Studies in Music Education》第18期,第53–61页。研究音乐家的“期望”与其对“听觉示范中表达性特征感知”之间的关系,关注自上而下认知因素对表达性感知的塑造。
补充说明
本条与Lindström等(2003)的“学生视角”研究共同呈现表达性学习的认知—心理层面。
第22段(P0078)
原文复述
Young, V., Burwell, K., & Pickup, D. (2003). Areas of study and teaching strategies in instrumental teaching: A case study research project. Music Education Research, 5, 139–155.
中文讲解
Young、Burwell 与 Pickup (2003) 发表于《Music Education Research》第5卷,第139–155页。该文通过案例研究考察器乐教学中的“学习领域”与“教学策略”,是对器乐教学实践的多案例综合研究。
补充说明
该文与 Persson (1996) 同样关注器乐教学实践,但采用多案例方法,覆盖更广的器乐教师群体。
第23段(P0079)
原文复述
Submitted August 22, 2005; accepted January 30, 2006.
中文讲解
该条目记录本文投稿与被接受的时间:2005年8月22日投稿,2006年1月30日接受。它属于期刊文章的同行评审流程信息,常以脚注或文末注的形式置于参考文献之后。
补充说明
从投稿到接受约5个月,可视为较为正常的审稿周期。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节仅含参考文献清单与文末投稿/接受日期,无脚注、图表或边栏等附加材料;所有信息以字母顺序排列的书目条目形式呈现,是正文论点的文献支撑与出处凭证。
💡 本节核心要点
- 本节参考文献围绕“音乐表达性的获得”这一核心主题展开,覆盖教学示范、模仿、rubato、情感交流与表达性感知等多条研究脉络。
- 作者群高度集中在 Juslin、Persson、Clarke、Repp、Woody 等长期从事表达性演奏研究的团队,文献基础横跨音乐心理学与音乐教育学。
- 书目同时包含实证研究(如 Johnson 2000、Repp 2000、Woody 1999/2000/2002a/2002b)与综述/章节性文献(Dickey 1992、Juslin & Persson 2002、Sloboda 1996),体现“实证—综述”并重的文献结构。
- 关于“模仿/示范”的文献占有显著比重(Barten 1998、Dickey 1992、Ebie 2004、Sang 1987、Repp 2000、Woody 多篇),呼应正文中“通过模仿获得表达性”的论证主线。
- 文末投稿/接受日期(2005-08-22 / 2006-01-30)为读者提供审稿与发表时序背景,与正文引用的研究时段(1987–2005)相一致。
🔑 关键术语
- Modeling (示范):教师以演奏或演唱为学生提供可模仿的表达性范例;本节多篇文献(Barten 1998、Dickey 1992、Ebie 2004、Sang 1987、Woody 1999等)围绕其教学效应展开。
- Expressivity (表达性):演奏中超越音符本身、传达音乐意义的质量;本节在多个标题与主题中作为核心概念被反复研究(Laukka 2004、Lindström等 2003、Woody 2000 等)。
- Rubato (弹性速度):演奏中对基本节拍的弹性偏离,是表达性时间维度的核心手段;Clarke & Baker-Short (1987) 与 Johnson (2000) 分别从听觉模仿与教学指导两方面加以研究。
- Motor-affective metaphor (动觉—情感隐喻):将身体动作与情感反应联结起来的隐喻语言,是教学中常用的口头中介手段;Barten (1998) 与Woody (2002a) 均对此加以讨论。
- Aural modeling task (听觉示范任务):通过聆听示范进行模仿的学习情境,是Woody (1999, 2002b) 等研究中使用的实验范式。
- Imitation (模仿):在演奏研究中指再现所感知到的演奏特征(时间、力度等);Clarke (1993)、Repp (2000)、Lisboa等 (2005) 均围绕模仿与表达性展开。