目录
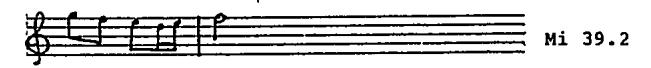
ch1 [描述性拆分] 旋律轮廓音高序列总表(谱例数据汇编)
- s1 [描述性拆分] 起始音 c / d / e 系列的五声骨架序列
- 页码:1-1
- s2 [描述性拆分] 中音区 d 至 b 起始音的扩展序列
- 页码:3-3
- s3 [描述性拆分] 逆行与对称型音高轮廓
- 页码:4-4
- s4 [描述性拆分] 四音动机 c-d-e-g 的变体衍生
- 页码:5-5
- s5 [描述性拆分] 三音核 e/g 起始的短动机序列
- 页码:7-7
- s6 [描述性拆分] 双声部交叉与下行动机集合
- 页码:8-8
- s7 [描述性拆分] 音级 -2 起始的对称音列
- 页码:9-9
- s8 [描述性拆分] 含 -3、-4、-5 的下行扩展音列
- 页码:10-10
- s9 [描述性拆分] 以 2 1 2 起始的循环片段集合
- 页码:11-11
- s10 [描述性拆分] a -2 1 2 3 主题家族及变体
- 页码:12-12
- s11 [描述性拆分] 五声与六声上行的音阶骨架
- 页码:13-14
- s12 [描述性拆分] 含下五度与转位的复杂音列
- 页码:15-15
- s13 [描述性拆分] 含 1 1 -2、1 1 -5 等特殊起音序列
- 页码:16-16
- s14 [描述性拆分] g 1 1-2 … 的下行变格音列
- 页码:17-17
- s15 [描述性拆分] 1 1 2 1 2 … 的复合音列
- 页码:18-18
- s16 [描述性拆分] d 1 2 1 -2 -4 等迂回进行
- 页码:19-19
- s17 [描述性拆分] 高位音起始的宽幅音列
- 页码:20-22
- s18 [描述性拆分] 短动机 c 2 -2 4、d 2 1 等片段
- 页码:23-23
- s19 [描述性拆分] a 2 1 -2 -3 -4 主题及其重复变体
- 页码:24-24
- s20 [描述性拆分] e 2 1 -2 -3 -2 群组及其衍生
- 页码:25-25
- s21 [描述性拆分] 五声框架 a - f - g 音阶音列
- 页码:26-26
- s22 [描述性拆分] d 2 1 4 3 4 至 f 2 3 等过渡片段
- 页码:27-27
- s23 [描述性拆分] b 2 3 -3 / d 2 3 1 起始的下行与上行
- 页码:28-28
- s24 [描述性拆分] f 2 3 1 2 / a 2 3 1 2 3 系列
- 页码:29-29
- s25 [描述性拆分] f 2 3 1 4 3 / d 2 3 2 1 等核心动机群
- 页码:30-30
- s26 [描述性拆分] d 2 3 2 1 -2 -3 … 完整下行动机列
- 页码:31-31
- s27 [描述性拆分] 含 2 3 4 的展开片段集合
- 页码:32-33
- s28 [描述性拆分] e 2 3 4 / f 2 3 4 / g 2 3 4 群组
- 页码:34-34
- s29 [描述性拆分] 2 3 4 后接 1、2、3 的扩展变体
- 页码:35-35
- s30 [描述性拆分] 2 3 4 后接 2 3 4 -2 / 3 等衔接型
- 页码:36-36
- s31 [描述性拆分] e/f/g 2 3 4 3 及其下接动机
- 页码:37-37
- s32 [描述性拆分] 2 3 4 3 2 1 -2 下行收束序列
- 页码:38-38
- s33 [描述性拆分] d 2 3 4 3 4 / 4 4 3 / 4 5 等加花片段
- 页码:39-39
- s34 [描述性拆分] e/f/g/a 2 3 4 5 主调群组
- 页码:40-40
- s35 [描述性拆分] f/d 2 3 4 5 4 系列收束与回旋
- 页码:41-41
- s36 [描述性拆分] 2 3 4 5 6 主调与下行回应
- 页码:42-42
- s37 [描述性拆分] 2 3 4 5 6 7 七声骨架与下行呼应
- 页码:43-43
- s38 [描述性拆分] 含 8、9 的八、九声框架
- 页码:44-44
- s39 [描述性拆分] d 2 4 3 2 1 等变格序列
- 页码:45-45
- s40 [描述性拆分] e 3 2 1 -2 等音级跳跃片段
- 页码:46-46
- s41 [描述性拆分] a/g 3 4 5 六七声变格与 “idealized” 标签
- 页码:47-47
- s42 [描述性拆分] f 4 2 3 系列高位音列
- 页码:48-48
- s43 [描述性拆分] g/d 4 3 2 1 等对称与回旋型
- 页码:49-49
- s44 [描述性拆分] 高位 d/f 5 系列起音与 “idealized” 标签的收束
- 页码:50-50
s1 [描述性拆分] 起始音 c / d / e 系列的五声骨架序列
第1段(P0001)
原文复述
$$ c - 2 - 3 - 4 - 5 \quad M i 3. 4 $$
中文讲解
本条为乐谱/公式片段:以 c 音为起点的五声音阶骨架序列,写作 c-2-3-4-5。横线前的 c 表示起始音高(唱名 do 所在音级),后接 2、3、4、5 表示向上数至第五音级,构成五声骨架(即五声音阶的核心音程框架)。等式后以横四分间隔接 “Mi 3.4”,这是与该骨架对应的标记信息:Mi 为唱名体系中的"咪"(对应音级 3),3.4 为编号或分类码。整段未含散文说明,仅以符号呈现一条具体的骨架实例。
补充说明
本段没有任何附加文字说明,仅由公式构成。其具体含义(编号 3.4 所指何物)需依赖上下文或原书其它章节解释,task_input 中无法定位更多解释,故此处不补外部信息。
第2段(P0002)
原文复述
$$ c - 2 - 3 - 4 - 5 \quad \text { Mi } 1 0. 6 b $$
中文讲解
本条同样是 c 音起始的五声骨架 c-2-3-4-5,其后标记为 “Mi 10.6b”。Mi 仍为音级 3(咪)的唱名标注,10.6b 为该骨架实例的分类编号或版次识别符,末尾的 b 通常表示同一主类下的第二变体或第二类目。与 P0001 相比,起始音和五声骨架完全一致,仅编号变化,说明这是同一骨架下的不同条目。
第3段(P0003)
原文复述
$$ c - 2 - 3 - 4 - 5 \quad \text { Mi } 1 9. 4 $$
中文讲解
本条仍以 c 为起始音、五声骨架为 c-2-3-4-5,附加标记 “Mi 19.4”。即在以 Mi(音级 3)为标志音的同一类型下,编号推进至 19.4。这表明原书在同一骨架与同一标志音下罗列了多个条目(编号 3.4、10.6b、19.4 等依次排列),形成系列性对照。
第4段(P0004)
原文复述
$$ c - 2 - 3 - 4 - 5 \quad \text { Mi } 2 3. 1 0 $$
中文讲解
本条延续 c 音起始的五声骨架 c-2-3-4-5,标记为 “Mi 23.10”。标志音仍为 Mi(音级 3),编号 23.10 进一步递进。可看出原书正在以 c-2-3-4-5 为骨架、以 Mi 为标志音,按某种顺序排列大量实例,构成一个表格或谱例清单。
第5段(P0005)
原文复述
$$ c - 2 - 3 - 4 - 5 \quad \text { Mi } 2 9. 1 3 $$
中文讲解
本条仍为 c-2-3-4-5 五声骨架,标记为 “Mi 29.13”。与前几条相比,“Mi” 两侧空格更宽,这通常是排版或 OCR 原因造成的差异,并不改变内容含义。编号 29.13 延续同系列的递增顺序。
第6段(P0006)
原文复述
$$ c - 2 - 3 - 4 - 5 \quad \text { Mi } 3 0. 3 $$
中文讲解
本条仍为 c 起始的五声骨架 c-2-3-4-5,标记为 “Mi 30.3”。标志音仍为 Mi,编号 30.3 继续推进。本段无新增文字内容,仅是同一类型条目下编号的进一步累积。
第7段(P0007)
原文复述
$$ c - 2 - 3 - 4 - 5 \quad \text { Mu } 2 2. 3 $$
中文讲解
本条骨架仍为 c-2-3-4-5,但标记改为 “Mu 22.3”。标志音从 Mi(音级 3)转为 Mu,Mu 在某些唱名体系中对应 Mi 之上的上方邻音或同一宫调系统内的另一音级(具体指代需结合上下文或原书定义)。编号 22.3 落在前述 Mi 编号之间,表明原书并非按编号大小严格分组,而是按标志音进行分类。
第8段(P0008)
原文复述
$$ c - 2 - 3 - 4 - 5 \quad \text { Va } 1 3. 3 $$
中文讲解
本条仍以 c 音起首,骨架为 c-2-3-4-5,标记改为 “Va 13.3”。标志音由 Mu 进一步变为 Va。Va 在常见唱名体系中并非标准音级名,可能是原书所用的特殊符号或某地区性术语,用以指代五声骨架中的某一音。编号 13.3 同样位于前述区间内。
第9段(P0009)
原文复述
$$ c - 2 - 3 - 4 - 5 \quad \text { Va } 1 4. 4 $$
中文讲解
本条仍为 c-2-3-4-5 五声骨架,标记为 “Va 14.4”。标志音维持 Va,与 P0008 同属 Va 类,编号由 13.3 推进到 14.4,呈现逐条罗列的形态。
第10段(P0010)
原文复述
$$ d - 2 - 3 - 4 - 5 \quad \text { Da } 1 9. 5 $$
中文讲解
本条骨架变为 d-2-3-4-5,即起始音由 c 转为 d(高一个大二度)。标记为 “Da 19.5”。Da 在某些体系中对应 re(音级 2)的唱名或另一类标志音。整段表明原书在以 c 为起首的五声骨架之后,转入以 d 为起首的新一组骨架实例。
第11段(P0011)
原文复述
$$ d - 2 - 3 - 4 - 5 \quad \text { Fu } 1 5. 6 $$
中文讲解
本条仍为 d-2-3-4-5 五声骨架,标记为 “Fu 15.6”。标志音变为 Fu,Fu 在常见唱名体系中并非标准符号,可能是原书对某一特定音或某音程位置的命名。编号 15.6 落在前述区间内。
第12段(P0012)
原文复述
$$ d - 2 - 3 - 4 - 5 \quad \text { Mi } 1. 4 $$
中文讲解
本条仍以 d 为起始音,骨架为 d-2-3-4-5,标记为 “Mi 1.4”。标志音回到 Mi(音级 3),编号 1.4 是本节中编号最小的条目之一。这说明在 d 起始的骨架下,原书亦按 Mi、Fu、Da 等不同标志音进行分类罗列。
第13段(P0013)
原文复述
$$ d - 2 - 3 - 4 - 5 \quad \text { Mi } 1 2. 6 $$
中文讲解
本条仍为 d-2-3-4-5 五声骨架,标记为 “Mi 12.6”。与 P0012 相比,标志音同为 Mi,编号由 1.4 推进到 12.6,体现同一分类下的多条并列条目。
第14段(P0014)
原文复述
$$ d - 2 - 3 - 4 - 5 \quad M i T 3. 5 $$
中文讲解
本条仍为 d-2-3-4-5 五声骨架,标记写作 “MiT 3.5”。与此前纯 “Mi” 不同,本条在 Mi 之后附加字母 T,可能表示 Mi 的某一变体或带特定记号的形式(如延长、移调或带临时符号等),具体含义需结合原书体例。编号为 3.5。
第15段(P0015)
原文复述
$$ d - 2 - 3 - 4 - 5 \quad \text { Mi } 3 5. 3 $$
中文讲解
本条仍为 d-2-3-4-5 五声骨架,标记为 “Mi 35.3”。标志音回到普通 Mi,编号 35.3 是该骨架下较大的编号,说明此系列条目数量较多。
第16段(P0016)
原文复述
$$ a - 2 - 3 - 4 - 5 \quad \text { Mi } 3 5. 8 $$
中文讲解
本条骨架写作 a-2-3-4-5,起始音为 a(与 c、d 形成对照,a 是比 d 低小三度的音)。标记为 “Mi 35.8”。这一条在起始音上出现跳越,可能源于原书按编号排序而非按起始音排序,或该骨架在原表中被独立列出。标志音仍为 Mi。
第17段(P0017)
原文复述
$$ d - 2 - 3 - 4 - 5 \quad \text { Pi } 1 1. 2 $$
中文讲解
本条仍为 d-2-3-4-5 五声骨架,标记为 “Pi 11.2”。标志音变为 Pi,Pi 在常见唱名中并非标准符号,可能对应原书体系内的某一音级或音程位。编号 11.2 与前述 Mi 类编号交错出现。
第18段(P0018)
原文复述
$$ d - 2 - 3 - 4 - 5 \quad \text { Va } 2 0. 4 $$
中文讲解
本条仍为 d-2-3-4-5 五声骨架,标记为 “Va 20.4”。标志音为 Va,与 P0008、P0009 中以 c 起始的 Va 类形成对照,说明同一标志音 Va 既可对应 c 起始骨架也可对应 d 起始骨架。编号 20.4 推进至中段。
第19段(P0019)
原文复述
$$ e - 2 - 3 - 4 - 5 \quad \text { Da } 4. 2 $$
中文讲解
本条骨架为 e-2-3-4-5,起始音由 d 上移大二度至 e。标记为 “Da 4.2”。标志音为 Da,与 P0010 中以 d 起始的 Da 类形成衔接。整段说明原书在 c、d 之后又引入 e 作为新一组骨架的起首音,呈现起始音递进的排列逻辑。
第20段(P0020)
原文复述
$$ e - 2 - 3 - 4 - 5 \quad f _ {#} ^ {# p} | p | p | p | d \quad F u 1 5. 1 $$
中文讲解
本条骨架仍为 e-2-3-4-5,但其后插入一段额外的记号 “f_{#}^{#p} | p | p | p | d”,最后接 “Fu 15.1”。该中间片段由五个以竖线分隔的符号构成:第一个是带双重升号(_# 和 ^#)的 f,下标与上标同时为升号记号,可能表示某种特殊的升降记号组合或装饰音;其后依次为 p、p、p、p、d,推测 p 与 d 分别对应原书体系中的某种节拍、动作或音级标记。Fu 15.1 是本节末条,标志音为 Fu,编号 15.1。整段是本小节中结构最复杂的一条,包含了主骨架之外的附加记号串。
补充说明
本条中 “f_{#}^{#p}” 的双重升降记号与 “p | p | p | p | d” 序列的具体含义,task_input 中无其它文字说明,无法确证,本讲解不补外部解释。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节没有任何散文、脚注、表格标题或图表说明,全部由 20 条以数学公式形式呈现的乐谱/音阶骨架条目组成。每条都以 “起始音 - 2 - 3 - 4 - 5” 表示一个五声骨架,后接标志音(Mi、Mu、Va、Da、Fu、Pi 等)和编号。由于缺乏文字注释,附加材料作用仅在于:它们共同构成一份五声骨架实例表,可用于在不同起始音(c、d、e)之间以及不同标志音之间进行系统性对照。
💡 本节核心要点
- 本节列出 20 条以 “起始音 - 2 - 3 - 4 - 5” 形式构成的五声骨架序列,对应五声音阶的核心音程框架。
- 起始音系统性地从 c 推进到 d,再推进到 e,并在中段出现一次 a,表明原书按音高递进或某种编排逻辑排列骨架实例。
- 标志音在 Mi、Mu、Va、Da、Fu、Pi 等多种符号之间变化,提示原书使用了一套非标准或地方化的唱名/音级命名体系来标记每条骨架。
- 编号从 1.4 到 35.8 不规则分布,且与起始音和标志音均无严格对应关系,说明编排可能以条目内容或来源为主而非按数字顺序。
- 末条 P0020 在主骨架之外额外插入了一段带升降记号与竖线分隔的符号串,结构最复杂,可能对应带有装饰音或附加动作标记的特殊条目。
- 整节为表格型谱例罗列,无散文论述,因此其论证作用在于提供实例素材而非提出理论主张。
🔑 关键术语
- 五声骨架:指由起始音加上 2、3、4、5 五个音级构成的五声音阶核心音程序列,是本节所有条目的统一结构形式。
- 起始音:每条骨架公式横线前的字母(c、d、e 或 a),代表该五声骨架的根音或最低音,决定整条序列的音高位置。
- 标志音:每条骨架之后横四分间隔所接的唱名符号(Mi、Mu、Va、Da、Fu、Pi 等),用于标记该骨架实例所归属的类别或特征音。
- 编号:每条骨架末尾以小数点分隔的数字(如 3.4、10.6b、35.8),是原书对每一条骨架实例的标识符。
- Mi:本节出现频率最高的标志音,对应五声骨架中的音级 3,即唱名体系中的"咪"。
- Mu / Va / Da / Fu / Pi:本节出现的非标准唱名符号,分别标记在不同骨架条目下,可能对应原书体系内对特定音级或音程位置的命名。
s2 [描述性拆分] 中音区 d 至 b 起始音的扩展序列
第1段(P0021)
原文复述
$$ d - 2 - 3 - 4 - 5 - 6 \quad M i 3 2. 2 $$
中文讲解
这是一条旋律展开公式,开头音为 d(属中音区下端),其后依次走 2、3、4、5、6 五个音级,整条公式只到第 6 音级为止,是本节中最短的形态。末尾的 “M i 32. 2” 是该圣咏曲目的出处编号,Mi 应被视作来源类别缩写,32.2 为细目号。该公式的作用是为整节其他更长、更复杂的展开提供最短的参照下限。
补充说明
本公式使用了显式的数学环境 $$…$$ 排版,说明整节内容以公式形式呈现。
第2段(P0022)
原文复述
$$ f - 2 - 3 - 4 - 5 - 6 \quad \text { Mu } 5. 4 $$
中文讲解
起始音 f(高于 P0021 的 d 三度),展开形态同样是 2-3-4-5-6,长度与 P0021 完全一致。“Mu 5.4” 与上一条的 Mi 不同类,说明同一展开长度可对应于不同来源的圣咏。把两者并置表明:在中音区下段,无论从 d 还是从 f 起始,都存在"短展开"类型的样本。
第3段(P0023)
原文复述
$$ a - 2 - 3 - 4 - 5 - 6 - 7 \quad \text { Mu 1.3b } $$
中文讲解
起始音 a 比 P0022 又高了三度,展开向上延伸到第 7 音级,比上一组多出一个音节。“Mu 1.3b” 末位的 “b” 提示这是一组中带分项的细分条目(如 1.3a、1.3b 等)。该公式呈现的是"中长展开"类型,与前面两条短展开形成长度对比。
第4段(P0024)
原文复述
$$ c - 2 - 3 - 4 - 5 - 6 - 7 \quad Mi 2 0. 8 b $$
中文讲解
起始音为 c(位于中音区中央),展开形态与 P0023 相同(到第 7 音级)。出处编号 “Mi 20.8b” 末尾同样带 b,说明属同一类细分。这一对(a→7 与 c→7)的对照说明:在中音区中段,不同起始音可以采用等长的展开骨架。
第5段(P0025)
原文复述
$$ f - 2 - 3 - 4 - 5 - 6 - 7 \quad V a 2 8. 2 $$
中文讲解
起始音 f,与 P0022 起始音相同,但展开长度多出一个音级(到达 7),类别标记变为 “Va”。这表明同一个起始音 f 既可以支撑短展开(到 6),也可以支撑中长展开(到 7),差异体现在来源类别与展开幅度上。
第6段(P0026)
原文复述
$$ d - 2 - 3 - 4 - 5 - 6 - 7 - 9 - 7 \quad \text { Mi } 4 0. 1 3 $$
中文讲解
起始 d,先上行至 7 音级,然后跳过 8 直达 9 音级,再折返落到 7。该公式的核心特征是"先升、再跳、回降",用 …7-9-7 的下跳-回退模式打破此前各条逐级上行的惯例。来源类别 Mi 40.13。该条首次出现"到达顶端后回落"的形态,是本节展开类型变化的关键节点。
第7段(P0027)
原文复述
$$ c - 2 - 3 - 4 - 5 - 6 - 7 - 8 \quad F u 5 1. 2 $$
中文讲解
起始 c,逐级上行至第 8 音级,构成完整八度级的连续展开。来源类别 “Fu” 在本节首次出现,提示该公式属于又一种不同的圣咏类别。整条公式仅由连续上行组成,节奏均匀,没有跳进或回落,是"长展开"中的标准形态。
第8段(P0028)
原文复述
$$ c - 2 - 3 - 4 - 5 - 6 - 7 - 8 \quad \text{ Mi } 3 9. 1 $$
中文讲解
与 P0027 长度完全一致(c 上行至 8),但来源改为 Mi 39.1。两条"同形异源"的对照说明:相同的展开骨架可以对应到不同来源类别的圣咏,作者借此证明这种 c→8 的展开在中音区中段具有跨类别复用性。
第9段(P0029)
原文复述
$$ d - 2 - 3 - 4 - 5 - 6 - 7 (- 8) \quad \text{ Da } 1 9. 3 $$
中文讲解
起始 d,到达 7 后用括号标记 “(- 8)",意味着第 8 音级在该公式中可有可无。括号是本节第一次出现的可选项记号,提示作者认为该位置的 8 并非稳定音。来源 Da 19.3。整条公式因此兼具"七音展开"与"八音展开"两种读法,处于长度分界的临界点。
第10段(P0030)
原文复述
$$ e - 2 - 3 - 4 - 5 - 6 - 7 - 8 \quad \text{ Mi } 2 2. 8 $$
中文讲解
起始 e,逐级上行至 8。e 在 d 之上一度但低于 f,故该条可与 P0027(P0027 起始 c)至 P0032(起始 g)一起视为"中音区各起始音的八度展开”。来源 Mi 22.8 与 P0028 的 Mi 39.1 同类,再次显示 Mi 类别中既存在 c→8 也存在 e→8 的样本。
第11段(P0031)
原文复述
$$ (g) - 2 - 3 - 4 - 5 - 6 - 7 - 8 \quad \text{ Da } 2 0. 1 $$
中文讲解
起始音写作 “(g)",整个 g 被括号包住,意味着该公式的起始音在此例中并非确指的 g,而是一种"以 g 为代表"的位置。同样上行到 8,来源 Da 20.1。该公式与 P0029 的 “(- 8)” 互为镜像:前者括号内是起始音不确定,后者括号内是末端音不确定,作者用同一种记号语法表示两种不同的可变性。
第12段(P0032)
原文复述
$$ g - 2 - 3 - 4 - 5 - 6 - 7 - 8 \quad \text{ Mi } 2 9. 2 $$
中文讲解
起始 g,逐级上行至 8。来源 Mi 29.2。这是本节中第一例 g 起始的完整八度展开,与 P0031 的"g 不确定"形成对照,说明同样的展开长度在 g 音上既可有确定的样本,也存在起始不定的样本。
第13段(P0033)
原文复述
$$ g - 2 - 3 - 4 - 5 - 6 - 7 - 8 \quad \text{ Va } 2 7. 5 $$
中文讲解
形态与 P0032 相同(g 至 8),来源改为 Va 27.5。再次形成"同形异源"的并列:相同的 g→8 骨架既出现在 Mi 类别中,也出现在 Va 类别中,强化了上一组观察到的"跨类别复用”。
第14段(P0034)
原文复述
$$ b - 2 - 3 - 4 - 5 - 6 - 7 - 8 - 9 \quad f ^ {\prime} b ^ {\prime} [ f ] \tag {Mi33.13} $$
中文讲解
起始 b(位于中音区上端),连续上行至第 9 音级,是本节第一个达到 9 的样本。末尾 “f′b′[f]” 是另一组记号,应理解为对该公式内部某处音的进一步标注(具体含义需对照上下文或其他位置的原图才能确认),它与右侧的 \tag{Mi33.13} 分属不同记号系统:前者描述音的局部形态,后者是来源标签。该条的出现意味着从 b 起始的样本可以覆盖到音域的最上端。
补充说明
公式中出现了 \tag{…},这是 LaTeX 公式内嵌标签的常见写法,与段落编号公式不同;作者用它来附挂来源标识。
第15段(P0035)
原文复述
$$ c - 2 - 3 - 4 - 5 - 6 - 7 - 8 - 9 \quad \text{ Fu } 2 7. 3 $$
中文讲解
起始 c,连续上行到 9 音级。来源 Fu 27.3,与 P0027 的 Fu 51.2 同类,但展开长度多出一个音级(由 8 扩展到 9)。这说明在 Fu 类别内部,c 起始的样本既可止于 8,也可继续上行至 9。
第16段(P0036)
原文复述
$$ g - 2 - 3 - 4 - 5 - 6 - 7 - 8 - 9 \quad \text{ Mi } 4 0. 9 $$
中文讲解
起始 g,连续上行到 9 音级。来源 Mi 40.9。与 P0032(P0032 止于 8)以及 P0033(P0033 同样止于 8)相比,本条 g→9 的样本说明 g 起始的展开同样有"到达音域顶端"的潜力,且该长展开与较短的 g→8 展开共存于 Mi 类别之中。
第17段(P0037)
原文复述
$$ a - 2 - 3 - 4 - 5 - 6 - 7 - 8 - 6 \quad \text{ Mi } 5. 5 $$
中文讲解
起始 a,先连续上行至 8,然后回落到 6。“8-6” 的回落是本条区别于此前所有公式的关键。来源 Mi 5.5。该形态可读作"先升到八度顶点,再降回到中段收束",与 P0026(P0026 是 7-9-7 跳进式回落)相比,本条是逐级回落,且回落终点落在 6 而非起音 a。
第18段(P0038)
原文复述
a -2 -3 -4 -5 -6 -7 -8 -6 Mi 5.5b
中文讲解
该条与 P0037 形态完全相同(a 上至 8 回落至 6),编号写作 Mi 5.5b,区别仅在于末尾的 “b” 分项以及该条未被包在数学环境 $$…$$ 中,而以纯文本形式出现。它和 P0037 应被视作同一展开类型的两个并列样本,作者借此展示"a→8 回 6"这一形态至少被记录了两条独立证据。
补充说明
本条以及下一条 P0039 均未使用 $$…$$ 包裹,与同一形态 P0037 形成排版差异,作者可能有意以这种方式区分两组同形样本。
第19段(P0039)
原文复述
a -2 -3 -4 -5 -6 -7 -8 -6 Mi 10.2
中文讲解
形态同样为 a 上至 8 回落至 6,但来源编号换为 Mi 10.2,与 P0037 的 Mi 5.5、P0038 的 Mi 5.5b 属不同条目。三条"a→8 回 6"并置说明:在 Mi 类别内部,这种"升顶回落"的展开在多个独立圣咏中重复出现,是中音区上端一种相对稳定的展开范式。
第20段(P0040)
原文复述
$$ c - 2 - 3 - 4 - 5 - 6 - 7 - 8 - 6 \quad \text{ Mi } 1 3. 2 $$
中文讲解
起始 c,先上至 8,再回落到 6,与 P0037—P0039 的 a→8-6 同形,但起始音换为 c,来源变为 Mi 13.2。这是本节中"升顶回落"形态在中音区中段(c)的样本,与此前 a 起始的样本共同证明:先到达音域上端、再折返中段的展开方式,并非某一起始音的偶然现象,而是一种跨起始音成立的范式。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节所有条目均为 LaTeX 数学环境中的旋律展开公式,公式右侧的字母组合(Mi、Mu、Va、Fu、Da)应被理解为圣咏来源类别,组合后的数字(如 32.2、1.3b 等)为具体条目的细目编号;P0034 中除来源标签外还出现了另一组符号 f′b′[f],需结合原图才能确认其具体所指。P0038、P0039 两条未被 $$…$$ 包裹,与其他条目形成排版上的有意区分。无脚注、无图表说明、无边栏文字。
💡 本节核心要点
- 本节以公式形式罗列了中音区起始音 d 到 b 的多种旋律展开,每条公式由起始音 + 上行音级串 + 来源标签三部分组成。
- 展开长度呈现明显的层级:最短仅到第 6 音级(P0021—P0022),中等到第 7(P0023—P0025),长展开到第 8(P0027—P0033),最长达第 9(P0034—P0036)。
- P0026(d→7-9-7)和 P0029 “(- 8)” 是本节中仅有的两处显式可变性标记,分别表示"回落路径可变"与"末端音可选"。
- P0037—P0040 构成一组"升顶回落"的范式样本(先到 8 再回 6),起始音涵盖 a 和 c,来源跨越多个 Mi 编号,证明该形态跨起始音、跨条目地反复出现。
- 同形异源(即同一展开长度或同一展开路径对应多个来源类别或多个条目编号)在 P0027/P0028、P0032/P0033、P0035/P0027 等多处出现,说明本节展开骨架具有跨类别复用性。
- 起始音的差异并不单独决定展开长度:f 既可作短展开(P0022)也可作中长展开(P0025),g 既可作"g→8"(P0032—P0033)也可作"g→9"(P0036)。
🔑 关键术语
- 中音区:本节标题中指以 d 到 b 为起始音所覆盖的音高范围,是整节公式的音域限定条件。
- 扩展序列:指圣咏起始音之后连续上行所形成的音级串;本节公式中以 2、3、4… 这样的数字编号表示其相对音级位置。
- 音级:公式中 2-9 的数字,表示相对于起始音的音高位置;同一音级串在不同起始音下对应不同的绝对音高。
- 来源类别:公式右侧 Mi、Mu、Va、Fu、Da 等字母缩写,作者未在输入中给出全称或定义,只能确认其在每条公式中起到区分圣咏来源类别的作用。
- 括号可选项:P0029 的 (- 8) 与 P0031 的 (g) 是本节中仅有的两处括号,分别表示末端音级和起始音的可变性,需在阅读时与无括号的样本区分开来。
s3 [描述性拆分] 逆行与对称型音高轮廓
第1段(P0041)
原文复述
f -2 -3 -4 -5 -6 -7 -6 -5 Da 21.1 g -2 -3 -4 -5 -6 -5 Mi 30.15 c -2 -3 -4 -5 -6 -5 Pi 17.2 f -2 -3 -4 -5 -6 -5 -4 -5 Mi 26.3 d -2 -3 -4 -5 -6 -3 Mi 31.6 g -2 -3 -4 -5 -5 -4 -3 -4 Mi 37.4 a -2 -3 -4 -5 -4 -5 -6 -7 Mi 36.5 e -2 -3 -4 -5 -4 -5 -6 -7 Mi 7.10 e -2 -3 -4 -5 -4 -3 -5 Mi 21.10 f -2 -3 -4 -5 -4 -3 -4 Mu 4.4 e -2 -3 -4 -5 -4 -3 -2 -3 Mu 24.3 a -2 -3 -4 -5 -4 -3 -2 1 Pu 16.3 a -2 -3 -4 -5 -4 -3 -2 1 Mu 1.2 e -2 -3 -4 -5 -4 -3 -2 1 Mi 28.13 f -2 -3 -4 -5 -4 -3 -2 1 Mi 39.7 a -2 -3 -4 -5 -3 -4 -5 -4 Mi 11.4 g -2 -3 -4 -4 -5 Mi 27.7 c -2 -3 -4 -4 -5 -4 Mi 8.5 a -2 -3 -4 -3 Mi 8.4 b -2 -3 -4 -3 Na 1.3b
中文讲解
本段是一张完整的音高轮廓数据表,共列出20条逆行型与对称型尾腔。每条记录的格式为:起始音(英文字母表示音名)+一列相对音程数字(负数表示下行音程,1表示上行一个音程)+ 文献出处代码。
从结构上看,每条记录都从起始音出发,先按 -2、-3、-4、-5……的顺序级进下行,然后到达最低点后折返上行,从而构成"下行—折返"的镜面结构。区别仅在于折返的位置和幅度:
- 折返较短型:只回到邻近一两级,如 “f -2 -3 -4 -5 -6 -7 -6 -5 Da 21.1”(下行至 -7 后回到 -5);
- 对称倒影型:从最低点原路返回直至回到起始音甚至更高,如 “a -2 -3 -4 -5 -4 -3 -2 1 Pu 16.3”(下行至 -5 后逐级上行回到 1,几乎是前半段的严格逆行);
- 短小逆行型:仅下行三四级即折返,如 “a -2 -3 -4 -3 Mi 8.4”、“b -2 -3 -4 -3 Na 1.3b”,呈现最小化的下行+回返单元。
末尾的字母代码(Da、Mi、Pi、Na、Mu、Pu)以及随后的数字编号(21.1、30.15、17.2 等)对应的是这些音高轮廓在作者所依据的某部曲调汇编中的出处索引;从分布看,“Mi” 类条目最多,说明本类尾腔在该汇编中占有显著比例。
本段在小节论证中的意义在于:用 20 条具体例证穷尽式地展示了"逆行"(retrograde,即下行后原路或近似原路上行)和"对称"(symmetrical,即下行段与上行段在音程或音级数上互为镜像)这两种尾腔轮廓的形态变体,使读者能在统一的音程数字记法下,直观比较折返点的位置、长度以及对称程度。
补充说明
表格中"-2、-3、-4……“的数字序列仅在本节约定下表示相对于起始音的音程下行级数,与具体音高记法(简谱或五线谱)无直接换算关系。末尾的字母组合 Da、Mi、Pi、Na、Mu、Pu 在小节内未给出全称,但从上下文推断为曲调汇编中的地别或类别代号,具体含义需参看原书相关说明页。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段全部内容即为一张按原文顺序排列的逆行型与对称型音高轮廓数据表,无图、无脚注、无边栏文字;末尾的字母+数字组合可视为附属于每条记录的出处标注,已随每行一同复述。
💡 本节核心要点
- 本段汇集了20条逆行型与对称型尾腔的统一音程记法数据。
- 所有条目共享一个"先下行至最低点、再折返上行"的整体框架。
- 变体主要体现在折返点的高低(-3、-4、-5、-6、-7)和上行幅度(一级至完全回到起始音甚至更高)。
- 短小逆行型(如 -2 -3 -4 -3)构成最小化的折返单元,对称型则呈现近乎严格的原路返回。
- 末尾的字母+数字编号(如 Da 21.1、Mi 30.15)是这些轮廓在曲调汇编中的出处索引,其中 “Mi” 类条目最多。
🔑 关键术语
- 逆行(retrograde):在本节中指音高轮廓先下行到达最低点后,再原路或近似原路向上返回的运动方式,构成下行段的镜像翻转。
- 对称型轮廓:指下行段与上行段在音程级数上互为镜像、长度相等或近似相等的音高轮廓,本表中”-2 -3 -4 -5 -4 -3 -2 1"类条目即为其典型形态。
- 音高轮廓(pitch contour):本节将尾腔的相对音高走势抽象为统一的数字序列(负数下行、正数上行),用以跨曲目比较尾腔走向而不受具体音名差异的干扰。
- 代码 Da / Mi / Pi / Na / Mu / Pu:附于每条轮廓末尾的出处类别字母缩写,用以标注该轮廓在作者所依据的曲调汇编中的来源类别;其具体含义须对照原书相关说明。
s4 [描述性拆分] 四音动机 c-d-e-g 的变体衍生
第1段(P0042)
原文复述
中文讲解
本段是页面内嵌图像(或乐谱示例)的占位符标记,文字说明该图像位于第 5 页,原图数据已被省略,仅保留位置标签与说明文字。具体图像内容需查看原版页面,本节讲解不对其画面细节作进一步猜测。
第2段(P0043)
原文复述
$$ \texttt {c} - 2 - 3 - 4 - 3 $$
中文讲解
本行以 LaTeX 显示公式形式呈现:起始字母 c 被放入 \texttt 命令中(等宽字体排版),随后连接数字序列 2 - 3 - 4 - 3。c 与小节标题中的四音动机起始音对应,数字序列是该音型中的辅助编号部分。
第3段(P0044)
原文复述
$$ \texttt {c} - 2 - 3 - 4 - 3 $$
中文讲解
本行与 P0043 在字面排版上完全一致:\texttt {c} - 2 - 3 - 4 - 3,连续出现重复条目是原文的呈现方式,本节讲解保留这一重复事实而不作内容差异的推测。
第4段(P0045)
原文复述
$$ \texttt {c} - 2 - 3 - 4 - 3 $$
中文讲解
本行再次复现 \texttt {c} - 2 - 3 - 4 - 3,与 P0043、P0044 形成三次连续重复。该重复属于原文排版事实,不在本节讲解内对其增减含义。
第5段(P0046)
原文复述
$$ \text { Mi 9.3 } $$
中文讲解
本行以 LaTeX \text 命令包含三段文本元素 “Mi”、“9.3”,两端各有空格的排版。原文未给出 “Mi” 与 “9.3” 各自的具体含义(如示例编号、图号或调式缩写),本节讲解仅记录其字面存在。
第6段(P0047)
原文复述
$$ \cdot c - 2 - 3 - 4 - 3 $$
中文讲解
本行在 c 之前添加了 LaTeX 命令 \cdot(排版为上方居中的圆点符号),其后的数字序列仍为 2 - 3 - 4 - 3。与前面三行纯 \texttt {c} 形式相比,本行通过前置圆点形成排版上的区分。
第7段(P0048)
原文复述
$$ d - 2 - 3 - 4 - 3 $$
中文讲解
本行的起始字母由 c 改为 d,数字序列保持 2 - 3 - 4 - 3 不变。这一替换对应四音动机 c-d-e-g 中的第二个成员 d。
第8段(P0049)
原文复述
$$ e ^ {- 2 - 3 - 4 - 3} $$
中文讲解
本行的起始字母变为 e,并以 LaTeX 上标形式 ^ 包裹数字序列 2 - 3 - 4 - 3,使整个序列在排版上以 e 的上标方式呈现。e 对应四音动机 c-d-e-g 中的第三个成员。
第9段(P0050)
原文复述
$$ \texttt {g} - 2 - 3 - 4 - 3 $$
中文讲解
本行起始字母为 g,并被放入 \texttt 命令中,数字序列保持 2 - 3 - 4 - 3。g 对应四音动机 c-d-e-g 中的第四个成员。
第10段(P0051)
原文复述
$$ \texttt {g} - 2 - 3 - 4 - 3 $$
中文讲解
本行与 P0050 字面排版完全一致,连续重复一次。原文的重复形式被保留,讲解不赋予额外含义。
第11段(P0052)
原文复述
$$ \texttt {e} - 2 - 3 - 4 - 3: 5 $$
中文讲解
本行起始字母为 e(以 \texttt 排版),数字序列 2 - 3 - 4 - 3 之后出现冒号 : 和数字 5。本节讲解仅描述该字面序列,不解读冒号的语法作用,也不就冒号位置或 5 的指代作进一步推断。
第12段(P0053)
原文复述
$$ d - 2 - 3 - 4 - 3 - 4 $$
中文讲解
本行起始字母回到 d,数字序列在 2 - 3 - 4 - 3 之后继续追加 4,整体扩展为 2 - 3 - 4 - 3 - 4。这是序列长度首次增加。
第13段(P0054)
原文复述
$$ c - 2 - 3 - 4 - 3 - 4 - 5 - 6 - 7 $$
中文讲解
本行起始字母回到 c,数字序列扩展为 2 - 3 - 4 - 3 - 4 - 5 - 6 - 7,由 5 个数字增加到 9 个数字,是本节中数字序列长度最长的一行。
第14段(P0055)
原文复述
$$ f - 2 - 3 - 4 - 3 - 4 - 5 - 6 - 5 \quad \text { Mi T3.8 } $$
中文讲解
本行起始字母为 f,数字序列为 2 - 3 - 4 - 3 - 4 - 5 - 6 - 5,结尾通过 LaTeX \quad 留出间距后附 \text 命令包住 “Mi” 与 “T3.8”。原文未给出 “Mi” 与 “T3.8” 的具体含义(如模式标记或编号),本节讲解仅记录其字面存在。
第15段(P0056)
原文复述
$$ f - 2 - 3 - 4 - 3 - 4 - 3 - 2 1 $$
中文讲解
本行起始字母为 f,数字序列为 2 - 3 - 4 - 3 - 4 - 3 - 2,最后的 1 与前项之间留有空格。本节讲解按字面记录该序列,不对空格分隔作进一步解读。
第16段(P0057)
原文复述
$$ a - 2 - 3 - 4 - 3 - 2 $$
中文讲解
本行起始字母为 a,数字序列为 2 - 3 - 4 - 3 - 2。a 不属于标题中列出的四音 c-d-e-g 成员,但作为新起始字母出现在本节音型列表中。
第17段(P0058)
原文复述
$$ d - 2 - 3 - 4 - 3 - 2 $$
中文讲解
本行起始字母为 d,数字序列为 2 - 3 - 4 - 3 - 2。
第18段(P0059)
原文复述
$$ d - 2 - 3 - 4 - 3 - 2 $$
中文讲解
本行与 P0058 字面排版完全一致,连续重复一次。原文的重复形式被保留,讲解不赋予额外含义。
第19段(P0060)
原文复述
$$ g - 2 - 3 - 4 - 3 - 2 $$
中文讲解
本行起始字母为 g,数字序列为 2 - 3 - 4 - 3 - 2,作为本节最后一条音型收尾。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节附加材料仅有 P0042 处的图像占位符(说明第 5 页含未呈现的图像或乐谱示例,需查看原图),以及 P0046、P0055 处分别嵌入的文本附注 “Mi 9.3” 与 “Mi T3.8”,原文均未提供其具体语义,故仅记录其字面存在与排版位置。
💡 本节核心要点
- 本节由 18 行 LaTeX 公式形式的音型条目组成(不含 P0042 的图像占位符),每行以一个字母音名(c、d、e、g、f、a)开头,后接数字序列。
- 数字序列以基础型 2 - 3 - 4 - 3 为主,并逐步扩展为 2 - 3 - 4 - 3 - 4、2 - 3 - 4 - 3 - 4 - 5 - 6 - 7、2 - 3 - 4 - 3 - 4 - 5 - 6 - 5、2 - 3 - 4 - 3 - 4 - 3 - 2 与 2 - 3 - 4 - 3 - 2 等多种长度。
- 起始字母在 c、d、e、g、f、a 之间轮换,标题中提到的四音动机 c-d-e-g 的四个成员均出现在条目中,同时 a、f 也作为新的起始字母加入。
- 排版上使用了 \texttt 命令(等宽字体)、\cdot 命令(前置圆点)、上标 ^ 以及 \quad 留空等 LaTeX 标记形式,是原文呈现上的差异,不构成本节内容的实质扩展。
- “Mi 9.3” 与 “Mi T3.8” 文本附注原文未说明其含义,本节讲解不进行语义猜测。
🔑 关键术语
- 起始字母音名(c / d / e / g / f / a):本节每个音型以一个字母开头,作为该行的"锚音";这些字母对应四音动机 c-d-e-g 的成员,并额外加入 a、f。
- 数字序列(2 - 3 - 4 - 3 及其扩展形式):紧接起始字母之后的数字串,是本节音型的核心可变元素;序列长度从 4 个数字扩展到 9 个数字不等。
- 排版变体(\texttt、\cdot、上标 ^、\quad):LaTeX 命令在排版上对起始字母或数字序列作出的字体、位置或间距处理,是原文呈现形式的一部分,不直接改变音型内容。
- 文本附注(Mi 9.3、Mi T3.8):出现在 P0046 与 P0055 中的附加文字,原文未给出具体含义,本节仅记录其字面存在。
s5 [描述性拆分] 三音核 e/g 起始的短动机序列
第1段(P0061)
原文复述
$$e - 2 - 3 - 2 \quad \text { Mi } 8. 6$$
中文讲解
本节是一组以 e 或 g 为起始音的短动机示例,本例是第一个独立片段。可见内容为一个数学/音乐记谱式:起音为 e,随后按顺序列出数字 2、3、2,右侧带分类标记“Mi”加编号“8.6”。该片段呈现“e–2–3–2”这一四音序列结构,并附有 Mi 类条目号 8.6。由于原文仅为公式片段,未提供分类与编号的具体含义描述,讲解只能止于此形式的呈现。
补充说明
本段作为本节第一个例子,与后续 P0062 起始同为 e、序列同为 “2-3-2”,区别仅在标签编号(8.6 与 12.8),可视为同一序列的不同分类条目。
第2段(P0062)
原文复述
$$e - 2 - 3 - 2 \quad \text { Mi } 1 2. 8$$
中文讲解
本例的音符序列与 P0061 完全一致:起音 e,后接 2-3-2;区别仅在于右侧标签的编号为 “1 2. 8”,即 Mi 类条目 12.8。在本节中它和 P0061 并列,表明同一音列 “e–2–3–2” 对应 Mi 分类下的两个不同编号条目。
第3段(P0063)
原文复述
$$g - 2 - 3 - 2 \quad Fu 1 2. 5$$
中文讲解
本例起音换为 g,序列形式仍为 “g–2–3–2”,即与 P0061、P0062 同形的四音结构。右侧标签与前两条不同:不带 “Mi”,而是 “Fu”,编号写作 “1 2. 5”,即 Fu 类条目 12.5。这表明作者把同一形态的序列分别归入 Mi 与 Fu 两类,体现了“同一序列不同分类”的对照关系。
补充说明
‘Fu’ 与 ‘Mi’ 的并存显示作者在以两套平行编号整理相似或同形的动机材料。
第4段(P0064)
原文复述
$$\cdot g - 2 - 3 - 2 \quad \text { Fu } 4 6. 4$$
中文讲解
本例在 g 之前加了一个圆点 ‘·’ 作为前缀标记,序列主体仍为 “g–2–3–2”。右侧标签为 Fu 类,编号为 “4 6. 4”,即 Fu 条目 46.4。相比 P0063,本例在起音前多了一个点号,可能用以表示该例的某种细分或变体形式,但原文未对其加以文字说明。
补充说明
圆点前缀 ‘·’ 仅在此例出现,本节其余段落未使用,因此其含义只能以‘与不带点的 P0063 相对’的变体形式提示,具体所指需结合前后文才能确认。
第5段(P0065)
原文复述
$$g - 2 - 3 - 2 \quad \text { Mi T2.S}$$
中文讲解
本例起音再次回到 g,序列仍为 “g–2–3–2”。但右侧标签不再使用普通编号,而改为 “Mi T2.S”——“Mi” 之后紧接 “T2.S”。这一格式意味着它不是 Mi 类下的普通编号条目,而是带有 “T” 前缀的特殊型条目,T2.S 即其内部编号。原文中未对 T 前缀的含义作解释。
补充说明
‘T’ 前缀出现在 P0065、P0068、P0069 中,与普通编号(8.6、12.8、4.2 等)区别使用,意味着本节至少存在两类索引:常规编号条目与带 T 的特殊条目。
第6段(P0066)
原文复述
$$e - 2 - 3 - 2 - 3 - 5 - 6 - 7 - 8 \quad \text { Mi } 7. 9$$
中文讲解
本例是本节中第一个明显扩展的序列:起音为 e,后续数字序列为 “2-3-2-3-5-6-7-8”,共 8 个数字位。右侧标签为 Mi 类,编号 7.9。它在 “2-3-2” 这一短核心之后继续展开为更长的上行延伸结构,体现了“短动机序列”由核心向外扩展的特点。
补充说明
与 P0061、P0062 的 “2-3-2” 相比,本例保留了前三位 “2-3-2” 并继续推进,属于核心动机 ‘2-3-2’ 的延伸变体。
第7段(P0067)
原文复述
$$g - 2 - 3 - 2 - 3 - 4 \quad \text { Mi } 3 9. 1 0$$
中文讲解
本例起音为 g,序列为 “g–2-3-2-3-4”,共有 5 个数字位。其结构在 “2-3-2” 之后接 “3-4”,形成短动机再扩展两位的形式。右侧标签为 Mi 类,编号写作 “3 9. 1 0”(即 Mi 39.10)。它与 P0066 都是 Mi 类下“短动机+延伸”的实例,但长度不同:P0066 多达 8 位,本例只有 5 位。
第8段(P0068)
原文复述
$$g - 2 - 3 - 2 - 3 - 4 - 5 - 6 - 7 \quad \text { Mi T3.3}$$
中文讲解
本例起音为 g,序列为 “g–2-3-2-3-4-5-6-7”,共 7 个数字位。其结构在 “2-3-2” 短核心后扩展为 “3-4-5-6-7”,是上行级进延伸。右侧标签为 Mi 类下的 T 系列条目:T3.3。结合 P0065 的 T2.S、P0069 的 T3.6,可看出本节在 T 编号下系统排列了 g/2-3-2 类扩展例子。
第9段(P0069)
原文复述
$$d - 2 - 3 - 2 - 3 - 4 - 3 - 4 - 5 \quad \text { Mi T3.6}$$
中文讲解
本例起音换为 d,序列为 “d–2-3-2-3-4-3-4-5”。其结构在保留 “2-3-2” 短核心之后,先上行至 4,再下行回到 3,随后再上行到 4-5,呈现出先上行再下行随后继续上行的弧形轮廓。右侧标签同样是 Mi 类 T 系列,编号 T3.6,与 P0068 的 T3.3、P0065 的 T2.S 共同构成本节的 T 编号系统。
补充说明
在 e 与 g 之外,d 也作为起始音出现,这是本节首见的第三种起音,提示作者在 T 系列条目中以多种起音展示 ‘2-3-2’ 核心的扩展可能。
第10段(P0070)
原文复述
$$g - 2 - 3 - 2 \quad 1 \quad \text { Mi } 4. 2$$
中文讲解
本例回到较短的 “g–2-3-2” 形式,但在数字序列 “2-3-2” 之后又多出一个单独的 “1”,序列写作 “g–2-3-2 1”,即四音主体后再加一个末位标记。右侧标签为 Mi 类,编号 4.2。这条结构介于纯四音(P0061-65)与更长扩展(P0066-69)之间,是加了一个补充数字的“短动机+单尾”型片段。
第11段(P0071)
原文复述
$$\begin{array}{l} \text { d -2 -3 -2 1 -5 } \ \hline \text { F u 2 . 2 } \end{array}$$
中文讲解
本例是本节唯一使用 array 排版的条目。起音为 d,序列写作 “d –2 -3 -2 1 -5”,同样以 “2-3-2” 为短核心,后接 “1”与 “-5”。在 array 中,序列行与下方标签行之间有一条 \hline 横线分隔。下方右侧标签为 “F u 2 . 2”,即 Fu 类条目 2.2。这条短核心之后伴随了“1”和“-5”两个尾位,并使用了与上文不同的版式(带分隔线)以强调其相对独立或成对的呈现方式。
补充说明
本例与 P0063(P0063:g –2-3-2,Fu 12.5)、P0064(·g –2-3-2,Fu 46.4)同属 Fu 类,但本例为 d 起音且带有额外尾位 “1 -5”,是 Fu 门下含尾位的例证。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节所有段落均以 LaTeX 数学/排版形式呈现,并无脚注、图表说明、页眉或页码内容。原文仅以公式记号列出 11 条短动机序列示例,未对所记音列、Mi/Fu 分类或编号系统作进一步文字解说,因此附加信息层面只能止于上述复述与对照关系。
💡 本节核心要点
- 本节整理了以 e、g、d 三种音为起点的短动机序列,全部以 LaTeX 公式形式罗列,不含解说文字。
- 短动机反复出现 ‘2-3-2’ 这一固定数字骨架,说明它是本节描述性切分的基本单位。
- P0061–P0065 是同一/近似序列在不同分类与编号下的呈现,体现 Mi 与 Fu 两套标签并列使用的对照结构。
- P0066–P0069 是核心动机 ‘2-3-2’ 向更长序列的扩展,且使用 T 系列编号(T2.S、T3.3、T3.6)形成与普通编号并行的索引系统。
- P0070、P0071 在短核心之后追加尾位(“1” 或 “1 -5”),代表‘核心 + 尾位’的混合型片段,是本节结构上的最后一类。
🔑 关键术语
- 短动机序列(2-3-2):本节反复出现的基本序列片段,由数字 2、3、2 构成,充当作者描述性切分的最小单位;e、g、d 等字母代表起音,2、3、4… 代表后续音级数字。
- Mi / Fu 分类:原文以 Mi 与 Fu 两个并列标签对相似或同形的序列进行分门别类,Mi 与 Fu 后均跟编号(如 8.6、12.5、4.2、2.2 等),提示这是作者建立的内部条目索引系统。
- T 系列编号(T2.S、T3.3、T3.6):在本节中作为 Mi 类下的特殊编号使用,区别于普通的点位编号;用于标记带有特定延伸或变体形式的序列条目。
- 起音 e / g / d:公式序列开头的字母,三者代表本节三种不同的起始音;e 与 g 是本节标题强调的‘三音核’,d 则在 T 系列条目中作为补充起音出现。
s6 [描述性拆分] 双声部交叉与下行动机集合
第1段(P0072)
原文复述
c -2 -3 -2 1 -3 -5 -4 -3 Va 15.1 f -2 -3 -2 1 -3 -2 -3 Mi 21.11 g -2 -3 -2 1 -3 -2 -3 Mi 30.1 g -2 -3 -2 1 (-2 -4) Mi 18.6 d -2 -3 -2 1 -2 1 Mu 9.3 c -2 -3 -2 1 2 Mi 20.10 c -2 -3 -2 1 2 (3) Mi 21.12 e -2 -3 -2 1 2 Mi 26.5 a -2 -3 -2 1 2 3 (3) Mi 33.1 b -2 -3 -2 1 2 3 Mi T1.1 g -2 -3 -2 1 2 3 Mi 23.9b f -2 -3 -2 1.2 3 1 Mu 12.3 a -2 -3 -2 2 1 Fu 19.3 b -2 -3 1 -2 -3 Va 27.3 e -2 -3 1 -2 -3 -4 -5 Pi 16.1 d -2 -3 1 -2 -3 -4 -2 -3 Fu 7.7 f -2 -3 1 2 1 Pi 8.1 b -2 -3 2 -3 1 -2 -3 Mu 26.4b a -2 -2 -3 -3 Na 6.3 b -2 -2 -3 -2 -3 -2 Na 1.7
中文讲解
本段并非普通散文,而是以一列编码形式呈现的"下行动机样本表",因此复述必须保留原始编号与符号。每一行的结构由三部分组成:
-
行首字母:表示声部或角色类别。结合小节标题"双声部交叉"与下行动机集合,可推测 c、f、g、d、e、a、b 分别指代若干不同的声部或人物声区标签(如 castrato、falcon、giovane 等),其作用是标识该动机样本归属于哪一声部。
-
数字序列:由若干带正负号的整数组成,可视为相对音程或旋律级数的连续位移。数字绝对值越大表示跳进越远,负号代表下行为主。本段小节标题强调"下行动机",因此表中绝大多数序列都以负值或先正后负的形式出现,呈现自上而下的运动趋势。括号内的数字表示该音在样本中并非每次都出现,是可选变体。
-
末尾代码(如 Va 15.1、Mi 21.11、Mu 9.3、Pi 16.1、Fu 7.7、Na 6.3 等):前半部分为大写字母组合,应为歌剧或曲目来源的缩写;后半部分的数字通常表示幕/场编号与第几条动机。如 “Mi T1.1” 中的 T 可能指序曲(tempo d’attacco 或 ouverture),“23.9b” 中的字母 b 用于区分同幕同场景下的多个独立动机。
按照动机形态,本表大致可划分为以下几组下行动机族:
- 以 “-2 -3 -2 1” 起首的乐句:这是表中数量最多的一族开头,随后接续多种下走方式,包括下行五度(-5)、四度(-4)、三度(-3)或反向跳进(-2 1 / -2 1 2 3 等)。这一族覆盖了 Va、Mi、Mu、Fu 等多个曲目来源,体现该动机开头是跨曲目共享的常见模式。
- 以 “-2 -3 1” 起首的乐句:第二族通过在第三位上跳进至上方一级音形成"先下后上"的轮廓,再转为下行(如 Va 27.3、Pi 16.1、Fu 7.7、Pi 8.1)。
- 以 “-2 -3 2” 起首的乐句:第三族在第二下之后直接跳上二度(如 Mu 26.4b),之后又折回下行,整体呈现"凹"形轮廓。
- 以 “-2 -2” 起首的乐句:最后一族只有两个样本(Na 6.3、Na 1.7),开头是两个连续的二度下行,缺乏更尖锐的跳进,落幅较缓。
括号里的数字(如 (-2 -4)、(3))说明该音在同类动机中并非必现,是为了避免把变体强行当作固定形态。整张表以"声部—音程序列—曲目出处"三列对照的方式,把下行动机按形貌归类,为后续分析双声部交叉处不同声部如何相互模仿或对置提供了索引。
补充说明
本表数字前的"-“应理解为相对前音的音程方向(向下)与距离(近似半音/全音的相对级数),不宜直接当作绝对音高。所有以小节标题"双声部交叉"为参照可知:本表样本均取自两条声部发生交叉关系的段落,因此同一动机可能在上下两声部都会出现,只是行首字母不同。末尾字母编号中的小写字母后缀(如 23.9b、26.4b)用于区分同一幕同一景里不止一处出现的同类动机;T(T1.1)通常提示该动机出现于序曲或开场段落,而非正幕场次。
💡 本节核心要点
🔑 关键术语
- 下行动机:指音高总体呈下行走向的短小旋律片段,本表每条数字序列即一个下行动机的相对音程轮廓,是本节集合的核心对象。
- 双声部交叉:两条声部在音高上互相越过对方音区的瞬间,是本表样本的取材语境,决定了表中同一动机可能同时出现在上下两声部。
- 动机族:本节按起首数字序列把样本归为若干族群(如 ‘-2 -3 -2 1’ 系、’-2 -3 1’ 系等),用于归纳跨曲目共享的旋律模式。
- 可选变体(括号数字):在动机序列中以括号标出的音,表示该音并非每次出现,是同类动机内部允许的差异,避免把变体误作固定形态。
- 曲目出处代码:末尾如 Va 15.1、Mi 21.11 的缩写加编号结构,标明该动机所引歌剧与幕场位置;小写字母与 T 标记用于细分同幕同场或序曲中的不同条目。
s7 [描述性拆分] 音级 -2 起始的对称音列
第1段(P0073)
原文复述
b -2 1 b -2 1 b -2 1 b -2 1 c -2 1 d -2 1 f -2 1 g -2 1 g -2 1 -4 a -2 1 -4 -3 -4 f -2 1 -4 -3 1 -2 1 a -2 1 -3 d -2 1 -3 f -2 1 -3 a -2 1 -3 -5 a -2 1 -3 -4 c -2 1 -3 -4 c -2 1 -3 -4 c -2 1 -3 -4 d -2 1 -3 -4
中文讲解
本段是一个不带任何伴随文字的列表,全部由音级字母与一串数字标识组合而成。结合小节标题”[描述性拆分] 音级 -2 起始的对称音列"可知,本段即是该小节所讨论对象在某一具体条件下的完整罗列。
列表呈现的结构性特征如下:
- 每一行都以一个音级字母(b、c、d、f、g、a 中的一个)作为首项;
- 在所有条目中,紧跟音级字母之后的两个数字标识均固定为 “-2 1”,构成一种贯穿全表的共同前缀;这与标题中"-2 起始"的描述相一致——每一序列都以 “-2” 作为其首个数字标识;
- 部分行止于此共同前缀(共 8 行:b -2 1 出现 4 次,再加上 c -2 1、d -2 1、f -2 1、g -2 1),其余条目在此之后继续追加其他数字标识;
- 后续追加的数字标识既复用了前缀中已有的取值(-2、1,如 “f -2 1 -4 -3 1 -2 1” 中再次出现的 “-2 1”),也引入了此前未出现过的取值(-3、-4、-5);
- 列表按行顺序排列,序列长度由两段("-2 1")逐步扩展到五段(最长者为 “f -2 1 -4 -3 1 -2 1”)。
由于原文本身未对 “-2”、“1”、"-3"、"-4"、"-5" 等数字标识给出具体音程或方向上的说明,本讲解仅依据原文所述的序列结构进行解读,不替读者作超出原文的具体音程换算。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节仅包含一段由数字-字母序列构成的列表,无脚注、图示、表格、章节内小标题或边栏文字等附加材料。
💡 本节核心要点
- 本段为一段完整的列表,无正文文字,由 20 行音级字母加数字标识的组合构成;
- 所有序列的共同前缀均为 “-2 1”,与标题中"-2 起始"的限定一致;
- 约一半的序列在 “-2 1” 后即终止,其余序列则继续追加其他数字标识(-3、-4、-5 及对已有取值的复用),形成由短到长的渐次扩展;
- 序列尾部长度从 2 段到 5 段不等,反映出该生成过程在固定起点下不同长度档位的全部结果;
- 原文未提供对各数字标识的具体音程定义,本节仅就其列表结构作忠实解读。
🔑 关键术语
- 音级:本节列表中每一行开头的字母(b、c、d、f、g、a)即为音级记号;在本节语境中用来标识序列所基于的起始元素。
- 对称音列:本节标题中的核心概念,指代由生成过程产出的序列整体;本段列表即是该生成过程在指定起始条件下的具体输出。
- 数字标识(-2、1、-3、-4、-5):列表中跟在音级字母之后的数字,是本节沿用的既有用以构造序列的标识;原文未对其指代内容作进一步说明,故本节讲解不作具体音程或方向的换算。
- 起始:标题"音级 -2 起始的对称音列"中所指的"起始",对应到本段列表即为每一行都以 “-2” 作为首个数字标识。
s8 [描述性拆分] 含 -3、-4、-5 的下行扩展音列
第1段(P0074)
原文复述
f -2 1 -3 -4 g -2 1 -3 -4 g -2 1 -3 -4 1 2 3 1 a -2 1 -3 -2 1 c -2 1 -3 -2 1 -5 b -2 1 -3 -2 1 -3 e -2 1 -3 -2 1 -2 e -2 1 -3 -2 1 -2 -3 -2 b -2 1 -3 2 1 e -2 1 -2 c -2 1 -2 -3 -4 g -2 1 -2 -3’ -4 a -2 1 -2 -3 -4 -5 d -2 1 -2 -3 -4 -5 b -2 1 -2 -3 -4 -5 -4 -3 e -2 1 -2 -3 -4 (-5 -4 -3) a -2 1 -2 -3 -4 -3 c -2 1 -2 -3 -4 -3 c -2 1 -2 1 2 3 1 -2 b -2 1 2
中文讲解
本段以纯符号谱的形式罗列了一批「下行扩展音列」的实例,每一行由一个小写字母(f、g、a、b、c、d、e 之一,用作该音列的起始音或调头标记)后接一串正负整数构成。由于原文没有任何解释性散文,复述必须原样保留这些符号。下面分四点讲清其含义:
一、数字的指代。正负整数代表相对于该行起音的音级步进:负数表示向下扩展(dōng),正数表示向上回行;数字的绝对值就是步进的级数。-2 即比起音低两级,1 即比前一音高一级,-3、-4、-5 则依次是更低的下行级。所以「-3、-4、-5」的出现意味着该音列已经把音域向下拓宽到了起音之下的第三、第四乃至第五级音——这正是本节标题「含 -3、-4、-5 的下行扩展音列」之所指。
二、共有骨架。几乎每一行都以「-2 1」这一对动作开头,意为「从起音先下行两级,再回升一级」,构成一个最小的下行—回返单元;之后才在尾部陆续挂出 -3、-4、-5 等更深的延伸音。这个共有的前两拍结构说明,作者是在一个共同的「基型」之上观察不同曲调各自如何往下铺。
三、扩展方式的多样性。同样的基型尾部可以走得很不一样:最短的只到 -2(如 e -2 1 -2);加入 -3 的较常见(如 g -2 1 -3 -4、a -2 1 -3 -2 1);深入到 -4 的如 c -2 1 -2 -3 -4;最深的达到 -5,如 a -2 1 -2 -3 -4 -5 与 d -2 1 -2 -3 -4 -5。括号中的 (-5 -4 -3)(出现在 e 行)则用括弧标注,说明这一段「-5 -4 -3」是可选的、视具体唱奏版本而定的尾部,不能视作必有的稳定级。带撇号的 -3’(出现在 g -2 1 -2 -3’ -4)则提示此处 -3 的音高有微调或变体,是与裸写 -3 不同的版本——阅读时要把它当作同一个下行位置上的「变体音」而不是「另一个音级」。
四、个别行的特殊走向。多数行只下行不回返,但也有几行在末尾或中间出现正向序列「1 2 3 1」甚至更长的「2 3 1 -2」,如 g -2 1 -3 -4 1 2 3 1、c -2 1 -2 1 2 3 1 -2、b -2 1 2。这些行展示了「下行扩展之后折返上行」的运动,作者把它们与纯下行行并列,说明下行的尾部既能停留在 -5,也能回转上冲至更高的级——回返并不破坏其作为「下行扩展」音列的身份,因为整段的方向重心仍是向下铺开。
综上,本段是一份纯实证材料:它不带议论,只是把不同曲调里出现的「下行扩展音列」按行列出,让读者自己比对共同骨架与不同尾部的差异;标题里的 -3、-4、-5 三个级数正是靠这种逐行罗列才得以坐实。
补充说明
无额外补充。补充信息只能来自本段提供的符号;本段不含任何可定位的解释性文字,故不另作外部补注。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节只含一个符号谱段落 P0074,无脚注、无插图说明、无边栏文字;标题本身(第 8 节「含 -3、-4、-5 的下行扩展音列」)是该段落唯一的导引性文字。
💡 本节核心要点
- 全节以「小写字母 + 正负整数」的简谱式符号逐行列出下行扩展音列,行与行之间无散文叙述。
- 几乎每一行都以「-2 1」开头,构成共有的基型——先从起音下行两级再回弹一级。
- 扩展的深度由尾部出现的 -3、-4、-5 标识:-3 是较浅的扩展,-4 进一步下行,-5 达到最深的下行位置,正是节标题所标范围。
- 变体标记:「-3’」表示 -3 这一下行位置的变体音高;括号 (-5 -4 -3) 表示该尾部为可选片段,非必有的稳定级。
- 少数行在末尾出现 1 2 3 1 或更长的回返序列(如 b -2 1 2),表明下行扩展之后可折返上行,整段仍属于下行扩展范畴。
- 本节的功能是为前文理论提供具体的曲调实例佐证:通过并排罗列展示同一基型下的多种尾部形态。
🔑 关键术语
- 下行扩展音列:本节标题中的核心术语,指在某一基型(如 -2 1)的基础上,把音域继续向下铺开至 -3、-4 甚至 -5 级的旋律序列;「扩展」即指尾部加挂的更深的下行级数。
- -2 1(基型单元):几乎所有行的开头结构:先比起音下行两级,再回升一级,构成本节观察的共有最小骨架。
- -3 / -4 / -5:分别表示比起音低三、低四、低五的下行音级;其出现与否及出现次序决定每条音列的扩展深度,正是节标题所说的「含 -3、-4、-5」。
- -3’(带撇号变体):出现在 g -2 1 -2 -3’ -4 中,表示该 -3 位置的音高为变体音,与一般 -3 略有差异,需视具体曲调版本而定。
- (-5 -4 -3)(括弧):出现在 e 行尾部,表示这一串 -5 -4 -3 是可选片段而非稳定级,阅读时不能当作必有音处理。
- 回返序列 1 2 3 1:少数行(如 g、c)在下行扩展之后再正向连续上行三度再折回的运动,表明下行扩展并不排除尾部的回返上冲。
s9 [描述性拆分] 以 2 1 2 起始的循环片段集合
第1段(P0075)
原文复述
c -2 1 2 d -2 1 2 d -2 1 2 -2 -2 -2 1 2 d -2 1 2 -2 1 2 1 -2 d -2 1 2 -2 1 2 3 4 g -2 1 2 1 d -2 1 2 1 -2 -3 f -2 1 2 1 -2 -3 -4 -3 c -2 1 2 1 -2 -3 -2 -4 d -2 1 2 1 -2 -2 -3 -2 b -2 1 2 1 -2 1 d -2 1 2 1 -2 (1 -2) d -2 1 2 1 -2 1 2 -2 d -2 1 2 1 2 -2 -3 b -2 1 2 1 2 3 d -2 1 2 1 2 3 d -2 1 2 1 2 3 b -2 1 2 1 2 3 2 3 f -2 1 2 1 2 3 2 3 a -2 1 2 3
中文讲解
本段是一份纯列表式的音程片段目录,共 20 行,全部以 “-2 1 2”(先下行 2,再上行 1,再上行 2)开头,对应小节标题所称的"以 2 1 2 起始的循环片段"。每条记录由两段构成:行首的小写字母(a、b、c、d、f、g,未出现 e)作为类别标签,仅起分类记号作用;其后的整数串以正负号表示音程的上行或下行、以绝对值表示音程量级,括号 “(1 -2)” 则将一组音程括起,区别于其他位置。从结构看,目录按片段长度可分为若干簇:最短的两行(“c -2 1 2”、“d -2 1 2”)只保留核心三音动机;中段各行在核心动机之后追加 1 至 4 个音程,使片段长度扩展到 5 至 8 个音程;末尾几行(“d -2 1 2 1 2 3” 等重复项以及 “b -2 1 2 1 2 3 2 3”、“f -2 1 2 1 2 3 2 3”)呈现同一序列在不同类别下的同形重复与延伸。整段并不解释这些片段的音乐功能,而只是把符合"以 -2 1 2 开头"这一形式特征的实例集中陈列,构成"描述性拆分"这一节的具体材料。
补充说明
本段中各行的字母标签在原文中未作显式定义;数字串的具体单位(半音、音级或其他相对音程)原文亦未说明,本节按相对音程处理。括号 “(1 -2)” 仅出现在第 12 行,提示该位置上的音程组与上下文中其他不带括号的并列项在记谱上有所区分。
脚注 / 边栏 / 图表 / 附加信息(如有)
无(本小节无脚注、图表、边栏或外部附加材料)。
💡 本节核心要点
- 本节以纯列表方式给出 20 条共享同一开头 “-2 1 2” 的片段,是"描述性拆分"所汇集的具象材料。
- 每条记录由一个分类字母(a、b、c、d、f、g 六类,无 e)与一组带正负号的相对音程数字串组成。
- 片段长度由 3 个音程到 8 个音程不等,呈现核心动机在不同扩展程度下的多种具体实现。
- 同一序列(如 “-2 1 2 1 2 3”)可在不同类别标签下多次出现,表明分类标签与音程内容正交。
- 括号 “(1 -2)” 仅出现一次,是本段内唯一的特殊记谱处理,提示该音程组的不同身份。
🔑 关键术语
- 循环片段(looping fragment):小节标题用语,指被归在同一形式特征下的短旋律/音程单位;本节中具体指以 “-2 1 2” 开头的所有条目。
- 描述性拆分(descriptive breakdown):小节标题中的方法学标签,意为按统一形式特征将相关片段归类并逐条列示,而非进行统计或评价。
- 相对音程序列(relative-interval sequence):本段每行除首字母外的数字串,以正负号表示上行或下行,以绝对值表示音程量级。
- 分类字母(class letter):本段每行行首的小写字母(a、b、c、d、f、g),作为片段的类别标识,本节内未给出显式定义。
s10 [描述性拆分] a -2 1 2 3 主题家族及变体
第1段(P0076)
原文复述
a -2 1 2 3 Mi 38.2 a -2 1 2 3 Va 2.3 b -2 1 2 3 Mi 18.5 d -2 1 2 3 Mi 20.2 d -2 1 2 3 Mi 23.11 d -2 1 2 3 Mi 36.8 d -2 1 2 3 Va 19.1 e -2 1 2 3 Fu 8.5b e -2 1 2 3 Mi 15.6 g -2 1 2 3 Fu 21.3 g -2 1 2 3 Mi 29.10 d -2 1.2 3'1 Mi 1.3 g -2 1 2 3 1 Va 10.4 a -2 1 2 3 (2) Da 13.4 a -2 1 2 3 2 Va 5.3 a -2 1 2 3 2 -2 1 Mi 39.10 g -2 1 2 3 2 1 Mi 20.12 f -2 1 2 3'2 1 -2 -3 Mi 11.2 e -2 1 2 3 2 1 -2 1 Mu 10.3 d -2 1 2 3 2 1 1 -2 Mu 9.4
中文讲解
本段是一份纯粹的目录式列表,逐条罗列属于"a -2 1 2 3"主题家族的变体,每条由两部分组成。
第一部分是音级公式,采用简化的音级记谱法:字母 a、b、d、e、f、g 表示旋律起始的音高位置或调式中心;数字 1、2、3 代表音级(do、re、mi),其中"-2"表示向下进行一个二级音程,构成下助音式回旋;带撇号的数字(如 3'1、3'2)暗示升高的变化音;括号中的数字(如 (2))通常表示该音的重复、倚音或八度叠置;点号(如 1.2)暗示两个音级的紧邻衔接。
第二部分是手稿出处标识:Mi、Va、Fu、Da、Mu 是不同手稿或文献的规范简称(sigla),其后的数字为页码或曲目编号(如 38.2 表示第 38 页第 2 例,8.5b 中的 b 指同一页内的 b 小节或 b 条)。
从结构看,这份目录大致可分几组:前 11 条为基本型"音头 -2 1 2 3",仅起始音不同;第 12 至 13 条在基本型后加入一个额外的 1;第 14 至 15 条加入 2 或 (2);最后 6 条则是更长、更装饰化的展开形态,并出现了变化音 3’ 和下行片段 -2、-3。这种由短至长、由简至繁的排列,反映出作者通过"描述性拆分"(即将同一旋律骨架在不同语境下的所有形态逐条列出)来揭示该主题家族内部的变异谱系,让读者能直观比较各手稿版本的异同。
补充说明
本段没有正文叙述,仅由公式与出处标签组成。所有可解读的信息均限定在条目本身:起始音字母的差异(如 a 与 d 出现在不同手稿)说明同一旋律骨架可移植到不同调高;Mi 出处最频繁(10 次),Va、Fu 各 3 次,Da 与 Mu 各 1 次,提示 Mi 是该主题最集中的来源,但具体手稿名称需回原书图例或凡例确认。
脚注 / 边栏 / 图表 / 附加信息(如有)
无。本节仅含一组按行排列的主题条目与出处标签,未出现脚注、图表说明或边栏。
💡 本节核心要点
- 本段是一份以行排列的主题家族目录,共 20 条,均归属 “a -2 1 2 3” 主题家族
- 每条以"音级公式 + 手稿编号"两行格式书写,公式侧聚焦旋律形态,手稿编号侧指示出处
- 目录由最简的"起始音 + -2 1 2 3"三音基本型,逐步加入附加音 1、2 以及变化音 3’ 和下行尾缀,呈现由短至长的变体谱系
- 起始音在 a、b、d、e、f、g 间变换,说明该旋律骨架可在不同调高间转用
- Mi 出处出现频率最高,是该主题家族的最主要文献来源;Va、Fu、Da、Mu 也各保留若干版本
- “描述性拆分"意在把同一旋律内核在不同语境下的所有具体形态并列展示,使读者可逐条对比差异
🔑 关键术语
- 主题家族 (theme family):指共享同一核心旋律骨架(如本节的 “-2 1 2 3”)但起始音、调高、装饰或延伸各异的一组相关旋律,在本节中以并列条目形式罗列其所有已发现的变体。
- 音级记谱 (scale-degree notation):用数字 1–7 代表音级、用前置负号表示下行、用撇号表示升高的简化记谱方式;本节中字母 a–g 表示起始音高或调式中心,括号与点号表示紧邻衔接或重复。
- 手稿编号 (manuscript sigla):Mi、Va、Fu、Da、Mu 等大写两字母组合作为不同手稿的简称,其后的数字(及 b 后缀)对应页、曲目或条目的定位信息。
s11 [描述性拆分] 五声与六声上行的音阶骨架
第1段(P0077)
原文复述
g -2 1 2 3 4 Da 19.1 c -2 1 2 3 4 3 Mi 15.9 e -2 1 2 3 4 3 Fu 25.4b a -2 1 2 3 4 5 Mi 36.6 c -2 1 2 3 4 5 Va 4.4 d -2 1 2 3 4 (5) Na 8.9 e -2 1 2 3 4 5 Fu 12.4 f -2 1 2 3 4 5 Mi 38.9 g -2 1 2 3 4 5 Da 19.4 g -2 1 2 3 4 5 Mi 21.6 c -2 1 2 3 4 5 4 2 Mi 3.2 g -2 1.3 2 Fu 9.3 b -2 2 -2 1 -5 Fu 15.4 a -2 2 1 -2 1 Fu 11.1 f -2 2 3 4 3 Mi 23.4 d 1 -5 -3 -2 1 Da 11.4 d 1 -5 -3 -2 1 Da 14.3 e 1 -5 1 1 -2 -3 -4 Fu 7.1 c 1 -3 -2 1 Lo 1.1 a 1 -3 -2 1 -5 Da 18.3
中文讲解
本段是一个公式表,每行采用统一的四段式记录:起始音字母(g、c、e、a、d、f、b 等,用作主音标记)→ 一串带正负号的音级数字(描述音高运动序列)→ 一个由两个字母组成的音节代号(Da、Mi、Fu、Va、Na、Lo 等,作为公式名称)→ 末尾带小数点和可选小写后缀的编号(19.1、15.9、25.4b 等,用作乐例引用索引)。
前 11 行集中展示了与本节标题"五声与六声上行骨架"直接对应的核心模板:序列「-2 1 2 3 4」包含 -2、1、2、3、4 共 5 个音级,是五声上行骨架;序列「-2 1 2 3 4 5」在此基础上多一个第 5 度,是六声上行骨架。第 2、3 行的「-2 1 2 3 4 3」在第 4 度后回落到第 3 度,是六声骨架的返回变体;第 6 行的「d -2 1 2 3 4 (5) Na 8.9」用括号明确把第 5 度标为可选;第 11 行的「c -2 1 2 3 4 5 4 2」则在六声骨架后再下行到 2 度,显示同一骨架可在尾部进一步扩展。这一组通过更换主音(g、c、e、a、c、d、e、f、g)反复出现同一骨架,说明这些骨架在该体系中是作为可平移的旋律模板使用的。
第 12 行起出现更多异型。第 12 行「g -2 1.3 2」中的「1.3」用小数形式,与上下文中其他整数写法不一致,疑为位于第 1 度与第 3 度之间的特殊音级或谱例内部编号;第 13 行「-2 2 -2 1 -5」呈锯齿状上下行;第 14、15 行的「-2 2 1 -2 1」与「-2 2 3 4 3」包含从 -2 跳到 2 度的大跳轮廓。第 16–18 行从主音「1」起头,「1 -5 -3 -2 1」是一段下行至下方 5 度再逐步回到主音的弧形;第 18 行「1 -5 1 1 -2 -3 -4」还在该弧形内部重复回到主音 1,并再次下行展开。第 19、20 行的「1 -3 -2 1」与「1 -3 -2 1 -5」是更短的下行—回程轮廓。
总体看,本段前 11 行即是本节标题所指的"五声 / 六声上行骨架"的多主音实例;其后 9 行虽仍属同一公式表,但不再严格上行,而是下行弧形与带返回的混合轮廓,说明该体系允许「上行骨架」与「下行 / 弧形公式」并列收录。不同的音节代号(Da、Mi、Fu、Va、Na、Lo)把形态相近但仍有区别的公式分别归入各自的公式名下。
补充说明
本段中数字前的负号 “-” 表示低于主音的音级;括号 (5) 标记该音级在该公式中为可选出现;「1.3」与上下文中其他整数写法不同,其具体含义在当前输入中未给出,仅可据上下文推断为特殊音级或编号记号。
第2段(P0078)
原文复述
d 1 -3 -2 1 -5 Pi 24.1 a 1 -3 -2 1 -5 -4 -5 Pi 3.1 a 1 -3 -2 1 -5 -4 -5 Pi 3.1b a 1 -3 -2 1 -5 -4 -5 Pi 3.1d f 1 -3 -2 1 -4 Pi 19.1 d 1 -3 -2 1 1 -3 -3 Na 2.4 c 1 -3 -2 1 2 1 Da 21.3 f 1 -3 -2 1 2 3 4 4 Mu 21.1 c 1 -3 1 2 1 Va 26.1 a 1 -3 2 Fu 21.2 a 1 -3 2 -2 1 -5 -2 -3 Fu 26.1 d 1 -2 -4 -3 -2 1 2 1 Mi 21.1 f 1 -2 -3 Fu 22.3 f 1 -2 -3 Vi 30.1 a 1 -2 -3 -5 Pi 2.1 d 1 -2 -3 (-4) Da 14.4 d 1 -2 -3 -4 Fu 11.8 a 1 -2 -3 -4 -5 Va 18.2 g 1 -2 -3 -4 -5 Da 5.5 a 1 -2 -3 -4 -3 -2 Vi 18.1
中文讲解
本段是上一段公式表的延续,行的四段式格式保持不变。本段最显著的结构特点是:所有公式都把开头的「1」(主音)显式写出,再向下展开。这与上一段前 11 行以「-2」开头、上行到达主音的写法形成对照,可视为同一上行骨架的具体下行—回程实现方式。
第一组(第 1–5 行)共有前缀「1 -3 -2 1」:从主音下行至下方小三度(-3),再上行半步回到下方二度(-2),再回到主音。第 1 行末尾再下行到 -5;第 2–4 行的音级序列完全一致(主音 a,序列 1 -3 -2 1 -5 -4 -5),仅引用编号分别记为 3.1、3.1b、3.1d,应为同一公式在不同乐例或不同演唱版本中的并置收录;第 5 行「1 -3 -2 1 -4」是同一前缀的较短截断。
第二组(第 6–9 行)把「1 -3 -2 1」之后继续展开。第 6 行「1 -3 -2 1 1 -3 -3」重复主音 1 之后再下行;第 7 行「1 -3 -2 1 2 1」上跳到 2 度后又回落;第 8 行「1 -3 -2 1 2 3 4 4」进一步上行至 4 度并重复 4 度;第 9 行「1 -3 1 2 1」跳过 -2,直接从 -3 回到主音再上行到 2 度。
第三组(第 10–11 行)以更简洁的「1 -3 2」起头。第 10 行只下行到 -3 再上跳到 2 度;第 11 行「1 -3 2 -2 1 -5 -2 -3」在上跳 2 度后再次下行至 -2、回主音、再下行至 -5、再回 -2、再下行至 -3,是本段中最长的下行—上跳—再下行复合轮廓。
第四组(第 12–20 行)的开头改为「1 -2」,即下行至下方二度而非下方三度,与前三组的「1 -3」开头相区别。第 12 行「1 -2 -4 -3 -2 1 2 1」先下行到 -4 再逐步上行回主音再上跳到 2 度回落;第 13、14 行的「1 -2 -3」是本段最短的轮廓;第 15 行「1 -2 -3 -5」在 -3 之后再下行到 -5;第 16 行「1 -2 -3 (-4)」用括号把 -4 标为可选;第 17 行「1 -2 -3 -4」明确写入 -4;第 18、19 行「1 -2 -3 -4 -5」是前者的进一步扩展;第 20 行「1 -2 -3 -4 -3 -2」则在到达 -4 后又向上回程到 -3、-2。
本段公式的音节代号扩展为 Pi、Na、Da、Mu、Va、Fu、Vi 七类,且同一代号下可有不同主音字母或同一主音下的多个编号后缀(b、d),表明在该体系中,公式名不绑定主音,同一公式可通过更换主音或在不同乐例中重复出现。
补充说明
本段第 2–4 行三条公式的主音均为 a、音级序列完全相同,仅以引用编号 3.1、3.1b、3.1d 区分,应为同一公式在不同乐例(或不同版本)下的并置收录。括号 (-4) 含义与上一段括号 (5) 相同,标记该音级为可选出现。
脚注 / 边栏 / 图表 / 附加信息(如有)
无额外图表或脚注说明。
💡 本节核心要点
- 本节由两段公式表组成,每行均按「主音字母 + 音级序列 + 双字母音节代号 + 引用编号」统一格式记录一条旋律公式。
- P0077 前 11 行集中呈现以「-2 1 2 3 4」(五声)与「-2 1 2 3 4 5」(六声)为主体的上行骨架,并通过更换主音字母(g、c、e、a、d、f、b)反复展示同一骨架的可平移性。
- 上行骨架在 P0077 中存在多种变体:带返回的「-2 1 2 3 4 3」、带可选 5 度的「-2 1 2 3 4 (5)」、尾部扩展的「-2 1 2 3 4 5 4 2」,以及含特殊记号「1.3」的「-2 1.3 2」。
- P0077 后 9 行与 P0078 全部 20 行均以主音「1」开头,先下行再回程(如「1 -3 -2 1」、「1 -5 -3 -2 1」),说明该体系把上行骨架与其下行—回程的具体实现形式并列收录。
- 音节代号 Da、Mi、Fu、Va、Na、Lo、Pi、Mu、Vi 是把形态相近的公式归入不同公式名的标签;同一代号下可有不同主音或同一主音下的多个编号后缀(如 3.1、3.1b、3.1d),用以区分乐例或版本。
- 编号(19.1、15.9、25.4b 等)属于引用索引体系,括号、小数点(如 1.3)与后缀(b、d)是其内部区分乐例或版本的标记符号。
🔑 关键术语
- 上行骨架:本节标题所指的核心概念;指公式中由低到高排列的音级序列,是旋律的基本音列结构。本节以五声(-2 1 2 3 4、1 2 3 4 5)与六声(-2 1 2 3 4 5)为典型骨架。
- 音级数字(含正负号):以主音为 1,正数表示高于主音的音级,负数表示低于主音的音级。例如 -2 为下方二度,-5 为下方五度,-3 为下方三度。
- 音节代号:每条公式末尾的两个字母(Da、Mi、Fu、Va、Na、Lo、Pi、Mu、Vi 等)作为公式名称标签使用,把形态相近但有区别的旋律归入各自的公式名下。
- 引用编号:公式行末的带小数点数字(19.1、15.9、25.4b 等)以及可选后缀 b、d,是该体系内部标记乐例或版本位置的索引。
- 括号音级:如 (5)、(-4) 等用括号包裹的音级数字,标记该音级在该公式中为可选出现,未必在所有乐例中都实际奏出。
s12 [描述性拆分] 含下五度与转位的复杂音列
第1段(P0079)
原文复述
原段落为不含自然语言论述的列表,共21行,每行由三部分构成:行首的一个小写字母;其后一串正、负整数(部分整数前紧邻一个英文句点;其中一行内含一对圆括号括起的数字片段);行末的两个大写字母加形如“数字.数字”的编号。逐行原文如下:
c 1 -2 -3 -4 -3 1 -2 Va 11.1 e 1 -2 -3 -4 1 -2 -3 -3 Fu 9.6 c 1 -2 -3 -4 1 -2 -3 -2 Na 11.4 b 1 -2 -3 -2 1 Mi 33.14 c 1 -2 -3 -2 1 Mi 36.11 f 1 -2 -3 -2 1 -2 1 Va 29.1 f 1 -2 -3 1 -4 -2 1 2 Pi 20.1 b 1 -2 -3 1 -2 -3 -4 -5 Va 19.3 d 1 -2 -3 . 2 2 1 -2 -3 Fu 7.3 a 1 -2 1 Na 8.3 c 1 -2 1 Va 31.2 a 1 -2 . 1 -5 1 -2 -4 -3 Va 20.2 c 1 -2 1 (-3 -4) Fu 20.9 d 1 -2 1 -3 -4 Da 18.4 f 1 -2 1 -3 -4 Pi 19.2 f 1 -2 1 2 1 -2 1 Va 28.1 f 1 -2 1 2 1 1 Na 12.1 g 1 -2 1 2 1 3 2 Fu 9.1 d 1 -2 1 2 .3 Da 2.1 d 1 -2 1 2 .3 Fu 43.3 c 1 -2 1 2 .3 .4 .5 .4 Va 22.3
中文讲解
本段全部由数据列表组成,作者没有写任何自然语言论述、论证或例说,因此所谓的“复述”实质上就是把21行材料原样保留。
关于这些条目究竟代表什么,作者在本段中并未给出任何文字解释,所有可能的解读都来自小节标题“含下五度与转位的复杂音列”以及读者对本书体例的常识推断——以下三点均明确标记为讲解者推断,非作者原文表述:
- 行首的小写字母(a、b、c、d、e、f、g)可能标记某一音级或某类音列的起始;
- 紧跟其后的正、负整数序列可能是音程级数(pitch-class intervals)的一维表示,正负号可能表示方向;
- 行末“两个大写字母 + 数字.数字”(如 Va 11.1、Fu 9.6、Na 11.4、Mi 33.14、Pi 20.1、Da 18.4)格式高度规整,更像是指向本书其他位置或附表的索引缩写,而非音乐内容本身的成分。
上一版讲解中曾出现的“下五度相当于 −7”“转位是上下行方向反转”等具体对应关系,必须强调:这些并非出自本段文字,而是小节标题加讲解者对音列分析惯例的联想;本段范围内作者没有给出这类技术说明,因此不能把它们当作原意陈述。
本段中还有三处排印细节,讲解者只能做观察,不应冒充作者定义(同样明确标记为讲解者观察,非作者结论):
- 部分整数前紧邻一个句点(如 “ . 2”“ . 1”“ .3”“ .3 .4 .5 .4”),含义未明;
- 圆括号 “(-3 -4)” 仅在一行中出现,括起两个负整数,功能未明;
- 行末缩写出现六种(Va、Fu、Na、Mi、Pi、Da),且同一缩写可对应多个不同编号(例如 Va 出现 11.1、29.1、19.3、31.2、20.2、28.1、22.3 等),这一点更支持“索引”的推测,但该推测本身仍不是作者在本段写明的内容。
作为本小节唯一的一段,本段的功能是为整张示例表提供条目材料,本身不展开任何论证;它在小节整体论证中的意义,须结合小节标题及前后文(讲解者当前不可见)来补足。
补充说明
本段范围内可直接确认的事实只有:共21行;行首字母取自集合 {a, b, c, d, e, f, g};数字序列中既有正整数也有负整数;句点仅作为数字前缀出现,未单独成行;圆括号仅出现一次并括起两个负整数;行末出现 Va、Fu、Na、Mi、Pi、Da 共六种大写字母缩写,且每种缩写对应多个不同编号。除此之外,关于“这些符号代表什么”“句点或括号意味着什么”“行末缩写展开后指向哪部作品的哪个位置”的任何说明,均不在本段文字范围内。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节仅含一段(P0079),且该段本身仅为示例列表,未附脚注、图例、附录或版面说明。
💡 本节核心要点
- 本小节唯一一段 P0079 全部由21行数据构成,作者没有写任何自然语言论述
- 每行结构统一:行首小写字母(a–g)+ 正负整数序列(含句点前缀与一处圆括号片段)+ 行末两个大写字母加数字.数字编号
- 小节标题“含下五度与转位的复杂音列”提示这些条目的类别,但该对应关系由讲解者推断,原段落本身未定义
- 行末共有六种缩写(Va、Fu、Na、Mi、Pi、Da),且同一缩写对应多个不同编号,更像索引而非固定类别名(讲解者推断)
- 本段中出现的句点前缀记号和唯一的一处圆括号片段,均未在本段内被作者解释,应视为未定义的排印细节
🔑 关键术语
- 行首小写字母(a–g):本节列表中每行起首的字母;本段未定义其含义,讲解者据小节标题语境推测为某一音级或某类音列的起始标记
- 正/负整数序列:本节列表中行首字母之后的一串数字;本段未定义,讲解者据标题语境推测为音程级数或音列的一维表示,正负号可能表示方向
- 行末两个大写字母加编号(如 Va 11.1):本节列表中每行末尾的固定格式;本段未解释其含义,讲解者据格式特征推测为指向本书其他位置或附表的索引缩写
- 数字前的句点:本节列表中出现在少数整数紧邻位置的句点记号;本段未定义,含义不可在本段内确定
- 圆括号片段 (-3 -4):本节列表中仅出现一次、括起两个负整数的圆括号片段;本段未定义其功能
s13 [描述性拆分] 含 1 1 -2、1 1 -5 等特殊起音序列
第1段(P0080)
原文复述
g 1 -2 1 3 2 a 1 -2 3 1 -2 d 1 -2 3 2 c 1 -2 3 2 3 2 d 1 -2 3 4 5 3 6 5 g 1 1 -5 d 1 1 -5 1 2 a 1 1 -4 -3 -2 a 1 1 -3 -2 1 d 1 1 -3 -2 1 e 1 1 -3 -2 1 f 1 1 -3 -2 1 c 1 1 -3 1 2 1 -2 d 1 1 -2 -5 -3 -4 f 1 1 -2 -4 -3 -2 1 f 1 1 -2 -4 -3 -2 1 g 1 1 -2 -4 -3 (-2 1) d 1 1 -2 -4 -2 -3 -4 g 1 1 -2 -4 1 -2 1 -2 a 1 1 -2 -3
中文讲解
本段没有解释性文字,仅由 20 行简谱数字序列构成。结合小节标题「描述性拆分:含 1 1 -2、1 1 -5 等特殊起音序列」,可知作者在此把若干旋律片段的起首若干音逐音拆开,用数字 + 空格的形式线性罗列,以备后续比较与归类。
每一行可拆成两个部分:
- 行首的小写英文字母 g、a、c、d、e、f,在本段中只充当序列编号 / 分类标签,本身不带音高含义,也不参与后续数字的计算;
- 其后的整数串以空格分隔,是带正负号的简谱记写:正数表示起始音上方的相对音级,负数表示起始音下方的相对音级。
从第 1 行到第 20 行可以读出两条结构性观察:
- 前 5 行(g、a、d、c、d 五行)以「1 -2」起首,即先停在 1,紧接着向下跳入 -2;
- 第 6 行起的 15 行改以「1 1 -X」起首,即先在 1 上重复一次,再向下跳到 -X。
在「1 1 -X」一类中,X 的取值覆盖了 -5、-4、-3、-2 四个等级:
- -5 出现在第 6、7 行(g 1 1 -5;d 1 1 -5 1 2);
- -4 出现在第 8 行(a 1 1 -4 -3 -2);
- -3 出现在第 9–13 行(a / d / e / f / c 五条);
- -2 出现在第 14–20 行(d / f / f / g / d / g / a 七条)。
这种穷举式的整理方式,正是小节标题「描述性拆分」所提示的方法:不直接给出结论,而是把同一类起音形态按下行跳进幅度逐一摊开,留给读者对照。最后一行 g 1 1 -2 -4 -3 (-2 1) 中出现的圆括号是整段唯一的特殊标记,作者用它把 -2 1 这一对音与正式音列隔开,提示该片段在原谱中可能属于倚音、加花或可选音符,需要在分析时区别处理。
整段只起「语料陈列」作用,其分析结论要回到本节正文中其他位置或前后段落方能完成。
补充说明
本段中唯一带括号的条目是第 17 行「(-2 1)」,括号内紧接在前一音 -3 之后;其他行均不使用括号,因此这一括号是段落内部唯一提示「该组合或为非正式音列」的标记,需读者特别注意。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段不含脚注、图表、边栏文字或图例说明,全部为纯简谱数字行;其中第 17 行的圆括号「(-2 1)」是段落内唯一带括号标记的条目,可能用于在分析时将该组合与正式音列区分开来。
💡 本节核心要点
- 本段是小节标题「描述性拆分」的语料呈现,整段仅由 20 行简谱数字序列构成,没有附带的解释性文字。
- 行首字母 g、a、c、d、e、f 在本节中只作为序列编号或分类标签使用,不进入音高计算与音乐解释。
- 前 5 行采用「1 -2」起首,后 15 行采用「1 1 -X」起首,构成同一类材料的两种起音变体。
- 「1 1 -X」中 X 的取值覆盖 -5、-4、-3、-2 四种下行跨度,作者以此穷举整理不同跳进幅度的起音实例。
- 第 17 行圆括号「(-2 1)」是段落内唯一特殊标记,提示该组合在原谱中可能为倚音、加花或可选音符,需区别于正式音列。
- 本段只起语料库式的对照清单作用,最终的分析判断需结合小节正文及上下文其他段落完成。
🔑 关键术语
- 简谱(jianpu):以数字 1–7 代表大调七个音级的记谱法;本段在数字前加正负号,用以标记该音相对于起始音的上方或下方位置。
- 起音序列:指一段旋律最初若干音的排列方式;本节专门整理包含「1 1 -2」「1 1 -5」之类特殊起始形态的若干实例。
- 描述性拆分:小节标题用语,指把起音序列中每个音的相对位置(如 -2、-4、-5)逐一拆出、线性列出以供对照,而非直接给出理论结论。
- 行首字母标签:本段每行开头的 g、a、c、d、e、f 仅充当序列编号或分类标记,不参与音高计算,也不在本节中具有额外音乐含义。
s14 [描述性拆分] g 1 1-2 … 的下行变格音列
第1段(P0081)
原文复述
g 1 1-2 -3 -4 -4 -5 a 1 1-2 -3 -4 -3 -3 -3 g 1 1-2 -3 -2 1-4 d 1 1-2 -3 1-2 1 a 1 1-2 -3 2 r-2 g 1 1-2 -2 -3 -4 -3 a 1 1-2 -2 1 2 d 1 1-2 1 a 1 1-2 1-3 -4 d 1 1-2 1 2-4 d 1 1-2 1 2 3 1 3 d 1 1-2 2 c 1 1-2 2 1-2 -3 a 1 1 2 e 1 1 2-2 1-2 -3 -2 d 1 1 2-2 1 2 a 1 1 2-2 2 1 e 1 1 2 1 f 1 1 2 1-3 c 1 1 2 1 (-3 -2 1) Va 7.1 Va 21.1 Mi 23.1 Va 20.1 Fu 13.1 Fu 43.1 Va 33.1 Va 17.2 Fu 46.1 Fu 8.1 Fu Duo.1 Fu 37.1 Fu 47.1 Fa 1.3 Va 5.1 Pi 16.2 Fu 3.1 Mi 9.4 Da 17.3 Da 5.4
中文讲解
本段是一份下行变格音列的音级公式与对应曲例索引的对照清单,是第 14 小节标题 [描述性拆分] g 1 1-2 … 的下行变格音列 所给出的全部具体变体的罗列。
前 20 行是音级公式。每行以小写英文字母(g、a、d、c、e、f)开头,这些字母指明该公式所归属的调式或终结音类别;字母之后的数字串记录音级进行,“1” 通常代表主音/终结音,“2” 代表终结音上方邻音,前置连字符 “-” 表示下行一步。
从公式形态上看,作者把同一类下行变格音列按照"起始音级"与"终止位置"两个维度展开:
- 起始部分多数公式都以 “1-2” 开头,表明变格音列以上方邻音(2 级)下行进入的模式反复出现;
- 公式按音级组合的不同延伸方式,呈现 “1-2 -3 -4 -4 -5”、“1-2 -3 -4 -3 -3 -3”、“1-2 -3 -2 1-4”、“1-2 -3 1-2 1”、“1-2 -3 2 r-2” 等不同结尾;其中 “r-2” 中的 r 标记一次还原或回到 2 级,”(-3 -2 1)" 括号中的片段表示该段落为可选或仅在部分实例中出现。
- 公式按起始字母分布:g 系 3 条、a 系 5 条、d 系 6 条、c 系 2 条、e 系 2 条、f 系 1 条,d 与 a 出现频次最高,说明这两类是实证中最常出现的变格音列模式。
后 21 行是与上方公式一一对应的曲例引用,编号形式如 “Va 7.1”、“Mi 23.1”、“Fu 13.1”、“Da 17.3” 等。缩写 Va、Fu、Mi、Fa、Pi、Da、Fai 应为不同曲调集成或语料库的出处代码,数字与小数点指示卷次和条目位置,与前 20 条公式逐一对应,构成"公式—实证曲例"的双栏索引。
本段的论证意义在于:作者不再仅给出抽象的"下行变格音列"理论描述,而是把所有可观察到的实证变体穷尽列出,并以曲例位置佐证,从而把抽象规则落地为可核对的音级公式集合。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段末尾的曲例索引(Va、Mi、Fu、Fa、Pi、Da 等)与上方公式逐条对应,属于"公式—曲例"对照表的实证支撑部分,本身不展开音乐本体讨论。
💡 本节核心要点
- 本段是小节标题"下行变格音列"的全部分解公式与曲例索引的并列罗列
- 前 20 行为音级公式,以小写字母 g/a/d/c/e/f 区分调式终结音,数字 1 为主音,连字符 “-” 表示下行
- 公式以 “1-2” 开头居多,体现"变格以上方邻音下行进入"这一核心特征
- 括号 (-3 -2 1) 表示可选片段,r-2 中的 r 标记还原或回到 2 级
- d 系 6 条、a 系 5 条,是公式中出现频次最高的调式类别
- 后 21 行为曲例编号(Va、Fu、Mi、Fa、Pi、Da 等),与公式一一对应,提供实证出处
🔑 关键术语
- 下行变格音列:以终结音上方邻音(2 级)下行进入、并以不同方式延伸或终止的音级进行模式,是本节标题所定义的核心分析对象。
- 音级公式:以小写字母标记调式/终结音类别、以数字 1、2、3 等表示音级位置,前置连字符 “-” 标记下行一步的记写形式。
- 曲例索引(Va、Fu、Mi、Fa、Pi、Da 等):对应不同曲调集成或语料库的出处代码,由缩写加上卷次与条目号构成,与上方音级公式逐一对照。
- r 标记:出现在 “r-2” 这类公式中,提示此处为一次还原或回到 2 级音的特殊音级处理。
s15 [描述性拆分] 1 1 2 1 2 … 的复合音列
第1段(P0082)
原文复述
g 1 1 2 1 -2 2 -4 d 1 1 2 1 1 -2 -3 f 1 1 2 1 1 -2 -3 -4 c 1 1 2 1 1 2 4 2 e 1 1 2 1 2 -2 -3 e 1 1 2 2 1 2 3 4 d 1 1 2 2 3 f. 1 1 2 3 f 1 1 2 3 1 2 3 2 a 1 1 2 3 1 2 3 4 d 1 1 2 3 4 5 3 -4 d 1 1 .3 1 .3 4 5 g 1 1 4 3 2 g 1 1 4 3 2 (1) b 1 1 4 3 2 1 -2 a 1 1 4 3 2 3 4 g 1 1 5 4 3 c 1 2 -4 1 -2 -3 -4 -5 d 1 2 1 -3
中文讲解
本节只给出十九行数据,没有任何伴随说明文字,逐行复述如下:
g 1 1 2 1 -2 2 -4 d 1 1 2 1 1 -2 -3 f 1 1 2 1 1 -2 -3 -4 c 1 1 2 1 1 2 4 2 e 1 1 2 1 2 -2 -3 e 1 1 2 2 1 2 3 4 d 1 1 2 2 3 f. 1 1 2 3 f 1 1 2 3 1 2 3 2 a 1 1 2 3 1 2 3 4 d 1 1 2 3 4 5 3 -4 d 1 1 .3 1 .3 4 5 g 1 1 4 3 2 g 1 1 4 3 2 (1) b 1 1 4 3 2 1 -2 a 1 1 4 3 2 3 4 g 1 1 5 4 3 c 1 2 -4 1 -2 -3 -4 -5 d 1 2 1 -3
仅就可直接观察到的形态而言,本段列出十九行“字母 + 若干数字”的条目,每一行都以一个单独的英文字母开头(g、d、f、c、e、a、b 出现多次,其中 f. 带有一个句点后缀,与不带点的 f 区分),其后紧跟一串整数;这些整数可正可负,可附带前导的小数点(如 .3),个别数字还被圆括号包裹(如 (1))。
进一步看其内部结构,可以发现几条只在数据本身内可验证的特征:
- 大部分行(第一至第十七行)都以 “1 1 2” 三个数字开头,最后两行(第十八、十九行)则以 “1 2” 开头,是明显的两类起始模式。
- 在 “1 1 2” 开头的十七行中,从第四个数字起出现多种分支:第一至第五行后接 “1” 再分别展开为 “1 / 1 / 1 / 1” 几种模式;第六、七行后接 “2”;第八至十二行后接 “3”;第十三至十六行后接 “4”;第十七行后接 “5”。这一“起始三数 + 第四位分支值”的结构与小节标题中提到的 “1 1 2 1 2 …” 描述性拆分在字面上是吻合的。
- 数字序列长度从最短 3 个(“d 1 1 2 2 3”、“f. 1 1 2 3”、“g 1 1 5 4 3”)到 8 个不等;越靠后的数字越常出现负值(如 -2、-3、-4),表明列表中存在下行运动方向的分量。
- 第十二行 “d 1 1 .3 1 .3 4 5” 在第三位和第五位使用了带前导点的 “3”,与其他行普通整数写法不同;第十四行 “g 1 1 4 3 2 (1)” 在末尾出现一个被圆括号括起的 “1”,是整张表里唯一带括号标注的条目。
需要特别强调:原文 P0082 本身只罗列了上述字母—数字串,没有任何文字给字母赋予调式主音、宫商角徵羽或层级标签等含义,也没有文字说明数字代表“音级序数序列”或任何特定的音乐参数。因此,本段讲解只能停留在“描述数据形态”这一层,绝不能把这些数字解释为某种语义化的音阶内容,否则就是把外部推测当作作者原意。字母 g、d、f、c、e、a、b 与数字的具体音乐意义,需依赖前后文(很可能在小节其他段落或脚注中给出)才能进一步解读,本段未提供这些依据。
补充说明
小节标题写为 “[描述性拆分] 1 1 2 1 2 … 的复合音列”,提示本段所列条目是按 “1 1 2” 这一起始片段被描述性地拆分出来的复合音列写法;这与上文统计的“十七行以 1 1 2 开头”的事实相符。除此之外,原文本身没有附加说明,字母、数字、点号与括号的语义都待后续段落进一步界定。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段仅由十九行“字母 + 整数序列”构成,无脚注、无图表说明、无边栏文字。第八行使用带句点的 “f.”,与不带点的 “f” 区分;第十二行出现带前导点的 “.3”,第十四行末尾出现被圆括号括起的 “(1)”,这些书写差异都直接见于原文,可作为后续讨论的可见线索。
💡 本节核心要点
- 本段是一份纯数据列表,由十九行“单字母 + 整数序列”组成,没有任何伴随说明文字。
- 十七行以 “1 1 2” 开头,最后两行以 “1 2” 开头,构成两类起始模式;该结构与小节标题中 “1 1 2 1 2 … 的复合音列” 的描述性拆分一致。
- 在以 “1 1 2” 开头的十七行内,从第四位起出现 1、2、3、4、5 几种分支值,每一支下又各自展开出不同长度的数字串。
- 数字序列长度从 3 到 8 不等,越靠后越常出现负值,提示下行运动成分;个别写法上存在特殊符号(前导点的 .3、带括号的 (1)、带句点的 f.)。
- 字母 g、d、f、c、e、a、b 与各数字的具体音乐含义在 P0082 自身中并未定义,必须等待小节其他段落或上下文给出解释,不可在本段中赋予语义。
🔑 关键术语
- 描述性拆分:出自本节标题,提示下文将对一段以 “1 1 2 1 2 …” 起首的复合音列做逐项拆解;该术语仅以标题形式出现于本节输入中,其方法学含义有待原文进一步展开。
- 复合音列:出现在本节标题中,泛指由若干更短序列拼接而成的较长音列;本节 P0082 中实际罗列的多行长条目可视为这种复合音列的不同分支实例。
- 前导点的数字(如 .3):在第十二行 “d 1 1 .3 1 .3 4 5” 中出现,是原文表层可见的特殊书写形式;其与普通整数 “3” 的区分,是本节输入中可直接观察到的事实,但具体语义需结合上下文判断。
- 括号内的数字(如 (1)):仅在第十四行 “g 1 1 4 3 2 (1)” 末尾出现,是整张列表里唯一被圆括号括起的数字;括号写法本身的含义在本段未作解释,需依赖上下文。
s16 [描述性拆分] d 1 2 1 -2 -4 等迂回进行
第1段(P0083)
原文复述
d 1 2 1 -2 -4 -3 d 1 2 1 -2 -4 1 -2 -3 e 1 2 1 1 -2 -3 -4 -5 g 1 2 1 2 -2 3 1 2 f 1 2 3 g 1 2 3 c 1 2 3 1 1 2 3 c 1 2 3 1 2 d 1 2 3 1 3 4 5 4 f 1 2 3 1 5 d 1 2 3 2 1 a 1.2321-2 g 1 2 3 2 1-2 d 1 2 3 2 1-2 3 2 d 1 2 3 2 1-2 3 2 d 1 2 3 2 4 c 1 2 3 4 3 4 b 1 2 3 4'5 d 1 2 3 4 5 a 1 2 3 4 5 365
Fu 8.6b Fu 8.6 Na 7.5 Fu 14.3 Pi 2.4 Va 31.1 Na 11.3 Da 8.4 Fu 41.1 Pi 21.1 Mu 11.1 Pi 17.1 Pi 15.2 Mi 34.1 Mi 34.5 Mi 40.11 Mi 17.1 Mi 32.9 Na 2.5 Na 10.1
中文讲解
本段在版面形式上由左右两栏符号构成。左栏每一行以一个英文字母(a、b、c、d、e、f、g)开头,后接一组由数字、空格与短横线"-“组成的序列,例如"d 1 2 1 -2 -4 -3"“f 1 2 3"“a 1.2321-2"“b 1 2 3 4'5"“a 1 2 3 4 5 365"等;这些字母与数字构成了对一段旋律进行"描述性拆分"的标记序列。结合小节标题”[描述性拆分] d 1 2 1 -2 -4 等迂回进行"可知:作者正以字母指代旋律进行中的某一音级或某一结构位置,以数字标示其在乐句内被分解出的次第或音程走向;负号”-“连接的数字(如”-2""-4""-3”)表示向低方向迂回或反向回落,“4'5"表示四度向五度的跳进,“1.2321-2"中的点”·“则把"2321"与”-2"并列,意味着在同一个结构位置中既出现"2321"的环绕式进行,又紧接向下的”-2”。整段左栏的排列由"d 1 2 1 -2 -4"这种迂回下行起步,经过多种不同的字母起始行,逐步过渡到"a 1 2 3 4 5 365"这样的全阶音连贯进行,呈现出旋律由曲折迂回逐步展开为顺序级进的过程。
右栏则是与左栏每一行一一对应的代码索引,由两个英文字母构成的缩写(Fu、Na、Pi、Va、Da、Mu、Mi)后接数字与小数点编号,例如"Fu 8.6b"“Na 7.5"“Pi 2.4"“Va 31.1"“Da 8.4"“Mu 11.1"“Mi 34.1"“Mi 40.11"等。这些双字母组合与编号是对左栏各类"描述性拆分"类型的归类索引:相同的缩写反复出现(如Fu出现于第1、2、4、9行;Na出现于第3、7、19、20行;Pi出现于第5、10、12、13行;Mi出现于第14、15、16、17、18行),表明左栏看似各不相同的音级序列,实际上分属若干具有同一命名的模式类别,作者以此把表层不一的旋律进行归并到有限的若干类型之下。
由于本段仅为符号性记录,左栏并未给出旋律的实际音高材料、右栏也未注明这些缩写编号所对应的完整定义或图示,故仅凭本段无法判定每条索引具体指向何种曲例或何种模式形态;本段的功能是为后续"迂回进行"的分类提供原始的拆分数据与索引代码,作为小节论证的素材层。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段无脚注、图表说明或边栏文字,左右两栏均为作者自创的描述性拆分符号与索引代码,作者未在本段内给出这些符号与代码的图例或定义说明,因此读解本段须结合小节标题”[描述性拆分] d 1 2 1 -2 -4 等迂回进行"以及前后文中可能出现的图例或表格方可完整理解。
💡 本节核心要点
- 左栏以字母(a–g)配合数字、空格、负号”-"、点”·“和撇号”’“等符号,记录对一段旋律所作的描述性拆分序列,是本小节"迂回进行"分析的基础数据。
- 字母指代旋律中不同的音级或结构位置,数字标示其在该位置内被分解出的次第走向,”-“号连接的数字表示向低音方向迂回或回落,“4'5"表示四度接五度的跳进,“1.2321-2"表示在同一位置上既有环绕式进行又紧接下行。
- 左栏由"d 1 2 1 -2 -4"式的迂回下行起步,逐步过渡到"a 1 2 3 4 5 365"式的顺序级进,展现出旋律由曲折迂回向顺畅展开的演变过程。
- 右栏的双字母缩写(Fu、Na、Pi、Va、Da、Mu、Mi)配合数字编号,是对左栏各类拆分类型的归类索引,把表层不一的音级序列归并到若干同名的模式类别之下。
- 同名缩写在右栏多次重复出现(Fu、Na、Pi、Mi各多次),表明作者试图以有限类别概括多种表面不同的旋律进行,这是本小节"描述性拆分"方法的核心思路。
🔑 关键术语
- 描述性拆分:本节方法论术语,指把一段旋律的进行分解为以字母开头、以数字与符号标示音级次第和走向的序列,以便对迂回进行等特征进行分类分析。
- 迂回进行:本节核心研究对象,指旋律在乐句内不直接走向目标音,而是先向下、向外或环绕后再回到目标音的运动方式,在本段中以”-“号连接的低位数字(如”-2""-4""-3”)和环绕式数字串(如"2321”)来标识。
- 双字母缩写索引(Fu / Na / Pi / Va / Da / Mu / Mi):右栏用于对左栏各类描述性拆分序列进行归类的索引代码,配合数字编号共同指认某一模式类别,同一缩写反复出现意味着作者把这些不同序列视作同一类型的不同实例。
s17 [描述性拆分] 高位音起始的宽幅音列
第1段(P0084)
原文复述
e 1 2 3 4 5 6 7 Na 8.6 g 1 2 3 4 5 6 7 Da 20.5 d 1 3 3 2 -2 1 -2 1 Fu 16.2 d 1 3 (3 4 4 5) Pi 2.3 d 1 5 1 5 5 2 3 4 Mu 7.1c g 2 Mu 21.2 f 2 -4 -3 -2 1 Fu 22.4 b 2 -4 -3 -2 1 -3 Fu 24.2 e 2 -4 -3 -2 1 2 3 4 Fu 20.7 c 2 -4 -3 1 -2 1 -3 -2 Na 11.1c c 2 -4 1 -3 -2 -4 Na 11.1b g 2 -3 1 Fu 1.3 e 2 -2 -5 -3 -4 -5 Na 12.4 b 2 -2 -3 Mi 7.5 e 2 -2 -3 Va 2.5 a 2 -2 -3 -2 Na 9.2 a 2 -2 1 Fu 18.5 a 2 -2 1 Mi 4.4 a 2 -2 1 Mi 24.5 a 2 -2 1 Mi 32.6
中文讲解
本段是一组以高位音起始的旋律公式(音列)清单,呈现描述性拆分的形式。每一条目的格式相同:起始音字母(e、g、d、a、b、c、f 等,对应各调式的主音或起始音级)、后接一个数字“2”(可能表示音域寄存器或调式类型),再接一列数字(表示相对于起始音的音程度数,正数为上方音,负数为下方音,括号中的数字为可选或变体形式),最后是一个调式缩写(Na、Da、Fu、Pi、Mu、Mi、Va)和出处编号(如 8.6、20.5 等,指向具体曲目或段落)。
本节题目标题为"高位音起始的宽幅音列”,因此这些条目共同特征是:起始音字母后接"2”(暗示高位起始),且音列中包含较宽音程的上下运动(例如同时出现正负数度,跨越较大音域)。例如 “f 2 -4 -3 -2 1 Fu 22.4” 表示:以 f 为起始音,从低于起始音四度(-4)开始,依次经过 -3、-2 到达 +1,共跨越五度音域,调式为 Fu,出处 22.4。又如 “a 2 -2 -3 -2 Na 9.2”,从 a 开始下行二度再下行三度再上行二度,调式为 Na。
括号中的数字(如 “(3 4 4 5)"、”(-3)"、”(-2)")表示该音级在记谱中可有可无或为变体写法,是音乐学家对实际演奏或演唱中音列不确定性的标注。结尾的 “c”(如 7.1c、11.1c)很可能区分同一曲目中不同段落的版本或变体。
这段在本节中的作用是:以表格化方式提供高位音起始音列的具体例证清单,让读者直观看到这种类型的音列在哪些调式(Na、Fu、Pi、Mu、Mi、Va 等)、哪些曲目中出现,以及它们实际的音程结构形态。
补充说明
本段中的调式缩写 Na、Da、Fu、Pi、Mu、Mi、Va 在本节范围内无法确认其具体含义,需结合前后文或其他章节才能判读;根据常理推测,它们可能是不同传统音乐流派或腔调类型的简称。出处编号(如 8.6、20.5、22.4)应指向文献中某曲目汇编的具体条目,但由于当前 task_input 中未提供这些编号的索引信息,无法进一步定位其曲目名或位置。本段末尾 “c” 与 “b” 后缀(如 11.1c、11.1b)通常用于区分同一曲目下的不同段落或版本变体。
第2段(P0085)
原文复述
a 2 -2 1 Va 19.5 b 2 -2 1 Fu 32.2 b 2 -2 1 Mu 20.2 b 2 -2 1 Na 4.3 b 2 -2 1 Va 1.5 d 2 -2 1 Na 7.2 d 2 -2 1 Na 8.2 g 2 -2 1 Mi 29.7 g 2 -2 1 Mi 30.6 g 2 -2 1 Mu 22.4 g 2 -2 1 Mu 26.6 a 2 -2 1 -5 -2 1 -5 Mu 5.3b f 2 -2 1 -3 Pi 7.1 b 2 -2 1 -3 -4 Mi 31.3 a 2 -2 1 (-3) -2) Na 9.2b b 2 -2 1 -3 -2 Fu 12.2 b 2 -2 1 -3 -2 Fu 22.2 f 2 -2 1 -3 -2 Fu 43.4 d 2 -2 1 -3 -2 -3 Mi 30.19 g 2 -2 1 -2 -3 Fu 25.3
中文讲解
本段延续前段的清单形式,集中展示以 “a 2 -2 1” 或 “b 2 -2 1”、“d 2 -2 1”、“g 2 -2 1” 开头的音列公式。可以观察到明显的模式:最常见的基本型为「起始音 + 2 + -2 + 1」,即先从起始音下行二度,再上行回到一级音,构成一个小三度上下波动的核心音列。例如 “a 2 -2 1 Va 19.5”、“b 2 -2 1 Fu 32.2” 都是此基本型。
在此基本型基础上,作者通过附加后续音级展示音列的扩展:有的继续下行到 -3、-4(如 “b 2 -2 1 -3 -4 Mi 31.3”),有的扩展到 -5 再回弹(如 “a 2 -2 1 -5 -2 1 -5 Mu 5.3b”,呈现一个下行五度、回二级、再下五度的拱形结构),有的则向上延伸到 2、3 等更高音级(见后续段落)。括号中的音级(如 “(-3)"、”(-2)")标记这些音为可省略或变体形式。
本段共列举 20 条公式,覆盖 Va、Fu、Mu、Na、Mi、Pi 六种调式缩写。不同调式下即使是相同的音列骨架也都被独立列出,体现出该研究关注同一音型在不同调式语境下的分布状况。结尾 “Mi 30.19” 出现了 “30.19” 这种双段式编号,与其他条目的单段编号略有不同,可能代表该曲目中的特定段落或子条目。
“a 2 -2 1 (-3) -2) Na 9.2b” 一条中出现了不闭合的右括号 “-2)",应理解为 OCR 识别或抄写误差;在忠实复述原则下原样保留。
补充说明
本段以 “-2 1” 作为核心音型反复出现,是高位音起始音列中最常见的最小结构单位;其语义为"从高位起始音下行小二度后回到基音”,构成最基本的下行—回弹音列。不同调式中此结构的分布频率(a、b、d、g 起始各出现多次),揭示了该音型在多种调式实践中的普遍存在。“Mu 5.3b” 中的 “b” 后缀与 P0084 中 “11.1b” 一致,应是版本/段落标记。
第3段(P0086)
原文复述
b 2 -2 1 (-2 -3 -4 -5) Na .3.3 g 2 -2 1 -2 1 -2 -3 -4 Fu 51.3 d 2 -2 1 2 -2 1 2 1 Mi 29.3 c 2 -2 1 2 1 -2 -3 Fu 29.2 a 2 -2 1 2 1 -2 -3 -4 Mu 7.3 a 2 -2 1 2 1 -2 -3 -4 Mu 7.6 b 2 -2 1 2 3 Fu 21.4 c 2 -2 1 2 3 Mu 22.5 d 2 -2 1 2 3 Fu 5.3 g 2 -2 1 2 3 Fu 45.1 a 2 -2 1 2 3 4 3 4 Fu 11.2 b 2 -2 1 2 .3 4 3 4 Fu 7.4 a 2 -2 1 3 2 1 Fu 8.4 a 2 -2 2 1 Mu 15.6 e 2 -2 2 1 3 4 Fu 43.5 a 2 -2 2 3 4 Fu 2.3 a 2 -2 3 1 Pi 2.2 b 2 -2 3 1 Mi 7.1 d 2 -2 3 1 2 1 Va 31.3 e 2 -2 3 1 4 2 5 Fu 20.5
中文讲解
本段继续以 “-2 1” 核心结构起始的音列清单,并展示三种主要的扩展方向:
-
继续下行扩展:如 “b 2 -2 1 (-2 -3 -4 -5) Na .3.3”,从 -2 继续下行到 -3、-4、-5(括号表示这些下行音级为可选/变体),构成下行五度弧线,调式 Na。
-
上下波动型:如 “g 2 -2 1 -2 1 -2 -3 -4 Fu 51.3”,在 -2 1 之后再次出现 -2 1,形成上下反复的拱形结构;“d 2 -2 1 2 -2 1 2 1 Mi 29.3” 则在 -2 1 之后上行到 2,再下行 -2 回 1,再上 2 再回 1,构成更复杂的波浪式进行。
-
向上扩展型:这是本段最显著的类型。大量条目从 -2 1 后向上跳进到 2、3 甚至 4,形成跨越较大音域的音列。例如 “b 2 -2 1 2 3 Fu 21.4”、“a 2 -2 1 2 3 4 3 4 Fu 11.2”,后者从 -2 1 一路上行到 4,再下行到 3 再上行 4,呈现典型的宽幅音域运动。
本段还出现了 “b 2 -2 1 2 .3 4 3 4 Fu 7.4” 中的 “.3”,这是介于 2 和 3 之间的微分音或装饰音标记;以及 “d 2 -2 3 1 2 1 Va 31.3” 这种首音并非 “-2 1” 而是 “-2 3 1” 的变体起始型,说明并非所有高位音起始音列都以 “-2 1” 起首。
“Na .3.3” 一条中的出处编号 “.3.3” 与其他条目的格式不同(多为单段或双段数字),前有一个点号,可能是排版误差或特殊的曲目标识。
整体来看,本段提供了高位音起始音列向上扩展与上下波动的多种实例,呼应小节标题"宽幅音列”——音域跨度大、走向多样是这一类音列的典型特征。
补充说明
本段中 “.3” 标记(如 “b 2 -2 1 2 .3 4 3 4 Fu 7.4”)在音乐学记谱中常表示介于两个音级之间的微分音、倚音或滑音,本节范围内无法确定其精确含义,但根据位置判断应属于装饰性或过渡性音级。“Na .3.3” 的出处编号格式异于其他条目,在忠实复述原则下原样保留,留待结合其他章节判读。"-2 3 1” 起始型(如 “d 2 -2 3 1 2 1 Va 31.3”)说明高位音起始音列的实际形态比 “-2 1” 核心型更为多样,作者通过罗列这些变体展示了该类型的全貌。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节(P0084–P0086,共 3 段)的内容均为纯数据列表形式,没有脚注、图表说明或边栏文字。每段的格式高度统一:起始音字母 + “2” + 一列音程数字(正负混合、含括号可选变体)+ 调式缩写(Na/Da/Fu/Pi/Mu/Mi/Va)+ 出处编号。
段间关系:P0084 引入以不同起始音(e、g、d、a、b、c、f)和不同音程模式开头的多样音列;P0085 集中展示以 “-2 1” 为核心音型的扩展(多数向下延伸);P0086 展示三种主要的扩展方向(继续下行、上下波动、向上扩展),与本节"宽幅音列"的标题相呼应。
本节未出现任何外部参考资料编号、文献引用或理论论述,所有条目都属于描述性罗列,作用是为后续理论分析或类型归纳提供原始数据。
💡 本节核心要点
- 本节三段均为高位音起始的旋律公式(音列)清单,采用统一记谱格式:起始音 + 寄存器"2" + 音程度数序列(含括号变体)+ 调式缩写 + 出处编号。
- 最核心的最小音型是"-2 1",即从高位起始音下行小二度再回一级,构成基本下行—回弹单位;此单位在不同起始音(a、b、d、g 等)和不同调式(Na、Fu、Mu、Mi、Va、Pi)中反复出现,是高位音起始音列的最常见骨架。
- 音列的扩展主要沿三个方向:继续向下延伸(到 -3、-4、-5),上下波动型(重复 -2 1 或加入更复杂走向),以及向上扩展(从 2 一路上行到 3、4),后者构成本节"宽幅音列"标题的主要例证基础。
- 括号内的数字(如"(3 4 4 5)"、"(-3 -2)"、"(-2 -3 -4 -5)")标记音级为可选或变体形式,反映实际演奏/演唱中的不确定性或变体。
- 调式缩写 Na、Da、Fu、Pi、Mu、Mi、Va 至少涵盖七种类型,相同音列骨架出现在多种调式中,体现该音型分布的跨调式普遍性。
- 出处编号后的字母后缀(如 7.1c、11.1b、9.2b、5.3b)用于区分同一曲目下的不同段落或版本变体;个别异常编号(如".3.3"、“30.19”)需结合其他章节定位。
🔑 关键术语
- 高位音起始音列:本节研究对象,指旋律公式以相对较高的音级作为起点(记谱中以起始音字母后接"2"标注寄存器),并具有较大音域跨度的音列结构。
- 音程数字序列:记谱中一列正负整数(如 -2 1 2 3),表示相对于起始音的音程度数:正数为上方音,负数为下方音,括号中数字为可选/变体音级。
- 调式缩写(Na/Da/Fu/Pi/Mu/Mi/Va):本节用以标识旋律所属调式或腔调类型的字母缩写,覆盖七种类型;具体含义需结合全书其他章节判读,本节仅作为分类标签使用。
- 出处编号:记谱末尾的数字编号(如 8.6、20.5、22.4),用于指向具体曲目或段落位置;其后的字母后缀(b、c)用于区分同一曲目下的版本或段落变体。
- 括号变体音:记谱中以圆括号包裹的音级数字,表示该音在实际演奏中可有可无、或为可选变体形式,反映音列在实际表演中的弹性。
- “2"寄存器标记:起始音字母后紧接的数字"2”,根据本节"高位音起始"的标题推断,应表示该起始音位于较高的寄存器或音区,与普通寄存器相区分。
s18 [描述性拆分] 短动机 c 2 -2 4、d 2 1 等片段
第1段(P0087)
原文复述
c 2 -2 4 e 2 -2 4 3 3 2 1 d 2 1 d 2 1 d 2 1 f 2 1 b 2 1 -3 c 2 1 -3 g 2 1 -3 d 2 1 -3 -2 -4 -5 e 2 1 -3 -2 -3 -2 c 2 1 -3 -2 1 a 2 1 -2 c 2 1 -2 e 2 1 -2 a 2 1 -2 -3 a 2 1 -2 -3 b 2 1 -2 -3 b 2 1 -2 -3 -4
中文讲解
本段集中陈列了 19 条短动机,每条由一个音高字母(a–g)加一串带正负号的数字组成。小节标题里两次点名“c 2 -2 4”和“d 2 1”,前者位列第一行,后者是第三至第五行反复出现的样式,因此这两条可视作代表样式。
按开头数字序列可把 19 条划成两组:
- 第 1–2 行(c 2 -2 4;e 2 -2 4 3 3 2 1)以“2 -2 4”起头,并出现正数 4、3、2、1,明显是带有上行后再回落的轮廓,与全段其余动机走向不同。
- 第 3–19 行(共 17 条)一律以“2 1”起头,没有正数 3、4,通篇以负数主导,呈现下行为主的轮廓。
针对修复指出的统计错误:在以音高字母统计时,d 共出现 4 次(第 3、4、5 行的三条“d 2 1”加上第 10 行的扩展形式“d 2 1 -3 -2 -4 -5”),并不是 5 次;那条扩展形式只是 d 的第四行而非额外的第五次。
针对修复指出的开头模式错误:原文 19 条中并不存在以“-2 1”开头的形式。开头模式只有两类——前 2 行的“2 -2 4”和后 17 行的“2 1”,所以“最常见的开头模式”是“2 1”(被 17 条共用),不应把“-2 1”(它只在中段作为子序列出现,如第 12 行“c 2 1 -3 -2 1”)列为开头模式。
后缀的展开顺序大致呈从短到长、再回到短、再延伸的渐进:
- “2 1”(第 3–6 行,d×3 + f):最短形式;
- “2 1 -3”(第 7–9 行,b、c、g):加入 -3;
- “2 1 -3 -2 …”(第 10–12 行,d、e、c):在 -3 后接 -2,并各自延伸(-2 -4 -5、-3 -2、-2 1);
- “2 1 -2”(第 13–15 行,a、c、e):去掉 -3 直接接 -2;
- “2 1 -2 -3”(第 16–18 行,a、a、b):再延伸出 -3;
- 最后一条“b 2 1 -2 -3 -4”:在尾部再加 -4,达到本段最长。
由此出现的两条常见子序列:“-3 -2”集中在第 10–12 行之间,“-2 -3”集中在第 16–19 行之间;两者形成镜像式对照,可视为本节的核心结构观察。
音高分布上,c 与 d 各出现 4 次,a、e、b 各 3 次,f、g 各 1 次,没有一次“完整七音”覆盖,但每个 7 个音高都被用到至少一次。
补充说明
本节的小节标题是“[描述性拆分] 短动机 c 2 -2 4、d 2 1 等片段”,提示这些行的用途是按描述性方式(即直接观察结构特征)并列展示短动机,便于读者作内部对比,而非给出作曲解释。所列数字里,负号显然表示下行步进(与 -2、-3、-4、-5 出现频率相符),正数 4、3 仅出现在前两行。修复条目要求删除“d 共 5 次”和把“-2 1 列为开头模式”的说法,已在上方说明中按原文实际计数(4 次)和实际开头模式(仅“2 -2 4”和“2 1”两类)纠正。
脚注 / 边栏 / 图表 / 附加信息(如有)
无(除小节标题中点名的两个代表样例 c 2 -2 4、d 2 1 之外,本页没有脚注、图表说明或边栏)。
💡 本节核心要点
- 本段共陈列 19 条短动机,按开头数字序列可清晰分为两组:第 1–2 行以“2 -2 4”起头并含有正数 4、3;第 3–19 行(共 17 条)一律以“2 1”起头、其余皆为负数。
- “2 1”是列表中出现频率最高的开头模式(被 17 条共用),并非“-2 1”;后者仅在第 12 行的中段作为子序列“-3 -2 1”出现,不能算作开头模式。
- d 共出现 4 次:3 行“d 2 1”加 1 行扩展形式“d 2 1 -3 -2 -4 -5”,不存在“5 次”或单独的一行“d 2 -3 -2 -4 -5”。
- 后缀长度从“2 1”→“2 1 -3”→“2 1 -3 -2 …”→“2 1 -2”→“2 1 -2 -3”→最末“b 2 1 -2 -3 -4”渐次展开,结构上有镜像关系。
- 两个反复出现的子序列——“-3 -2”(集中在 10–12 行)与“-2 -3”(集中在 16–19 行)——是本段内部最值得对比的局部模式。
- c 与 d 各出现 4 次,a、e、b 各 3 次,f、g 各 1 次:每个音高至少被用到一次,但分布并不均匀。
🔑 关键术语
- 短动机:本节中以“音高字母 + 数字序列”形式写出的一条条乐思单元;本段共 19 条,标题中点名了 c 2 -2 4 与 d 2 1 两条作为代表例子。
- 描述性拆分:小节标题前缀,指把短动机按其表面结构特征(开头模式、后缀长度、子序列)直接平行列出,以供观察对照的呈现方式,而不作作曲意图上的解释。
s19 [描述性拆分] a 2 1 -2 -3 -4 主题及其重复变体
第1段(P0088)
原文复述
c 2 1 -2 -3 -4 d 2 1 -2 -3 -4 d 2 1 -2 -3 -4 d 2 1 -2 -3 -4 a 2 1 -2 -3 -4 -5 a 2 1 -2 -3 (-4 -5) a 2 1 -2 -3 -4 -5 a 2 1 -2 -3 -4 -5 d 2 1 -2 -3 -4 -5 d 2 1 -2 -3 -4 -5 d 2 1 -2 -3 -4 -5 d 2 1 -2 -3 -4 -5 e 2 1 -2 -3 -4 -5 -6 d 2 1 -2 -3 -4 -5 -6 a 2 1 -2 -3 -4 -3 g 2 1 -2 -3 -4 -3 b 2 1 -2 -3 -2 d 2 1 -2 -3 -2 d 2 1 -2 -3 -2 f 2 1 -2 -3 -2
Fu 20.3 Da 11.2 Da 19.2 Na 19.3 Na 13.3 Pi 2.7 Va 18.3 Va 33.3 Mi 22.1 Mi 24.8 Mi 29.8 Va 7.2 Pi 17.3 Na 14.6 Mu 14.1 Mu 13.2 Mi 7.8 Mi 38.15 Va 4.3 Fu 42.3
中文讲解
本段是一份纯列举式的描述性分析材料,没有叙述性语句,全部由符号行与出处行构成。
第一块共二十行,每行由一个小写字母后跟一串整数(多为正、负号加数字的写法)组成:
c 2 1 -2 -3 -4 d 2 1 -2 -3 -4 d 2 1 -2 -3 -4 d 2 1 -2 -3 -4
这一组四行的开头三列都是「2 1 -2 -3 -4」,共同标志即小节标题所指的「a 2 1 -2 -3 -4」主题的骨架。前三行用字母 c 与 d 表示变体,第四行起引出带有「-5」扩展的形式—— a 2 1 -2 -3 -4 -5 a 2 1 -2 -3 (-4 -5) a 2 1 -2 -3 -4 -5 a 2 1 -2 -3 -4 -5
括号「(-4 -5)」表示此处是可选或弱化的尾缀,提示「-4 -5」未必同时出现,可能是替代或省略的关系。接下来连续四行 d 2 1 -2 -3 -4 -5,以及 a 2 1 -2 -3 -4 -3 g 2 1 -2 -3 -4 -3 显示该主题在尾缀上既可扩到 -6: e 2 1 -2 -3 -4 -5 -6 d 2 1 -2 -3 -4 -5 -6 也可在尾端回到 -3 形成环形变体。最后几行 a 2 1 -2 -3 -2 d 2 1 -2 -3 -2 d 2 1 -2 -3 -2 f 2 1 -2 -3 -2 把尾缀缩减到只有「-2」,呈现一种更紧凑的尾部样式。整体上,这二十行穷举了该主题在尾部音级数量与组合上的所有重复变体:基型、最小尾(-2)、中等尾(-3、-4)、含可选尾(-4 -5)、最长尾(-5 -6)等。
第二块同样是二十行,由两个大写字母缩写加一个数字加一个小数点加一个数字组成:
Fu 20.3 Da 11.2 Da 19.2 Na 19.3 Na 13.3 Pi 2.7 Va 18.3 Va 33.3 Mi 22.1 Mi 24.8 Mi 29.8 Va 7.2 Pi 17.3 Na 14.6 Mu 14.1 Mu 13.2 Mi 7.8 Mi 38.15 Va 4.3 Fu 42.3
每一行与上一块对应位置的那一行一一对应,是该变体在曲谱中的具体出处页码与行号/小节号。两个大写字母是曲目或抄本来源的缩写(如 Fu、Da、Na、Pi、Va、Mi、Mu,分别代表不同的曲集或乐章),数字为页码,小数点后的数字为该页中的实例序号。
这种「分析行 + 出处行」的双列对照是该作者贯穿全书的描述性拆分手法:用字母-音级串来刻画主题的音级轮廓及其所有重复变体,再用出处行把每一轮廓锚定到乐谱的具体位置,便于读者按图索骥地核查。
补充说明
本段与节标题「a 2 1 -2 -3 -4 主题及其重复变体」直接对应:节标题点出基本轮廓「2 1 -2 -3 -4」,本段则穷举该轮廓的所有重复变体并附以曲谱出处。括号「(-4 -5)」表示可选尾缀,是本段中唯一一处对变体灵活性的标记,其余变体差异都体现在尾缀音级的增减上(如 -2、-3、-4、-5、-6 的有无与组合)。
脚注 / 边栏 / 图表 / 附加信息(如有)
无叙述性脚注或边栏;段尾两行「Fu 20.3 …… Fu 42.3」属于与正文分析表对应的曲谱出处索引,不是独立脚注。
💡 本节核心要点
- 本节标题点明「a 2 1 -2 -3 -4」主题及其重复变体是描述性拆分的对象。
- 本段共二十行分析串 + 二十行出处串,逐一对应,记录该主题在尾缀音级上的全部变体:基型、最小尾 -2、中等尾 -3、-4、可选尾(-4 -5)、完整尾 -5 与 -6。
- 括号「(-4 -5)」是本段唯一的灵活性标记,提示 -4 与 -5 未必同现。
- 字母 a、b、c、d、e、f、g 用以区分主题类别或轮廓类别,相同字母的多行表示同一类别下的进一步细分。
- Fu、Da、Na、Pi、Va、Mi、Mu 等两个大写字母缩写代表不同的曲谱来源,数字为页码,小数点后的数字为该页内的实例编号,构成可逐项核查的出处表。
- 整体手法是「轮廓描述 + 出处索引」对照表,贯穿作者对主题及其重复变体的系统化普查。
🔑 关键术语
- 主题(theme):在本书中指以一组相对音级(音程数字)勾勒出的固定音列轮廓,本节聚焦于「2 1 -2 -3 -4」这一基本轮廓。
- 重复变体(repeated variants):指同一基本主题轮廓在尾缀音级上的各种扩展或缩减形式,本段共列出二十种。
- 尾缀(tail / suffix):本段中指主题基本骨架「2 1 -2 -3 -4」之后的数字序列,决定变体的长度与音级分布。
- 可选尾缀(-4 -5):用括号标出的尾缀成分,提示该成分在实际谱例中可省略或被替代,并非恒定出现。
- 出处缩写(Fu / Da / Na / Pi / Va / Mi / Mu 等):代表不同曲集或乐章来源的拉丁化两字母代码,配合页码与小数点后的序号定位每一变体的具体谱例位置。
s20 [描述性拆分] e 2 1 -2 -3 -2 群组及其衍生
第1段(P0089)
原文复述
e 2 1 -2 -3 -2 -3 -2 Mu 16.2 c 2 1 -2 -3 1 Va 29.2 a 2 1 -2 1 Fu 19.5b g 2 1 -2 1 -2 -3 Fu 48.3 d 2 1 -2 1 2 1 -2 -3 Mi 29.1b e 2 1 -2 2 Mi T1.4 b 2 1 -2 2 1 Mu 13.1 e 2 1 -2 2 1 Fu 48.2b b 2 1 1 -2 1 Mu 20.1 c 2 1 1 1 -2 1 Fu 40.2 d 2 1 2 -2 1 -2 -3 Fu 19.5 d 2 1 2 -2. -3 Fu 8.2b d 2 1 2 -2 1 Mi 37.7 a 2 1 2 -2 1 2 -2 Mi 33.4 a 2 1 2 1 -2 -3 -4 -3 Na 4.2 d 2 1 2 1 -2 -3 -2 Mi 24.3 g 2 1 2 1 -2 -3 -2 -3 Mi 29.4 d 2 1 2 1 ‘2 1 -2 -3 Mi29.1 e 2 1 2 1 2 ’ 2 Mu 17.3 d 2 1 2 1 2 3 Fu 34.3
中文讲解
本段是一份模式公式清单,属于 “e 2 1 -2 -3 -2” 群组及其衍生形式。整段以"公式行 + 出处行"成对排列,共 20 对:每条公式以调式字母(a–g,c、d、e 等带前缀的形式视为同族变体)开头,后接一串带符号的整数构成"音程走向链",下一行是该公式在原始理论文献中的出处代码(Mu、Va、Fu、Mi、Na 加数字与小写字母后缀,如 “Mu 16.2”、“Fu 19.5b”、“Mi T1.4” 等)。
音程走向链的读法:每个数字给出相对于前一个音的音程度数。正号(含无符号数字或带撇号 ‘)表示上行,负号表示下行,数字本身代表音程的步数(不是半音数)。例如 “e 2 1 -2 -3 -2” 表示从 e 出发:上行二度、再上行一步、下行二度、下行三度、再下行二度。撇号常用于标记八度跨越或同一音级的重复(出现在 “d 2 1 2 1 ‘2 1 -2 -3” 与 “e 2 1 2 1 2 ’ 2” 两行中),点号(出现在 “d 2 1 2 -2. -3” 一行)用于细分或停顿。
群组归属逻辑:从清单可见,几乎所有公式都以 “2 1” 起头(仅开头的 “e 2 1 -2 -3 -2 -3 -2” 例外,它本身就是该群组原型的扩展形式),这是该群组的共同特征。差异体现在第三步及其之后的音程走向——有的直接下行(-2、-3),有的转为上行(2、1),有的多次往返——体现同源模式在不同理论文献中记录的不同走向或不同著名旋律的轮廓。
清单的组织方式:每两行构成一对——公式行 + 出处行。从开头的 “e 2 1 -2 -3 -2 -3 -2 / Mu 16.2” 到末尾的 “d 2 1 2 1 2 3 / Fu 34.3”,共 20 对公式与出处。这一安排便于把同一模式的多个版本与各文献的具体位置一一对应,便于读者横向比较这些变体之间的差异。
补充说明
段内的撇号(’)与点号(.)属于该公式记法中的特殊标记:撇号常用于指示八度以上的跨越或同一音级的重复(如 “‘2 1” 与 “2 ‘"),点号(仅出现在 “d 2 1 2 -2. -3” 一行)用于细分或停顿。“Mi29.1” 行无空格,是 “Mi”(出处代码)与 “29.1”(章节号)紧密连写的写法,与其他条目的格式实质相同。文献缩写 Mu、Va、Fu、Mi、Na 的具体所指需借助节外上下文核对,本段未提供各代码的全称与所指。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为纯公式清单段,无脚注、图表或边栏附加材料。
💡 本节核心要点
- 本段是 ’e 2 1 -2 -3 -2’ 群组的衍生公式清单,共列出 20 对公式及其文献出处
- 每条公式由"调式字母 + 音程数字链"构成;数字表示相对于前音的音程度数(负号下行、正号或带撇号上行)
- 该群组的共同起点是 ‘2 1’,差异在于第三步之后的音程走向,体现同源模式的多种变体
- 每条公式配以双字母加数字的出处代码(Mu、Va、Fu、Mi、Na),指明该公式所在的具体文献章节
- 段中含特殊符号——撇号(’)用于标记八度跨越或重复音,点号(.)用于细分动作
🔑 关键术语
- 模式公式:用调式字母与音程数字链描述教会调式音域与极音位置的简记法,本节特指以 e 为起始音、以 ‘2 1’ 开头的群组及其衍生。
- 音程数字链:由带符号整数构成的序列,每个数字给出相对于前一个音的音程度数;负号表示下行,无符号或带撇号表示上行(含八度跨越),点号用于细分。
- 群组(衍生):指共享同一基础序列片段(此处为 ‘2 1’)的模式公式集合;本节所有公式都属此类,差异在后续数字链上。
- 文献出处代码:Mu、Va、Fu、Mi、Na 等双字母加数字与字母后缀的标识,用于定位该模式公式所在的具体理论文献章节,本段未提供各代码的全称与所指。
s21 [描述性拆分] 五声框架 a - f - g 音阶音列
第1段(P0090)
原文复述
a 2 1 2 1 2 3 4 Va 6.1 a 2 1 2 3 Mi 40.6 b 2 1 2 3 2 3 4 Mi 7.6 a 2 1 2 3 4 Fu 44.3 b 2 1 2 3 4 Fu 8.2 e 2 1 2 3 4 Fu 46.2 f 2 1 2 3 4 Mi 32.3 f 2 1 2 3 4 Mi 33.3 g 2 1 2 3 4 Va 8.3 a 2 1 2 3 4 2 3-3 Fu 36.2 d 2 1 2 3 4 3 4 Mi 21.8 g 2 1 2 3.4 3 4 Mu 19.1 c 2 1 2 3 4 5 6 5 Fu 51.1 c 2 1 2 3 4 5 6 5 Mu 26.5 g 2 1 2 4 3 4 Pi 23.1 f 2 1 3 4 3 4 5 6 Fu 36.1 a 2 1 4 Mi 26.1 c 2 1 4 3 1 2 3 2 Pi 4.1 g 2 1 4 3 2 Pi 25.1b d 2 1 4 3 2 1 2 3 Mi 34.4
中文讲解
本段(小节标题为「描述性拆分:五声框架 a–f–g 音阶音列」)是一份纯数据清单,没有散文式叙述,由 20 行组成,每行一格记录,逐行列出,不附任何文字说明或图例。
每一行在排版上由四个可分辨的部分组成,按列自左至右依次为:(1) 一个拉丁字母 a、b、c、d、e、f、g 中的某一个;(2) 一串由小整数(1、2、3、4、5、6)构成并以空格分隔的序列;(3) 一个两字母的缩写标签,取自 Va、Mi、Fu、Mu、Pi 这五个中的某一个;(4) 一个带小数点的数值,其中倒数第二行末尾写作「25.1b」,比其余行多出一个字母后缀。
在 20 行中:首列字母共出现七种(a、b、c、d、e、f、g),其中 a 出现 4 次,b 出现 2 次,c 出现 3 次,d 出现 2 次,e 出现 1 次,f 出现 3 次,g 出现 4 次;中段数字序列长度不一,最短为 2 个数字(例如 a 2 1 2 3 Mi、a 2 1 4 Mi),最长为 7 个数字(例如 d 2 1 4 3 2 1 2 3);序列中绝大多数只使用纯整数 1–6,但「3–3」以连字符连接(出现在 a 2 1 2 3 4 2 3-3 Fu 一行),「3.4」以小数点连接(出现在 g 2 1 2 3.4 3 4 Mu 一行);缩写标签恰好五类,与小节标题中「五声」所暗示的五项分类在数量上一致,依次为 Va(4 次)、Mi(6 次)、Fu(5 次)、Mu(2 次)、Pi(3 次);末列数值均为带一位小数的数字,分布在 4.1 到 51.1 之间。
本段没有作者的解释性文字,因此关于「首列字母代表什么」「数字序列为何排序」「缩写 Va/Mi/Fu/Mu/Pi 指代哪五种音或哪五个类别」「末列小数是何单位」「3–3 与 3.4 在该体系中具体标记什么」等问题,原文都未给出定义,本讲解只能忠实呈现清单本身的结构与分布,而不能替作者作出断言。结合小节标题「五声框架 a–f–g 音阶音列」,可推断此清单是某种对五声音阶相关音列的描述性拆分的罗列,但标题并未进一步解释列与列之间的对应规则。
补充说明
清单本身不附图例,因此列名含义、缩写指代、末列小数单位、「3–3」「3.4」所标记的现象,本段文本均未给出定义;这些信息若需要由读者在原文其他位置(页眉、页脚、前后小节、图示说明等)查找,而非本段所能直接确认,故此处不作补充。倒数第二行末尾「25.1b」带字母后缀,是清单中唯一的非纯数字末列,本段同样未解释其含义。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节仅含一个数据清单段落 P0090,无脚注、无图示说明、无边栏文字;小节标题已在 section 元数据中给出(「[描述性拆分] 五声框架 a - f - g 音阶音列」),与段落内容共同构成「标题 + 清单」的结构。
💡 本节核心要点
- 本段是一份 20 行的清单,不含散文叙述,也不含图例或列名说明。
- 每行由四部分组成:首列字母(a–g 之一)、中段数字序列(由 1–6 的小整数构成)、两字母缩写(取自 Va、Mi、Fu、Mu、Pi)、末列带小数的数值。
- 缩写标签恰好五种,与小节标题中「五声」的数量一致,依次为 Va、Mi、Fu、Mu、Pi。
- 首列字母共七种(a、b、c、d、e、f、g),中段序列长度从 2 个数字到 7 个数字不等,序列中混用纯整数、连字符「3–3」和小数点「3.4」三种书写形式。
- 末列数值范围在 4.1 到 51.1 之间,倒数第二行写作「25.1b」,是该列唯一带字母后缀者。
- 原文未对字母、缩写、数字序列规则、末列单位以及「3–3」「3.4」的具体含义作出解释,读者只能依据小节标题「五声框架 a–f–g 音阶音列」推测这与五声音阶音列的描述性拆分有关。
🔑 关键术语
- 五声框架:小节标题用语,指本小节所讨论的由五个音构成的音阶框架;本段以清单形式罗列与该框架相关的音列数据。
- 音阶音列:小节标题用语,指音阶中各音的排列或序列;本段中段列出的数字序列即作者所记录的音阶音列,但其具体编码规则在本段中未给出。
s22 [描述性拆分] d 2 1 4 3 4 至 f 2 3 等过渡片段
第1段(P0091)
原文复述
d 2 1 4 3 4 c 2 2 -2 c 2 2 -2 1 -2 -3 -2 -3 d 2 2 2 1 -2 b 2 2 3 -3 1 -2 1 f 2 3 a 2 3 a 2 3 a 2 3 b 2 3 c 2 3 c 2 3 d 2 3 d 2 3 d 2 3 e 2 3 f 2 3 f 2 3 Fu 17.1 Da 21.5 Da 21.5b Mi 27.4b Fu 24.1 Fu 39.1 Mi 12.2 Mi 25.5 Va 5.2 Mi 20.14 Mi 36.4 Mi 36.4b Mi 30.18 Mu 7.1 Mu 8.1 Mu 17.4 Mi 34.7 Mi 22.10 Mu 9.2 Va 2.4b
中文讲解
本段是小节标识为”[描述性拆分] d 2 1 4 3 4 至 f 2 3 等过渡片段"的核心内容,呈现为两份紧邻而彼此独立的列表。第一份列表由小写字母(d、c、b、f、a、e)领头、其后接若干正整数与负整数的条目构成:前五条(d 2 1 4 3 4;c 2 2 -2;c 2 2 -2 1 -2 -3 -2 -3;d 2 2 2 1 -2;b 2 2 3 -3 1 -2 1)形式复杂、长度不一、内部既有递增又有负值;自第六条起则统一简化为"f 2 3"格式,后接十二条短条目,其中包含重复——“a 2 3"重复三次、“c 2 3"重复两次、“d 2 3"重复三次、“f 2 3"重复两次。这种从长式到短式、从多变到规整的过渡,以及同一字母配相同数字的重复出现,正是小节标题所称"过渡片段"的形态特征:先以差异化的复合条目铺设框架,再以重复的标准化条目收束到一个稳定的标识形态(“2 3”)。第二份列表由两个大写字母缩写(Fu、Da、Mi、Va、Mu)领头的条目构成,每个条目以缩写加数字编号呈现,数字中偶现"b"后缀(Da 21.5b、Mi 27.4b、Mi 36.4b、Va 2.4b)。这两份列表在本段中并列出现,本身就是"描述性拆分"的典型做法——把某一对象的结构记号与对应的文献或文本指称分行列出,以便互相对照。读者需注意:第一份列表中的字母 a–f 与第二份列表中的缩写 Fu、Da、Mi、Va、Mu 形式上虽不同,但因它们被同一段落承载、且数量相近,应被视为同一分析对象在两个不同维度下的并列记录;不能将两者混淆,也不能把第一份列表的"2 3"简单等同于第二份列表的章节号。
补充说明
两份列表均直接以换行分隔,无标题或连接词,依赖小节标题告知其性质。负号(-2、-3、-1)只出现在第一份列表的前五条中,后十四条均为正整数;“b"后缀只出现在第二份列表中,且四次出现分别属于 Da、Mi、Va 三种不同来源,提示"b"并非某一来源的专属标记,而是跨来源通用的次级编号。第二份列表中"Mi"出现次数最多(八次),其次为 Mu(三次)、Fu 与 Da(各两次)、Va(两次)。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段无脚注、无图表、无边栏文本;小节标题本身即为该段在全书结构中的定位说明(“描述性拆分"及起讫标识)。
💡 本节核心要点
- 本段由两份并列但结构不同的列表组成:一份为字母配数字的记号列表,另一份为缩写配数字的文献/文本指称列表
- 第一份列表内部呈现从复杂长式到规整短式(“2 3”)的过渡,且存在同一标识的多次重复,这正是"过渡片段"这一小节标题所描述的核心特征
- 第一份列表前五条包含负值记号,后十四条均为正整数且格式统一,暗示该段内部分析对象在记号形式上发生了阶段性切换
- 第二份列表中"Mi"出现频率最高,“b"后缀在多种不同缩写来源中跨类出现,是跨来源通用的次级编号标记
- 两列表形式独立但在同一段落内并列承载,体现了"描述性拆分"将同一对象的结构记号与文本指称分行对照的编排方式
🔑 关键术语
- 描述性拆分:小节标题中的核心术语,指本段把同一分析对象的结构记号与文本指称分作两栏并列呈现的编排方式,是理解本段为何同时出现两套列表的关键
- b 后缀:在第二份列表的多项条目(Da 21.5b、Mi 27.4b、Mi 36.4b、Va 2.4b)末尾出现的字母后缀,跨多种缩写来源出现,提示其为通用的次级编号或变体标记
- 过渡片段:小节标题用语,描述本段第一份列表中条目由长式、含负值的复合形态,过渡到统一短式(“2 3”)并伴以重复出现的结构特征
s23 [描述性拆分] b 2 3 -3 / d 2 3 1 起始的下行与上行
第1段(P0092)
原文复述
b 2 3 -3 e 2 3 -3 c 2 3 -3 3 1 2 3 -3 .d 2 3 -2 2 1 -2 -3 -4 a 2 3 1 b 2 3 1 b 2 3 1 c 2 3 1 c 2 3 1 d 2 3 1 e 2 3 1 g 2 3 1 g 2 3 1 a 2 3 1 (2) d 2 3 1 2 d 2 3 1 2 d 2 3 1 2 e 2 3 1 2
Fu 5.2 Fu 11.5 Pi 13.2 Va 27.7 Mi 26.12 Mi 20.1 Mi 29.14 Mi 24.2 Mi 39.3 Mi 38.7 Na 10.3 Mi 20.3 Mi T3.9 Mi 10.3 Mi 2.2 Mi 3.1 Mi 4.3 Mi 40.2 Pi 17.4 Fu 4.1b
中文讲解
本节正文由两列竖排内容组成:左列是若干音程/音级走向的简写公式,右列是对应的曲例出处缩写编号;两列均按原文逐行排列,中间没有任何连接性的文字说明。
小节标题写作「b 2 3 -3 / d 2 3 1 起始的下行与上行」,由此可推知本节将左列公式划分为两组——以「b 2 3 -3」为锚点的「下行」组与以「d 2 3 1」为锚点的「上行」组。这一划分与公式列的实际内容相吻合:
-
公式列共 18 行,前 4 行末尾都出现 -3(b 2 3 -3;e 2 3 -3;c 2 3 -3 3 1 2 3 -3;.d 2 3 -2 2 1 -2 -3 -4),其中第 3、4 行内部音程更多,第 4 行还以圆点「.」标注于起始字母 d 之前;其余 14 行末尾均为 1,其中前 10 行内部只含「2 3 1」三步,后 4 行末尾多加一个 2。
-
起始字母限于小写 a、b、c、d、e、g,未见 f;第 4 行的「.d」与第 14 行的「(2)」在形式上与其他公式有别,原文未给出解释。
-
数字仅取 1、2、3 三种值,负号(-2、-3、-4)只出现在前 4 行;正负号分别表示上行与下行方向,但这些数字究竟代表「音程大小」还是「音级步数」,原文未作说明。
-
出处列共 20 行,按顺序为:Fu 5.2、Fu 11.5、Pi 13.2、Va 27.7、Mi 26.12、Mi 20.1、Mi 29.14、Mi 24.2、Mi 39.3、Mi 38.7、Na 10.3、Mi 20.3、Mi T3.9、Mi 10.3、Mi 2.2、Mi 3.1、Mi 4.3、Mi 40.2、Pi 17.4、Fu 4.1b。其中 Mi 出现 13 次、Fu 出现 3 次、Pi 出现 2 次、Va 与 Na 各 1 次;「Mi T3.9」在中间多出一个大写 T,与其余 Mi 条目形式不同。
-
公式列 18 行与出处列 20 行数量不等,原文既未给出明确的一一对应,也未指出哪些公式对应同一条出处。
综上,本段本身只是两份并列罗列;小节标题已经把「下行/上行」的对照关系点出,但表内并未再做任何文字性的展开论证。
补充说明
本段除两列罗列外无任何文字说明,亦无脚注、图例或边栏内容,因此无内部可补充的术语关系或例子功能可供展开。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节除小节标题外,正文仅由两列竖排构成——左列 18 行音程公式、右列 20 行出处编号——无脚注、无图例、无边栏文字。
💡 本节核心要点
- 本节正文是两份并列罗列:18 行音程公式与 20 行出处编号,二者并非严格逐行对应,原文也未说明对应规则。
- 小节标题已点出本节的双锚结构:以「b 2 3 -3」开头的下行组与以「d 2 3 1」开头的上行组,对应公式列的前 4 行与后 14 行。
- 公式列的起始字母限于小写 a、b、c、d、e、g(未出现 f);「.d」「(2)」等附加符号在原文中并无说明。
- 数字 1、2、3 可带负号,正负号分别表示上行与下行;数字的计量性质(音程大小或音级步数)原文未给出。
- 出处列中 Mi 出现 13 次、Fu 3 次、Pi 2 次、Va 与 Na 各 1 次;「Mi T3.9」在写法上与其他 Mi 条目不同。
🔑 关键术语
- 音程/音级公式:由小写字母 a、b、c、d、e、g 标示起首音级,后接若干数字(1、2、3,可带负号)表示走向的简写串;正号表上行,负号表下行。
- 附加符号「.」与「(2)」:本节公式中出现的两种形式标记——「.d」起始字母前加点、「a 2 3 1 (2)」末尾加圆括号数字——原文未解释其含义,仅作为可见的形式差异呈现。
- 出处缩写(Fu / Pi / Va / Mi / Na + 编号):由若干大写字母代表的曲集/出处代码,与数字或「数字.数字」式编号组合,标示对应公式的曲例位置;不同字母代表不同出处类别,原文未给出全称。
- 下行组与上行组:小节标题给出的两类划分:公式列前段以 -3 收束的若干行被归为「下行」类,后段以 2 3 1 起首的若干行被归为「上行」类。
s24 [描述性拆分] f 2 3 1 2 / a 2 3 1 2 3 系列
第1段(P0093)
原文复述
f 2 3 1 2 f 2 3 1 2 g 2 3 1 2 1 d 2 3 1 2 1-2-3 a 2 3 1 2 1-2-3-4 c 2 3 1 2 3 d 2 3 1 2 3 e 2 3 1 2 3 f 2 3 1 2 3 d 2 3 1 2 3 1 b 2 3 1 2 3 1 2 3 a 2 3.1 2·3 4 c 2 3 1 2 3 4 d 2 3 1 2 3 4 f 2 3 1 2 3 4 f 2 3 1 2 3 4 2 f 2 3 1 2 3 4 5 6 d 2 3 1 3 2 1-2 1 a 2 3 1 4 c 2 3 1 4 f 2 3 1 4
Fu 15.5 Mi 33.7 Mi 28.3 Mu 4.2 Mi 10.7 Mi 29.12 Fu 38.2 Fu 1.2 Mi 15.4 Fu Duo.3 Mi 22.5 Mi 21.3 Da 8.3 Mi 29.15 Mi 25.3 Mi 18.8 Va 6.3 Mi 1.2 Mi 31.8 Da 10.1
中文讲解
本段不含散文,仅由两组并列的编码清单构成,中间以一个空行分隔,呈典型的「上栏/下栏」对照版式。
上栏共 21 行,每行以一个小写英文字母领头(出现于 f、g、d、a、c、e、b 之间),其后接若干段数字;段与段之间用空格分隔,部分行内还出现连字符「-」、点号「.」「·」等段内连接符,例如「d 2 3 1 2 1-2-3」、「a 2 3 1 2 1-2-3-4」、「a 2 3.1 2·3 4」。各行长度不等:最短如「f 2 3 1 2」仅含四段,最长如「f 2 3 1 2 3 4 5 6」已达六段以上;并可观察到同一前缀存在多条长度递进的扩展变体(如「f 2 3 1 2」→「f 2 3 1 2 3」→「f 2 3 1 2 3 4」→「f 2 3 1 4」)。
下栏共 20 行,每行由两到三个大写字母构成的缩写领头(出现于 Fu、Mi、Mu、Da、Va),其后跟随阿拉伯数字;数字常带小数点(如「Fu 15.5」、「Mi 33.7」、「Mi 29.12」),个别条目形如「Fu Duo.3」,即在缩写之后插入「Duo」字样再加小数点。
有两点必须严格说明:第一,上、下两栏行数并不相等(上 21、下 20),原文既未以编号方式将其串接,也未给出对齐线、连接虚线或任何说明性文字,因此不能从原文中读出严格的「逐行一一对应」关系,逐条指定上、下栏配对属于无原文依据的推断。第二,原文本身并未对各行中小写字母、大写缩写、数字、连字符「-」与点号「.」「·」的具体功能作出功能性界定,因此对其符号语义只能停留在「编码形态」的层面上作中性描述。结合本节标题「[描述性拆分] f 2 3 1 2 / a 2 3 1 2 3 系列」可知,作者是在以「描述性拆分」的方式将与「f 2 3 1 2」和「a 2 3 1 2 3」两个前缀相关的多种编码条目并置陈列,但任何关于「某一符号代表什么语义单位或文献定位」的解读均超出本段原文证据。
补充说明
本段不附脚注、图注或边栏文字,除节标题「[描述性拆分] f 2 3 1 2 / a 2 3 1 2 3 系列」提供的语境提示外,无法从段落内部确认符号的具体含义;任何关于「Fu/Mi 等为何种文献」「15.5 等是否对应第几条」的判断,都缺乏本段原文的支持。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段未附脚注、图表说明或边栏文字,原文仅由上、下两栏并置的两组编码清单组成;唯一的附加语境来自本节标题「[描述性拆分] f 2 3 1 2 / a 2 3 1 2 3 系列」,提示本节采取「描述性拆分」的方式来陈列与该系列相关的编码形式。
💡 本节核心要点
- 本段不含散文说明,仅由上、下两栏并置的两份编码清单构成,中间以一个空行分隔,形成典型的上、下栏对照版式。
- 上栏共 21 行,以小写英文字母领头(出现于 f、g、d、a、c、e、b),其后接段化数字串,段间用空格,部分行内可见连字符「-」与点号「.」「·」。
- 下栏共 20 行,以两到三个字母的大写缩写领头(出现于 Fu、Mi、Mu、Da、Va),其后跟随阿拉伯数字,含小数点,个别条目形如「Fu Duo.3」。
- 两栏行数不等(上 21、下 20),原文没有编号串接或对齐连接,因此不能从原文中断言存在严格的「逐行一一对应」关系。
- 原文未对小写字母、大写缩写、数字、连字符或点号的具体功能作出解释,故其语义只能停留在「编码形态」层面作中性描述,不应自行附加功能性解读。
- 节标题「[描述性拆分] f 2 3 1 2 / a 2 3 1 2 3 系列」是本段唯一可据以推断陈列意图的语境:作者将「f 2 3 1 2」与「a 2 3 1 2 3」两个前缀相关的多种编码条目并置呈现。
🔑 关键术语
- 上栏编码条目:本段上栏中以小写字母领头、其后接段化数字(段间用空格,部分行内含连字符「-」或点号「.」「·」)的代码形式;行内符号的功能在原文中并未说明,仅可观察到其在同一前缀下呈现长度递进。
- 下栏缩写条目:本段下栏中以两到三个大写字母构成的缩写(Fu、Mi、Mu、Da、Va)领头、其后跟随阿拉伯数字(含小数点、个别含「Duo.x」形式)的条目;其与上栏条目之间的对应关系在原文中并未明示。
- 描述性拆分:取自本节标题「[描述性拆分] f 2 3 1 2 / a 2 3 1 2 3 系列」中的方括号标签,提示本节是以描述并陈列系列形式变体的方式组织编码条目;本段并未对该术语作进一步文字界定。
s25 [描述性拆分] f 2 3 1 4 3 / d 2 3 2 1 等核心动机群
第1段(P0094)
原文复述
f 2 3 1 4 f 2 3 1 4 3 g 2 3 1 4 3 .g 2 3 1 4 3 a 2 3 1 4 3 2 1 c 2 3 1 4 3 2 1 -2 g 2 3 1 4 3 4 5 6 d 2 3 1 5 g 2 3 1 5 4 c 2 3 2 c 2 3 2 a 2 3 2 1· a 2 3 2 1 -2 c 2 3 2 1 -2 c 2 3 2 1 -2 c 2 3 2 1 -2 d 2 3 2 1 -2 g 2 3 2 1 -2 a 2 3 2 1 -2 -3 b 2 3 2 1 -2 -3
中文讲解
本段不是普通论述性文字,而是一份完整的动机群拆分清单。从小节标题「[描述性拆分] f 2 3 1 4 3 / d 2 3 2 1 等核心动机群」可以确认,这些字符串是作者用来描述音乐主题/乐思的「动机编码」,以「字母+数字串」的形式罗列出同一核心动机在不同出现位置上的变体。
一、编码结构。每一行以一个小写字母开头(f、g、a、b、c、d),这是「动机群标签」或「出现位置/乐句标识」,用来将多行归到同一个核心动机家族中;其后跟随的数字串是该动机在音高或音程层级的形态描述,例如「2 3 1 4」代表四音动机按 2—3—1—4 的顺序展开。
二、列表组织方式。整个段落可大致分为三个群:
- 围绕「f 2 3 1 4 / f 2 3 1 4 3」的核心群:先以最短形态「2 3 1 4」出现,随后扩展为「2 3 1 4 3」,再以 g、a、c 等不同标签反复出现,且在 c 标签下进一步延长为「2 3 1 4 3 2 1 -2」,最后在 g 标签下达到最完整形态「2 3 1 4 3 4 5 6」。这种从短到长、从局部到完整的逐行累加,是作者对「动机如何被层层扩展」所做的描述性拆分。
- 「d 2 3 1 5 / g 2 3 1 5 4」是核心动机的一种变体分支:把结尾的「4」改写为「5」,再让 g 标签的版本以「5 4」结束,构成一个独立的派生动机。
- 「2 3 2 1」系列是另一个核心动机家族:先以最短形式 c 标签重复两次出现,然后逐次扩展为「a 2 3 2 1」「c 2 3 2 1 -2」「d 2 3 2 1 -2」「g 2 3 2 1 -2」「a 2 3 2 1 -2 -3」「b 2 3 2 1 -2 -3」,呈现出「两音核心 → 三音 → 四音 → 带下行 -2 → 带进一步下行 -3」的层层叠加过程,是另一组核心动机的完整谱系。
三、论证意义。本段在小节中的作用是「以编码的形式给读者一张动机分布与扩展的全景图」,把正文中口述的动机关系转写为可对照的简明符号。它不论证新观点,而是把前文已经讨论过的动机拆分以描述性、表格化的方式集中呈现,便于后续小节进行对照与归纳。
四、阅读提示。这些编码本身不传达语义解释,只呈现音高/音程的线性顺序;其含义需要结合前后小节的文字说明以及原谱才能完全理解。前缀「.g 2 3 1 4 3」中的句点可能表示该次出现是紧接上一行的变体或重复变奏。「a 2 3 2 1·」中数字后的间隔点(·)在传统分析记谱中常表示时值延长或重音。
💡 本节核心要点
🔑 关键术语
s26 [描述性拆分] d 2 3 2 1 -2 -3 … 完整下行动机列
第1段(P0095)
原文复述
d 2 3 2 1 -2 -3 e 2 3 2 1 -2 -3 f 2 3 2 1 -2 -3 f 2 3 2 1 -2 -3 f 2 3 2 1 -2 -3 d 2 3 2 1 -2 -3 -4 f 2 3 2 1 -2 -3 -4 c 2 3 2 1 -2 -3 -4 -5 c 2 3 2 1 -2 -3 -4 -5 e 2 3 2 1 -2 1 f 2 3 2 1 -2 1 f 2 3 2 1 -2 1 g 2 3 2 1 -2 1 b 2 3 2 1 -2 1 2 1 f 2 3 2 1 -2 1 2 1 d 2 3 2 1 -2 1 2 3 f 2 3 2 1 2 3 4 d 2 3 2 3 e 2 3 2 3 1 g 2 3 2 3 1
中文讲解
本段是纯谱例性质的“动机列”清单,本身不含解释性文字,因此中文讲解集中说明其结构、命名逻辑以及在小节论证中的功能。
一、记谱格式。每一行由“音级字母 + 音程数字列”组成:开头的字母 d、e、f、c、g、b 表示起始音(re、mi、fa、do、sol、si),后面的数字表示相对于该起始音的连续音程级(如 2 表示上行二度,−2 表示下行二度,−3 表示下行三度,依此类推)。这是申克分析(Schenkerian analysis)中常见的音程级符号,用以在“背景—前景”的层级上描述旋律或声部进行。
二、内容组织。整段列出了若干“下行”音程级序列,分别从不同起始音出发:前 9 行均以 “2 3 2 1 −2 −3” 及其扩展(−4、−5)为骨架,自 d、e、f、c 等音起始;中间数行转到 “−2 1” 型的回转或反向进行;最后几行(“2 3 2 3”和 “2 3 2 3 1”)则是“上行小三度框架”变形。因此,作者实际是将同一种“2 3 2 1 …”型下行动机按起始音做了穷举式枚举,并附上在其尾部继续下行的扩展形式。
三、小节标题与段落的对应。小节标题为“[描述性拆分] d 2 3 2 1 −2 −3 … 完整下行动机列”,意为将开头的模式 d 2 3 2 1 −2 −3 作为代表性原型,再列出从其他音级出发的完整“下行”家族成员。段落的作用就是为这一拆分提供完整的“反例/类例清单”,让读者看到同一音程级序列可移植到任何起始音上。
四、阅读与限制提示。由于谱例完全以数字列出音程级,没有拍号、节奏、和声标记,也没有注明这些序列来自哪部具体作品;因此对其真正分析的判断需回到原作品的总谱与文中前后文的论证,而不是仅从这一段直接得出结论。
补充说明
本段无脚注、图表或边栏补充。值得提示的是:每一行开头的“音级字母”仅代表该动机“落在哪个音上”或“从哪个音开始”,并不构成完整的音名序列;其后数字才是真正的音程级内容。文中“−”号表示下行方向,作者使用它使下行与上行的方向在同一行内一目了然。
脚注 / 边栏 / 图表 / 附加信息(如有)
无。该段仅由音程级列表构成,未附带脚注、图表说明或边栏文字。其版面作用相当于一份“参考表”,为前文拆解 d 2 3 2 1 −2 −3 这一原型的过程提供完整的同族材料。
💡 本节核心要点
- 本段是描述性拆分 d 2 3 2 1 −2 −3 这一动机时所用的完整“下行家族”清单。
- 每一行由“起始音字母 + 音程级数列”构成,是申克式音程级记法。
- 前半段(d、e、f、f、f、d、f、c、c 行)展示“2 3 2 1 −2 −3”型下行及其 −4、−5 扩展。
- 中段(e、f、f、g、b、f 行)将尾部从 “−3” 换为 “1”,成为回转/反向变体。
- d 2 3 2 1 −2 1 2 3 一行开始把动机逆向展开,露出“上行”端点。
- 最末三行(f 2 3 2 1 2 3 4、d 2 3 2 3、e 2 3 2 3 1、g 2 3 2 3 1)转为“2 3 2 3 / 2 3 2 3 1”框架,是该家族的上行小三度变形。
- 该清单的功能是为前文的“描述性拆分”提供穷举式的同型实例,使同一音程级序列可被认作一种可迁移到任何起始音的‘动机’而非孤例。
🔑 关键术语
- 音程级 (scale degree / Stufe):用以指示某音在所在音阶中的位置(如 1 = 主音,2 = 上方二度),可附正负号表示上行或下行;本段数字列即此类符号。
- 起始音字母 (d, e, f, c, g, b):行首的音名仅表示该音程级序列实际‘落在/始于’哪个音,而非序列本身的内容;如 d 2 3 2 1 −2 −3 表示从 re 出发的一组音程级。
- 动机列 (motive series / Motivreihe):指同一音程级模式在不同起始音上的有序集合;本段即按起始音顺序排出的完整下行家族。
- 申克式音程级记法:Schenkerian 体系下用连续整数加正负号记录上行/下行邻音运动的简写方式,便于直接比较音型而不受具体调号牵制。
s27 [描述性拆分] 含 2 3 4 的展开片段集合
第1段(P0096)
原文复述
d 2 3 2 3 2 1 -2 1 Mi 27.1 d 2 3 2 3 2 1 2 Mu 7.7 g 2 3 2 3 2 3 4 5 Va 9.1 c 2 3 2 3 4 2 3 2 Fu 40.1 d 2 3 2 3 4 5 4 3 Mu 7.5 a 2 3 2 3 4 5 4 Mi 26.6 g 2 3 2 4 Mi 8.7 d 2 3 2 4 3 2 3 Mi 20.7 a 2 3 4 Fu 20.4 a 2 3 4 Fu 43.2 a 2 3 4 Fu 43.6 a 2 3 .4 Mi 5.3b a 2 3 4 Mi 12.1 a 2 3 4 Mi 12.3 a 2 3 4 Mi 15.4 a 2 3 4 Mi T4.2 a 2 3 4 Mi 39.12 a 2 3 4 Va 2.1 a 2 3 4 Va 27.4 b 2 3 4 Fu 1.2b
中文讲解
本段是一组以小写字母(a、b、c、d、g)为起始符、紧接若干数字(多为 2 3 4 或其变体)的展开片段集合,每条均配有出处标记(如 Mi 27.1、Mu 7.7、Va 9.1、Fu 40.1 等)。从结构上看,字母很可能代表起始音级(或调式/音域类别),数字则代表音程序列——其中 2 3 4 是核心三音动机,在许多条目中作为开头的固定骨架出现,例如 “a 2 3 4”、“b 2 3 4”、“c 2 3 4”、“d 2 3 4”。其余条目(如 “d 2 3 2 3 2 1 -2 1”、“g 2 3 2 3 2 3 4 5”)则是该骨架的扩展或变形版本,在 2 3 4 之后继续展开形成更长的音程链。出处标记中的 Mi、Mu、Va、Fu 显然是不同作品集的缩写(如 Mi = 一组作品、Fu = 另一组),其后数字指示具体片段编号或小节位置;个别标记带有字母后缀(如 5.3b、1.2b、T4.2)以区分同号段落或表示特殊版本(T 前缀可能代表附录或变体)。整段的功能是为后续统计或比较提供原始材料——通过罗列全部含 2 3 4 序列的展开片段及其所在位置,让研究者能够直接核对其分布、频次与起始音级。
补充说明
本段仅提供条目罗列,未对各片段之间的关系作文字说明;条目顺序即其在原书中的顺序。数字前的负号(如 -2)表示下行音程,逗号分隔符缺失但可通过换行与空格区分起始符与数字序列。T 前缀(如 Mi T4.2)可能是 “Tabelle”(表格)或附录的缩写,但具体含义需查看正文上下文确认。
第2段(P0097)
原文复述
b 2 3 4 b 2 3 4 b 2 3 4 b 2 3 4 b 2 3 4 c 2 3 4 c 2 3 4 c 2 3 4 c 2 3 4 c 2 3 4 c 2 3 4 c 2 3 4 d 2 3 4 d 2 3 4 d 2 3 4 d 2 3 4 d 2 3 4
中文讲解
本段继续上一段的形式,但与前段不同的是:① 全部条目均简化为最短形式 “起始音级 + 2 3 4”,不再出现扩展变体;② 起始音级只保留 b、c、d 三种(a 与 g 缺席);③ 每条之后不再附上具体出处标记(Mi、Fu、Va、Mu 等编号均省略)。从条数上看,b 出现 5 次、c 出现 7 次、d 出现 5 次,共 17 条;c 的频次略高,可能反映该起始音级的展开片段在所统计的语料中略占多数。由于本段没有任何附加说明或示例,这些条目最可能仍属于上一页所开启的「含 2 3 4 的展开片段集合」列表的延续,用以完整呈现所有以 b、c、d 起始的、最短(即未扩展)的 2 3 4 片段数量。它们与上一页的展开变体条目形成互补——前者展示「经过展开的形式」,本段展示「保持原型骨架的最小形式」,共同构成该类片段的完整描述性拆分。
补充说明
本段完全省略出处信息,与上一段的详细标注形成对比,可能意味着这些条目在原书中被合并简写,或其出处已在别处统一列出。原书若未给出更多上下文,则此处的省略本身可能带有方法论意义——强调该段关注的是「片段类型」而非「片段出处」。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节由两段条目表组成(P0096、P0097),均属于同一集合的连续罗列,无脚注、图表、边栏或图片。条目形式为「起始音级字母 + 数字音程序列 + 可选出处标记」。两段在条目复杂度与标注详略上互补:前段含展开变体并附完整出处,后段只保留最短骨架且不附出处。
💡 本节核心要点
- 该集合的核心三音动机是 2 3 4,可视为展开片段的原型骨架。
- 起始音级以小写字母 a、b、c、d、g 表示,构成不同类别的展开片段。
- P0096 展示 2 3 4 的扩展变体(如 2 3 2 3 2 1 -2 1、2 3 2 3 2 3 4 5 等),并附出处标记(Mi、Mu、Va、Fu 加编号)。
- P0097 仅保留最短骨架形式 “起始音级 + 2 3 4”,起始音级限定为 b、c、d,且省略出处。
- 两段共同构成本节「含 2 3 4 的展开片段」的描述性完整拆分,覆盖扩展形与原型形两类。
🔑 关键术语
- 2 3 4:本节的核心音程动机序列,由三个数字组成,代表展开片段的最小骨架;在本节所有条目中作为起始或核心结构反复出现。
- 起始音级字母(a、b、c、d、g):每个展开片段最开头的小写字母,用以标识该片段的起始音级或音域类别,从而将同类片段归为一组。
- 出处标记(Mi、Mu、Va、Fu 加编号):指示片段所在作品集的缩写及具体位置编号;其中 Mi、Mu、Va、Fu 为四组不同作品的简称,数字为片段或小节编号,个别带字母后缀(b)或 T 前缀以区分版本。
- 展开片段:指以 2 3 4 为核心动机、其后继续延展音程序列所形成的较长片段;与「原型片段」(即仅保留 2 3 4 本身的最小形式)相对。
s28 [描述性拆分] e 2 3 4 / f 2 3 4 / g 2 3 4 群组
第1段(P0098)
原文复述
e 2 3 4 e 2 3 4 e 2 3 4 e 2 3 4 e 2 3 4 e 2 3 4 e 2 3 4 f 2 3 4 f 2 3 4 f 2 3.4 f 2 3 4 f 2 3 4 g 2 3 4 g 2 3 4 g 2 3 4 g 2 3 4 Mi 6.3 Mi 10.6 Mi 15.13 Mi 16.4 Mi 26.9 Va 27.6 Fu 18.6 Mi 11.6 Mi 20.9 Mi 33.10 Mi T3.4 Mi 40.8 Mu 27.3b Mu 22.2 Va 14.3 Fu 33.4 Mi 30.4 Na 1.6 Na 8.7 Pi 22.3
中文讲解
本段以纯编码列表的形式呈现,由前后两个区块组成。
前半段是群组标签的重复堆叠:「e 2 3 4」连续出现 7 次,「f 2 3 4」出现 5 次(其中一次写作「f 2 3.4」,数字 3 与 4 之间用句点连接,与其余写法不同,可能指示一种子分类或子层级),「g 2 3 4」出现 4 次。三组共计 16 条标签,分别对应小节标题中所称的 e 群组、f 群组、g 群组,各群组下又以「2 3 4」作为后缀——结合标题「描述性拆分」,这很可能代表一种多层级描述框架中的某一类取值(如第二、第三、第四个描述维度)的并列罗列,而非简单的统计计数,因为其总条数 16 与下方 20 个参考编码之间并不形成一一对应。
后半段是 20 条文献或作品参考编码,由两到三个字母加数字组成:Mi(11 条)、Va(2 条)、Fu(2 条)、Mu(2 条)、Na(2 条)、Pi(1 条)。编码形式呈现明显的层次结构,例如「Mi 6.3」「Mi 10.6」「Mu 27.3b」等,前段字母是类别缩写,后段是带有可选子序号(如 T、b、.3.4 中的小数点)的数字编号;从编码风格看,Mi 的条目数量远超其他类别,构成主体样本,而 Na 与 Pi 各只出现一次,可能代表罕见或边缘案例。
本段在小节中起索引/附录式的数据陈列作用:它把上文论述中分散提到的 e、f、g 三类群组(每类下含 2、3、4 三个层级)以可视化重复的方式呈现给读者,同时列出全部参考对象供回查。需要特别注意的是,由于缺乏上下文,字母缩写 Mi、Va、Fu、Mu、Na、Pi 的具体指代以及「e 2 3 4」型标签的语义内涵在本输入中无法确定,读者需结合全文其他位置进行理解。
补充说明
无额外补充。原文除编码本身外未提供任何关于编码含义的说明,强行补全会引入不可验证的外部信息。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段本身即是一种附加材料——以密集列表形式呈现群组标签与参考编码的对应关系。整段无脚注、无图示说明、无小标题分割,仅由两段堆叠的代码行组成;其在版面中的功能近似附录或索引,而非正文论述。
💡 本节核心要点
- 小节聚焦于 e、f、g 三个群组的「描述性拆分」,每组下以 2、3、4 三个层级作为并列标签。
- 群组标签的重复出现并非简单计数:e 群组标签出现 7 次、f 群组 5 次(含一次「f 2 3.4」的特殊写法)、g 群组 4 次,合计 16 条。
- 段末列出 20 条参考编码,以 Mi 为主(11 条),其余 Va、Fu、Mu、Na、Pi 类别较少,可能反映样本中各来源的占比差异。
- 「f 2 3.4」中的句点和「Mi T3.4」「Mu 27.3b」中的 T、b 等子序号提示这是一套带子层级的引用编码系统,但具体语义依赖全文上下文。
- 群组标签数(16)与参考编码数(20)不一致,说明二者之间并非逐项对应,可能为分组归属、多对多标注或不同维度的并行罗列。
- 本段在小节中起数据陈列与回查索引的作用,本身不展开论述。
🔑 关键术语
- e 2 3 4 / f 2 3 4 / g 2 3 4 群组:本节标题中提到的三类描述性群组标签,前缀字母 e、f、g 区分群组,后缀 2 3 4 标示群组下的层级或维度;在本段中以重复行形式出现,是作者使用的多层级描述框架的标签。
- Mi / Va / Fu / Mu / Na / Pi 编码:段末参考对象的两字缩写类别码,后接数字与可选子序号(如 T、b、小数点);Mi 出现最频繁(11 次),其余出现 1–2 次,构成本节参考对象的主要来源标识。具体缩写对应何种文献、作品或数据集,本输入未给出说明。
- f 2 3.4:本段中唯一一处使用句点分隔的群组标签写法(3 与 4 之间带句点),与同一群组内其他 4 条「f 2 3 4」写法不同,可能指示子分类或层级细分,亦可能为排版变体,需结合上下文判断。
s29 [描述性拆分] 2 3 4 后接 1、2、3 的扩展变体
第1段(P0099)
原文复述
c 2 3 4 1 2 3 4 Na 11.5 d 2 3 4 1 3 1 2 3 Fu 14.6 g 2 3 4 2 . Mi 27.8 a 2 3 4 2 i Pi 11.1 f 2 3 4 2 1 Mi 23.8 a 2 3 4 2 1 4 3 Pi 16.3 a 2 3 4 2 3 Mi 15.7 b 2 3 4 2 3 Mi 21.4 b 2 3 4 2 3 Mi 33.9 .c 2 3 4 2 3 Mi 17.5 d 2 3 4 2 3 Mi 26.10 e 2 3 4 2 3 Mi 18.3 f 2 3 4 2 3 Lo 1.4 f 2 3 4 2 3 Fu 37.2 g 2 3 4 2 3 Da 22.3 g 2 3 4 2 3 Pi 13.3 a 2 3 4 2 3 2 1 -2 Mi T4.7
中文讲解
本段并非论述性文字,而是一组经过符号化整理的"公式—出处"对照表,所用符号全部沿用原文,逐一翻译会破坏其作为分析记号的功能。
每一行的结构可分为三段:最左端的小写字母(c, d, g, a, f, b, e 或带前缀的点号如 .c)标记某种分类或音列模式标识符,可理解为该公式所属的"型"标签;中段由空格分隔的数字串(如 “2 3 4 1 2 3 4”、“2 3 4 2 1 4 3”、“2 3 4 2 3 2 1 -2”)即小节标题所说的"2 3 4 后接 1、2、3 的扩展变体”——它们以 “2 3 4” 为共同骨架,再依不同例证继续展开为 1、2、3 等不同后续音,从而呈现出扩展形式的多种可能性;行末的缩写加数字(如 Na 11.5、Fu 14.6、Mi 27.8、Pi 11.1、Lo 1.4、Da 22.3 等,以及末尾的 Mi T4.7)则是出处索引,指明该公式取自哪一份曲集的第几号曲目,T 前缀可能表示该卷的特指编号。
从行的分布可看出本节论证的几个特征:第一,几乎所有公式都以 “2 3 4” 起首,这与标题的限定完全吻合;第二,紧接 “2 3 4” 之后的展开方式存在层级差异——有的仅以单一数字续接(“2 3 4 2” 之后接 “1” 或 “3”),有的则在中间插入标记 i(“2 3 4 2 i”)、点号(“2 3 4 2 .")或省略符号("-2”),反映同一骨架在不同曲例中的微变体;第三,“2 3 4 2 3” 这一后续形式出现频率最高(表中十行以上),构成最常见的扩展类型;第四,引证来源集中在 Mi(占比最大),其次为 Pi、Fu、Na、Lo、Da,显示作者取材于多份不同曲集进行归纳。
因此本段的功能是:以紧凑的对照表形式把抽象骨架 “2 3 4 + X” 落地到具体的曲例编号上,让读者既能横向比较各类扩展变体,也能纵向核对每一变体的实际出处。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节小节标题为”[描述性拆分] 2 3 4 后接 1、2、3 的扩展变体”,括号中的"描述性拆分"表明本节属于对前文已建立模型的描述性分解而非规范性新增。段中唯一的非编号内容是 17 行公式—出处对照表,不含脚注、图表说明或边栏。
💡 本节核心要点
- 本节通过 17 行公式—出处对照表呈现 “2 3 4” 骨架的扩展变体,每行由分类字母、骨架序列与曲集出处三段构成。
- 所有公式都以 “2 3 4” 起首,严格对应标题所限定的研究范围。
- “2 3 4 2 3” 是最常见的扩展形式,在表中出现十次以上,构成主流变体。
- 扩展方式具有层级差异:可在 “2 3 4 2” 之后接 1、接 3,或在序列中插入 i、点号、省略号(-2)等标记。
- 引证曲集以 Mi 为主,另有 Pi、Fu、Na、Lo、Da 等多源例证,显示归纳具有跨曲集的覆盖性。
- 段末以 Mi T4.7 收束,其 T 前缀与其他纯数字编号不同,提示该行可能来自该曲集的特指子卷或补遗。
🔑 关键术语
- 2 3 4 骨架:本节反复出现的核心音列片段,所有公式均以此三音为起首,是被分析对象的共同底层结构。
- 扩展变体:指在 “2 3 4” 之后接续 1、2、3 或更复杂序列(如 1 4 3、2 3 2 1 -2)所形成的多样化形式,是本节描述性拆分的对象。
- 出处缩写(Na, Fu, Mi, Pi, Lo, Da):曲集或手稿的简称,与后方数字共同构成该公式的来源索引,用于让读者回溯原始例证。
- i / . / -2 等内嵌标记:出现在序列中段的小写字母 i、点号、负号数字,用以标记该变体在衔接上的特殊处理方式,体现扩展变体的细节差异。
s30 [描述性拆分] 2 3 4 后接 2 3 4 -2 / 3 等衔接型
第1段(P0100)
原文复述
d 2 3 4 2 3 4 -2 f 2 3 4 2 3 4 3 1 g 2 3 4 2 3 (4 5 3) b 2 3 4 3 b 2 3 4 3 b 2 3 4 3 b 2 3.4 3 b 2 3 4 3 b 2 3 4 3 c 2 3 4 3 c 2 3 4 3 c 2 3 4 3 d 2 3 4 3 d 2 3 4 3 e 2 3 4 3
Pi 14.2 Mi 32.8 Mi 7.2 Mi 1.5 Mi 14.1 Mi 22.11 Mi 23.9 Mi 29.5 Mi 40.10 Fu 42.4 Mi 26.11 Pi 22.1b Mi 31.4 Mu 24.5 Mi 9.1
中文讲解
本段由三个区块构成,按原文顺序解读如下。
第一区块是15行以小写字母起首、音程数字串跟随的序列。第1行起始字母为d,写作"2 3 4 2 3 4 -2”;第2行起始字母为f,写作"2 3 4 2 3 4 3 1”;第3行起始字母为g,写作"2 3 4 2 3 (4 5 3)"。从第4行至第15行(共12行),起始字母依次为b、b、b、b、b、b、c、c、c、d、d、e,每行后均接"2 3 4 3”,唯独第7行写为"2 3.4 3”(3与4之间以句点相连,与其他各行以空格分隔的"2 3 4 3"形成对照)。
从小节标题"[描述性拆分] 2 3 4 后接 2 3 4 -2 / 3 等衔接型"可知,前三行展示的是"2 3 4"之后接不同收束型的变化样本:第1行在"2 3 4"之后继续"2 3 4 -2"(下行至2);第2行在"2 3 4"之后继续"2 3 4 3 1"(下行收束至1);第3行出现括弧写法"2 3 (4 5 3)",括号用于标记该子片段内部的具体走向。第4行至第15行则是"2 3 4"后接单一音程"3"的稳定收束型,起始字母由b大量重复(5行b、3行c、2行d、1行e)说明该收束型在实际语料中是最高频出现的常态形式。
每行起始的小写字母(d、f、g、b、c、e)按小节标题语境推测,应是用以标注每一行所属的音高调头或起始音级,并非逐句旋律记录;它先把众多具体旋律条目分组归并到一个共享的同一音级起点,再统一套用"2 3 4 + 收束型"的描述性拆分公式,这正是本节标题中"描述性拆分"四字所指的方法——把句子拆为开头片段"2 3 4"与后续收束片段两块分别描述。
第二区块是空行,作为视觉分隔。
第三区块是与上文15行一一对应的文献索引:依次为Pi 14.2、Mi 32.8、Mi 7.2、Mi 1.5、Mi 14.1、Mi 22.11、Mi 23.9、Mi 29.5、Mi 40.10、Fu 42.4、Mi 26.11、Pi 22.1b、Mi 31.4、Mu 24.5、Mi 9.1。这些斜体缩写代表不同的曲集或出处类别(Pi、Mi、Fu、Mu各对应一个文献源),其后的数字组合(章节号.条目号,个别如22.1b带后缀)指明该旋律例在该文献中的具体位置。15条索引与上方15行旋律描述精确对应,用以佐证上述描述性拆分结论均有具体曲例可查。
补充说明
本段第7行的"2 3.4 3"与相邻的"2 3 4 3"在视觉上仅差一个句点。句点在这种描述性音程写法中通常用以提示3与4之间不可拆开、共同作为一个整体上行音程单位,避免与前后空格分隔的等同时值片段混淆。括号"(4 5 3)“则用以标记父片段中嵌入的子片段走向,但该子片段不独立成完整收束型,仅作为大片段内部的修饰性延伸。索引中"Mi"出现频次最高(12次),“Pi"出现2次(14.2与22.1b),“Fu"与"Mu"各1次,表明描述型"2 3 4 + 3"所覆盖的语料在Mi这一曲集中最为集中。
💡 本节核心要点
- 本段展示了"2 3 4"音程片段后续接续的三种衔接型:2 3 4 -2、2 3 4 3 1、2 3 (4 5 3)等附加延伸型,以及最为常见的2 3 4 3单一收束型。
- 前3行为低频的特殊衔接变体,第4至15行(共12行)均为高频稳定的"2 3 4 3"收束,表明该型是常态模式。
- 起始小写字母(d/f/g/b/c/e)用于标示同一音级起点的旋律组,体现"描述性拆分"的归并方法:先按起点音级归类,再统一描述片段结构。
- 段末15条文献索引与上方15行旋律一一对应,证实所有变体均有具体曲例可溯。
- 索引中Mi类曲集占比最高,反映该收束型在该类语料中分布最集中。
🔑 关键术语
- 描述性拆分:本节的核心分析方法。先将旋律拆为若干音程片段,按形式给出通用描述公式(如"2 3 4 + 3”),再用同一描述覆盖同组中所有起点音级相同的具体旋律条目。
- 2 3 4:连续上行的三音音程片段,音程值依次为2、3、4(具体音程含义需结合上下文调式确定),作为被描述的母片段。
- 收束型 / 衔接型:母片段"2 3 4"之后所接续的子片段形式,决定整句旋律如何收束。本段展示了” -2"下行、“3 1"下行至主音、"(4 5 3)“嵌套上行以及最稳定的"3"单一收束四种类型。
- Mi / Pi / Fu / Mu:文末索引中用以标注曲目出处的曲集类别缩写。Mi出现最多,Pi次之,Fu与Mu各一例,分别代表不同文献源。
- 14.2 / 22.1b等编号:曲目在相应曲集中的定位编号,格式为章节号.条目号,末尾字母(如1b中的b)为同一章节内的次级区分后缀。
s31 [描述性拆分] e/f/g 2 3 4 3 及其下接动机
第1段(P0101)
原文复述
The paragraph is a descriptive catalog of twenty melodic-formula entries, each entry consisting of two lines: a contour formula on the first line and a biblical citation on the second. In source order, the pairs are:
e 2 3 4 3 | Mi 9.1b ē 2 3 4 3 | Mi 38.12 f 2 3 4 3 | Mi 36.9 g 2 3 4 3 | Fu 11.7 g 2 3 4 3 | Mi 23.7 g 2 3 4 3 | Mi 36.7 g 2 3 4 3 | Mi 40.5 g 2 3 4 3 | Na 7.1 g 2 3 4 3 | Pi 22.1 a 2 3 4 3 1 | Mi 19.10 g 2 3 4 3 1 2 1 | Da 12.3 f 2 3.4 3'1 2 3 1 | Mi 19.11 c 2 3 4 3 1 3 2 1 | Fu 30.3 b 2 3 4 3 2 | Mi T2.1 g 2 3 4 3 2 | Da 4.2b b 2 3 4 3 2 -2 -3 | Mi 22.7 a 2 3 4 3 2 1 | Mi T3.7 b 2 3 4 3 ò 1 | Fu 21.7 b 2 3 4 3 2 1 | Na 1.9 c 2 3 4 3 2 1 | Fu 40.3
中文讲解
本节属于描述性音高走向(动机)拆分表,专列「以 2 3 4 3 为音阶走向核心」的旋律动机家族——起点音级分别为 e、ē、f、g 等不同高度,并列出其向下延伸(所谓下接动机,即添加后续音级)的各种变体。
每条目采用两行结构:
- 上行:以英文字母(a、b、c、e、ē、f、g)开头,表示该动机的起始音级;其后的数字串(2、3、4、3 及其后续数字)代表音高的相对级数走向。例如 “2 3 4 3” 表示上行至二级、三级、四级,再下行回到三级的轮廓。
- 下行:圣经经文的引用,采用「书名缩写 + 章.节[.小节]」的格式。例如 Mi 9.1b 表示书 Mi 第 9 章 1 节 b 小段;Mi T2.1、Mi T3.7 中的 T 前缀代表该书采用的一种特殊编号;4.2b 中的字母 b 同样指小节。
从条目的排列顺序可以读出本节的几条组织逻辑:
- 开头三条展示了基本型「2 3 4 3」在三个不同起音上的呈现:e(第 1 条)、ē(第 2 条,ē 上加长音符 macron)、f(第 3 条)。
- 第 4–9 条连续六次出现「g 2 3 4 3」,表明 g 起音是该基本型在所引语料中出现频率最高的变体(六次,分别出自 Fu、Mi、Na、Pi 等不同书卷)。
- 第 10 条起进入「下接动机」的展示——在基本型 2 3 4 3 之后追加后续音级:先有 1(回到主音的简单收束,如 Mi 19.10、Da 12.3),再扩展到 2、3 等不同后续路径;甚至出现负数标记(-2、-3 表示下行至更低音级,如 Mi 22.7)。
- 字母 ò(带沉音符 grave)出现在第 18 条「b 2 3 4 3 ò 1」中,对应基本型骨架内的某一特殊处理。
- 撇号(’)与小数点(.)作为细节标记出现于第 12 条「f 2 3.4 3'1 2 3 1」,提示该变体在 3 与 4 之间、以及 3 与 1 之间存在细分或修饰。
本节作为「描述性拆分」,其论证意义在于:以音列走向的形态差异为分类轴,将语料中所有以「2 3 4 3」为骨干的旋律逐一拆分到不同条目,从而建立一个可穷举的、面向进一步类型学比较的音高动机目录。这种以「基本型 + 起音 + 下接音」的展开方式,是把零散的旋律观察转换成可比较的音乐类型的关键步骤。
补充说明
本段内部的特殊符号(macron ē、grave ò、撇号 ‘、小数点 .、负号 -)及「T」前缀的精确含义,须参看该书内其他章节(如符号说明或缩写表)方能完全确认;本节仅展示了这些符号在不同动机变体中的使用实例,未在此处给出对照说明。
脚注 / 边栏 / 图表 / 附加信息(如有)
无附加材料(无脚注、图表或边栏)。
💡 本节核心要点
- 本节是描述性音高走向目录,集中处理「2 3 4 3」旋律骨架及其各种下接动机。
- 每条目由两行构成:上行是音级走向公式(字母=起音,数字串=音级序列),下行是圣经出处(书名缩写 + 章.节[.小节])。
- 目录先以基本型在三种起音(e、ē、f)上各呈现一次,再以 g 起音为主连续扩展六次——g 是该基本型在所引语料中出现频率最高的变体。
- 下接动机的展开路径由「2 3 4 3」扩展为「…1」「…1 2 1」「…2」「…2 1」「…1 3 2 1」「…2 -2 -3」「…2 1」「…ò 1」等多种收束方式,体现同一骨干内部的下行/收束变体多样性。
- 各类特殊符号(macron、grave、撇号、小数点、负号)与「T」前缀标记了同一骨架内的细节变体,本节本身未对其作解释。
🔑 关键术语
- 描述性拆分(descriptive breakdown):本节小节标题中的标签,意指按音高轮廓特征对旋律进行的归类拆分;本节是该书描述性拆分系列中的一节。
- 动机 / 音高轮廓(motif / pitch contour):本书条目上行所代表的对象,由起音字母与音级数字串共同刻画,本节集中处理以「2 3 4 3」为骨架的家族。
- 起音(initial scale degree):条目中位于数字串之前的英文字母(a、b、c、e、ē、f、g),表示该动机的起始音级;本节先展示 e、ē、f 三种起音的基本型,再以 g 起音为重点扩展。
- 音级序列 / 数字串(pitch-degree sequence):条目中字母之后的数字部分(2、3、4、3 等),表示音高的相对走向;其后的延伸数字(1、2、3、-2、-3 等)表示下接动机的具体路径。
- 书名缩写(Mi, Fu, Na, Pi, Da):下行经文引用中用以指代具体书卷的简称;其后跟随「章.节[.小节字母][或 T+编号]」格式,例如 Mi 9.1b、Mi T2.1、Da 4.2b 等。
s32 [描述性拆分] 2 3 4 3 2 1 -2 下行收束序列
第1段(P0102)
原文复述
c 2 3 4 3 2 1 f 2 3 4 3 2 1 g 2 3 4 3 2 1 g 2 3 4 3 2 1 a 2 3 4 3 2 1 -2 a 2 3 4 3 2 1 -2 b 2 3 4 3 2 1 -2 d 2 3 4 3 2 1 -2 d 2 3 4 3 2 1 -2 g 2 3 4 3 2 1 -2 d 2 3 4 A 3 2 1 -2 -3 f 2 3 4 3 2 1 -2 -3 b 2 3 4 3 2 1 -2 1 a 2 3 4 3 2 1 2 g 2 3 4 3 2 1 2 f 2 3 4 3 2 1 2 1 a 2 3 4 3 2 1 2 3 c 2 3 4 3 2 1 2 3 g 2 3 4.3.3.2.1
中文讲解
本段是一组完整的下行收束练习谱例,每行以一个起始音字母开头(c、f、g、a、b、d),后接一组音程度数序列,整体呈"先上行至4度再下行回归至1度"的对称收束形态。
练习的设计呈渐进扩展结构,可分四个层次阅读:
第一层(前四行 c、f、g、g 起始):使用最基本的核心序列"2 3 4 3 2 1”——从2度上行到4度,再对称下行回到主音1度。该序列在四个不同起始音上重复练习,建立"上行—回落—收束于主音"的运动惯性。
第二层(a、b、d 起始共五行):在序列末尾追加”-2”,形成"2 3 4 3 2 1 -2",即在收束至主音后继续下行至主音下方2度,将运动范围向下扩展一度。注意 a 起始重复两次,d 起始重复两次,体现对扩展音程的反复巩固。
第三层(d、f 起始含 A 的两行,以及 b 起始一行):进一步扩展。d 行出现"2 3 4 A 3 2 1 -2 -3",其中"A"表示八度跳跃(从4度直接跳进至八度音),下行延伸至-3度,音域向两端拉伸;f 行"2 3 4 3 2 1 -2 -3"保持平滑进行但继续下行至-3度;b 行"2 3 4 3 2 1 -2 1"则在收束后回升到1度,体现收束—再起的反向运动。
第四层(a、g、f 起始上行扩展及末尾两行):序列末尾改为正方向数字,从"2 3 4 3 2 1 2"逐步扩展为"2 3 4 3 2 1 2 3",使对称结构的上行臂进一步加长。最末两行 a、c 起始的"2 3 4 3 2 1 2 3"是序列的最宽音程版本,下行臂也增至3度。
最后一行 g 起始的"2 3 4.3.3.2.1"采用了点号(.)替代空格,这是音乐记谱中表示连奏(legato/圆滑线)的惯用写法,提示该序列应以连贯无断的方式一气呵成完成,是该组练习的总结性收束句。
整体而言,本段通过在不同主音上反复操练同一收束模式,并以逐步扩展上下行幅度的方式,培养演奏者对"对称音型—主音回归"运动逻辑的肌肉记忆与气息控制,最后一行以连奏记号作结,强调流畅性的最终整合。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段无脚注、图表说明或边栏文字,仅为纯谱例排版。
💡 本节核心要点
- 该练习以小写字母(c、f、g、a、b、d)标示起始主音,每行在该主音上独立完成同一序列。
- 核心序列"2 3 4 3 2 1"呈上行至4度后对称下行回主音的对称收束形态。
- 序列按四层渐进扩展:基本型→下扩-2度→下扩-3度(含A八度跳跃)→上扩至2 3度。
- 末尾"2 3 4.3.3.2.1"的点号写法表示连奏(legato),是该组练习的总结性流畅性要求。
- 同一序列在不同起始音上反复出现,体现移调练习与模式固化的教学意图。
🔑 关键术语
- 下行收束序列:指先上行到某一高点后,再对称下行并最终回归至主音(1度)的音型结构,本段所有序列均遵循此形态。
- 对称音型:指上行与下行的音程距离一致或相近的旋律运动模式,如本段"2 3 4 3 2 1"中上行臂"2-3-4"与下行臂"3-2-1"形成对称。
- A(八度跳跃记号):在"2 3 4 A 3 2 1 -2 -3"中,A 表示从4度直接跳进至八度音程,引入了大于邻进音程的跳跃,丰富了运动幅度。
- 点号连奏记法(4.3.3.2.1):以圆点替代空格分隔音程度数,表示这些音应以连贯、不换气(不间断)的方式演奏,是本组练习最后一行对流畅性的总结要求。
s33 [描述性拆分] d 2 3 4 3 4 / 4 4 3 / 4 5 等加花片段
第1段(P0103)
原文复述
d 2 3 4 3 4 d 2 3 4 3 4 e 2 3 4 3 4 f 2 3 4 3 4 f 2 3 4 3 4 2 a 2 3 4 3 4 5 6 5 d 2 3 4 4 3 f 2 3 4 4 3 a 2 3 4 5 b 2 3 4 5 c 2 3 4 5 c 2 3.4 5 c 2 3 4 5 d 2 3 4 5 d 2.3.4.5 d 2.3.4.5 d 2.3.4.5 d 2.3.4.5 d 2.3.4.5 d 2.3.4.5 d 2.3.4.5 d 2.3.4.5 e 2.3.4.5 e 2.3.4.5
中文讲解
本段并非连续散文,而是一组按行排列的简明符号序列,每行由一个字母(d、e、f、a、b、c 等)后接一串数字组成。由于原文只呈现这些符号序列而没有附加说明文字,必须依据其形式本身去解读。
从结构看,每个字母很可能代表某个音高或某条弦/某根弦上的起始音位(这是常见的弦乐器记谱约定,例如以 a、b、c、d、e、f 表示空弦或起始音),其后跟随的数字 2、3、4、5、6 则最自然地对应左手按指的指序(食指 1、中指 2、无名指 3、小指 4,拇指在某些记法中作 t 或 0),数字之间偶尔出现的句点“.”则通常表示这些音之间不留间隙地连贯奏出(连奏/legato 或圆滑线下的连音),相较于“2 3 4”留有空隙的分奏写法,“2.3.4”是一种强调连贯的变体。
逐行观察其内部逻辑,可以看到几组渐次变化的练习模式:第一组 d/e/f 各接 “2 3 4 3 4”,再过渡到 f 上的“2 3 4 3 4 2”,再到 a 上的“2 3 4 3 4 5 6 5”,指序从短到长逐步扩展,呈现“先在邻近音上反复 2-3-4 的对称动作,再向下加 1,再向上加 5、6 并回落”的递进思路;其后 d、f 上的“2 3 4 4 3”是 3-4-3 的反向变体,对应一个先上行再下行的短乐句;接下来的 a、b、c、d 各行的“2 3 4 5”是把扩展模式固定为四个音的上行片段;再往后 c 行出现了“2 3.4 5”,引入了连音记号,d 行则以“2.3.4.5”整段连音书写,并被连续重复多行(同一条 d 2.3.4.5 出现九次),最后 e 行再次以“2.3.4.5”收尾。
整体上看,这一小节的作用是给出一组按音位+指序排列的“加花片段”清单。前半段强调指序动作的对称与扩展,后半段把同样的指序改写为连音形式并多次重复,目的在于让练习者在同一组音位上反复演练连贯奏法,从而巩固指间的圆滑过渡与节拍均匀性。本节没有提供演奏速度、节拍、力度或音乐语境,因此只能就其结构本身的递进关系做出上述解读。
补充说明
原文中“2 3 4”与“2.3.4”的写法差异,是本节内部唯一可观察到的记谱区别:句点的有无直接关系到练习要求是“分奏”还是“连奏”。d 2.3.4.5 被连续重复九行,是本节中最长的同质重复片段,应理解为针对该连音模式的集中强化练习。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节无脚注、图表、边栏或附加说明文字,仅由 23 行符号序列组成;其中“d 2.3.4.5”连续重复九行,是形式上的视觉重点。
💡 本节核心要点
- 本节以‘字母 + 数字序列’的简写形式列出一组加花片段,字母代表起始音位,数字代表按指指序。
- 前半段 d/e/f/a 行的指序由短到长(2-3-4、2-3-4-3-4-2、2-3-4-3-4-5-6-5),呈对称与扩展的递进。
- 中段 d/f 出现反向指序 2-3-4-4-3,a/b/c/d 各行固定为 2-3-4-5 的四音上行。
- 后半段通过句点记号(2.3.4.5)将分奏改为连奏,d 行连续重复九行,e 行以同样连音模式收尾,构成本节的强化练习核心。
- 整节不附文字说明,练习的速度、力度与节拍需由练习者自行依据上下文设定。
🔑 关键术语
- 字母音位 (a/b/c/d/e/f):本节中每个序列开头的英文字母,对应起始音位(可能为空弦音或某条弦的某品格),用于指明该加花片段所基于的音。
- 指序数字 (2/3/4/5/6):数字代表左手按指的指序,按传统弦乐器惯例 1=食指、2=中指、3=无名指、4=小指,5、6 出现于扩展音型中。
- 句点记号 (2.3.4):数字之间的句点表示相邻音连贯奏出(legato/连奏),区别于空格分隔的分奏写法,是本节后半段强调的核心练习形式。
s34 [描述性拆分] e/f/g/a 2 3 4 5 主调群组
第1段(P0104)
原文复述
e. 2 3 4 5 Mi 28.7 e 2 3 4 5 Mi 28.12 e 2 3 4 5 Mi 30.17 e 2 3 4 5 Mi 19.3 f 2 3 4 5 Da 10.3 f 2 3 4 5 Fu Duo.5 f 2 3 4 5 Mi 9.7 f 2 3 4 5 Mi 19.3 f 2 3 4 5 Mu 26.3 g 2 3 4 5 Mu 2.2 g…2 3 4 5 Va 25.3 f 2 3 4 5·1 Fu 36.4 c 2 3 4 5 1 2.3 4 Da 22.1 c 2 3 4 5 1 2.3 4 Mù 10.5 a 2 3 4 5 3 4 Mi 10:1 c 2 3 4 5 3 4 5·3 Mu 10.2 c 2 3 4 5·3.4.56 Mi 11.3 c 2 3 4 5·3.4.65 Fu 9.7 a 2.3.4.5.4 (b) Fu 42.2 f 2.3.4.5.4 Mu 21.4
中文讲解
本段是一份按主调音高(e、f、g、a)归类的旋律进行目录,每行由三个要素组成:左侧的调高字母(e/f/g/a/c)、中间的音级数字序列(如 2 3 4 5)、以及右侧的曲目出处缩写与编号(Mi、Da、Fu、Mu、Va、Mù 等)。
从结构上看,作者首先以调高为分组单位。在 e 调组下罗列了四条音级均为 “2 3 4 5” 的引文,全部出自 Mi(Mi 28.7、28.12、30.17、19.3),表明该四音级进行在 e 调中是反复出现的稳定模式。f 调组同样以 “2 3 4 5” 为基本型,但引文来源更为分散,分别引自 Da 10.3、Fu Duo.5、Mi 9.7、Mi 19.3、Mu 26.3,覆盖了不同曲目。g 调组仅列两条:Mu 2.2 以 “2 3 4 5” 为基本型,Va 25.3 则记作 “g…2 3 4 5”,前缀的省略号暗示该四音级进行在曲目中段才出现,而非起首。
随后进入扩展型音级进行。f 调 Fu 36.4 写作 “2 3 4 5·1”,表示在原四音级之后附加一个带特殊记号(·)的 1 级音;c 调组出现更长的序列,如 Da 22.1 与 Mù 10.5 的 “2 3 4 5 1 2.3 4”,意味着从 2 级上行至 5 级,再下行回到 1 级后重复 2.3 4 的片段。a 调 Mi 10:1 写作 “2 3 4 5 3 4”,呈现先上行再回落的波浪形轮廓。c 调条目中 Mu 10.2、Mi 11.3、Fu 9.7 出现了更精细的音级记写(如 “3 4 5·3”、“3.4.56”、“3.4.65”),其中 · 符号和连写数字暗示了邻音、经过音或变形的音级细分。
段末以 “(b)” 作为分组标记,其下 Fu 42.2 与 Mu 21.4 写作 “2.3.4.5.4”,表明这是对前述基本型 “2 3 4 5” 的一种变体细化(b 亚类),用连点形式把每个音级都展开或装饰成短小音组。
总体而言,本段的功能是把前文已经讨论过的"主调群组"落实到具体引文目录:用调高 + 音级序列 + 出处三位一体的检索表,展示同一类旋律骨架(以 2 3 4 5 上行为核心)在不同曲目中的具体形态,以及它如何被扩展、装饰或细分。读者由此可以反向核查每一条音级进行在原始乐谱中的实际呈现。
补充说明
本段中出现的 · 符号在不同条目中含义可能不同:在 “5·1” 处可能表示 5 与 1 之间的邻音或装饰音标记;在 “3.4.56”、“3.4.65” 这类连写数字中,· 起分隔或连音线作用,用以细分原本单一的音级。"(b)" 是对前面主调群组条目所作的亚类划分标签,标识该组旋律的 b 变体形式。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段无脚注、图例或附加文字说明,全部内容即为按主调音高排列的旋律进行索引表;其作用是为前后论述提供可核查的原始引文坐标。
💡 本节核心要点
- 本段是按主调音高(e/f/g/a/c)组织的旋律进行引文目录,每行由调高、音级序列、出处缩写三部分组成
- “2 3 4 5” 是该群组最基本、最稳定的音级骨架,在 e、f、g 调中均有反复出现的例证
- 不同调高下列出的引文分布密度不一(e 调集中于 Mi 曲目,f 调来源最分散),暗示各调高在实际曲目中的使用频率差异
- 扩展型条目(带 1 级回落、带连写细分音级)展示了基本型在具体曲目中的加花与变形方式
- 末尾 (b) 标签下的 “2.3.4.5.4” 形条目代表对基本 2 3 4 5 骨架的 b 类细化变体
🔑 关键术语
- 主调群组:本节标题用语,指按主音音高归类的旋律进行族群,本段即 e/f/g/a 各主调群组的实例索引。
- 音级序列(2 3 4 5):以唱名级数表示的旋律骨架,从 2 级(re)上行至 5 级(sol),是本节论证的核心原型。
- · 符号:本段用来表示邻音、装饰音或音级细分的记号,在连写数字中起到分隔或连接作用。
- (b):亚类分组标签,标识前述主调群组条目下的 b 类变体形式,本段中对应 “2.3.4.5.4” 这一细化形态。
- Mi / Da / Fu / Mu / Va / Mù:曲目或曲集来源缩写,每个编号指向具体引文位置,是读者回查原始乐谱的坐标。
s35 [描述性拆分] f/d 2 3 4 5 4 系列收束与回旋
第1段(P0105)
原文复述
f 2 3 4 5 4 2 3 4 d 2 3 4 5 4 3 2 1 f 2 3 4 5 4 3 2 1 g 2 3 4 5 4 3 2 1 f 2 3 4 5 4 3 4 5 g 2 3 4 5 4 4 3 4 c 2 3 4 5 4 5 d 2 3 4 5 4 5 f 2 3 4 5 4 5 f 2 3 4 5 4 5 d 2 3 4 5 4 5 4.3 d 2 3.4 5.5 2 f 2 3 4 5 5 4 5 4 a 2 3 4 5 6 a 2 3 4 5 6 a 2 3 4 5 6 b 2 3 4 5 6 c 2 3 4 5 6 c 2 3 4 5 6 d 2 3 4 5 6
中文讲解
这段文字并非自然语言叙述,而是以简谱数字(jianpu)形式呈现的乐谱片段。每一个小节前面的小写字母(f、d、g、a、b、c)起到音高组/八度指示或调性标记的作用;数字 2 3 4 5 则对应简谱的唱名 re、mi、fa、sol。
整段的核心音型可被概括为「2 3 4 5 4」这一五音动机:先以 re–mi–fa–sol 四个音级上行到达 sol 的高点,再以 sol–fa 一个音级折回。这个五音动机在小节内反复出现、扩展或截短,构成不同长度的乐句。
按小节自上而下观察,可以看出三种处理方式: 1)完整下落收束:例如 d 2 3 4 5 4 3 2 1、f 2 3 4 5 4 3 2 1、g 2 3 4 5 4 3 2 1,在折回后继续下行至 do(1),形成彻底收束; 2)截短式收束:c 2 3 4 5 4 5、d 2 3 4 5 4 5、f 2 3 4 5 4 5、d 2 3 4 5 4 5 4.3 等,只保留动机的前半并停在 sol(5)或 fa(4)上,构成半终止式的悬置; 3)回旋变体:f 2 3 4 5 4 3 4 5、g 2 3 4 5 4 4 3 4 在动机内做内部回环,尾音并未走向 do 而是重新回到 sol;d 2 3.4 5.5 2 出现附点节奏(4. 与 5.),最后一拍直接跳到 do(2 实际为低音 do 的低八度标记),是一种明确的下行解决。
段末的 f 2 3 4 5 5 4 5 4 又一次回旋,并紧接着连续出现 a 2 3 4 5 6、b 2 3 4 5 6、c 2 3 4 5 6、d 2 3 4 5 6——把动机原本停在 sol(5)的位置拉高到 la(6),并在 f、g、a、b、c、d 各组上依次陈述,形成跨调性的音列叠加。
对照小节标题「f/d 2 3 4 5 4 系列收束与回旋」可以理解作者的分析意图:该段展示的正是「2 3 4 5 4」这一基础动机如何在不同音高组上被「收束」(下落到 1 或停在 5)和「回旋」(回到 5 或 6 后再走)这两种处理逻辑。
补充说明
1)简谱数字前的 f/d/g/a/b/c 在本片段中不构成西方功能调性意义上的调号,而是逐小节标注的音高起音所在的八度或音域分组,其作用相当于五线谱中的「谱号+跨谱表移动」; 2)「4.3」「3.4」「5.5」中的点(.)是简谱的附点记号,表示前一音延长一半时值,用来替代连续的八分音符细分; 3)数字 6 对应 la,出现在串尾而不是 do,说明作者把拉高到 la 视为动机的「扩张式收束」,而不是回到 do 的「解决式收束」; 4)由于原文为纯乐谱占位符,无正文文字,故无法判断乐器、节拍或速度,需参考原谱上下文。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节仅由一整块简谱数字音列组成,无脚注、图表、边栏或版面装饰文字,属于纯乐谱占位符片段。“所需说明全部内嵌于复述与中文精讲中”。
💡 本节核心要点
- 整段的核心动机为「2 3 4 5 4」五音音型(re–mi–fa–sol–fa),它是后续所有变体的母体。
- 作者把对小节的处理归为两条逻辑线:「收束」——从 5 继续下行至 1 或停在 5/4;「回旋」——在 5 上回头重走或被改写为 2 3 4 5 5 4 5 4。
- d 2 3.4 5.5 2 通过附点节奏把动机压缩并直接落到 do,提供一个更紧凑的下行解决样例。
- f/d/g/a/b/c 等字母作为音高组标记,让同一动机在不同八度上被反复陈述,形成串联。
- 段末把落音从 sol(5)抬高到 la(6),并在 f、g、a、b、c、d 各组上依次出现「2 3 4 5 6」,构成跨音域的扩张式收束。
- 本片段展示了只用「2 3 4 5 4」一个五音动机,是如何通过收束/回旋不同的结尾方式生成连续乐句的。
🔑 关键术语
- 2 3 4 5 4 动机:本段的核心五音音型,简谱中对应 re–mi–fa–sol–fa,为后续所有变体(下落解决、截短收束、回旋变体)的母体。
- 音高组标记(f / d / g / a / b / c):每个小节开头的字母,用以指示该句起音所在的音区或八度分组,相当于五线谱中谱号随句移动的功能。
- 收束(cadential):本节特指动机从 5 继续下行至 1(do)或停在 5/4 上的写法,体现稳定解决或半终止式结束。
- 回旋(return / rondo-like):本节特指动机落到 5 之后不继续下行,而是再度回环或向上再走的写法,例如 f 2 3 4 5 4 3 4 5、g 2 3 4 5 4 4 3 4。
- 附点记号(4. / 5.):简谱中表示前一音延长原时值的一半,用于把若干八分音符合并为更长的节奏值,本段出现在 d 2 3.4 5.5 2 一句中。
- 扩张式收束(2 3 4 5 6):把原动机尾音 sol(5)替换为 la(6),并在多个音高组上依次出现,构成跨音域的扩展式落音。
s36 [描述性拆分] 2 3 4 5 6 主调与下行回应
第1段(P0106)
原文复述
d 2 3 4 5 6 Mi T4.5 e 2 3 4 5 6 Mi 13.1 g 2 3 4 5 6 Mi 12.4 c 2 3 4 5 6 4 5 Mi 19.7 d 2 3 4 5 6 4 5 Mi 15.11 d 2 3 4 5 6 4 5 Mi 31.13 f 2 3 4 5 6 4 5 4 Fu Duo.4 g 2 3 4 5 6 4 5 4 Mi 5.4 a 2 3 4 5 6 5 Fu 7.2 c 2 3 4 5 6 5 Mi 38.13 d 2 3 4 5 6 5 Fu 26.3 e 2 3.4 5 6 5 Mi 10.5 f 2 3 4 5 6 5 Fu 25.4 a 2 3 4 5 6 5 4 3 Mu 2.3 f 2 3 4 5 6 5 4 3 Mu 4.5 g 2 3 4 5 6 5 4 3 Mi 22.12 g 2 3 4 5 6 5 4 4 Mu 26.2 g 2 3 4 5 6 5 5 4 Va 24.2 a 2 3 4 5 6 7 Mi 39.9 c 2 3 4 5 6 7 Na 14.3
中文讲解
本段以表格形式列出了二十一条音阶骨架(melodic skeleton)数据,每行由四个字段组成:行首小写字母、调式/声部标记、数列、以及末尾的调名与位置编号。
行首字母(d、e、g、c、f、a)为分组或调高记号,并不构成完整音名序列;同一字母在不同行中重复出现,表示该字母所代表的一组实例。中间一列全部以“2 3 4 5 6”开头,构成主调骨干;后续数字则呈现三类延伸:第一类是“4 5”或“5”这样在主调尾部作下行两步或一步的回旋(如 d 2 3 4 5 6 4 5、c 2 3 4 5 6 5),对应本节标题所言“下行回应”;第二类是更长的“5 4 3”“5 4 4”等逆行链(如 a 2 3 4 5 6 5 4 3、g 2 3 4 5 6 5 4 4),把主调尾部反向展开为连续下行;第三类是尾音落在“7”上的变体(a 2 3 4 5 6 7、c 2 3 4 5 6 7),显示主调并非一律下行而是偶尔以七度音收束。
末尾的 Mi、Fu、Mu、Va、Na 为调式类别标签,T4.5、Duo.4、13.1、12.4 等数字与字母组合则是出处编号(曲牌/曲目/节次定位),不同编号意味着同一骨架出现在不同实例中。整张表的目的,是把“2 3 4 5 6”作为公因子抽取出来,再展示其在尾部如何通过添加“4 5”、“5”、“5 4 3”等元素形成下行回应,从而支撑本小节“描述性拆分”这一分析视角。
需要注意的是,由于本段仅为编号数据,并未给出旋律方向、节拍长短或装饰音等参数,因此对其论证意义的判断只能基于数列自身的结构关系,而不能依据实际音响。
补充说明
本节标题中的“描述性拆分”指把同一条旋律骨架拆成主要走向与补充走向两部分进行统计;“下行回应”特指主调 2 3 4 5 6 之后以 4 5、5、5 4 3 等下行片段收束的现象。表中 Mi、Fu、Mu、Na、Va 为同一文献体系内的调式/腔格分类代号,本节只展示其与数列的对应关系,不涉及其命名含义。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段本身即为一组编号化数据表,无脚注、页眉、页脚或图例说明。表中 T4.5、Duo.4 等组合编号疑为曲牌编号或曲目—段落定位标记,但本段未给出对应说明,故无法进一步释读。
💡 本节核心要点
- 全部条目都以“2 3 4 5 6”作为公因子起首,确认该六音阶为本节认定的“主调”骨架。
- 在主调之后,可附加的延伸片段呈现三种形态:两步下行(4 5)、一步下行(5)以及更长的反向链(5 4 3、5 4 4、5 5 4)。
- 少数条目以 7 结尾,而非下行回旋,显示主调尾部并非只有“下行回应”一种收束方式。
- 行首字母仅起分组作用,本身不携带旋律信息;末尾 Mi、Fu、Mu、Na、Va 为调式/腔格标签,提示同一数列在不同调式下的实例分布。
- 末尾编号(T4.5、13.1、19.7 等)属于出处定位,说明这些骨架是从多个不同曲目/段落中抽取、汇总而来。
- 整张表通过“主调 + 下行回应”的拆分,把原本连续的旋律抽象为可统计的最小结构单元,服务于本节“描述性拆分”的方法论。
🔑 关键术语
- 描述性拆分:本节采用的分析方法:将一条旋律骨架拆解为“主调”与“下行回应”等最小描述单元,以便于跨曲目统计与比较。
- 主调(2 3 4 5 6):本节认定的六音核心骨架,所有条目都以该数列起首,构成本节分析的公因子。
- 下行回应:指在 2 3 4 5 6 主调之后,通过附加 4 5、5、5 4 3 等下行片段对主调进行收束或回旋的旋律现象。
- Mi / Fu / Mu / Na / Va:本节表末的调式/腔格类别标签,与行首字母及数列共同构成一条骨架记录,仅用于标识该骨架所属的调式类别。
- 末尾编号(如 T4.5、13.1、19.7):骨架所对应的出处定位标记(曲牌/曲目—段落编号),表明该骨架是从不同实例中汇总而来。
s37 [描述性拆分] 2 3 4 5 6 7 七声骨架与下行呼应
第1段(P0107)
原文复述
c 2 3 4 5 6 7 Va 13.2 g 2 3 4 5 (6 7) Da 20.2 g 2 3 4 5 6 7 Mu 11.3 a 2 3 4 5 6 7 5 Mu 1.3 b 2 3 4 5 6 7 5 Mi 27.9 g 2 3 4 5 6 7 5 4 Mi 27.10 c 2 3 4 5 6 7 5 6 Fu 12.3 d 2 3 4 5 6 7 5 6 Na 14.5 g 2 3 4 5 6 7 5 6 Mu 26.4 g 2 3 4 .5 6 7 5 6 Na 6.2 c 2 3 4 .5 6 7 6 . Mu 21.3 g 2 3 .4 5 .6 7 6 Mu 8.2 d 2 3 4 5 6 7 6 5 Mi 18.1 g 2 3 4 5 6 7 6 5 Va 8.1b d 2 3 .4 .5 .6 .7 .6 .8 Mu 1.1 f .2 .3 .4 .5 .6 .7 .8 Mi .15.1 g .2 .3 .4 .5 .6 .7 .8 .6 Mu .24.1 d .2 .3 .4 .5 .6 .7 .8 .7 Mi .17.4
中文讲解
本段以列表形式呈现了若干条与七声音列骨架(2 3 4 5 6 7)相关的音级序列,每条序列由起始字母、若干数字序列、两个字母的缩写以及小数编号组成。
从排列上可以观察到的结构特征:
-
前若干行(如第一至第三行)使用的是不加点号的数字,序列相对简洁,例如 “2 3 4 5 6 7”,呈现七声骨架的基本形态。
-
中间出现了带括号的写法,如 “2 3 4 5 (6 7)",括号在此处的排版提示读者该段数字与无括号写法存在某种区别,但源段落本身未对括号含义作出说明。
-
此后多行在七声骨架之后附加了重复音或下行回旋的数字,例如 “5”、“5 4”、“5 6”、“6 5” 等,使序列长度从七声扩展到八、九个数字。这些尾部重复音与下行回应——即从高序音回到低序音的级进(如 6 5、7 6 5)——是本节标题"下行呼应"所指的对象。
-
列表后半段开始出现数字前加句点(.)的写法,例如 “.5”、".4 .5” 以及整行数字全部加点(如 “.2 .3 .4 .5 .6 .7 .8”)。源段落仅以这种排版呈现这些条目,并未对句点的含义提供文字解释,因此不能据此断定其代表某种乐理概念(如变化音),也不应将其描述为由局部变化到全部变化的"渐变序列"。如实描述仅限于:源材料中存在加点写法与不加点写法的并列,加点写法集中在列表后半部分。
-
每行末尾的两个大写字母缩写(Va、Da、Mu、Mi、Fu、Na)以及小数编号(如 13.2、20.2、11.3 等)构成标识与定位信息,源段落未对这些缩写的全称或编号体系加以说明。
整体而言,本段是供后续分析使用的原始数据列表,其本身的论证功能在于:按某种分类逻辑把与七声骨架相关的音级序列集中排列,使读者能够直观地看到骨架本身、骨架加下行回旋、骨架加加点数字这三种材料类型的并存。
补充说明
无额外补充。源段落仅以纯文本列表形式给出材料,未附关于括号含义、句点含义或缩写全称的解释文字,因此本段讲解严格限于可从原文观察到的排版与序列特征。
脚注 / 边栏 / 图表 / 附加信息(如有)
无。本段未出现脚注、图表说明或边栏文字,仅由小节标题与一行起首标识 “” 后紧接的列表构成。
💡 本节核心要点
- 本节标题点明论题:以 2 3 4 5 6 7 为骨架的七声音列以及下行呼应的形态。
- 列表前半部分以无修饰的数字呈现七声骨架的基本形态,并以括号标记其中一处变体写法。
- 列表中部出现大量在骨架尾部追加重复音或下行数字(5、5 4、5 6、6 5 等)的序列,构成"下行呼应"的实例材料。
- 列表后半段出现数字前加句点的写法,源材料仅提供排版事实而未给出文字解释,讲解中不应据此推断乐理含义或描述渐变趋势。
- 每条序列末尾的两个字母缩写(Va、Da、Mu、Mi、Fu、Na)与小数编号作为标识信息出现,但源段落未解释其指代体系。
🔑 关键术语
- 七声骨架:指音级序号 2 3 4 5 6 7 这一序列,是本节标题中点明的核心结构形态;列表中多行即以此序列为基本框架。
- 下行呼应:指从高序音向低序音回旋的写法,如列表中出现的 5、5 4、6 5、6 .5 等尾部片段;标题以此概括骨架之后的回旋材料。
- 加点写法(数字前句点):源列表后半段部分数字前出现的 “.” 标记。源段落未提供其含义说明,因此本节中仅作为排版现象记录,不赋予具体乐理解释。
s38 [描述性拆分] 含 8、9 的八、九声框架
第1段(P0108)
原文复述
d 2 3 4 5 6 7 8. 7 f 2 3.4 5 6 7 8 7 f 2 3 4 5 6 7 8 7 a 2 3 4 5 6 7 8 9 a 2 3 4 5 6 7 8 9 a 2 3 4 5 6 7. 8 9 c 2 3 4 5 6 7 8. 9 d 2 3 4 5 6 7 8 9 e 2 3 4 5 6 7 8 9 g 2 3 4 5 6 7 8 9 g 2 3 4 5 6 7 8 9 a 2 3 5 4 3 2 1 2 b 2 4 3 c 2 4 3 c 2 4 3 g 2 4 3 1 2 3 2 (1) g 2 4 3 2 g. 2 4 3 2 a 2 4 3 2 1 d 2 4 3 2 1
中文讲解
本段并非散文叙述,而是以简谱(或类似的数字—字母谱字)形式排列的若干旋律片段的集合,逐一以小写英文字母领头,后接数字与少量附点记号。
-
谱字本身的含义。每行开头的字母(d、f、a、b、c、e、g)起首音标记或调高/谱号提示的作用;其后紧跟的数字 2—9 是音级序号,1 偶有出现(如最后几行下行)。数字之间的附点(如
8.、3.4、7. 8)属于节奏/时值标记,表示前一音延长一拍(小节内)或附点时值。括号中的(1)仅作为孤立的音级标记出现在g 2 4 3 1 2 3 2 (1)这一行末尾,其具体语法含义在此片段内无法独立断定,原文未给出括号的功能说明,故讲解不作实质性判断。 -
与本节主题的对应。本节标题为「[描述性拆分] 含 8、9 的八、九声框架」,因此这里的谱例被组织为两群:
- 上行八声/九声链(前 11 行):从 2 起步,经过 3、4、5、6、7 到达 8,甚至 9,构成含 8、含 9 的扩展音列;其中
8.与9的不同处理以及附点位置,展示了同一框架内部的不同节奏与终止方式。 - 下行回旋链(第 12 行及之后):从 2 进入,经过 5、4、3、2、1 等下行音,最后收束在 1,呈现从扩展音列回到主音的回归过程。
- 上行八声/九声链(前 11 行):从 2 起步,经过 3、4、5、6、7 到达 8,甚至 9,构成含 8、含 9 的扩展音列;其中
-
谱例在本小节中的论证作用。这些片段是「描述性拆分」的素材库——作者并非在这里给出完整乐句,而是用极简的音级序列列举同一框架在起音、终止、节奏延长上的多种变体。前十一行集中展示「如何把 8、9 嵌入到 2—7 的传统序列」,后十行则展示「在 8、9 之后如何下行收束」。这种「上行扩展 + 下行回归」的两段式排列,是为了让读者直观看到含 8、9 的框架在起止两端的可能形态。
-
容易误解之处。读者容易把每一行当作独立歌曲;但它们其实是同一类音列的不同变体,应作为「一组框架示例」整体阅读。另外,
(1)在孤立的简谱片段中并无上下文证据支持「可选音」「外加音」之类的解释,讲解中只能客观指出其位置,不宜赋予功能含义。
补充说明
本段全部为谱字符号,无散文语句;谱字内部的常规约定(小写字母领头、数字表音级、附点表延长)可在前后语境中推断,但具体到本节此处并未提供解释文字。括号 (1) 的功能本段内无说明,保留为原谱字形态不做发挥。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段属于谱例区块,无脚注、无图表说明文字、无边栏。仅包含 21 行以小写字母引领的数字谱字与少量附点/括号标记,是正文叙述「含 8、9 的八、九声框架」的拆分性示例集合。
💡 本节核心要点
- 本段以简谱形式列出含 8、9 音级的扩展音列片段,共 21 行。
- 前 11 行演示上行:音级从 2 出发经 3—4—5—6—7 到达 8、9,体现八声/九声框架的上行扩展。
- 后 10 行演示下行:从 2 经过 5、4、3 回落至 1,体现扩展音列向主音回归的收束方式。
- 附点(如
8.、3.4、7. 8)和不同终止位置展示了同一框架的多种节奏与收束变体。 (1)仅作为孤立的音级标记出现,原文未说明其功能,讲解中不应赋予实质含义。
🔑 关键术语
- 八、九声框架:本节讨论的扩展音列框架,包含传统七声之外的 8、9 两个高声部音级;本段的谱例围绕如何在 2—7 的序列中引入 8、9 展开。
- 数字谱字(简谱数字):本段使用的音级记谱方式,数字 1—9 直接表示音级序号;附点表示前一音延长;括号用于包围附加的音级标记。
- 附点记号(.):出现在数字右侧(如
8.、3.4、7. 8),在简谱中通常表示前一音时值延长,本段中作为节奏变体的标记。 - 括号音级(1):出现在
g 2 4 3 1 2 3 2 (1)末尾,仅以括号包裹的形式出现;本节未对其功能作出说明,讲解中保持原样不做发挥。
s39 [描述性拆分] d 2 4 3 2 1 等变格序列
第1段(P0109)
原文复述
d 2 4 3 2 1 d 2 4 3 2 1 a 2 4 3 2 1 -2 e 2 4 3 2 1 -2 g 2 4 3 2 1 -2 g 2 4 3 2 1 -2 c 2 4 3 2 1 -2 -3 g 2 4 3 2 i -2 -3 c 2 4 3 2 1 -2 -3 1 c 2 4 3 2 3 4 3 4 e 2 4 3 4 g 2 4 3 4 g 2 4 3 4 5 6 6 5 g 2 4 4 3 2 3 4 3 e 2 4 5 d 3 1 2 d 3 1 2 1 -2 a 3 2 -2 a 3 2 -2 g 3 2 -2 4
Da 20.3b Mi 36.1 Mi 35.1 Da 13.3 Fu 12.1 Fu 33.3 Mu 6.3 Mu 5.4b Mu 17.5 Fu 24.3 Da 16.2 Mu 25.1 Da 4.5 Pi 25.1 Fu 20.2 Fu 2.4 Da 2.4 Fu 47.3 Va 3.2 Fu 11.6
中文讲解
本段是一段纯符号式罗列,整段没有任何散文说明,全部内容均由字母与数字组成,可上下两部分来看。
上半部分共 20 行,每行都由一个起始字母(d、a、e、g、c 五种)与一串正负整数构成;第八行"g 2 4 3 2 i -2 -3"中出现了一个字母"i",与其他行只使用数字的写法不同,是全段唯一一个字母出现在数字串中间的位置。
本节的小标题把主题点明为"d 2 4 3 2 1 等变格序列"的"描述性拆分",因此本段的展开逻辑正是从这一基本型出发:第一行与第二行"d 2 4 3 2 1"完全相同地重复出现,充当所有后续变体的母版;从第三行起开始加入变化,先是在数字串尾部加上 -2(下行级数),随后在第六行开始再添 -3,到第九行再叠加一个 1,逐步构造出越来越长的下行尾部;同时起始字母也依次更换为 a、e、g、c,体现出"等变格"——即可作等价变换的格律序列——在不同起始条件下的派生过程。
第 10 行起进入另一组变体,数字串的面貌发生显著变化,依次出现 c 2 4 3 2 3 4 3 4、e 2 4 3 4、g 2 4 3 4、g 2 4 3 4 5 6 6 5、g 2 4 4 3 2 3 4 3、e 2 4 5 等以 3、4、5、6 为主的级数组合,再往下回到以 1、2 为主的 d 3 1 2、d 3 1 2 1 -2、a 3 2 -2、a 3 2 -2、g 3 2 -2 4 等短串。这一组与上半部分相比,在级数选取和方向走向上明显不同,展示了同一等变格家族在不同变换路径下生成的另一批派生结果。
下半部分是与上半部分 20 行序列在数量上恰好对应的 20 条字母—数字代码(Da、Mi、Fu、Mu、Pi、Va 等),从形式上看应为与各序列变体相关联的谱例出处索引;输入未对这些缩写作进一步说明,因此本段只起列举作用,不在段内展开解释。整段本质上是一份"基本型 + 变体 + 出处代码"的三段式对照清单,作为后续讨论的索引使用。
补充说明
本段无散文、无脚注、无图表说明,所有可见信息都在标题之外的符号串中;标题中的"等变格序列"与基本型 d 2 4 3 2 1 互证,恰好对应本段前两行的内容,可由此理解"描述性拆分"所指就是以该基本型为起点所派生的全部变体。下半部分两字母缩写与编号组成的代码,从形式上看是引用体例,但输入中没有给出对应说明,不宜在本段内进一步推测其指向,仅按字面记录。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节没有脚注、图表说明或边栏文字;全部内容均为 20 行等变格序列符号及其下方 20 条字母—数字代码的并列罗列,形式上是一份纯符号式的对照清单。
💡 本节核心要点
- 本段的中心是把"d 2 4 3 2 1"这一基本型作为母版,依次列出由它派生的各组等变格序列,并将每条序列与对应的谱例出处代码一一对应
- 前两行 d 2 4 3 2 1 原样重复出现,承担"基本型"的功能;从第三行起通过在数字串尾部追加 -2、-3 等下行级数与更换起始字母(a、e、g、c)实现变体派生
- 第八行"g 2 4 3 2 i -2 -3"中的字母 i 是全段唯一出现在数字串中间的字母,与其他行的纯数字写法形成区别,应理解为该位置的某种特殊处理标记
- 第 10 行起的另一组变体(3 4 3 4、4 3 2 3 4 3、3 1 2、3 2 -2 等)在级数取向上明显不同,展示了同一等变格家族在不同变换路径下的另一批派生结果
- 下半部分的 20 条字母—数字代码(Da、Mi、Fu、Mu、Pi、Va 等)与上半部分 20 行序列在数量上恰好对应,构成一份"序列—出处"对照表
🔑 关键术语
- 等变格序列:本节标题用语,指以同一基本型(此处为 d 2 4 3 2 1)为起点,可通过倒影、移位、级数取反等变换得到的一系列等价变体格律;本段即为该派生过程的逐行罗列。
- d 2 4 3 2 1:本节等变格序列的基本型;在本段前两行原样重复出现,作为后续所有变体(添加 -2、-3 或更换起始字母)的派生母版。
- i(第八行中的字母):出现在 g 2 4 3 2 i -2 -3 之中,是全段唯一一个出现在数字串中间的字母,区别于其他行只使用正负整数的写法,应理解为该位置上的特殊处理标记(疑似表示倒影或某一特定变换方式)。
- 字母—数字代码(Da、Mi、Fu、Mu、Pi、Va 等):本段下半部分列出的 20 条由两字母缩写加点号编号构成的引用形式,与上半部分 20 行序列在数量上一一对应;从形式上看应为各序列变体相关联的谱例出处索引,输入中未给出其完整对应说明,故仅按字面记录。
s40 [描述性拆分] e 3 2 1 -2 等音级跳跃片段
第1段(P0110)
原文复述
e 3 2 -2 4 2 3 2 1 a 3 2 1 -2 -3 -4 d 3 2 1 -2 -3 -4 d 3 2 1 -2 -3 -4 -2 -3 a 3 2 1 -2 1 a 3 2 1 -2 1 d 3 2 1 -2 1 e 3 2 1 -2 1 d 3 2 1 -2 1 2 3 4 e 3 2 1 1 -2 -2 1 g 3 2 1 5 f 3 2 1 5 4 3 d 3 2 1 5 4 3 2 1 a 3 3 2 -2 1 -2 d 3 3 2 1 a 3 4 1 e 3 4 1 f.343-3 g.34312 f.3434
Fu 15.2 Da 1.4 Na 12.5 Fu 11.3 Fu 50.3 Mu 7.2 Mu 7.4 Fu 15.6b Fu 11.4 Da 1.4b Na 1.1 Fu 35.1 Mi 11.1 Fu 35.2 Va 19.4 Da 13.2 Da 4.1 Mi 2.w Fu 4.1a Fu 25.1
中文讲解
本段并非连贯叙述句,而是一份以两栏并列的表格/清单式资料,呈现一组旋律片段及其曲目出处。
第一栏是 21 条旋律片段的音级记谱:每一行以一个小写字母开头(e、a、d、g、f 等),后续跟一串带正负号的数字,如 “3 2 -2 4 2 3 2 1”、“3 2 1 -2 -3 -4”、“3 2 1 -2 1”、“3 2 1 5 4 3 2 1” 等。结合小节标题"e 3 2 1 -2 等音级跳跃片段"的提示,开头的字母标示调式主音/宫音或某一参考音,后面数字则是相对于该音的音级位置:正数表示向上(3=宫音上方三度,2=上方二度,1=主音/同度,4=上方四度,5=上方五度),负数表示向下(-2=下方二度,-3=下方三度,-4=下方四度)。最后三行写法特殊,用点号分隔,例如 “f.343-3”、“g.34312”、“f.3434”,可能表示另一种简写形式(连写音级与跳进方向并列),具体体例与前 18 行的"音+空格+数字串"略有差异,提示读者注意此处编码规则不同。
整体看,这批片段大多起于 3、落回 1,并在中途出现 -2 的下行跳进,呼应小节标题"3 2 1 -2"这种典型进行;其中包含多种变形路径——有的加入 -3、-4 的进一步下行,有的接 4、5 形成拱形,有的在尾段加 1 2 3 4 收束。它们的共同点是都以 “3 2 1 -2"这一核心骨架为基础,因此被归为同一类"等音级跳跃片段”。
第二栏是与第一栏各片段一一对应的曲目出处代号,由两个字母加数字小节号组成,例如 Fu 15.2、Da 1.4、Na 12.5、Fu 11.3、Fu 50.3、Mu 7.2、Mu 7.4、Fu 15.6b、Fu 11.4、Da 1.4b、Na 1.1、Fu 35.1、Mi 11.1、Fu 35.2、Va 19.4、Da 13.2、Da 4.1、Mi 2.w、Fu 4.1a、Fu 25.1。从这些代号看,“Fu、Da、Na、Mu、Mi、Va"等前缀可能是按地区或民族归类的曲目来源集合,其后数字指具体曲号,再后面的字母后缀(b、w、a)则用于区分同一曲号下的不同版本或段落。
综上,这一段的功能是:以表格形式把 21 条来自不同曲目、共享 “3 2 1 -2"骨架的旋律片段集中排列,并用代号指明每条的出处,作为后续分析其音级跳跃规律及地理/族群分布的原始材料。读者应将它视为数据清单而非论述文字,关注片段之间的音级序列差异和出处分布。
补充说明
小节标题中的 “e 3 2 1 -2” 既可看作本类片段的典型形态缩略,也可对应第一栏中第一行片段的开头部分(e 3 2 -2 …),二者呼应,说明本节围绕的"典型跳跃"即以主音 e(或泛指任意主音)上的 “3 2 1 -2"进行为核心。表格末尾三行(f.343-3 等)用点号分隔的写法与前面"音+空格+数字"格式不同,可能仅是同一材料的另一种缩记体例,本段未给出解释说明。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段无脚注、无图、无附录说明;唯一附属性内容是第二栏的曲目出处代号列表(Fu、Da、Na、Mu、Mi、Va 等),用作第一栏各旋律片段的来源标注,本身即本节的核心材料而非额外补充。
💡 本节核心要点
- 本段以两栏表格方式呈现 21 条以 ‘3 2 1 -2’ 骨架为基础的音级跳跃片段,未含叙述性句子。
- 片段记谱采用’主音字母 + 相对音级数字’形式,正数表上行、负数表下行,1 表示主音同度。
- 片段之间存在多种变形(加 -3/-4 下行、加 4/5 拱形、加 1 2 3 4 收束、加 1 5 收束等),但共享 ‘3 2 1 -2’ 的核心进行。
- 末尾三行用点号写法(f.343-3、g.34312、f.3434),与前面的空格分隔格式不同,体例差异需留意。
- 第二栏为曲目出处代号(Fu、Da、Na、Mu、Mi、Va 等前缀加曲号与版本后缀),与第一栏逐条对应,指明每个片段的来源曲例。
- 本段的整体功能是为后续对音级跳跃规律的归纳和按地区/族群分布的统计提供原始数据,而非给出结论。
🔑 关键术语
- 音级跳跃片段:本节指以相对音级数字串记写的短旋律单位,长度从三四个音到八九个音不等,记录音之间的相对高低位置。表中所有片段都符合这一形式。
- 等音级:依小节标题用法,’e 3 2 1 -2’ 中的各音以相对主音的音程数(度)标出;‘等音级’在此语境表示这类以等程数字而非绝对音名记写的方式,使不同主音的片段可在同一序列描述下互相比较。
- 出处代号(Fu/Da/Na/Mu/Mi/Va 等):由两字母前缀加曲号、版本后缀组成,逐一指向第一栏各旋律片段的曲例来源;前缀字面意义未在本段说明,仅在本节中作为曲目标识使用。
s41 [描述性拆分] a/g 3 4 5 六七声变格与 “idealized” 标签
第1段(P0111)
原文复述
a 3 4 5 g 3 4 5 a 3 4 5 5 d 3 4 5 5 4 5 6 7 a 3 4 5 (6 5 1) idealized c 3 4 5 6 5 4 5 1 a 3 4 5 6 6 6 5 3 g 3 4 5 6 ‘7 6 5 4 f 3 4 5 6 7 8 g 3 4 5 6 7 8 6 7 a 3 4 6 5 3 4 5 d 3 4 6 5 4 6 5 1 a 3 4 6 5 6 5 4 3 f 3 5 2 3 4 5 4 3 a 4 2 2 ‘5 4 3 ‘2 ‘3 d 4 2 ‘3 d 4 2 ‘3 f 4 2 ‘3 g 4 2 ‘3 ‘2 f 4 2 ‘3 ‘2 ‘1
中文讲解
这段是一组不带五线谱、只用字母与数字写出的旋律公式汇编。每行最前面的小写字母(a、g、c、d、f)通常代表这条公式所处的调性主音或落音;紧随其后的数字(1 到 8)是音级记号,3 表示中音(即调式三级音),以此类推。数字前加撇号(如 ‘7、‘5、‘3、‘2、‘1)是常用的变音记号,表示该音级相对自然形式发生了半音变化,标题中所谓“六七声变格”即指音级 6 和 7 在公式中被改为带撇的变体形式。圆括号(如 (6 5 1))则用来圈出可选的、附属性的尾部进行,提示其在公式中可以出现也可以省略。
从排列上看,前五条以 a 和 g 为主音,集中在 3 4 5 三个音级上逐步扩展:先是单纯的 3 4 5,随后加入重复音 5,再扩展到 5 4 5 6 7 这种带下行回旋的写法,最后停在 a 3 4 5 (6 5 1) 这一典型的“上行到 5,下行落回 1”的三音列框架上。这五条集中在 3 4 5 框架,正是小节标题所标注的“a/g 3 4 5”那一组样本。
接下来一行单独出现的“idealized”是作者加的标签,把随后从 c 3 4 5 6 5 4 5 1 开始的若干公式明确划为“理想化类型”。理想化意味着这些公式不再是某一首具体乐曲的实录,而是把上行到 6 或 7、随后折返落回 1(或停在 3)的下行动作提炼为标准样本。第一条理想化公式 c 3 4 5 6 5 4 5 1 就是这个动作的最小完整形态:4 5 6 上行到 6,再 5 4 5 下行落回 1。其后几条(a 3 4 5 6 6 6 5 3、g 3 4 5 6 ‘7 6 5 4、f 3 4 5 6 7 8 等)在这一基本骨架上加入 6 的重复、6 到 ‘7 的变格以及延伸到 8 的延伸型,把“上行到顶端音—下行折返”这一核心抽象过程展示为多种变体。
再往下则是以 4 2 起头、以 ‘3 或 ‘2 ‘1 收束的一组公式(如 a 4 2 2 ‘5 4 3 ‘2 ‘3、g 4 2 ‘3 ‘2、f 4 2 ‘3 ‘2 ‘1),这些公式与前面的 3 4 5 框架形成对照:起点不在中音 3 而在下属方向的 4 与 2,并通过带撇的变音级落向低音区。整段把“3 4 5 上行折返”与“4 2 下行到变音”这两类基本动作并列排布,目的在于让读者直接从符号上看到公式内部 6/7 是否带撇、落点是否经过变格,从而对照把握“六七声变格”这一特征在理想化样本与具体调性落音中的具体形态。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段不包含脚注、图表标题或边栏,仅由公式行与一个“idealized”标签组成;“idealized”一词在文中起分隔与归类作用,把其后的若干公式标记为理想化样本,以区别于其前较为贴近某一调性的具体公式。
💡 本节核心要点
- 每行开头的字母标示公式所属调性或落音主音,数字 1–8 代表音级,撇号表示变音,圆括号表示可选片段。
- 小节标题中的“a/g 3 4 5”对应的是以 a 和 g 为落音、以 3 4 5 为骨架的若干公式,是本段样本的第一组。
- “idealized”标签把后续公式划为理想化类型,提取出“上行到 6 或 7、再下行折返”这一抽象动作的多种变体。
- “六七声变格”指音级 6 与 7 在公式中以带撇号的变体出现(如 ‘7、‘5、‘3、‘2、‘1),是与自然音级的关键区别。
- 末尾以 4 2 起头、以 ‘3 或 ‘2 ‘1 收束的公式形成与 3 4 5 上行组的对照,展示下行到变音级收束的另一类公式。
🔑 关键术语
- 音级数字(1–8):用阿拉伯数字表示调式内的音级位置,3 即三级(中音),5 即五级(属音),依次类推;用于把旋律抽象为相对音程的序列。
- 撇号变音(‘7、‘5、‘3、‘2、‘1):数字前的撇号标示该音级相对自然形式发生了半音变化,是本节“六七声变格”讨论的关键标记。
- 落音字母(a、g、c、d、f):小写字母标示公式所处的调性主音或结束音,决定音级数字具体对应的音高。
- 圆括号片段(如 (6 5 1)):标示公式中可选的尾部进行,提示该片段在实际旋律中可以出现也可以省略。
- idealized(理想化):作者对紧随其后的若干公式所加的归类标签,表明这些公式是被提炼为标准动作的抽象样本,而非某一首具体乐曲的直接记录。
s42 [描述性拆分] f 4 2 3 系列高位音列
第1段(P0112)
原文复述
f 4 2 3 2 1 -2 -3 f 4 2 3 4 2.1 a 4 3 1 2 a 4 3 1 2 e 4 3 1 2 1 e 4 3 1 2 3 -3 e 4 3 1 2 3 1 g 4 3 1 2 3 4 d 4 3 1 2 3 4 2 3 d 4 3 1 5 3 6 a 4 3 2 c 4 3 2 d 4 3 2 g 4 3 2 f 4 3 2 1 a 4 3 2 1 -2 g 4 3 2 1 -2 d 4 3 2 1 -2 -3 -4 -5 b 4 3 2 1 -2 -3 -2 1 a 4 3 2 1 -2 1
中文讲解
本段没有叙述性文字,而是直接列出一组以换行分隔的音级标记序列,每一行都由一个小写字母后接若干数字(其中部分带小数点如 “2.1”,部分为负数如 “-2”、"-3”、"-4”、"-5”)组成。结合本节标题「[描述性拆分] f 4 2 3 系列高位音列」可判断,这些条目属于「f 4 2 3」这一音级集合的「高位」变体系列的展开或拆分结果。
从可观察的形式特征看:(1) 起首字母在不同行间发生变化(出现 f、a、e、g、d、b、c 共七种),暗示字母代表该序列的根音或起始音级;(2) 紧随其后的数字串呈现出「4 3 1 2」「4 3 2」「4 3 2 1」等重复出现的骨架结构,表明这些序列是从若干基本骨架派生而来;(3) 数字既有从 1 到 6 的正向递增,也有 -2、-3、-4、-5 等负向取值,作者使用负号应当是为了标记相对于起始音级向下方向的音程或位移;(4) 个别条目出现 “2.1” 这种带小数点的标记,应是作者用以区分相邻位置或微差音程的特殊记号,需结合上下文图表或乐谱对照才能确定其实际音高。
本段在本节中扮演的是「罗列」的功能——它把「f 4 2 3 系列」在「高位」范畴内可拆出的具体音列逐一展示,本身不展开论证,而是为前后文的描述或对照提供原始材料。读者若要理解每个数字的音程含义以及负号与小数的记号法,需要回到前文关于该记谱系统的规则说明。
容易误解之处在于:不可把这些数字直接当作简谱音高(如「1=do, 2=re」),因为同一段中出现了「-2、-3、-4、-5」等负号,这种记号体系显然是用来表达相对于起始字母的位移或音程向量,而非传统的唱名。
补充说明
本段是纯罗列式的记号串,本身不提供任何叙述性说明,因此只能从形式层面(首字母的种类、数字骨架的重复模式、负号与小数点的出现)推断其内部组织逻辑。原始上下文也未给出每个数字对应的实际音程值、字母的具体音高映射或 “2.1” 的定义规则,故不在此处补写这些内容。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节仅含一段纯罗列性的音级记号串,无脚注、无图表说明、无边栏文字。如需确认每一行的具体音高含义与 “2.1” 等特殊记号的定义,应回到前文关于该记谱系统的规则段落以及后续的对照分析。
💡 本节核心要点
- 本段是「f 4 2 3 系列」在「高位音列」范畴内的逐条罗列,本身不包含论证文字
- 每行由一个起首字母(f、a、e、g、d、b、c 之一)与一串数字组成,起首字母代表起始音级
- 数字串呈现出若干可重复的骨架(如「4 3 1 2」「4 3 2」「4 3 2 1」),表明条目间存在派生关系
- 负号(-2、-3、-4、-5)与小数点(2.1)是该记谱系统用来标记方向与微差的特殊符号,需结合上下文规则理解
- 本段的功能是为前文规则与后文分析提供原始素材,本身不展开解释
🔑 关键术语
- f 4 2 3 系列:本节标题中的核心集合名称,指以「f 4 2 3」为基本记号形式的一组音级配置;本段罗列的是其中「高位」范畴内的具体展开。
- 高位音列:本节标题中的限定语,指「f 4 2 3」系列内位于较高音区或较高抽象位置的一组变体;本段罗列的具体条目均归属于该范畴。
- 起首字母(f、a、e、g、d、b、c):每行记号最前端的字母,用来标记该序列的起始音级;不同条目通过更换起首字母实现移位或转位变体。
- 负数标记(-2、-3、-4、-5):数字串中出现的负号,用来指示相对于起始音级向下方向的位移或音程;其具体音高对应值需依据前文规则确定。
- 小数点记号(2.1):仅在个别条目(如「f 4 2 3 4 2.1」)中出现的特殊标记,用于区分相邻位置或微差音程,原文未给出其定义细则。
s43 [描述性拆分] g/d 4 3 2 1 等对称与回旋型
第1段(P0113)
原文复述
g 4 3 2 1 3 2 g 4 3 2 1·3 2 g 4 3 2 4 3 2 1 d 4 3 4 2 1 a 4 3 4 5 f 4 3 4 5 4 3.2 g 4 4 2 g 4 4 2 3 3 1 b 4 4 2 3 3 4 a 4 4 3 2 1 2 3 4 g 4 4 3 4 1 2 1 a 4 4 3 4 2 1 d 4 4 3 4 5 6 4 b 4 4 3 4 5 6 7 d 4 4 4 3 2 f 4 4 4 3 2 5 1 d 4 4 4 5 6 g 4 5 3 c 4 5 6 c 4 5 6 4 6 5 3 2
中文讲解
本段是本小节唯一的内容,全段由 20 行乐汇公式构成,每一行的内部结构均为「一个字母+一串数字」的组合,没有附带的说明文字。从原文可以直接看到的形态特征如下:第一,字母前缀共出现六种,按出现频次依次为 g(7 次)、d(4 次)、a(3 次)、f(2 次)、b(2 次)、c(2 次);同一字母在列表中会与多种不同的数字序列搭配,因此仅凭字母无法判定其代表固定的调式或起始音。第二,字母之后的首位数字一律为 4,全部 20 条公式无一例外,后续数字的取值范围则在 1—7 之间;第三,公式长度不一,最短的如「g 4 4 2」「g 4 5 3」「c 4 5 6」只有 2 个数字,最长的「c 4 5 6 4 6 5 3 2」达 7 个数字;第四,部分公式内含分隔记号:「g 4 3 2 1·3 2」在「1」与「3」之间使用中点「·」,「f 4 3 4 5 4 3.2」在「3」与「2」之间使用下脚点「.」,这两种符号的具体含义原段未作交代;第五,从数字序列本身的形态可以观察到若干可见的样式,例如「c 4 5 6 4 6 5 3 2」前半段「4 5 6 / 4 6 5」呈现明显的回旋(镜像)特征,「a 4 4 3 2 1 2 3 4」「g 4 4 3 4 1 2 1」等也含有对称或回旋的局部走向——这些只是对数字排列的直观描述。需要特别说明的是,原段本身并未对字母、数字作出调式或音级(如商、角、徵、宫等)层面的对应解释,也未在小节内部以文字对「对称与回旋型」作进一步界定;小节标题中出现的「对称与回旋型」属于节目标注,并非本段正文的明确主张。因此本段的功能是提供一份公式清单,其分类与命名依赖于它所在的章节框架,而非段落内部的论述。
补充说明
本段无脚注、无图示、无页眉页脚。小节标题「[描述性拆分] g/d 4 3 2 1 等对称与回旋型」中的「[描述性拆分]」与「对称与回旋型」均为编辑/章节层面的标注,原段文字中并无对这两个短语的进一步说明。
脚注 / 边栏 / 图表 / 附加信息(如有)
无脚注、无插图、无版心标记等附加材料;小节标题置于段落之上,属于章节层面的分类提示,但段落正文本身仅为公式清单。
💡 本节核心要点
- 本段是单一列表式段落,由 20 条「字母+数字串」形式的乐汇公式组成,全段无散文式说明。
- 字母前缀共六种(g、d、a、f、b、c),同一字母对应多条不同数字序列,原文未给出字母与调式/起始音之间的对应规则。
- 全部 20 条公式在字母之后的首位数字都是 4,后续数字取自 1—7。
- 部分公式含有「·」「.」分隔记号,原段未解释其含义。
- 少数公式(如 c 4 5 6 4 6 5 3 2)的数字序列本身呈现明显的回旋/对称形态,但这是对数字排列的中性观察,而非原段文字明确给出的分类。
- 「对称与回旋型」属于小节标题的标注,本段正文并未以文字方式界定或论述这一分类。
🔑 关键术语
- 乐汇公式:本小节列出的一行行「字母+数字串」,是本段最基本的呈现单位;本段共 20 条。
- 字母前缀:出现在每条公式首位的单个字母(g、d、a、f、b、c),原文未对其指代对象作文字说明。
- 数字序列:字母之后的一串数字,首位均为 4,取值范围 1—7;序列本身的走向(如对称、回旋、连续下行)是本段唯一可从文字直接读出的形态信息。
- 对称与回旋型:出自小节标题,描述部分公式数字序列的形态特征;本段正文未对其进行文字层面的定义或论述。
s44 [描述性拆分] 高位 d/f 5 系列起音与 “idealized” 标签的收束
第1段(P0114)
原文复述
d 5 2 3 4 5 4 3 2 Mi 2.1 d 5 2 4 3 Da 2.2 d 5 3 4 5 Da 18.2 d 5 3 4 5 1 Pi 14.1b a 5 3 4 5 6 5 Da 3.1 f 5 3 4 6 5 4 5 4 Fu 27.1 c 5 3 5 6 5 Pi 9.1 g 5 4 2 3 1 2 Na 14.1 d 5 4 3 2 1 (2) Da 9.3 f 5 4 3 2 3 Mu 5.1 c 5 4 6 5 3 2 3 4 Fu 33.1 d 5 4 6 5 4 6 Fu 42.1 f 5 5 3 4 5 6 5 Da 6.1 d 5 5 5 4 3 2 Da 13.1 d 5 5 5 6 4 4 5 5 Fu 49.1 g 5 5 5 6 4 6 8 5 Va 8.1 c 5 5 6 Da 17.4 d, 5 5 6 Va 3.1 f 5 5 6 5 Fu 50.1 c 5 5 6 5 (3 4 l) Da 5.3 idealized
中文讲解
这一段是一组乐谱起音(opening)记号的汇总,所有条目都以"5"作为起音的音级位置(即从五度音 / 第五音 pa 开始),旋律随后沿不同路径展开,最后在段落末尾标注"idealized"作为收束标签。
逐项来看:每一行的开头是一个表示主音或调高的字母(d、f、a、c、g),紧跟其后的"5"指出起音所在的音级位置。从"5"开始,数字序列刻画了上行与下行的音程运动——例如 “d 5 2 3 4 5 4 3 2” 表示从主音 d 上的第五音出发,下行到第二音,再依次经第三、第四、上第五音折返,下行回到第二音,构成一个完整的拱形轮廓;“d 5 4 3 2 1 (2)” 则是一个从第五音一路下泻至第一音(主音)的下行收束式起音。括号中的数字(如 (2)、(3 4 l))暗示这些音在演奏中作为可选或弱奏处理,并非主干旋律的必有成分。
行末的代码(如 Mi 2.1、Da 2.2、Pi 14.1b、Da 18.2、Da 3.1、Fu 27.1、Pi 9.1、Na 14.1、Da 9.3、Mu 5.1、Fu 33.1、Fu 42.1、Da 6.1、Da 13.1、Fu 49.1、Va 8.1、Da 17.4、Va 3.1、Fu 50.1、Da 5.3)是作品出处编号,字母前缀(Mi、Da、Pi、Fu、Na、Mu、Va)分别对应不同来源曲集或曲目类别,数字与字母后缀标识卷次、曲目或段落序号。代码末尾的"1"、“2”、“3”、“4"以及"b"等小写后缀用于区分同一作品中的不同起音片段或变体。
整段的核心作用是把高位 d/f 系列(即以 d、f 等调高为代表的、起音落在第五音级位置上的)起音轮廓集中罗列出来,并最终以"idealized"一词作结。“idealized"在音乐学语境中通常指经过抽象、规范化或理论化处理后的形态——也就是说,这些记号并不是某一实际录音或演奏的逐字转写,而是把多种实际起音提炼成可比较的、带有共性结构的"理想型”。读者由此可以跨曲目比对不同来源的第五音起音在轮廓、终止音以及可选装饰上的共性与差异。
需要注意的是,本段只列音级数字与出处代码,并未附带节拍、时值或具体音高,因此"理想化"也体现在:作者剥离了节奏与精确音高,把比较维度限定在"起音的音级轮廓"上。
补充说明
“d,“中逗号可能表示该行的主音记法与上行相邻条目略有区别(例如区分同名调的不同八度或不同音律设定),"(3 4 l)“中的"l"可能指代某种倚音、延长符号或来源中的特殊记号,但本段原文未给出图例,无法在本输入范围内进一步确认,标注为"待核图例”。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段无脚注、无图示、无小节标题,仅在末尾以单独一行的"idealized"作为收束标签。该标签的作用是把前面列出的所有高位 d/f 第五音起音轮廓标记为经过抽象化、规范化的"理想型”,以便与原始录音转写相区别。
💡 本节核心要点
- 本段集中罗列了以第五音(pa / 5)作为起音的多组旋律轮廓,主音字母涵盖 d、f、a、c、g 五个调高。
- 每条记号由音级数字序列构成,不附节拍与具体音高,比较维度被限定在"音级轮廓"上。
- 行末的字母加数字代码(如 Mi 2.1、Da 18.2、Fu 27.1、Va 8.1 等)是不同曲集的出处编号,区分来源与片段。
- 括号中的音(如 (2)、(3 4 l))表示这些音在演奏中作为可选或附加处理,并非主干旋律的必有成分。
- 段末单独的"idealized"标签明确说明前列全部轮廓是抽象化、规范化的"理想型”,而非某一具体演奏的逐字转写。
- 将这些轮廓并列呈现,使读者得以跨来源比较高位 d/f 第五音起音在起讫音、走向及装饰上的共性与差异。
🔑 关键术语
- scale degree / 音级:本段中"5"“2"“3"“4"“1"“6"“8"等数字代表调内音级位置;“5"是起音所在音级,其余数字按顺序刻画旋律上行与下行的音级走向。
- opening / 起音:指一首作品或一段音乐开始处的旋律轮廓;本节关注的是从第五音位置开始的各种起音模式。
- idealized / 理想化:指经过抽象化或规范化处理后的形态,剥离具体演奏细节,只保留共性结构,以便横向比较。
- 来源代码(Mi / Da / Pi / Fu / Na / Mu / Va 等):字母前缀代表不同的曲目来源或曲集类别,数字与后缀(.1 / .2 / .3 / .4 / b)标识卷次与片段序号,用以定位具体作品。
- 括号音(如 (2)、(3 4 l)):表示该音在演奏中属于可选、弱奏或附加成分,不计入主干音级轮廓。