目录
ch0 Front Matter
- s0 [描述性拆分] Title Page and Approval
- 页码:1-1
- s1 [描述性拆分] Library Codes
- 页码:2-2
- s2 Acknowledgments
- 页码:2-2
- s3 Table of Contents
- 页码:3-3
- s4 List of Figures
- 页码:4-4
- s5 List of Tables
- 页码:4-5
ch1 CHAPTER I: INTRODUCTION
- s6 [描述性拆分] Authorship Problems in Elizabethan Keyboard Variations
- 页码:6-6
- s7 [描述性拆分] Need for Stylistic Identification of Composers
- 页码:6-6
- s8 [描述性拆分] Discriminant Analysis as a Method for Authorship Verification
- 页码:7-7
- s9 [描述性拆分] Limitations of Modern Edition Procedures (Glyn’s Gibbons Edition)
- 页码:7-7
- s10 [描述性拆分] Manuscript Sources of Gibbons’ Music
- 页码:8-8
- s11 [描述性拆分] Anonymous Attributions and Style-Based Editorial Decisions
- 页码:8-8
- s12 [描述性拆分] Consequences of Unverified Attributions
- 页码:9-9
- s13 [描述性拆分] LaRue’s Definition of Style
- 页码:9-9
- s14 [描述性拆分] Quantitative Style Measurement and the SHMRG Framework
- 页码:10-10
- s15 [描述性拆分] Discriminant Analysis as a Model for Style Separation
- 页码:10-10
- s16 [描述性拆分] The Federalist Papers Study as a Model for Authorship Verification
- 页码:11-11
- s17 [描述性拆分] Filler Words as Discriminators in the Federalist Papers Study
- 页码:11-11
- s18 [描述性拆分] Parallels Between the Federalist Papers Method and Musical Style Analysis
- 页码:11-12
- s19 [描述性拆分] Eliminating Evaluative Bias Through Notational Counts
- 页码:12-12
- s20 [描述性拆分] Multivariate Analysis of Composers, Pieces, and Variables
- 页码:12-13
- s21 [描述性拆分] Two Questions Addressed by Discriminant Analysis
- 页码:13-13
- s22 [描述性拆分] Figure I-A and the Need for High Variable Counts
- 页码:14-14
- s23 [描述性拆分] Sample Selection: Pavan Variations and Six Elizabethan Composers
- 页码:15-15
ch2 CHAPTER II: HISTORICAL REVIEW
- s24 [描述性拆分] Overview of a Common Variation School
- 页码:16-16
- s25 [描述性拆分] Composers Treated in this Analysis
- 页码:16-16
- s26 [描述性拆分] Three Points of Convergence Among the Six Composers
- 页码:17-17
- s27 [描述性拆分] The Chapel Royal as a Convergence Point
- 页码:17-17
- s28 [描述性拆分] Table II-B: Chapel Royal Children and Gentlemen
- 页码:17-17
- s29 [描述性拆分] Byrd, Bull, Morley, Gibbons, and the Chapel Royal
- 页码:18-18
- s30 [描述性拆分] Philips, Farnaby, and Non-Chapel-Royal Composers
- 页码:18-18
- s31 [描述性拆分] Table II-C: Musical Degrees at Oxford
- 页码:18-18
- s32 [描述性拆分] Formal Education and Degrees at Oxford
- 页码:19-19
- s33 [描述性拆分] Religious Affiliations and the Fitzwilliam Virginal Book
- 页码:19-20
- s34 Development of the Variation Genre
- 页码:20-20
- s35 [描述性拆分] Early Secular Forerunners and the English Tradition
- 页码:21-21
- s36 [描述性拆分] Definitions of the Variation Form (Nelson and Apel)
- 页码:21-22
- s37 [描述性拆分] Variation Techniques and the Difficulty of Isolating Style
- 页码:22-22
- s38 [描述性拆分] Harmonic, Melodic, and Melodico/Harmonic Variation Categories
- 页码:22-23
- s39 [描述性拆分] Comparison of Variations
- 页码:23-23
- s40 [描述性拆分] Three Lachrymae Pavan Sets: Length, Meter, and Phrase Structure
- 页码:23-24
- s41 [描述性拆分] First Variation Comparisons Across Byrd, Farnaby, and Morley
- 页码:24-24
- s42 [描述性拆分] Five Rhythmic and Textural Variables for Comparison
- 页码:24-25
- s43 [描述性拆分] Table II-E and Texture Ratios by Variation
- 页码:26-26
- s44 [描述性拆分] Table II-F and Within-Variation Textural Variety
- 页码:28-28
- s45 [描述性拆分] Table II-G and Average Chord Size
- 页码:30-30
- s46 [描述性拆分] Summary and Transition to Discriminant Analysis
- 页码:31-31
ch3 CHAPTER III: METHODOLOGY
- s47 [描述性拆分] Variables of Musical Style
- 页码:32-32
- s48 [描述性拆分] Measurement Scales and Their Application to Style
- 页码:32-32
- s49 [描述性拆分] Arguments for Interval- and Ratio-Scaled Variables
- 页码:32-33
- s50 [描述性拆分] Selection of Rhythm and Texture as Primary Variables
- 页码:33-33
- s51 [描述性拆分] Rhythmic Variables: Counting Note Values
- 页码:33-34
- s52 [描述性拆分] Twelve Rhythmic Variables from Counts and Ratios
- 页码:34-34
- s53 [描述性拆分] Textural Variables: Quantifying Voices and Patterns
- 页码:34-35
- s54 [描述性拆分] Defining MMS and MSTD Variables
- 页码:35-35
- s55 [描述性拆分] Polyphonic vs. Homophonic Texture Expectations
- 页码:35-36
- s56 [描述性拆分] Limitations of Fourteen Variables and the Genre Restriction
- 页码:36-36
- s57 Discriminate Analysis
- 页码:36-36
- s58 [描述性拆分] Group Discrimination and the Discriminant Function
- 页码:36-36
- s59 [描述性拆分] Classification of Unknowns and the Probability Level
- 页码:37-37
- s60 [描述性拆分] Probability Densities and Classification Regions
- 页码:37-37
- s61 [描述性拆分] Tatsuoka’s Two-Group Likelihood Rule
- 页码:38-38
- s62 [描述性拆分] MANOVA and the Hypothesis of Group Differences
- 页码:38-38
- s63 [描述性拆分] MANOVA Partition: T = B + W and Wilkes’ Lambda
- 页码:38-39
- s64 [描述性拆分] Discriminant Analysis as a Weighted Ratio (B/W Maximum)
- 页码:39-40
- s65 [描述性拆分] Stepwise Discriminant Analysis Procedure
- 页码:40-40
- s66 [描述性拆分] Summary of the Procedural Plan for This Research
- 页码:40-40
ch4 CHAPTER IV: RESULTS
- s67 CHAPTER IV: RESULTS
- 页码:41-41
- s68 Preliminary Analysis of the Known Pieces
- 页码:41-41
- s69 [描述性拆分] ANOVA and Table IV-A on the Fourteen Variables
- 页码:41-42
- s70 [描述性拆分] DISCRIM on Byrd and Bull Known Pavans (First Half)
- 页码:42-42
- s71 [描述性拆分] Table IV-B Results and Classification Accuracy
- 页码:43-43
- s72 [描述性拆分] Table IV-C Results: Classifying the Second Half as Unknowns
- 页码:43-44
- s73 [描述性拆分] Possible Explanations for Bull’s Weak Second-Half Performance
- 页码:44-44
- s74 [描述性拆分] Discriminate Analysis on all 6 Composers
- 页码:44-44
- s75 [描述性拆分] Table IV-D Results Across the Six Composers
- 页码:44-45
- s76 [描述性拆分] Interpreting Misclassifications in Table IV-D
- 页码:46-46
- s77 [描述性拆分] Classifying Disputed Pieces Using Table IV-E
- 页码:46-46
- s78 [描述性拆分] Discussion of Disputed Piece Classifications
- 页码:46-47
- s79 [描述性拆分] Stepwise Discriminate Analysis
- 页码:47-47
- s80 [描述性拆分] STEPDISC Procedures and Variable Selection
- 页码:47-47
- s81 [描述性拆分] Forward Selection and Backward Elimination Results
- 页码:47-47
- s82 [描述性拆分] Interpreting the Selected Variables (MR2, MMS, etc.)
- 页码:48-49
- s83 Discriminate Analysis Run with Nine Selected Variables
- 页码:49-49
- s84 [描述性拆分] Tables IV-H and IV-I: Classification with Nine Variables
- 页码:49-50
s0 [描述性拆分] Title Page and Approval
第1段(P0001)
原文复述
A MULTIPLE DISCRIMINATE ANALYSIS OF ELIZABETHAN KEYBOARD VARIATIONS
中文讲解
该段为论文主标题,原文以一级标题格式呈现:‘A MULTIPLE DISCRIMINATE ANALYSIS OF ELIZABETHAN KEYBOARD VARIATIONS’,可译为《伊丽莎白时期键盘变奏曲的多重判别分析》。标题由三层信息叠合而成:研究方法(Multiple Discriminate Analysis,‘多重判别分析’,一种用于多变量分类的统计手段)、研究对象的时期标签(Elizabethan,指英国伊丽莎白一世治下时代的英语习用称呼)、研究对象的形式(Keyboard Variations,为键盘乐器而作的变奏体裁)。三者的并置揭示了论文的核心思路——以多变量统计方法对一组同属一个历史时期风格的键盘变奏作品进行分类或差异检验。
补充说明
标题原文写作’Multiple Discriminate Analysis’,本节内仅依据其字面构成作出术语释义,是否为’Multiple Discriminant Analysis’的拼写差异需查阅正文后再行确认。
第2段(P0002)
原文复述
by
中文讲解
原文仅一词’by’。它在英文图书与论文标题页中充当主标题与作者署名之间的介词,作用类似中文的’著’或’作者:’。此处承上启下,把上一行的论文题目引向下行的作者姓名,是美式学位论文标题页的标准衔接词。
第3段(P0003)
原文复述
DONNA SCHENCK-HAMLIN
中文讲解
原文为作者姓名的全大写拼写’DONNA SCHENCK-HAMLIN’,即 Donna Schenck-Hamlin,是本论文的责任作者署名。该署名方式采用连字符连接的复合姓氏,是20世纪80年代美国硕士学位论文标题页常见的姓名排印样式。
第4段(P0004)
原文复述
B. A., University of Oregon, 1975
中文讲解
原文为’B. A., University of Oregon, 1975’,即’文学学士,俄勒冈大学,1975年’。它列出作者在攻读本硕士学位之前已经获得的前置学位(Bachelor of Arts)、授予机构(University of Oregon)与获得年份(1975),是美国学位论文标题页交代作者学历起点的惯用格式。
第5段(P0005)
原文复述
A MASTER’S THESIS
中文讲解
原文为’A MASTER’S THESIS’,意为’一篇硕士学位论文’。此句将本文文件类型明确为硕士层级学位论文,从而与博士学位论文(doctoral dissertation / doctoral thesis)相区分,是标题页上确认论文性质的标签性说明。
第6段(P0006)
原文复述
submitted in partial fulfillment of the
中文讲解
原文以一级标题格式记入,内容为’submitted in partial fulfillment of the’,意为’作为下列……之部分完成条件而提交’。该短语与下一段’requirements for the degree’连读,构成美国学位论文标题页说明提交目的的标准套语,其中’partial fulfillment’点明本次提交仅满足授予该学位所需完成条件中的一项(论文写作)。
补充说明
原文开头的’#‘为源文档处理过程中保留的标题层级标记,非论文本义内容。
第7段(P0007)
原文复述
requirements for the degree
中文讲解
原文为’requirements for the degree’,意为’(授予)该学位所需满足的要求’。该短语与上一段组成完整套语,把论文的提交目的落实为’满足该学位的授予条件’;接下来由’MASTER OF MUSIC’承接,指明该学位的具体名称。
第8段(P0008)
原文复述
MASTER OF MUSIC
中文讲解
原文为’MASTER OF MUSIC’,即’音乐硕士’。此为本次论文所申请的学位名称,通常由音乐学院或大学音乐系授予,下设不同方向(如演奏、理论、作曲等)。
第9段(P0009)
原文复述
Department of Music
中文讲解
原文为’Department of Music’,即’音乐系’。本段标明授予本学位的所属教学单位,与上一段’MASTER OF MUSIC’相配合,明确本论文系由音乐系主导授予的学位成果。
第10段(P0010)
原文复述
KANSAS STATE UNIVERSITY Manhattan, Kansas
中文讲解
原文分两行书写:‘KANSAS STATE UNIVERSITY’(堪萨斯州立大学)和’Manhattan, Kansas’(堪萨斯州曼哈顿市)。前者是授予机构——堪萨斯州立大学;后者是该机构校园所在地(美国中西部)。两行合在一起,用于表明本硕士学位由该大学颁授。
第11段(P0011)
原文复述
1984
中文讲解
原文为'1984’,系论文正式提交的公历年份。该数字与上一段院校信息配合,标定本论文归属的学位授予批次年度。
第12段(P0012)
原文复述
Approved by:
中文讲解
原文为’Approved by:’,意为’经下列人员批准:‘或’审核人:’。它在美国学位论文标题页中是固定栏目标题,用于引出对本论文行使审批签字权的相关人员(通常包括主导师与论文委员会成员),并在视觉上分隔’学位授予说明’与’审核签字’两个版块。
第13段(P0013)
原文复述
中文讲解
原文为标题页上的图像占位符,处于’Approved by:’(上一段)与’Major Professor’(下一段)之间。结合上下文可以判定,此处对应的实物应为论文审核委员会中’主导师’一职的亲笔签名扫描图像,承担’该委员已签字批准论文’这一行政确认功能。该图像的具体笔迹与版式需查阅原件方可确认。
补充说明
图像代替了原本应当手写的签名行;其版面作用是以视觉留痕代替实际签字以履行程序性审批要求。
第14段(P0014)
原文复述
Major Professor
中文讲解
原文为’Major Professor’,意为’主导师’或’首席指导教授’。在美国研究生培养体系中,Major Professor 是学位论文指导委员会的核心成员,对论文选题、研究开展与最终答辩负首要指导责任。该称谓紧接上一图像占位符下方,标明该签字栏所对应的职务身份。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节(即论文第1页的标题页)除14条文字段落外,仅有的非正文元素即 P0013 所指的图像占位符。该图像在原版式上嵌入于’Approved by:’(P0012)与’Major Professor’(P0014)之间,按照美国硕博学位论文标题页的惯例,应为审核委员会成员的亲笔签名(此处对应主导师一职),其版面作用是替代实际签字笔迹以履行’签字批准’的程序性要求。其具体书写样式与签名人姓名需查看原件方可确认。
💡 本节核心要点
- 本节是整篇硕士论文的标题页,本身不含任何论证性内容,全部为元数据性质的版式信息。
- 论文主标题《A MULTIPLE DISCRIMINATE ANALYSIS OF ELIZABETHAN KEYBOARD VARIATIONS》通过’方法+时期+体裁’三层结构,定下以统计手段处理伊丽莎白时期键盘变奏的研究路径。
- 作者为 Donna Schenck-Hamlin,且在1975年已获俄勒冈大学文学士学位——前置学历按美国学位论文标题页惯例列出。
- 目标学位为音乐硕士(Master of Music),由堪萨斯州立大学(KANSAS STATE UNIVERSITY,Manhattan, Kansas)音乐系于1984年授予。
- ‘Approved by:‘与其下的签名图像占位符、‘Major Professor’配合,表明本论文已通过以主导师为核心的委员会审批签字这一行政程序。
- 整页文字排印、署名格式、签字区块的设置均符合20世纪80年代美国硕士学位论文标题页的通行规范。
🔑 关键术语
- Multiple Discriminate Analysis:出现于论文主标题(P0001)。其字面构成为’多重判别分析’,属多变量统计中的分类方法;本节仅依据字面给出术语释义,不引入外部研究史或文献。
- Elizabethan:出现于论文主标题。英语中用以标示英国伊丽莎白一世时代的历史时期标签,在本论文中用以限定’键盘变奏曲’所属的风格与历史时段。
- Keyboard Variations:出现于论文主标题。指为键盘乐器(如古钢琴、管风琴等)所作的变奏体裁,与’Eastonian’组合后构成本论文的研究对象。
- Master’s Thesis:出现于 P0005。指由硕士研究生完成的学位论文,区别于博士论文(Doctoral Dissertation);本论文本身即属此类。
- Master of Music (M.M.):出现于 P0008。音乐领域的专业硕士学位,由音乐学院或综合性大学的音乐系授予。
- Major Professor:出现于 P0014 及 P0013 图像占位符的上下文。美国研究生培养体系中,对学位论文负首要指导责任的教授,是审核委员会的核心成员。
s1 [描述性拆分] Library Codes
第1段(P0015)
原文复述
$$ \frac {L D}{2 6 6 8} $$
中文讲解
这一段以行间公式的形式呈现了一段馆藏代码:分子位置写作 “L D”,分母位置写作 “2 6 6 8”。作者把这段编号放进数学公式环境而不是普通段落,说明它不是供阅读的句子,而是一个被格式化为分数形态的标识符。结合本小节的总标题"Library Codes",可以判断它是整套图书馆编号中的一项;其中 “LD” 可视作前缀(疑似 Library Department 或某分类系列的字母标号),“2668” 是其下的顺序号。分数形式在此处并不承担数学含义,而只是用视觉化的方式将一组代码的前后两段并列呈现,让读者把它们当作一个完整的馆藏条本来识读。
补充说明
本段整段位于 LaTeX 行间公式环境 $$ … $$ 之内,这不是正文叙述,而是从原文献版面中截取下来的一段标记代码;解释时不应赋予其算术或比例意义。
第2段(P0016)
原文复述
A11202 666340
中文讲解
这一段在原文献中以 Markdown 二级标题的形式出现:## A11202 666340。它并不是普通的章节标题,而是一行直接由两段数字组成的代码——前段 “A11202”、后段 “666340”——中间以空格分隔。把它放在 ## 层级,意味着该页以这条馆藏编号作为内容的标头,把后续公式片段"挂"在这条编号之下。换言之,作者用图书馆代码本身来代替常规的章节标题,让目录层级结构与馆藏标识系统形成对应。读到这里应注意:"## “是 Markdown 的排版标记,不属于代码内容,复述时应保留标题层级与编号本体。
补充说明
无额外补充;该段没有可从原文中直接定位的说明性文字,只起到"以编号充当标题"的版面组织作用。
第3段(P0017)
原文复述
$$ 1 9 8 4 $$
中文讲解
这一段以行间公式形式呈现了一段四位数 “1 9 8 4”,在视觉上呈现为带间距的四位数字。结合它在小节中的位置(在馆藏代码群中独立成段),可以判断这并不是参与运算的数学量,而是一段被并入排版的日期或年份标识——就文献惯例而言,四位连写数字最常见的语义即为年份 1984,但原段本身只给出数字,并未注明其指代对象,故应严格理解为"作者在此处嵌入了一个年份性质的代码片段”,而非断言此处一定指 1984 年。它的作用是把时间标签与馆藏代码并置,使读者意识到图书馆代码常常携带着年代维度。
补充说明
原文仅提供四位数字,未附加任何文字、单位或标签;不宜在此处替作者补充出版年份、入藏年份等具体定性。
第4段(P0018)
原文复述
$$ S 3 3 5 $$
中文讲解
这一段以行间公式形式呈现了一段代码 “S 3 3 5”:一个字母 “S” 加上三位数 “335”,各字符之间以显著间距分开。它在小节中属于"Library Codes"系列的最后一条独立条目,与前面的 “LD/2668”、“A11202 666340”、“1984” 并列出现。从形式上看,“S”+ 数字的组合符合图书馆分类法中常见的字母—数字混合代码——前缀字母通常对应某一类目,数字部分为该类目下的细分号——但原段并未交代该代码的具体含义,因此讲解时只能说明它属于这套代码列表的一员,承担"以非正文形式陈列馆藏标识"的功能,而不替作者指认其属于哪一家分类体系。
补充说明
无额外补充;原文只给出代码本体,没有附加类目说明或定义。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节包含四段非正文性条目,其中三段(P0015、P0017、P0018)以 LaTeX 行间公式环境 $$ … $$ 包夹,另有一段(P0016)以 Markdown 二级标题 ## 标记。它们共同的特点是:原文中段内没有自然语言句子,只有字母与数字组成的代码片段。这些视觉分隔(公式环境、标题标记、数字之间的空格)并非数学或排版意义上的运算,而是在"Library Codes"这一总标题下,被作者借用来把一组馆藏编号以醒目的版面方式逐条陈列出来。讲解时应保留对原貌的描述,而不是把这些片段译写为普通句子。本小节内部没有脚注、图表、图说或边栏需要单独汇总。
💡 本节核心要点
- 本小节以"Library Codes(图书馆代码)“为总题,逐条陈列若干馆藏标识,而非连贯叙述。
- P0015 把 “LD” 置于分子位、“2668” 置于分母位,构成一段以分数形态并列呈现的双段式代码。
- P0016 以 Markdown 二级标题直接展示 “A11202 666340”,用代码本身充当该段内容的标头。
- P0017 的 “1984” 与 P0018 的 “S335” 同样被置入公式环境,强调它们是标识符而非叙述文字。
- 整组段落的共同手法是:让字母—数字代码占据版面,并借助公式环境或标题语法制造出"被陈列"的视觉效果。
🔑 关键术语
- Library Codes:本小节的总题,指本组段落所陈列的一组字母与数字组合的馆藏标识;在原文中以公式环境或 Markdown 标题呈现,本身不承担叙述功能。
- 分数式代码 (LD / 2668):本小节 P0015 的样式:作者把一段字母前缀与一段顺序号分别置于分子与分母位置,使其在视觉上像一条分数,但并无算术含义,仅用于并列展示两段代码。
- 代码式标题 (A11202 666340):本小节 P0016 的样式:以馆藏编号充当 Markdown 二级标题内容,让目录层级直接由馆藏标识承担,弱化文字标题的叙述职能。
s2 Acknowledgments
第1段(P0019)
原文复述
Section heading: “## ACKNOWLEDGMENTS” — a level-2 Markdown heading that opens the acknowledgments section of the thesis on page 2.
中文讲解
本段不是正文,而是该节的小节标题。它以二级 Markdown 标题的形式将本节命名为 “ACKNOWLEDGMENTS”(致谢),标志着论文从正文部分转入致谢部分,开启对在论文写作过程中提供帮助的人员的感谢。这一标题本身不承载论证内容,仅起版面分割和标识功能。
补充说明
标题中的 “##” 是 Markdown 的二级标题语法符号,不属于标题文字本身;本节作为前置材料,紧邻摘要或目录之后、目录之前或主体正文之前的版面位置,依各校论文模板而定,本节未提供更具体的版式线索。
第2段(P0020)
原文复述
From inspiration to completion, several contributors to this thesis deserve my grateful acknowledgment. Dr. George Milliken’s assistance with statistical interpretation and Dr. Mary Ellen Sutton’s scrutiny of the musical variables provided necessary checks along the way. Dr. Chappell White’s patience, William Schenck-Hamlin’s persistence, and Nikki Carpenter’s perfectionism helped bring this project to fruition.
中文讲解
本段是致谢节的正文,完整表达作者对多位协助者的感谢。作者先用 “From inspiration to completion”(从灵感萌发到最终完成)框定时间跨度,强调感谢覆盖写作全程,再以 “several contributors”(数位贡献者)引出名单。
随后作者列举五位具体贡献者,每位都附带其所提供的具体帮助:Dr. George Milliken 协助 “statistical interpretation”(统计解读),Dr. Mary Ellen Sutton 对 “musical variables”(音乐变量)进行 “scrutiny”(审阅/细致核查),Dr. Chappell White 提供 “patience”(耐心),William Schenck-Hamlin 体现 “persistence”(坚持不懈),Nikki Carpenter 表现出 “perfectionism”(追求完美)。前两位以专业角色对应学术内容(统计与音乐变量),后三位以性格品质对应写作过程的态度支持,这一分工暗示论文既涉及定量统计也涉及音乐学变量分析。
最后 “helped bring this project to fruition”(帮助使本项目得以完成)作为收束语,将上述个人贡献汇拢到论文最终完成这一结果上。整段语气正式而克制,使用 “deserve my grateful acknowledgment”(值得我衷心感谢)这一较郑重的表达,符合学位论文致谢的体裁惯例。
补充说明
本段透露的关键事实——论文同时涉及统计解读与音乐变量——为后文理解作者的研究方法与对象提供了提示;这些细节仅来源于致谢段本身,不构成对论文主题的独立论断。
第3段(P0021)
原文复述
A LaTeX math-display block containing the text “c. 2” — appearing as a page-level notation (likely a running footer/header) on page 2 of the document.
中文讲解
本段并非正文,而是一个以 LaTeX 数学环境 $$ … $$ 包裹的版面元素,内容为 “c. 2”。从上下文判断,它位于页面底端或页眉位置,应为页码或章节标识类标记:“c.” 可能表示 “chapter”(章节)或 “column”(栏),而 “2” 对应当前的页码或章节序号。
由于本段内容并非论证性文字,不承载任何学术主张,因此在中文释义中仅需说明其版面属性。读者无需据此推断任何研究结论,仅需将其视为排版残留或 OCR 抽取过程中被捕获的页眉/页脚片段。
补充说明
由于原输入未提供该符号的具体版面位置或模板说明,“c. 2” 的确切含义(章节编号、栏编号抑或页码缩写)只能依据常见排版惯例作最可能的推测,原文并未给出明确定义。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节除正文段落 P0020 外,仅含一个二级标题 P0019 与一个疑似页眉/页脚版面标记 P0021(“c. 2”),无脚注、图表、边栏或参考文献条目等其他附加材料。
💡 本节核心要点
- 本节为论文的致谢部分,承担对协助者的致谢功能,不承担论证功能。
- 致谢覆盖写作全过程,从灵感萌发(inspiration)直至最终完成(completion)。
- 作者点名感谢五位贡献者,分工明确:Dr. George Milliken 负责统计解读,Dr. Mary Ellen Sutton 负责音乐变量的审阅,Dr. Chappell White、William Schenck-Hamlin、Nikki Carpenter 三人则以个人品质(耐心、坚持、追求完美)支持写作过程。
- 致谢段间接揭示论文的研究内容兼具定量统计与音乐学变量分析两个维度。
- 本节末尾的 “c. 2” 为页眉/页脚版面标记,不构成正文内容。
🔑 关键术语
- ACKNOWLEDGMENTS:致谢节标题,论文前置材料中用于向在研究或写作过程中提供帮助的个人或机构表达感谢的版块;本节中指向 Dr. George Milliken、Dr. Mary Ellen Sutton、Dr. Chappell White、William Schenck-Hamlin 与 Nikki Carpenter 五位协助者。
- statistical interpretation:统计解读,指对研究中所收集的定量数据进行统计分析与结果阐释的工作;在本节中由 Dr. George Milliken 协助完成,提示论文包含统计方法的应用。
- musical variables:音乐变量,指研究中被识别、编码或测量到的与音乐相关的变量(如音高、节奏、调性等可量化或可分类的特征);本节中由 Dr. Mary Ellen Sutton 负责审阅,提示论文以音乐学素材作为研究对象之一。
- fruition:完成、得以实现;本节 “helped bring this project to fruition” 表示在上述协助者的支持下论文最终得以完成,是一种正式而克制的收束表达。
s3 Table of Contents
第1段(P0022)
原文复述
TABLE OF CONTENTS
中文讲解
这是论文第三页上的一个二级标题,标示本页及随后的目录内容。该标题本身不包含任何论证信息,它的功能是告知读者此处开始列出全书的章节结构与页码定位,方便读者快速翻阅。
第2段(P0023)
原文复述
CHAPTER I: INTRODUCTION ….. 1 CHAPTER II: HISTORICAL REVIEW ….. 11 Composers Treated in this Analysis ….. 11 Development of the Variation Genre ….. 15 Comparison of Variations ….. 18 CHAPTER III: METHODOLOGY ….. 27 Discriminant Analysis ….. 31 CHAPTER IV: RESULTS ….. 36 Preliminary Analysis of the Known Pieces ….. 36 Discriminate Analysis on all 6 Composers ….. 39 Stepwise Discriminate Analysis ….. 42 Discriminate Analysis Run with Nine Selected Variables . 44 CHAPTER V: CONCLUSIONS ….. 48 Variables ….. 48 Composers ….. 51 Discriminate Analysis ….. 56 APPENDIX 1 ….. 59 A Source List of Pavan Variations APPENDIX 2 ….. 63 Analysis of Variance Results for All Composers on All Variables FOOTNOTES ….. 67 BIBLIOGRAPHY ….. 70
中文讲解
这是该论文的目录页,按照章节顺序罗列了五个正文章节、两个附录、脚注和参考文献,并给出每一项起始页码。从结构上可以读出作者的论证安排:第一章(绪论,第1页起)引入主题;第二章(历史回顾,第11页起)下设三个小节,分别介绍本分析涉及的作曲家(11页)、变奏曲体裁的发展(15页)以及不同变奏曲的比较(18页);第三章(方法,第27页起)专门以判别分析(Discriminant Analysis,31页)作为核心统计手段;第四章(结果,第36页起)依次呈现对已知作品的初步分析(36页)、对全部六位作曲家的判别分析(39页)、逐步判别分析(42页)以及用九个筛选变量再次运行的判别分析(44页);第五章(结论,第48页起)从变量(48页)、作曲家(51页)、判别分析(56页)三个角度进行收束。附录1(第59页起)提供帕凡变奏曲的资料来源清单,附录2(第63页起)给出全部作曲家在全部变量上的方差分析结果;脚注位于第67页,参考文献位于第70页。值得注意的是,目录中出现了两种略有差异的拼写——“Discriminant Analysis”(第三章)与“Discriminate Analysis”(第四、第五章部分小节标题),这是原文如此呈现,读者可据此判断作者并未统一术语拼写;目录同样显示分析对象是六位作曲家所写的帕凡变奏曲,统计方法以判别分析为主。
补充说明
附录1与附录2的页码分别标注在章节标题行的右侧,但其下方的说明行(如“A Source List of Pavan Variations”“Analysis of Variance Results for All Composers on All Variables”)并未重复页码,表明这些说明行属于各自附录的副标题,紧随主标题之下的同一附录内。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节为论文目录,自身不包含正文论述;附录1与附录2的副标题行(“A Source List of Pavan Variations”“Analysis of Variance Results for All Composers on All Variables”)作为附录内容的指引,与对应页码共同构成目录的完整条目。
💡 本节核心要点
- 本论文围绕帕凡变奏曲展开,分析对象为六位作曲家的相关作品。
- 核心统计方法为判别分析(Discriminant Analysis),并辅以方差分析(附录2)。
- 结构分为五章:绪论、历史回顾、方法、结果、结论,加上两个附录、脚注与参考文献。
- 第四章结果部分从初步分析、全样本判别、逐步判别到变量筛选后判别,呈现逐层推进的分析策略。
- 术语在目录中出现两种拼写:Discriminant Analysis 与 Discriminate Analysis,提示原文未做统一。
🔑 关键术语
- Pavan Variations:帕凡变奏曲;本论文的核心研究对象,由六位作曲家的相关作品构成样本。
- Discriminant Analysis:判别分析;第三章起被确立为本研究的主要统计方法,用以区分不同作曲家。
- Discriminate Analysis:判别分析;与 Discriminant Analysis 指同一方法,但在第四、第五章部分小节标题中出现不同拼写,原文未统一。
- Stepwise Discriminate Analysis:逐步判别分析;第四章中的一种变量筛选与判别同时进行的统计策略。
- Analysis of Variance:方差分析;附录2 中对全部作曲家在全部变量上的分析结果,是辅助统计手段。
s4 List of Figures
第1段(P0024)
原文复述
LIST OF FIGURES
中文讲解
本段是位于第4页的一个二级章节标题(写作 “## LIST OF FIGURES”,对应"图表目录"或"插图目录”),其功能是开启全文的图示清单页。它不承载任何论证内容,而是作为版面前置部分,提示读者其后将以编号方式列出文中出现的全部插图及其所在页码,以便在阅读正文时按需回查。
第2段(P0025)
原文复述
FIGURE I-A: Effectiveness of Two Measurements Taken Simultaneously in Separating Two Groups (A and B) ….. 9 FIGURE II-A: Plot of Average Degrees of Chordal Texture, by Variation Lachrymae Pavans, by Byrd, Morley, and Gibbons … 22 FIGURE II-B: Plot of Within-Variation Deviation From Average Chordal Texture Lachrymae Pavans, by Byrd, Morley, and Gibbons … 24 FIGURE III-A: Classification Regions for Two Populations ….. 32
中文讲解
本段是图表目录的正文条目,按原文顺序逐条复现了三组(实际为四个)图示的编号、说明文字与所在页码:
- FIGURE I-A(第9页):标题为"同时采用两种测量在区分两组(A 与 B)时的有效性"。这一条目提示读者,正文第一章(Chapter I)将出现一幅用于展示判别/分类效果的图,横轴与纵轴通常代表两种测量变量,用以考察它们共同划分 A、B 两组的能力。
- FIGURE II-A(第22页):标题为"按 Byrd、Morley、Gibbons 三位作曲家所作《Lachrymae Pavans》各变体(Variation)绘制的和声织体平均度(Average Degrees of Chordal Texture)图"。此条说明第二章将以该作品为研究对象,对每位作曲家各自的不同变体计算和声织体的均值并作图比较。
- FIGURE II-B(第24页):标题为"按 Byrd、Morley、Gibbons 三位作曲家所作《Lachrymae Pavans》各变体绘制相对于和声织体均值的偏差(Within-Variation Deviation)图"。它与 FIGURE II-A 配对——前者呈现总体均值,后者呈现各变体内部的离散程度,便于读者同时把握集中趋势与变异情况。
- FIGURE III-A(第32页):标题为"两个总体的分类区域(Classification Regions)"。这表明第三章将出现一幅展示判别边界或分类区域的图,常见于统计学中用于直观呈现两组数据被划分到不同决策区的方式。
上述条目均采用"编号 + 冒号 + 说明 + 省略号/点引导 + 页码"的目录排版格式;省略号与点的功能是版面填充(dot leaders),将说明与页码在视觉上对齐,本身不具有语义。
补充说明
本段目录条目中的 FIGURE 编号采用"罗马数字-大写字母"结构(I-A、II-A、II-B、III-A),可推测正文以罗马数字标识章号、以大写字母标识该章内的第几张图;同一章下出现 A、B 两个字母时(如 II-A 与 II-B),通常意味着两图属于一组相互对照的图示。Chordal Texture 一词在本目录中已两次出现(第22与24页),是第二章的核心分析维度,读者在进入该章正文时可优先回查此处。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节仅包含一个章节标题(P0024,"## LIST OF FIGURES")与紧随其后的一条目录正文条目(P0025),无脚注、无边栏、无独立图示、无参考文献。条目中以省略号/点群(…..)连接的说明与页码属于版面填充(dot leaders),无独立语义功能。
💡 本节核心要点
- 本节是位于第4页的"图表目录"(LIST OF FIGURES),属于论文前置版面,不承担论证功能。
- 目录共列出四幅图示,编号遵循"罗马数字章号 + 大写字母图号"的体系:I-A、II-A、II-B、III-A。
- 第一章图示聚焦于两种测量同时区分 A、B 两组的有效性(第9页)。
- 第二章图示以 Byrd、Morley、Gibbons 三位作曲家所作《Lachrymae Pavans》各变体为对象,分别绘制和声织体的平均度(第22页)与相对均值的偏差(第24页),构成均值/离散的一组对照图。
- 第三章图示展示两个总体的分类区域(第32页),属于统计学中的判别/分类可视化。
🔑 关键术语
- LIST OF FIGURES:位于第4页的章节标题,中文含义为"图表目录",作用是集中列出全文插图的编号、说明及所在页码,供读者回查。
- Effectiveness of Two Measurements Taken Simultaneously in Separating Two Groups (A and B):FIGURE I-A 的图题;指同时使用两个测量变量来区分 A、B 两组时的判别效果,对应第一章的方法示例图。
- Chordal Texture:和声织体,是本论文第二章的核心分析维度,指音乐片段中和声密度或织体复杂度的量化指标;图 II-A 展示其按变体计算的平均值,图 II-B 展示各变体相对该均值的偏差。
- Lachrymae Pavans:本论文第二章所分析的同名作品,由 Byrd、Morley、Gibbons 三位作曲家各自所作;目录条目说明图 II-A 与 II-B 均以该作品的不同变体(Variation)为基本单位进行比较。
- Within-Variation Deviation:变体内部的偏差量;与 II-A 的"平均度"配对,用于在展示集中趋势之外再呈现离散情况。
- Classification Regions for Two Populations:FIGURE III-A 的图题;指两个总体(两组数据)在特征空间中所对应的分类区域,常见于判别分析与统计分类的可视化。
s5 List of Tables
第1段(P0026)
原文复述
LIST OF TABLES
中文讲解
这是一节的标题——“表格目录”(List of Tables)。在论文/学位论文中,“List of Tables"属于前置内容(front matter),与目录(Table of Contents)、图目录(List of Figures)并列,目的是让读者无须翻到正文就能快速定位每一张表格的题名和所在页码。它的存在说明本论文包含大量以表格形式呈现的定量或对照性材料,因此作者特意单独列出,以辅助检索。
补充说明
本节标题以二级Markdown标题(##)形式出现,位于第4页;它开启的不是论证正文,而是论文前置的检索辅助板块。
第2段(P0027)
原文复述
TABLE II-A: Composers’ Lives in Relation to Tudor/Stewart Reigns . . 11 TABLE II-B: Composers as Chapel Royal Children and Gentlemen. . . . 12 TABLE II-C: Composers Receiving Musical Degrees at Oxford . . . . . . 13 TABLE II-D: Rhythmic Note Values Ranked by Quantity for Lachrymae Pavan Variations of Farnaby, Morley and Byrd . . . . . 20 TABLE II-E: Average Degree of Chordal Texture by Variation . . . . . 21 TABLE II-F: Standard Deviation in Chordal Texture, by Variation . . . 23 TABLE II-G: Average Chord Size (Number of Voices) Per Variation . . . 25 TABLE IV-A: Analysis of Variance Results on the Fourteen Variables . 36 TABLE IV-B: DISCRIM Results Using “Known” Pieces by Byrd and Bull . . 38 TABLE IV-C: DISCRIM Results Using “Unknown” Pieces by Byrd and Bull . 38 TABLE IV-D: DISCRIM Results Using All Sample Pieces by the Six Composers . . . . . . . . . . . 40 TABLE IV-E: DISCRIM Results from 14 Variables . . . . . . . . . . . 41 TABLE IV-F: STEPDISC, Forward Selection . . . . . . . . . . . 43 TABLE IV-G: STEPDISC, Backward Elimination . . . . . . . . . . . 44
中文讲解
这是"表格目录"的第一页内容,逐行列出了14张表格的编号、题名与起始页码。从编号方式可以看出作者的分类逻辑:所有表格均按"章号—字母序号"双重编号,字母A、B、C……表示同一章内的排列顺序。因此本章出现的是第二章(II-A至II-G)与第四章(IV-A至IV-G)的表格。
从内容主题看,第二章的七张表格可分两组:II-A至II-C属于"作曲家生平背景"类,分别涉及都铎/斯图亚特王朝在位期、宫廷教堂(Chapel Royal)成员身份、牛津大学音乐学位;II-D至II-G属于"音乐形态量化分析"类,针对Lachrymae Pavan(泪之帕凡)的变奏,分析节奏时值、和声织度均值与标准差、声部数量等可测变量。第四章的表格则全部围绕统计学方法展开——方差分析(ANOVA)、判别分析(DISCRIM)、逐步判别(STEPDISC)等,并以Byrd与Bull作为"已知"与"未知"作品对比的检验对象,最后扩展到六位作曲家的全样本。
通过这一页的列表,读者可以预判论文的结构:先建立历史—机构语境,再将Lachrymae Pavan拆解为可量化的音乐特征,进而以多元统计方法检验这些特征能否区分作曲家署名。
补充说明
表格题名中出现的Chapel Royal指英国宫廷教堂音乐机构;Lachrymae Pavan在表中限定为Farnaby、Morley、Byrd三人所作的变奏版本,是论文重点分析的同一首作品的多家诠释。Byrd与Bull在本页反复作为DISCRIM的测试对象,因为他们既有共同风格时代,又存有归属争议的"匿名"作品,是署名判别的天然样本。
第3段(P0028)
原文复述
TABLES–CON’T.
中文讲解
这是"表格目录"的接续标题——“TABLES–CON’T."(CON’T.即Continued的缩写)。它表明前一张表格目录因版面原因被截断,本页继续列出其余表格。这是学位论文常见的排版处理:当List of Tables内容超过一页时,作者或排版者会在新一页顶端放置一个"接上页"的小标题,以便读者识别列表的连续性。
因此P0028本身不承载学术信息,它的功能是版面性、结构性的:让目录在跨页时保持视觉与逻辑的连贯。
第4段(P0029)
原文复述
TABLE IV-H: DISCRIM Results from 9 Variables Derived After STEPDISC . 45 TABLE IV-I: DISCRIM Results from 9 Variables Derived After STEPDISC . 46 TABLE V-A: Variables Rank-ordered According to Stepwise Discriminate Analysis Results . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . 50 TABLE V-B: Composers Ranked According to Averaged Percentages of Correct Classification from the two Discriminate Analyses. . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . 52 TABLE V-C: Disputed Pieces Ranked by Average Percent of Classification into Primary Composer Group. . . . . . . . . . . . . . . . . . 55
中文讲解
这是表格目录的接续部分,列出五张表格:第四章的后两张(IV-H、IV-I)和第五章的全部三张(V-A、V-B、V-C)。
IV-H与IV-I的题名完全相同——“STEPDISC之后由9个变量得出的DISCRIM结果”——但分别位于第45页和第46页;这种"双胞胎标题"通常意味着两张表承载同一分析的不同侧面(例如一套训练集结果、一套验证集结果,或针对不同作曲家集合的并列输出)。结合上页IV-F(STEPDISC前向选择)和IV-G(STEPDISC反向剔除),可以看出第四章的统计论证路线是:先在14个变量上跑方差与判别(IV-A至IV-E)→ 用逐步判别筛掉冗余变量(IV-F、IV-G)→ 用筛剩的9个变量重做判别(IV-H、IV-I)。这是一种典型的"模型精炼"流程:从全变量出发,再用逐步法降维,最后用降维后的模型重新检验分类效果。
第五章的三张表则属于汇总与结论:V-A对逐步判别筛选出的变量进行排序,V-B对六位作曲家在两次判别分析中的平均正确分类率进行排序,V-C对归属争议的"匿名"作品按归入主要作曲家组的平均百分比进行排序——后者直接服务于论文最核心的署名归属判断。
综合P0027与P0029两页,论文以表格形式呈现了从历史背景(II-A至II-C)→ 作品特征量化(II-D至II-G)→ 全变量统计检验(IV-A至IV-E)→ 变量筛选(IV-F、IV-G)→ 精炼模型复检(IV-H、IV-I)→ 结论排序(V-A至V-C)的完整论证链条。
补充说明
IV-H与IV-I题名一致但页码相邻(45、46),是论文中"同一分析、两个并列输出"的典型排版;第五章V-C专门处理"归属争议作品"的分类比例,是论文判别分析应用的最终落点。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节(P0026–P0029)整体属于论文的前置目录板块(front matter),由二级标题"LIST OF TABLES"领起,分两页排布:第4页(P0027)列出第二章A–G与第四章A–G共14张表;第5页以接续标题"TABLES–CON’T."(P0028)引出其余表格(P0029),即第四章H–I与第五章A–C共5张表。两页合计列出19张表格。每一行条目由"表格编号 + 题名 + 点引线 + 页码"构成,是论文表格索引的标准格式。本节不包含正文论证、脚注或图示。
💡 本节核心要点
- 本节为论文前置的"表格目录”,分两页(P0026/P0028为标题、P0027/P0029为条目),共索引19张表格。
- 表格编号采用"章号—字母序号"制:第二章II-A至II-G,第四章IV-A至IV-I,第五章V-A至V-C,便于读者按章节定位。
- 第二章表格分两类:II-A至II-C记录作曲家生平与机构背景(王室教堂、牛津学位),II-D至II-G记录Lachrymae Pavan变奏的可量化音乐特征。
- 第四章表格展示完整的统计建模流程:全变量方差/判别(IV-A至IV-E)→ 逐步判别筛变量(IV-F、IV-G)→ 9变量再判别(IV-H、IV-I),体现"全模型→精炼模型"的论证路径。
- 第五章表格属于结论性汇总:V-A排序变量、V-B排序作曲家、V-C对归属争议作品给出归类概率,是判别分析的应用落点。
- IV-H与IV-I题名完全相同而页码不同,提示它们承载同一分析的不同侧面(如训练集与验证集,或不同样本集合的并列输出)。
🔑 关键术语
- DISCRIM:SAS统计软件中的判别分析(Discriminant Analysis)过程名,用于根据若干变量把样本归入已知类别。本论文中多次出现(IV-B、IV-C、IV-D、IV-E、IV-H、IV-I),用于检验音乐特征能否区分作曲家署名。
- STEPDISC:SAS中的逐步判别分析过程,包含前向选择(Forward Selection, IV-F)与反向剔除(Backward Elimination, IV-G)两种策略,用于从14个变量中筛选出最具判别力的子集(本论文最终保留9个)。
- Lachrymae Pavan:“泪之帕凡”,一首被多位都铎时期作曲家(Farnaby、Morley、Byrd等)共同诠释的固定主题变奏曲,是本论文音乐特征量化的核心分析对象,体现在II-D至II-G四张表中。
- Chapel Royal:英国宫廷教堂音乐机构,II-B表专门统计作曲家作为Chapel Royal Children(唱诗班少年)与Gentlemen(绅士成员)的身份,是判断作曲家宫廷背景的关键依据。
- Chordal Texture:“和声织度”,指音乐段落中同时发音声部的密集程度。II-E给出按变奏排列的均值,II-F给出标准差,II-G进一步以声部数(Number of Voices)量化平均和弦规模——三者共同构成对织度的多角度描述。
s6 [描述性拆分] Authorship Problems in Elizabethan Keyboard Variations
第1段(P0030)
原文复述
CHAPTER I: INTRODUCTION
中文讲解
这是全文第一章的标题,英文意为"第一章:引言”。原文以 Markdown 二级标题符号"##“作版面标识,内容只有"CHAPTER I: INTRODUCTION"六个英文单词。它本身不承载任何论点,但通过"CHAPTER I"标记把本节定位为论文/学位论文的第一章,而"INTRODUCTION"提示该章的功能是为后续讨论提供问题意识与方法交代。在论证结构上,这一标题锁定了接下来的段落将围绕"研究什么、为什么困难、本文如何处理"三个层面展开,而不进入实质性考证。
第2段(P0031)
原文复述
Editors of Elizabethan keyboard literature often face authorship ques-
中文讲解
本行是论文起首句的上半部分,因排版断字而被截断,行末的"ques-“在下一段接"tions"才构成完整单词"questions”。就本段独立可见的内容而言,作者已经把核心主语与谓语摆出——“编辑伊丽莎白时代键盘文献的人常常面对署名……"。其中"Elizabethan keyboard literature"明确把研究对象锚定在伊丽莎白时代(1558–1603)的键盘乐谱文献;“often"是限定副词,说明这种困难并非偶发而是常态;句尾未完成的"ques-“在版面上制造悬念,引导读者把目光移到下行继续阅读。
补充说明
“ques-“为行末断字,原词为"questions”。
第3段(P0032)
原文复述
tions just as problematical as the transcription of the music itself.
中文讲解
本行承接上一行的"ques-",拼合成"questions”,并补全整个比较句的下半部分:这些署名疑问"与音乐本身的转写一样棘手”。“just as…as…“是比较级句式,作者借此把两类工作——“确定作者"与"转写乐谱”——并列起来,强调二者的难度同等。在通常的学术想象中,“抄录、转写乐谱"被视为编辑工作的主要难关;而本句有意把"作者识别"抬升到同等高度,为后文具体列举归属困难作了铺垫,同时也抬升了本研究的学术必要性。
第4段(P0033)
原文复述
Classifying compositions from 1558 to 1603 among contemporary composers is
中文讲解
本行开启第二个长句的上半部分,句子的主语是动名词短语"Classifying compositions from 1558 to 1603 among contemporary composers”(将1558至1603年间的作品分类到当代作曲家名下),谓语动词是尚未出现的"complicated”。作者通过精确给出"1558 to 1603"这一时间范围,把研究对象限定在伊丽莎白一世在位时期;“contemporary composers"暗示这些作品产生于一个活跃且彼此竞争的创作群体内部,因此归属判定具有内在的竞争性。行末的"is"作为系动词把这一分类行为定义为"complicated”,并引出下一行的具体干扰因素。
补充说明
1558–1603为伊丽莎白一世在位之年,由原文直接给出,不再向外扩展。
第5段(P0034)
原文复述
complicated by unauthorized manuscripts, multiple copies, conflicting
中文讲解
本行紧接上一行的"is”,给出第一组让分类行为变得复杂的因素:“unauthorized manuscripts”(未经授权的手稿)、“multiple copies”(多份副本)以及尚未写完的"conflicting”。三个并列名词的摆放呈现累积效果——未经授权的手稿意味着文本本身的合法性存疑;多份副本则意味着同一作品有多个差异版本;“conflicting”(相互矛盾的)作为形容词,预告其修饰对象(归属记录)将紧随其后。这种层层叠加的并列结构让读者从一开始就能感到归属判定的工作量与难度。
第6段(P0035)
原文复述
attributions by copyists, and use of common themes by composers of vari-
中文讲解
本行延续上一行的并列名词,把第二项"attributions by copyists”(由抄写者所作的归属标记)补完;并列连词"and"再新增第四项——“use of common themes by composers of vari-",但这一项同样因断字未完,下一行才接"ations”。“attributions by copyists"把署名信息的来源具体化到抄写者的笔下,提示归属并非作曲家自述,而是后人经抄写链条传承下来的二手判断;“common themes"是一个关键概念:多位作曲家共享相同的旋律素材进行变奏,使得仅凭主题无法判定作者。行末"vari-“与下一行"ations"合成"variations”(变奏曲)。
补充说明
“vari-“为行末断字,下行"ations"与之拼合成"variations”。
第7段(P0036)
原文复述
ations. Variations on song or dance tunes were the predominant genre of
中文讲解
本行把上一行未完的"variations"补完,结束这一长句;随即以句号切分,开启第三个长句,交代研究对象的体裁定位——基于"song or dance tunes”(歌曲或舞曲主题)的"Variations”(变奏)是当时"predominant genre”(主流体裁)。“song or dance tunes"以"or"连接两种主题来源,提示变奏素材的多样性;“predominant"是最高级意味的强势限定词,意为"占主导地位的”,它明确把变奏定位为世俗键盘作品的主流形式,而非边缘体裁。这一定位为后文把"风格分类"作为研究方法作了体裁上的合法性背书。
补充说明
“predominant"在此取最强意义"占主导地位的”,区别于"common"或"frequent”。
第8段(P0037)
原文复述
secular keyboard music at that time, and their surviving quantity represents
中文讲解
本行承接上一行的"predominant genre of”,补全"secular keyboard music at that time"(当时的世俗键盘音乐)这一范围状语,并以"and"引出对存世数量的评价——它们存世下来的数量"represents"(代表/呈现出)……。本行仍属于主句的宾语引导部分,真正宾语由后两行揭晓;“at that time"把判断锚定在伊丽莎白时代范围内;“secular"是关键词,与教会音乐相对,明确把研究对象限定在非宗教领域。“and"把两个并列分句(评估与判断)连成一个复合判断。
补充说明
“secular"对应中文"世俗、非宗教”,用以区别于教会音乐;这一限定由原文直接给出。
第9段(P0038)
原文复述
a remarkable collection of popular music as well as a baffling array of
中文讲解
本行承接上一行的"represents”,给出第一个并列宾语"a remarkable collection of popular music”(一份非凡的流行音乐合集),并通过"as well as"引出第二个并列宾语"a baffling array of……"(一组令人困惑的……)。两个宾语形成鲜明对照:前者以"remarkable"肯定其流行音乐史料价值,后者以"baffling"突出归属判定的学术困境。作者用一对评价色彩完全相反的形容词呈现同一批遗产的"两面”——既是富矿,也是迷宫。这种对照为后文宣布"研究归属难题"作了情感与价值上的双重铺垫。
第10段(P0039)
原文复述
unsolved authorship problems. The following paper will examine keyboard
中文讲解
本行把上一行的宾语"a baffling array of"补完为"unsolved authorship problems"(未解的归属难题),并以句号结束这一长复合句。随后以"The following paper will examine keyboard"开启下一个句子,正式宣布本文的研究对象与目标——“本文将考察键盘变奏……"。“The following paper"作为元话语标记,把行文从背景描述转入研究目的宣告;“will examine"是承诺性措辞,暗示作者将系统性地处理这一问题,而非仅作表面概述。行末"keyboard"与下一行的"variations"合成"keyboard variations”。
补充说明
“The following paper"为典型的学位论文元话语,用于宣告研究范围。
第11段(P0040)
原文复述
variations with regard to the problem of authorship verification. The
中文讲解
本行把上一行的"keyboard"补完为"keyboard variations”,并通过介词短语"with regard to"明确切入角度——“针对归属核验这一问题”。作者用"the problem of authorship verification"替代此前反复出现的"authorship questions/problems”,措辞更精确;引入"verification”(核验、验证)一词,暗示研究将不只是描述现象,而是建立某种判定或验证流程。行末的"The"开启下一个句子,将给出这一核验流程所要面对的核心难点,把读者的注意力引向具体的技术性挑战。
补充说明
“verification"区别于一般"归属"问题,侧重于可操作的核验过程。
第12段(P0041)
原文复述
challenge presented in their duplication of techniques as well as themes
中文讲解
本行开启引言最后一句的上半部分,句子主语是"The challenge”(挑战),“presented in"作为后置定语引出挑战所在——“their duplication of techniques as well as themes”(它们在技巧与主题两方面的相互重复)。这里的"their"指代前述键盘变奏群;“as well as"再次出现,把"技法(techniques)“与"主题(themes)“并列。作者挑出"duplication”(重复、复制)作为挑战根源,暗示归属判定之所以困难,是因为作曲家既共享素材又共享手法,单凭任一维度都不易区分。“duplication of techniques"也是后文"风格分类"方法论的关键伏笔。
第13段(P0042)
原文复述
especially lends itself to a study of stylistic classification.
中文讲解
本行补全上一句的下半部分:这种挑战"尤其适合用风格分类的方法来研究”。“especially"是强调副词,把"技法+主题双重重复"这一现象单独拎出来,断言它是风格分类研究的理想场域;“lend itself to"是英文固定搭配,意为"适宜于、便于”。作者借此收束整个引言,把研究方法锁定为"stylistic classification”(风格分类),从而预告论文后续将以风格学路径破解归属难题。这一句既总结前文铺垫,也为下一节(方法与文献综述)埋下伏笔,使整段引言形成"现象—难度—方法"的完整闭环。
补充说明
“lend itself to"为英文固定搭配,意为"适宜于、便于”,不可替换为"make itself suitable for”。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为论文第一章的引言部分,承接的上一级内容为论文前置部分(标题页、致谢、目录等)。本节自身不包含脚注、图表、谱例或边栏注释,仅由一个二级标题(P0030)和12个正文段落(P0031–P0042)组成;段落之间存在典型的排版断字(连字符”-“出现在 P0031 末"ques-"、P0035 末"vari-“两处),原文应为两行连续排版。
💡 本节核心要点
- 论文开篇把"编辑伊丽莎白时代键盘文献所面临的归属难题"与"乐谱转写的难度"并列,借此抬高归属问题在学术工作中的地位。
- 研究对象被精确限定为 1558–1603 年间世俗键盘音乐中的主流体裁——以歌曲或舞曲为主题的变奏,其存世量丰富、流行音乐史料价值突出。
- 归属判定受四类因素干扰:未经授权的手稿、多份副本、抄写者之间相互矛盾的归属记录,以及作曲家对共同主题的共享使用。
- 变奏作曲家不仅共享主题,也复制技法,使归属核验在主题与技法两个维度上都失效,形成本研究聚焦的"duplication"挑战。
- 作者据此宣布论文将围绕"归属核验"展开,并以"风格分类"作为破解归属难题的核心方法。
🔑 关键术语
- Elizabethan keyboard literature:伊丽莎白时代键盘文献;本节核心研究对象的总称,时间范围限定在伊丽莎白一世在位期间。
- authorship verification:归属核验;区别于宽泛的"归属判定”,强调建立可操作的核验流程,是本研究的目标动词。
- stylistic classification:风格分类;本节预告的研究方法,用于应对变奏曲在主题与技法上的双重重复。
- secular keyboard music:世俗键盘音乐;与教会音乐相对的体裁限定,明确把研究对象限定在非宗教领域。
- unauthorized manuscripts:未经授权的手稿;归属判定的第一类干扰源,指向文本合法性的存疑。
- common themes:共同主题;当时多位作曲家共享的变奏素材,仅凭主题无法判定作者归属。
s7 [描述性拆分] Need for Stylistic Identification of Composers
第1段(P0043)
原文复述
Scholarship concerning composers of the Elizabethan period has only recently begun the task of
中文讲解
本句是本节的起首句,作用是开门见山地点明研究现状:关于伊丽莎白时期作曲家的学术文献才刚刚着手进行某项工作。这句话的语气带有保留意味(“only begun”),暗示该领域尚处于起步阶段,从而为后文列举 Byrd 等作曲家研究专著数量之少、整体研究薄弱提供总论性的铺垫。
第2段(P0044)
原文复述
identifying the so-called “giants” of that era through their distinctive stylistic features. Fewer than six
中文讲解
承接上一句,明确指出那项尚未充分展开的工作就是:通过风格特征来识别该时期的"巨人"作曲家。作者用引号标出"giants”,暗示这是一个尚未被充分界定的概念,需要靠风格分析来逐步确立。紧接着用数字"Fewer than six"为下一句的具体例证做铺垫,强调即便是最重要的作曲家,专书研究也屈指可数。
第3段(P0045)
原文复述
monographs have been devoted to the works of William Byrd. Orlando Gibbons
中文讲解
举出具体的数字证据:关于 William Byrd 作品的专著不到六本。Byrd 通常被视为伊丽莎白时期最重要的键盘音乐作曲家之一,此处用他的研究专著数量之少来反衬整个领域的研究空缺。随后自然地过渡到下一位作曲家 Orlando Gibbons,引入对其他"巨人"研究状况的考察。
补充说明
William Byrd(约 1539/40–1623)是伊丽莎白时期英国最重要的作曲家之一,键盘音乐与宗教音乐均为其代表作;本节以此人为参照说明研究不足。
第4段(P0046)
原文复述
and John Bull, who together with Byrd contributed to the celebrated collection Parthenia,
中文讲解
本句插入对 Orlando Gibbons 与 John Bull 的身份说明:他们与 Byrd 一同为著名的 Parthenia 作出贡献。这一信息不仅介绍了两位作曲家的重要合作事实,也将他们归入"已具备一定学术关注度"的作曲家行列,与前句 Byrd 的研究数量形成对照。
补充说明
Parthenia(约 1612–1613 年出版)是英国最早的印刷出版的键盘乐合集之一,由 Byrd、Gibbons、Bull 三人共同创作,本节中作为这三位作曲家合作的关键证据出现。
第5段(P0047)
原文复述
have each been the subject of three such works, and a great many other composers represented
中文讲解
承接上句,说明关于 Gibbons 和 Bull 的专著各为三本,进一步印证即便是这几位与 Byrd 齐名的作曲家,专题研究仍相当有限。然后以"a great many other composers"引出对更广泛作曲家群体的关注,转折到研究不足的更普遍现象。
第6段(P0048)
原文复述
in collections such as the Fitzwilliam Virginal Book remain scarcely understood in
中文讲解
指出收录于 Fitzwilliam Virginal Book 等曲集中的大量其他作曲家,其风格几乎未被认识。“scarcely understood"一词强烈地凸显出研究界对这些作曲家风格个性的认知仍处于空白状态,呼应本节标题"对作曲家进行风格识别的必要性”。
补充说明
Fitzwilliam Virginal Book 是英国 17 世纪初编订的维金诺琴音乐手抄本曲集,收录了 Byrd、Bull、Gibbons、Farnaby 等多位英国作曲家的大量键盘作品,是研究伊丽莎白时期键盘音乐的核心曲集。
第7段(P0049)
原文复述
terms of their individual stylistic character. Although keyboard music forms a varying
中文讲解
完成上一句关于风格个性认知不足的论述,并以"Although"开始新的让步从句:虽然键盘音乐在每位作曲家的全部作品中占据不同比例。这一让步为后文通过键盘音乐(特别是变奏曲)来对比不同作曲家提供了逻辑前提——尽管键盘音乐并非每位作曲家的全部作品,但足以作为风格比较的有效依据。
第8段(P0050)
原文复述
share of each composer’s total output, figures such as Thomas Morley, Peter
中文讲解
承接让步从句,说明键盘音乐在不同作曲家全部作品中占比不同,并具体举出 Thomas Morley、Peter Philips、Giles Farnaby 三位作曲家,作为后文比较分析的对象。这一名单的扩展意味着作者不局限于前面提到的 Byrd、Gibbons、Bull 三位,而是把比较范围扩展到六位作曲家。
补充说明
Thomas Morley(约 1557–1602)是伊丽莎白时期重要的英国作曲家,以牧歌与芭蕾舞曲闻名;本节将其纳入风格比较的对象之一。
第9段(P0051)
原文复述
Philips, and Giles Farnaby may exhibit notable differences when their variation pieces
中文讲解
继续列出第三位作曲家 Giles Farnaby,并提出核心论点:当以变奏曲为比较基础时,这些作曲家之间可能呈现出值得注意的差异。“may exhibit noteworthy differences"的语气较为审慎,是作者的初步判断而非定论,表明后文将围绕变奏曲展开具体的风格对比。
补充说明
Peter Philips(约 1560/61–1628)与 Giles Farnaby(约 1563–1620)均为伊丽莎白时期英国键盘音乐作曲家;Farnaby 的作品大量保存在 Fitzwilliam Virginal Book 中。
第10段(P0052)
原文复述
are compared with one another. By examining the six composers named above, the author aims to discover
中文讲解
完成关于变奏曲比较的论述,正式宣布本书的研究计划:通过对前文提及的六位作曲家(Byrd、Gibbons、Bull、Morley、Philips、Farnaby)的考察,作者意图揭示他们各自的某些风格特征。“the author"的明确出现标志着研究立场的自陈,本节由此过渡到论文的总纲。
第11段(P0053)
原文复述
something of the stylistic identity
中文讲解
重申研究目标——揭示每位作曲家的风格身份(style identity)。“something of"这一措辞表达出作者的谦逊态度:他并非声称能够穷尽每位作曲家的全部风格,而是希望能有所发现、有所推进。
第12段(P0054)
原文复述
of each.
中文讲解
以简短的"of each"完成目标陈述:每位作曲家的风格身份。这一收束句虽短,却与开篇"only begun the task of identifying giants by stylistic features"形成首尾呼应,确立了本节论证的主线——以风格分析为基础,识别并比较六位伊丽莎白时期作曲家的个体风格。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节原文为一段连续论述,被拆分为 12 个段落片段(P0043–P0054)以便逐句精讲。原文未提供脚注、图表、边栏或其他附加材料。
💡 本节核心要点
- 关于伊丽莎白时期作曲家的学术研究目前仍处于起步阶段:通过风格特征识别该时期"巨人"的工作才刚开始。
- 即便是 Byrd、Gibbons、Bull 等最重要的作曲家,相关专著数量也极少(Byrd 不到六本,Gibbons 与 Bull 各三本),反映出研究空缺。
- 收录于 Fitzwilliam Virginal Book 等曲集中的大量其他作曲家,其风格个性几乎未被认识,构成本研究的问题意识。
- 本研究的比较对象确定为六位作曲家:Byrd、Gibbons、Bull、Morley、Philips、Farnaby。
- 比较的基础是各作曲家的变奏曲(variation pieces),尽管键盘音乐在其全部作品中占比不一。
- 研究目标是揭示每位作曲家独有的风格身份(stylistic identity),语气审慎,意在为这一尚待开拓的领域添砖加瓦。
🔑 关键术语
- Parthenia:约 1612–1613 年出版的英国早期印刷键盘乐合集,由 Byrd、Gibbons、Bull 三人共同创作;本节中作为这三位作曲家共同参与的重要合作曲集的证据出现。
- Fitzwilliam Virginal Book:17 世纪初编订的英国维金诺琴音乐手抄本曲集,收录多位伊丽莎白时期作曲家的键盘作品;本节中用以说明大量作曲家风格尚未被充分研究的现状。
- variation pieces:变奏曲,即以一个主题为基础进行一系列变化的曲式;本节中作为比较六位作曲家风格差异的核心文本类型。
- “giants”:本节中加引号使用的概念,指伊丽莎白时期最具代表性的作曲家群体;作者强调这种身份仍需通过风格分析加以确立。
- stylistic individuality / identity:风格个性或风格身份,即每位作曲家在音乐语言上区别于他人的独特特征;本节的研究目标即是揭示这一身份。
s8 [描述性拆分] Discriminant Analysis as a Method for Authorship Verification
第1段(P0055)
原文复述
A method for selecting and evaluating stylistic variables for the pur-
中文讲解
本段是本节乃至整篇论文核心论题的起首句。作者开门见山地指出,整篇论文的主要关切(major concern)是提出一种「选择并评估风格变量的方法」。所谓风格变量,是指能够区分不同作曲家风格的可量化特征。pur- 为行末连字符,其完整形式将在下一段 P0056 中拼合为 purposes。这句话同时界定了方法的两个动作(selecting 与 evaluating)和一个应用目标(identifying anonymous pieces,识别匿名作品),为后续选择判别分析这一统计路径埋下伏笔。
第2段(P0056)
原文复述
poses of identifying anonymous pieces is the major concern of the thesis.
中文讲解
本段接续 P0055,跨行连字符拼合为 purposes,补全了介词短语「purposes of identifying anonymous pieces」以及系表结构「is the major concern of the thesis」。其中 identifying anonymous pieces 明确了方法的应用语境——匿名音乐作品的归属判定;major concern 则表明这一任务被作者置于论文的中心位置,而非附带议题。整句话的作用是为整篇研究设定合法性框架:之所以要动用一套统计程序,是因为它服务于一个被作者称为「主要关切」的具体任务。
第3段(P0057)
原文复述
Since the problem is one that requires detailed quantification of nota-
中文讲解
本段以从属连词 Since 引出原因状语从句,论证采用统计方法的必要性。作者指出,由于该问题(识别匿名作品)要求对记谱观察(notational observations)进行「详细量化」(detailed quantification),因此必须借助量化工具。nota- 为行末连字符,与 P0058 拼合为 notational。这一句是论文从「风格分析」转向「统计分析」的逻辑桥梁:它把研究对象的内在属性(需要对记谱进行详细量化)与方法选择(统计程序)显式连接起来。
第4段(P0058)
原文复述
tional observations, the author has followed a statistical procedure used
中文讲解
本段接续 P0057,跨行连字符拼合为 notational observations,完成原因状语从句,并开启主句:作者采用了一种「在科学研究中广泛使用的统计程序」。这里 followed 一词暗示作者并非发明该程序,而是借用既有的、被验证过的方法论;这种「借力」的表述方式增强了方法选择的合理性——作者并非在自创新工具,而是在移植一个已在其原领域被广泛验证的工具。
第5段(P0059)
原文复述
widely in scientific research. Discriminant analysis provides a technique
中文讲解
本段先以 widely in scientific research 收束 P0058 的定语从句,然后以句号断开,正式开启新句并引入论文的核心方法——判别分析(Discriminant analysis)。作者用 provides a technique 这一表述,将判别分析定位为一种「技术」而非泛泛的「方法」,暗示它具有明确的数学形式与操作步骤,区别于定性分析或描述性比较。这一术语的出现标志着方法论路径的正式确立。
第6段(P0060)
原文复述
for analyzing quantified measurements taken from several groups. Stylistic
中文讲解
本段说明判别分析的功能:对来自多个群体的量化测量进行分析(for analyzing quantified measurements taken from several groups)。这是判别分析作为多元统计工具的标准适用情境——根据多个数值变量将样本归入已知的类别群体。本段末尾的 Stylistic 一词是下一句主语 Stylistic features 的起首词,跨段预告了从「方法功能」到「分析对象」的过渡。
第7段(P0061)
原文复述
features that can be counted from the musical score can be statistically
中文讲解
本段开启新句,主语为「从乐谱中可数的风格特征」(Stylistic features that can be counted from the musical score)。这一表述隐含两个前提:第一,风格特征必须是客观可数的,而非依赖主观审美判断;第二,记谱本身承载了足够丰富的风格信息。作者用 can be counted 这一限定,排除了无法量化、无法复核的风格维度,从而为判别分析的适用性预先清理了分析对象的边界。
第8段(P0062)
原文复述
evaluated using this model for their probability of successful classifica-
中文讲解
本段继续 P0061 的句子:这些特征可以通过判别分析模型(this model)进行统计评估,目标是估计它们「成功分类的概率」(their probability of successful classification)。这是判别分析在论文中的具体用法——不是直接给出分类结果,而是先评估各风格变量的判别效力,再据此筛选有效变量。classifica- 为行末连字符,与 P0063 拼合为 classification。这一表述暗示论文的研究路径是「先评估、后分类」,与判别分析在传统应用中直接分类的做法略有区别。
第9段(P0063)
原文复述
tion. In employing discriminant analysis to study stylistic variables, a
中文讲解
本段先收束上一句,跨行连字符拼合为 classification;随后以 In employing… 这一方式状语开启新的句子,预示运用判别分析研究风格变量将带来一个结果。该结果由不定冠词 a 引出,即「一种……的程序」,具体内容在下一段展开。从论证结构看,这是一个从「方法的输入/用法」过渡到「方法的产出/承诺」的衔接句。
第10段(P0064)
原文复述
systematic, reproducible procedure for composer classification will be
中文讲解
本段揭示 P0063 中 a 所引导的结果:一种「系统化、可复现的作曲家分类程序」(systematic, reproducible procedure for composer classification)。两个关键形容词 systematic 与 reproducible 是论文方法论的标志性承诺——既保证流程的条理化,也保证其他研究者可以重复操作并验证结论。这两个词在科学哲学语境中常被视为「科学方法」的最低限度判据,作者以此为方法的可接受性背书。
第11段(P0065)
原文复述
provided that, to the author’s knowledge, has never been used in musical
中文讲解
本段延续 P0063–P0064 的句子,说明这种程序「将被提供」(will be provided)。其中插入语 to the author’s knowledge 是一个克制的限定——作者仅就其个人所知作出判断。这一限定在学术写作中具有双重作用:一方面加强原创性主张的力度,另一方面为可能存在的未知先例留下余地,避免绝对化表述。musical 一词开启下一段,将所讨论的领域限定为「音乐研究」。
第12段(P0066)
原文复述
research.
中文讲解
本段仅一词 research,收束全句:has never been used in musical research(在音乐研究中从未被使用过)。这是论文对其方法新颖性的最强主张——将判别分析这一在自然科学中广泛使用的统计工具,首次引入音乐学领域的作曲家风格识别。本句的修辞效果在于:通过指出跨学科方法的「空白」,为论文填补这一空白提供合法性,同时也强调了研究在学术版图中的定位价值。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为方法论引入段,未包含脚注、图表、边栏或附录材料,亦无页眉页脚信息需补充。
💡 本节核心要点
- 论文的核心任务被界定为:提出一种用于「识别匿名作品」的选择与评估风格变量的方法,作者称之为论文的「主要关切」。
- 方法选择的逻辑链条是:问题需要对记谱观察进行「详细量化」→ 因此需要量化工具 → 借用科学界广泛使用的统计程序 → 选定判别分析。
- 判别分析的功能被严格界定为「分析来自多个群体的量化测量」,而分析对象则被严格限定为「从乐谱中可数的风格特征」,二者构成方法与对象的契合关系。
- 判别分析的具体用法是:先评估各风格变量「成功分类的概率」,而非直接产出分类结果,体现了「先评估、后分类」的严谨路径。
- 论文承诺提供「系统化、可复现」的作曲家分类程序,并以 to the author’s knowledge 这一限定主张该方法在音乐研究中前所未有,从而确立其跨学科原创性。
🔑 关键术语
- Discriminant analysis:判别分析;一种多元统计方法,根据多个量化变量将样本归入已知群体;在本节中作为评估风格变量分类效力的核心工具。
- Stylistic variables / Stylistic features:风格变量/特征;可从乐谱中计数的、用于区分不同作曲家风格的客观量化指标,是判别分析的输入对象。
- Notational observations:记谱观察;对乐谱记谱法层面内容的观察与记录,是风格变量的原始素材来源。
- Quantified measurements:量化测量;将观察内容转化为可用于统计分析的数值形式,是判别分析处理的标准数据类型。
- Composer classification:作曲家分类;根据风格特征判定作品作者归属的问题,是判别分析在论文中的最终应用目标。
s9 [描述性拆分] Limitations of Modern Edition Procedures (Glyn’s Gibbons Edition)
第1段(P0067)
原文复述
Modern editions of Elizabethan keyboard music are, in a characteristic manner, restricted in what they disclose about their editorial procedures.
中文讲解
本段以副词 Characteristically(典型地)开篇,奠定整小节的论点基调。它将随后的判断定位为一种规律性的概括,而非孤立观察——暗示这种’不透明’并非个别编辑的偶然疏忽,而是这一领域现代版本的整体风貌。下一句(P0068–P0069)将引入具体的案例(Glyn 的 Gibbons 版)来佐证这一’characteristically’的判断。
第2段(P0068)
原文复述
When such editions do mention procedure at all, they tend to offer only general advice — of the kind that follows immediately.
中文讲解
本段把 P0067 的’characteristically’具体化为:现代版本所披露的’少量’编辑程序,并非完全缺席,而是以’一般性建议’(general advice)的形式出现。‘Such as the following’ 是关键的过渡短语,把读者直接引向下文即将引述的 Glyn 前言节录。
第3段(P0069)
原文复述
An example of this kind of general advice is to be found in Margaret Glyn’s edition of Orlando Gibbons’ keyboard pieces.
中文讲解
本段点名了被当作标杆来剖析的案例:Margaret Glyn 编辑的 Orlando Gibbons 键盘作品集。Glyn 版在英语学界长期被视为 Gibbons 键盘作品的标准版本,因此其前言中的措辞具有示范意义——一旦该标杆版本都存在方法论不透明的问题,作者便可由此推论整个领域的状况。
第4段(P0070)
原文复述
Margaret Glyn’s competence to distinguish music genuinely by Orlando Gibbons
中文讲解
本段开始介绍 Glyn 的学术资历。‘Competence to distinguish … from others’’(分辨 Gibbons 本人作品与他人作品的能力)这一措辞至关重要:它设定了即将展开批评的前提——作者质疑的不是 Glyn 是否具备辨别能力,而是她在前言中是否说明了辨别所依据的方法。
第5段(P0071)
原文复述
from music by other composers rests on her years of scholarship and on her editions of many works
中文讲解
本段承接 P0070,说明 Glyn 资历的两个具体来源:长期学术积累,以及对同时期众多作品的编辑经验。‘Many works from this period’ 暗示她对伊丽莎白键盘音乐的曲目整体有深入把握,因此她的’分辨’建立在广泛曲目熟悉度之上,并非随意断言。
第6段(P0072)
原文复述
drawn from this same period.¹ Yet, when Glyn attributes her final editorial choices to
中文讲解
本段以转折词 ‘Still’ 引出对立面:尽管资历充分,Glyn 对最终编辑选择所作的归因却并不令人满意。脚注 1 紧接 ‘from this period’,按学术惯例通常用于支撑对 Glyn 资历的引述,但 task_input 未提供脚注 1 的具体文字,无法进一步复述其内容。
补充说明
脚注 1 的具体内容在 task_input 中未给出,仅可知其在本段标记。
第7段(P0073)
原文复述
“mature experience only” and to a trained ear, this leaves many questions unanswered
中文讲解
本段是本小节批评的核心所在。‘Mature experience only’(仅凭成熟经验)与 ‘a trained ear’(训练有素的耳朵)是 Glyn 在前言中的原话引用,作者用引号凸显其措辞——这两个短语共同构成一种’主观直觉式’的自我辩护:既不可被外人复核,也无法被后人复制。‘Leaves many questions unanswered for followers in the field’ 指明此做法的代价:同行无法从中学习到可操作的判断依据。
第8段(P0074)
原文复述
for other scholars working in the field. Her preface could be improved by additional
中文讲解
本段从批评过渡到建议。‘Followers in the field’(领域内的后继者)一词暗示作者关心的不仅是 Glyn 本人的工作,而是学术传承链的整体——当一部标准版本仅以个人资历为依据时,后来者无从学习其方法。
第9段(P0075)
原文复述
clarification — specifically, by a technique explained in a systematic way
中文讲解
本段提出具体的补救方案:‘a systematically explained technique’(系统化解释的技术)。关键限定在 ‘systematically’——意味着不只是一次性的解释或罗列理由,而是可被他人重复使用、按步骤执行的方法。这与 Glyn 的’经验直觉’式辩护形成对照:前者追求可传授的程序,后者依赖不可外化的内在判断。
第10段(P0076)
原文复述
for making decisions in cases where authorship is in question.
中文讲解
本段限定该技术的应用范围:‘authorship problems’(作者归属问题)。这是伊丽莎白键盘音乐研究中极具代表性的难题——许多曲目在不同手稿中以匿名形式流传,或被分别归于不同作曲家。‘Decision-making’ 一词揭示:编辑的工作并非单纯誊写,而是要在多个归属方案之间作出取舍;这一取舍理应由系统化技术支撑。
第11段(P0077)
原文复述
A glance at the manuscript sources of Gibbons’ music as catalogued in
中文讲解
本段开启论证的第二阶段:从’前言的方法论不透明’转向’手稿源头所呈现的客观困难’。‘A glance’ 是作者谦逊的说法,暗示其对相关文献已有掌握;同时也让论证从编辑’自陈’的层面转向手稿’实证’的层面。
第12段(P0078)
原文复述
Musica Britannica² already reveals some of the problems that Glyn and other [editors encounter].
中文讲解
本段以 Musica Britannica 的编目作为实证入口,指出仅翻阅其 Gibbons 条目也已经能看到 Glyn 等编辑所面临的归属难题。‘Some of the problems’ 表明此处并非穷举,而是引子——预示下一节将展开具体讨论。本句在 ‘and other’ 处戛然而止,是因输入截断,并非作者原文的真正结尾。脚注 2 与 ‘Musica Britannica’ 关联,但 task_input 未给出其具体内容,无法进一步复述。
补充说明
脚注 2 的具体内容在 task_input 中未给出,仅可知其与 Musica Britannica 相关。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节共出现两处脚注标记:¹ 位于 P0072,² 位于 P0078,但脚注的具体文字在 task_input 中均未给出,因此本节内只能保留其位置信息,无法对其内容、来源或论证功能作具体复述。本节在 P0078 的 ‘and other’ 处中断,明显是因输入在该处截断,而非作者原文的自然结尾;下一节应承接 ‘Glyn and other [editors]…’ 的句意继续展开。
💡 本节核心要点
- 现代伊丽莎白键盘音乐编辑版本的’典型’特征是方法论不透明:除一般性建议外,鲜有具体编辑程序的说明。
- Margaret Glyn 的 Gibbons 版本被作为这一现象的标杆案例;她的学术资历(多年研究、编辑过同时期众多作品)确实足以胜任分辨工作,但她在前言中却把最终判断归因于’成熟经验’与’训练有素的耳朵’。
- 作者指出,这种依赖个人直觉与听觉经验的辩护既不可验证、也不可传承,使’领域内的后继者’无法学习到可操作的判断依据。
- 作者提出的补救方案是:在前言中加入’系统化解释的技术’,专门用于处理作者归属问题(authorship problems)。
- Musica Britannica 的 Gibbons 条目作为实证入口,已经显示出归属难题的客观存在;本节以此过渡,将论证导向对具体手稿问题的讨论,由下一节承接。
🔑 关键术语
- Characteristically:本节首段所用的副词,中文可作’典型地’。它将随后对现代版本’方法论不透明’的判断定位为该领域的整体特征,而非孤例;这是作者对现代编辑版本整体性评价的关键限定。
- “mature experience only” 与 “trained ear”:Glyn 在前言中对自身最终判断依据的原话引用,分别可译为’仅凭成熟经验’与’训练有素的耳朵’。作者用引号标示,批评这是依赖个人直觉与听觉经验的辩护——既不可验证,也不利传承,是前言方法论不透明的核心症结。
- systematically explained technique:中文:‘系统化解释的技术’。作者建议编辑在前言中提供的补救措施,其特点是可被他人按步骤重复使用,针对作者归属问题作出可操作的决定;与 Glyn 的’直觉式’辩护形成对照。
- authorship problems:中文:‘作者归属问题’。在伊丽莎白键盘音乐中,许多曲目在不同手稿中以匿名形式流传或被分别归于不同作曲家;编辑必须就归属作出判断,作者认为此类判断理应由系统化技术支撑,而非仅凭个人资历。
- Musica Britannica:文中提及的英国音乐研究/编目文献,作者以之作为查阅 Gibbons 手稿源头资料的入口;脚注 2 与此名关联,但脚注具体内容在 task_input 中未给出。
s10 [描述性拆分] Manuscript Sources of Gibbons’ Music
第1段(P0079)
原文复述
Of the forty-one sources that editors have faced, only Parthenia (see footnote 3) was printed.
中文讲解
本段延续上一页的论述,交代编辑所面对的史料基盘:在与Gibbons音乐相关的全部四十一份资料中,只有Parthenia(详见脚注3)是印刷出版的。这句话用"only"突出了"印刷"与"手抄"之间的对比,把后文讨论的核心对象——其余四十份手抄本——凸显出来,从而设定本节焦点。
补充说明
脚注3的指向对象Parthenia在P0079中首次以原名出现;其印刷属性使其与本节其余手抄本形成鲜明对比。
第2段(P0080)
原文复述
The remaining manuscripts represent the work of a wide range of copyists.
中文讲解
本段把焦点从印刷本转向其余手稿,指出它们并非出自单一抄写者,而是由数量众多、身份各异的抄写员完成。“a wide range of"一词暗示抄写者的水平与背景差异巨大,为下文的可靠性讨论埋下伏笔:既然来源庞杂,质量自然不能一概而论。
第3段(P0081)
原文复述
Ranging from amateurs to professionals, these copyists force editors to question the accuracy of their work by considering various factors.
中文讲解
本段进一步指出抄写者涵盖业余与专业两个极端,并由此引出编辑必须"质疑"抄本准确性的立场。“must"一词强调了这一立场的强制性:面对来源庞杂的史料,准确性不能默认,必须主动考察;句子以"by considering"收尾,预告后文将列出具体的考察维度。
第4段(P0082)
原文复述
Editors must consider the copyists’ identity, the sources they drew upon, and their proximity to the original composer.
中文讲解
本段列举了编辑评判抄本准确性时应参照的三个维度:抄写者本人的身份(identity)、抄写者所依据的底本(sources they drew upon,指他们抄写时所使用的更早一级乐谱)、以及抄写者与作曲家本人的接近程度(proximity,可指时间或社会关系上的接近)。这是对前段"必须质疑"立场的方法论展开。
补充说明
本段中的"sources"指抄写者用作底本的更早乐谱,与本节标题"Manuscript Sources"中的"sources”(指保存Gibbons音乐的原始手稿)含义不同,需注意区分。
第5段(P0083)
原文复述
Editors must also weigh the purposes behind their copying. William Ellis, identified by editor…
中文讲解
本段补齐了第四个评判维度——抄写的目的(purposes),即抄写者为什么制作这份副本。这一维度揭示了抄写行为背后可能存在的不同动机(例如练习、收藏、教学、传播等),进而影响对抄本忠实度的判断。随即以"William Ellis"作为前文方法论的第一个实例切入。
补充说明
本段是承上启下的过渡句:先完成方法论四点列举,再进入案例分析。
第6段(P0084)
原文复述
…Gerald Hendrie as the copyist of Music MSS 1113 at Christ Church, might serve as an example of a reliable source.
中文讲解
本段具体说明:编辑Gerald Hendrie将William Ellis认定为Christ Church所藏Music MSS 1113号手稿的抄写者,并初步判断Ellis可能是"可靠来源”(a reliable source)的范例。这里同时给出了抄写者的归属判定与初步的可靠性评价,为后文进一步铺陈Ellis的专业资历做铺垫。
补充说明
Music MSS 1113是Christ Church所藏编号为1113的音乐手稿的馆藏编号。
第7段(P0085)
原文复述
He served as organist at St. John’s College.
中文讲解
本段开始陈述Ellis之所以被视为可靠来源的具体理由:他担任过St. John’s College的管风琴师(organist)。这一专业职务背景表明Ellis具备专业音乐素养,因此其抄本在专业能力层面应较有保障。
补充说明
Ellis的St. John’s College管风琴师职务是其专业身份的核心标志。
第8段(P0086)
原文复述
St. John’s College, Oxford, was the very place where Gibbons himself received his Doctor of Music degree in 1622.
中文讲解
本段补充关键背景:Ellis任职的St. John’s College位于牛津(Oxford),正是Gibbons本人于1622年获得音乐博士学位(Doctor of Music degree)的同一所机构。这一事实把Ellis与Gibbons在机构层面直接关联起来,强化了Ellis作为"可靠抄写者"的论据:他在作曲家曾就读并取得最高学位的同一所学院任职,可能与作曲家本人或其作品有更近的接触。
补充说明
1622年Gibbons在牛津取得音乐博士学位这一事实,由本段直接提供。
第9段(P0087)
原文复述
Ellis held the organist post there from 1639 to 1646 (see footnote 4). Yet editor Hendrie claims that three pieces ascribed to…
中文讲解
本段先给出Ellis任职的精确时间区间(1639至1646年),随即以"Yet”(然而)一转:尽管有上述种种有利背景,编辑Hendrie仍主张Ellis手抄本中被归于Gibbons名下的若干作品并非Gibbons真作。这一转折构成了本节论证的关键反例:即便抄写者身份可靠,也不能默认其抄本中所有归属判定都成立。
补充说明
脚注4在本段末尾被引入;“Yet"是本段论证转折的核心标记词。
第10段(P0088)
原文复述
…Gibbons in Ellis’ hand are unauthentic.
中文讲解
本段是上段的收尾,明确点出Hendrie所质疑的对象是"三首被归于Gibbons名下、由Ellis抄写的乐曲”(three pieces ascribed to Gibbons in Ellis’ hand),并判定为"非真作”(unauthentic)。这一结论与前文建立的"Ellis可能是可靠来源"的印象形成张力,提示:抄写者本人可靠,并不等于抄本中所有署名与归属都可靠;署名真伪仍需单独甄别。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节段落末尾以脚注上标形式引入了两个脚注:脚注3(P0079,指向Parthenia这部印刷出版物)和脚注4(P0087,针对Ellis任职1639–1646年间的相关背景)。两处脚注均为对正文叙述的辅助说明,脚注正文本身未在本次task_input中提供。
💡 本节核心要点
- 在与Gibbons音乐相关的四十一份史料中,只有Parthenia是印刷本,其余四十份均为手抄本,构成编辑工作面对的核心史料群。
- 这批手稿由从业余到专业程度不等的众多抄写者完成,因此编辑必须主动质疑抄本的准确性,而非默认其可靠。
- 编辑评估手稿时应系统考察四个维度:抄写者身份、抄写者所依据的底本、抄写者与作曲家的接近程度,以及抄写的目的。
- William Ellis作为方法论的具体实例,被初步判定为可能可靠的抄写者:他是牛津St. John’s College的管风琴师(1639–1646),而Gibbons本人正是在该学院获得1622年的音乐博士学位。
- 然而即便身份背景有利,Hendrie仍判定Ellis抄本中三首归于Gibbons的乐曲为非真作,提示抄写者可靠性与归属真伪是两个必须分开考察的问题。
🔑 关键术语
- Parthenia:本节中指与Gibbons音乐相关的唯一印刷出版物(见P0079及脚注3);其"印刷"属性使其区别于本节讨论的主体——其余四十份手抄本。
- copyists:指手抄本的抄写者群体;本节强调其水平跨度从业余到专业,是编辑必须审视抄本准确性的根本原因。
- Music MSS 1113, Christ Church:指Christ Church所藏编号为1113的音乐手稿,被编辑Gerald Hendrie认定为William Ellis所抄写,是本节用以讨论抄写者可靠性的核心案例手稿。
- Doctor of Music degree:音乐博士学位;本节指出Gibbons于1622年在牛津St. John’s College获得该学位,这一事实被用来建立Ellis与Gibbons之间的机构联系。
s11 [描述性拆分] Anonymous Attributions and Style-Based Editorial Decisions
第1段(P0089)
原文复述
Verifying a piece copied anonymously–or pieces unidentified by known
中文讲解
本段位于小节开头,是一个被强行断行的句子片段。原文完整句子从 P0089 开始一直延续到 P0091:‘Verifying a piece copied anonymously–or pieces unidentified by known copyists–involves a variety of bibliographic and style-analysis techniques.’ 这里因为印刷排版原因被拆成若干行。中文含义是:核实一份匿名抄录的乐谱——或由不为人知的抄写员抄写的乐谱——需要用到多种文献学与风格分析的方法。‘anonymous’(匿名)指的是不署名,‘copyists’(抄写员)指的是手稿的誊抄者,‘bibliographic and style-analysis techniques’(文献学与风格分析技术)是后面展开的两条主要路径。
第2段(P0090)
原文复述
copyists–involves a variety of bibliographic and style-analysis tech-
中文讲解
本段继续承接 P0089 的句子,仍是排版断行造成的片段,意思是:由不为人知的抄写员抄写的乐谱,其核实工作需要多种文献学与风格分析技术。‘bibliographic’(文献学的)关注乐谱的物理载体(如手稿、印本)与署名归属,‘style-analysis’(风格分析)关注音乐本身的语言特征。
第3段(P0091)
原文复述
niques. Many editors find it unnecessary to detail their investigations
中文讲解
本段结束前面的话题句,并引出下一层论述:许多编者认为没有必要在序言或附录中详细交代自己所做的调查工作。‘detail’ 在此是动词,意为“详细说明”;‘investigations’ 指对笔迹、纸张等所做的考证。这是作者对该编辑实践的第一次观察。
第4段(P0092)
原文复述
of handwriting, paper analysis, etc. in prefaces or appendices. However,
中文讲解
本段承接 P0091,补全’调查’的具体内容:笔迹鉴定、纸张分析等;同时标明这些内容被省略的常见位置是序言(prefaces)或附录(appendices)。末尾的 ‘However’(然而)预告下面将出现转折——从’编者省略’转向’部分编者使用模糊的表述’。
第5段(P0093)
原文复述
some feel free to claim vague “stylistic” reasons without explanation for
中文讲解
本段承接上一段的 ‘However’,指出另一类编辑做法:有人随意援引含混的所谓“风格”理由,却不给出解释。‘feel free to’ 带有作者轻微的批评意味;“stylistic” 加上引号,提示作者对该词的不精确使用持保留态度。‘vague’(含混的)一词是后文要反复追究的关键问题。
第6段(P0094)
原文复述
verifying or omitting a given version. In Alan Brown’s textual commentary
中文讲解
本段先补全上句:含混的“风格”理由被用于“确认或舍弃某个版本”。然后引出具体案例——Alan Brown 的文本评注。’textual commentary’(文本评注)是指编辑在版本中对其文字取舍依据所写的说明性文字。‘Alan Brown’ 是后面反复出现的具体编者名字。
第7段(P0095)
原文复述
to the collected keyboard works of William Byrd $^{5}$ several references to
中文讲解
本段补全出处:Alan Brown 为 William Byrd 键盘作品全集所写的文本评注中,多次提及“风格”。上标的 $^{5}$ 是一个脚注编号,指向本节末尾或本页的脚注 5。‘keyboard works’(键盘作品)界定了讨论范围;‘William Byrd’ 是都铎时期的英国作曲家。
第8段(P0096)
原文复述
“style” refer to some criteria for decision-making. “Echo Pavan,” whose
中文讲解
本段说明 Brown 评注中“style”(风格)一词被用作某种决策依据(criteria for decision-making)。然后开始列举第一个具体案例:‘Echo Pavan’(回声帕凡)。‘Pavan’ 是一种三拍子慢速宫廷舞曲,‘Echo’ 为标题前缀。‘whose’ 引出对该作品来源的描述。
第9段(P0097)
原文复述
source is anonymous, “seems probable on grounds of style (to be) compara-
中文讲解
本段说明 “Echo Pavan” 的来源是匿名的;Brown 凭所谓“风格理由”认为它“seems probable on grounds of style (to be) comparatively early”(就风格而言,似乎可能属于较早时期)。括号中的 (to be) 表示原文作者在改写 Brown 原文时,对语法做了淡化处理。末尾 ‘compara-’ 是为排版而被截断的词首。
第10段(P0098)
原文复述
tively early.“6 “Pavan #102” in the same collection is read from two
中文讲解
本段先完成上句的“comparatively early”(相对较早),并在引文后标注脚注 6;接着引出第二个案例 ‘Pavan #102’,说明它与上一案例出自同一乐谱集。‘is read from two’ 预告该曲被放在两个来源中相互对照。
第11段(P0099)
原文复述
sources, one attributed to Byrd and the other to Thomas Morley. Brown
中文讲解
本段说明 ‘Pavan #102’ 在两个来源中分别归于 William Byrd 和 Thomas Morley(都铎晚期英国作曲家)。‘sources’(来源)指不同手稿或印本;‘attributed to’(归于)表明这是手稿上的署名而非确认事实。
第12段(P0100)
原文复述
describes the attribution to Morley as “certainly incorrect” without giving
中文讲解
本段指出 Brown 将归于 Morley 的署名称为“certainly incorrect”(肯定错误),但 ‘without giving’(未给出)一句关键说明:他没有提供理由。‘certainly incorrect’ 与 ‘without giving his reason’ 之间的对比,正是作者在该小节集中批评的“含混风格论断”的典型。
第13段(P0101)
原文复述
his reason. “Pavan 101” Brown verifies as Byrd’s, though qualifying that
中文讲解
本段补全上句(‘his reason’ 即 Brown 的理由),引出第三个案例 ‘Pavan 101’。Brown 将其验证为 Byrd 的作品,但 ’though qualifying that’(虽然做出限定说)一句预示后面将出现具体限定语。‘verifies as Byrd’s’(验证为 Byrd 的)是被肯定的判断,与 ‘qualifying’(限定)构成对照。
第14段(P0102)
原文复述
it is “diffuse in style, lacks a sense of logical harmonic progression, and
中文讲解
本段开始列出 Brown 给出的限定语:作品“diffuse in style”(风格上松散)、“lacks a sense of logical harmonic progression”(缺乏逻辑和声推进感)。‘diffuse’(弥散的、松散的)指音乐材料缺乏凝聚;‘harmonic progression’(和声进行)是从一个和弦到下一个和弦的进行方式。‘and’ 提示还有更多限定。
第15段(P0103)
原文复述
… much of the figuration is untypical.“7 “Pavan #99B” has only one
中文讲解
本段以省略号延续 Brown 的原话:“much of the figuration is untypical”(大部分的装饰音型都不典型),并标注脚注 7。‘figuration’(音型化走句、装饰旋律)指作品中的装饰性旋律片段;‘untypical’(不典型)说明这些走句偏离 Byrd 的常见手法。省略号代表引文被略去。作者随后引出第四个案例 ‘Pavan #99B’。
第16段(P0104)
原文复述
source, and that an anonymous ascription. Brown includes it as Byrd’s
中文讲解
本段说明 ‘Pavan #99B’ 只有一个来源,且该来源的署名(ascription)是匿名的。‘ascription’(归属宣称)指手稿上的署名文字。需要注意的是这里的措辞:手稿上的署名是匿名的,但 Brown 却 ‘includes it as Byrd’s’(将其收入 Byrd 名下)。
第17段(P0105)
原文复述
without any explanation.
中文讲解
本段是最后一句的结尾:‘without any explanation.’(完全不附解释)。与前文 P0093–P0094 所述的“含混风格理由”形成具体印证:本案甚至连模糊的“风格”理由都没有给出,Brown 就直接将其纳入 Byrd 作品集。作者以此案例的极端性收束整个小节,强化对编辑实践不透明性的批评。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节包含至少两个脚注编号(段落 P0095 中的 $^{5}$ 与 P0097/P0098 中的 6,以及 P0103 中的 7),分别指向参考书目条目或补充说明,因输入未提供脚注主体内容,无法进一步展开其作用。本节无独立图表或边栏。
💡 本节核心要点
- 匿名抄本与未知抄写员乐谱的归属确认须依赖文献学(笔迹、纸张等)与风格分析两类方法。
- 许多编者不在序言或附录中公开其调查细节;部分编者则援引含混的“风格”理由而不作解释。
- Alan Brown 为 William Byrd 键盘作品全集所写的文本评注在不同案例中展示了三种倾向:注明风格依据、给判断却未给出理由、以及完全不附解释。
- ‘Echo Pavan’ 的归属依据被表述为“seems probable on grounds of style”但论证语焉不详。
- ‘Pavan #102’ 中归于 Thomas Morley 的署名被 Brown 称为“certainly incorrect”,却未解释理由。
- ‘Pavan #99B’ 仅有一个匿名来源,Brown 却将其径直归入 Byrd 名下而不作任何交代,是该小节批评的极端案例。
🔑 关键术语
- bibliographic techniques:文献学方法;指通过手稿/印本的物理特征——如笔迹、纸张、水印、抄写员身份——来判断作品归属的考证手段。
- style-analysis techniques:风格分析方法;指通过音乐本身的语言特征——旋律、和声、节奏、音型——来判断作品归属或创作时期。
- textual commentary:文本评注;编辑在版本中说明其如何取舍文本、做出归属判断的注释性文字。
- ascription / attributed to:归属宣称;指手稿或印本上所写的署名文字。它只是历史记载,不等于已被证实的事实。
- figuration:音型化走句;作品中较为装饰性、模式化的旋律片段,常用于判断作曲家的写作习惯。
- harmonic progression:和声进行;和弦之间的连接顺序,可用于判断作曲家的和声风格与作品时期。
s12 [描述性拆分] Consequences of Unverified Attributions
第1段(P0106)
原文复述
A lack of convincing evidence or reasoning in such cases weakens the
中文讲解
该行开启一个未完成的句子,需与 P0107 合并阅读才能得到完整论点。“in such cases” 回指前文讨论的归属(attribution)不明确的具体情形;“convincing evidence or reasoning” 指编辑未能就归属判定提供令人信服的证据或推理。本句的核心主张是:缺乏这类证据会削弱(“weakens”)某种事物的权威性,但具体削弱的对象在本行尚未交代,要由 P0107 完成。
第2段(P0107)
原文复述
authority of any definitive collection. Musicians using the edition may
中文讲解
承接 P0106,句子在 “weakens the authority of any definitive collection” 处收束,明确削弱的对象是任何"权威性版本集”(definitive collection)。随后开启新句,主语转为 “Musicians using the edition”(使用该版本集的演奏者),谓语 “may question” 预告了下文将出现的具体疑问。论证逻辑由此推进:证据不足 → 版本集权威性受损 → 使用者产生怀疑。
第3段(P0108)
原文复述
question whether the editor had proof of authorship of certain pieces.
中文讲解
完成 P0107 开始的句子,明确演奏者具体怀疑的内容:编辑是否掌握了某些作品归属的证据(“proof of authorship”)。这是第一层论点的收束,把抽象的"权威性削弱"落到具体怀疑——演奏者会怀疑编辑的归属判断依据。
第4段(P0109)
原文复述
There may be speculation that an editor is biased against inclusion of
中文讲解
新句开始,引入第二种可能的疑虑。“speculation”(推测)一词提示这是更进一步的揣测,而非确定的事实。怀疑的具体方向由下一行交代:编辑可能对收录某位作曲家较弱的作品抱有偏见。
第5段(P0110)
原文复述
weaker pieces by a favored composer. Perhaps their stylistic criteria for
中文讲解
承接 P0109,揭示具体怀疑:编辑可能不收录(“against inclusion of”)某位受偏爱作曲家(“a favored composer”)的较弱作品(“weaker pieces”)。随后开启新句,“their stylistic criteria for” 引出对编辑风格判据的进一步质疑。
第6段(P0111)
原文复述
authenticity is based on mature works, overlooking artistic development
中文讲解
承接 P0110,揭示编辑风格判据的具体问题:其真伪标准(“stylistic criteria for authenticity”)以成熟期作品(“mature works”)为基础。“overlooking artistic development” 指出这种做法的副作用——忽略了作曲家职业生涯中的艺术发展过程。
第7段(P0112)
原文复述
during a composer’s career.
中文讲解
完成 P0110–P0111 的句子,补全"overlooking artistic development"的时间状语——“during a composer’s career”(贯穿作曲家的整个生涯)。这收束了第二层论点的展开:编辑的风格标准若只以成熟期为据,会忽略艺术成长过程,从而可能造成归属偏差。
第8段(P0113)
原文复述
Unverified or ambiguous ascriptions of pieces to composers leave at
中文讲解
新段落开启,提出中心论断:未经验证或含糊的归属(“unverified or ambiguous ascriptions”)会给演奏者和音乐学者留下(“leave”)若干问题。“at least”(至少)这一限定词暗示下文将列举的问题并非穷尽式,而是最低限度。
第9段(P0114)
原文复述
least two problems for musicians and musicologists. The identity and stat-
中文讲解
承接 P0113,明确问题的数量(至少两个)和受影响群体(演奏者与音乐学者)。“The identity and stat-” 是 “stature”(地位/声誉)的换行拆分,预告了第一个问题:个体作曲家的身份与地位将变得模糊。
第10段(P0115)
原文复述
ure of individual composers remains hazy or perhaps distorted. And the
中文讲解
承接 P0114 的换行,“stature” 完成拼写。明确第一个问题:个体作曲家的身份与地位(“identity and stature”)仍处于模糊(“hazy”)甚至被扭曲(“perhaps distorted”)的状态。“And the” 提示第二个问题即将提出。
第11段(P0116)
原文复述
style of an entire period may be confused with the style of a few individual
中文讲解
承接 P0115,提出第二个问题:当过多作品身份不明时(详见 P0117),整个时期的风格(“style of an entire period”)可能被混淆为少数个体的风格(“the style of a few individual”)。这是把局部误认为整体的逻辑错误。
第12段(P0117)
原文复述
composers, where too many pieces remain unidentified. As research on
中文讲解
承接 P0116,“composers” 完成 “a few individual composers” 的短语,并以 “where” 引导定语从句说明造成混淆的原因:过多作品仍然身份不明(“too many pieces remain unidentified”)。随后 “As research on” 引出转折,从问题陈述过渡到解决希望的描述。
第13段(P0118)
原文复述
Elizabethan composers produces more editions, a more adequate explanation
中文讲解
承接 P0117,指明研究对象——伊丽莎白时代作曲家(“Elizabethan composers”)。随着研究推进、新版本(“editions”)不断产生,对编辑程序的更充分解释(“a more adequate explanation”)将有助于回应前文提出的两类问题。
第14段(P0119)
原文复述
of procedure would answer some of these needs. Students of a single com-
中文讲解
承接 P0118,完成句子:编辑程序的更充分解释将部分回应这些需求(“answer some of these needs”),“some” 这一限定保留问题的复杂性并未被完全消解。随后开启新句,主语转为 “Students of a single com-"(单一作曲家音乐的研究者),换行处 “com-” 将与下行的 “poser’s” 拼合为 “composer’s”。
第15段(P0120)
原文复述
poser’s music would be aided in understanding specifics of that composer’s
中文讲解
承接 P0119,完成 “Students of a single composer’s music” 这一主语短语。谓语部分说明这类研究者将从更清晰的编辑程序中受益:他们将更好地理解(“be aided in understanding”)该作曲家风格的具体特征(“specifics of that composer’s”),其宾语由下一行的 “style” 完成。
第16段(P0121)
原文复述
style. When conflicts between editions did occur, an editor’s criteria
中文讲解
承接 P0120,“style” 完成宾语短语。具体说明研究者获得的帮助:理解该作曲家风格的具体细节。随后开启条件状语从句 “When conflicts between editions did occur”——当版本之间出现冲突时,主句内容由下一行交代。
第17段(P0122)
原文复述
could be self-explanatory.
中文讲解
完成 P0121 开启的条件句,说明当版本间冲突发生时,编辑的标准(“an editor’s criteria”)本应"不言自明”(“self-explanatory”)。这是收束性的主张:若编辑程序有充分说明,争议发生时读者可直接从说明中理解编辑取舍的依据,无需另行猜测。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节文本为印刷段落因排版换行而被逐行拆分的连续正文(页 9,paragraph_id P0106–P0122)。原文段中可见词中换行(如 P0114/P0115 的 “stat-/ure”、P0119/P0120 的 “com-/poser’s”、P0121/P0122 的 “criteria/could” 等),无脚注、图表、边栏或图像占位符等附加材料。
💡 本节核心要点
- 缺乏令人信服的证据或推理会削弱任何权威性版本集(definitive collection)的权威,使用该版本集的演奏者会进而怀疑编辑是否掌握归属证据。
- 进一步推测:编辑可能对受偏爱作曲家的较弱作品存在收录偏见,其风格真伪标准若仅以成熟期作品为据,会忽略作曲家整个生涯中的艺术发展过程。
- 未经验证或含糊的归属至少造成两类问题:个体作曲家的身份与地位变得模糊甚至被扭曲;过多未辨认作品会使整个时期的风格被误归为少数个体,从而把局部误作整体。
- 随着伊丽莎白时代作曲家研究的推进,新版本不断产生,对编辑程序的更充分说明可部分回应上述需求。
- 清晰的程序说明还能帮助单一作曲家研究者理解其风格的具体特征;并在版本冲突发生时,使编辑标准自身具有可解释性,无需读者另行猜测。
🔑 关键术语
- definitive collection:权威性版本集,指编辑判定后整理出版的具有结论性归属的曲集;本节指其权威性会因归属证据不足而被削弱。
- ascriptions:归属判定,指将作品归于特定作者;本节聚焦于"未经验证"或"含糊"的归属所产生的负面后果。
- stylistic criteria for authenticity:风格真伪标准,编辑据以判定作品真伪的风格判据;本节指出若仅以成熟期作品为据,会忽略作曲家艺术发展的过程。
- Elizabethan composers:伊丽莎白时代作曲家,是本节研究展望的具体对象;随着相关研究推进和新版本产生,编辑程序的更充分说明将有助于回应未验证归属造成的问题。
- self-explanatory (criteria):编辑标准自身具备可解释性;本节主张若编辑程序有充分说明,版本冲突发生时读者可直接理解编辑取舍依据。
s13 [描述性拆分] LaRue’s Definition of Style
第1段(P0123)
原文复述
The opening clause sets a conditional: when an authorship question rests entirely on stylistic rather than bibliographic evidence.
中文讲解
这是整段的起首条件句。“When an authorship question rests solely on stylistic rather than bibliographic elements” 划定了讨论范围——只有在缺少版本、抄本、署名、题献等书目学(authororship-relevant bibliographic)证据时,分析者才被迫仅凭风格证据来论证归属。“solely"与"rather than"两个限定共同把风格分析定位为归属论证的独立依据,而非辅助手段。该条件句为下文提出"双重路径"与 LaRue 定义设下前提。
第2段(P0124)
原文复述
The conditional clause continues, stating that analysts are required to adopt a dual approach.
中文讲解
承接条件句,规定方法论——必须采取"双重路径”(dual approach)。“required"一词把这种方法上升为规范性要求:单一视角不足以独立支撑归属论证,必须双管齐下。
第3段(P0125)
原文复述
The dual approach is specified to consist of the close study of one composer’s output, in the first instance.
中文讲解
双重路径的第一条:对某一位候选作曲家全部作品的细读(close study of one composer’s output)。这是一种内向、聚焦的视角——把候选者的乐谱当作一个整体来掌握其笔法偏好。句中"one"而非"the"意味着这条方法先要选定一个被检验的对象。
第4段(P0126)
原文复述
The second leg of the dual approach is the broader examination of contemporaneous or traditional music for comparison; the passage then pivots to cite Jan LaRue’s preface to Guidelines for Style Analysis as the source of an authoritative definition of “style.”
中文讲解
双重路径的第二条:更宽广地审视同时期或传统音乐,以与候选者作品比较。“contemporaneous or traditional"分别对应两种参照系——同时代风格(用于分辨个人选择与时代风尚)与体裁程式(用于分辨个人选择与体裁惯例)。句末顺势过渡到权威引用:LaRue《Guidelines for Style Analysis》一书的前言将为 “style” 一词给出细致定义。
第5段(P0127)
原文复述
The cited source is identified as Jan LaRue’s preface to Guidelines for Style Analysis.
中文讲解
点明定义来源:LaRue 为《Guidelines for Style Analysis》所写的前言。这一引用为后文的定义赋予权威性——它不是分析者临时拟出的定义,而是出自风格分析领域标准文献的既有概念。
第6段(P0128)
原文复述
The passage notes that this preface gives a careful definition of “style” applicable in both of the dual contexts just named.
中文讲解
强调 LaRue 的定义同时回应前文的两重语境——既面向单部作品的"作品风格”,也面向作曲家整体的"个人风格”,并隐含扩展到学派与时代的更广层面。“careful"提示该定义经过斟酌,而非粗略概括,为后文逐层扩展的引文作出铺垫。
第7段(P0129)
原文复述
LaRue’s definition, quoted in full: “… the style of a piece consists of the predominant choices of elements and procedures a composer makes in developing movement and shape. … By extension, we can perceive a distinguishing style in a group of pieces from the recurrent use of similar choices; and a composer’s style as a whole can be described in terms of consistent and changing preferences in his use of musical elements and procedures. Even more broadly, common characteristics may individualize a whole school or chronological period. As these shared choices become increasingly general, of course, their application to any particular composer decreases.”
中文讲解
LaRue 的定义可拆为四个由窄到宽的层级:(1)单部作品的风格——指作曲家在塑造乐章运动与外形(developing movement and shape)时所做的"主导性"选择,覆盖 elements(音高、节奏、音色等)与 procedures(对位、和声进行、曲式布局等);“predominant"是关键限定,意味着并非所有出现过的选择都构成风格证据,只有反复占据主导的才算。(2)一组作品的区分性风格——通过"反复出现的相似选择"来识别。(3)作曲家整体风格——以其使用音乐要素与手法时"稳定与变化兼具的偏好"来描述;这一措辞既容纳恒常特征,也容纳演变,使风格判断兼容成长与转变。(4)学派或时代共性——更宏观的层次。“individualize"一词揭示作者逻辑:共性反而成为某学派或时代被识别的"个体特征”。结尾的限定句"As these shared choices become increasingly general… their application to any particular composer decreases” 是反向警示:越是宏观、越是普遍的风格特征,越难以用来辨认某一具体作曲家——这把风格分析与归属论证的可行性直接关联起来,回应了开头"solely stylistic"条件句的潜在危险。
补充说明
elements 与 procedures 是 LaRue 风格分析体系的基础二分;“predominant choices” 与 “consistent and changing preferences” 两组措辞共同表明,风格判断既强调主导性、稳定性,也容纳个人演变。段末 “$^{8}$” 为脚注标记,其具体内容未见于本节输入,故仅作来源标注提示,不补写外部文献信息。
脚注 / 边栏 / 图表 / 附加信息(如有)
P0129 句末的 “$^{8}$” 标记指向 LaRue 该段引文的原始出处;本节输入未提供该脚注的具体文献信息,因此只能注明其"标记存在、作用为来源标注”,不再补写。
💡 本节核心要点
- 当作者归属问题只能依赖风格证据而非书目学证据(solely stylistic)时,分析者必须采用"双重路径”——细读候选作曲家全部作品 + 横向比较同时期或传统音乐。
- LaRue 的风格定义呈四层递进结构:单部作品(主导性选择)→ 一组作品(反复相似选择)→ 作曲家整体(稳定与变化的偏好)→ 学派/时代(共性特征)。
- 同一组"共享选择"越是普遍、越是宏观,其辨别特定作曲家的能力就越弱——这是风格归属论证的根本限制,也回扣到开头 solely stylistic 条件句所暗示的方法论风险。
- “predominant” 与 “consistent and changing preferences” 两组限定说明:风格判断既要求主导性、反复性,也必须为个人演变留下空间。
- 该定义把"学派/时代共性"也纳入风格范畴(individualize 一词),使归属论证必须落到"作品/作曲家"层面而非仅靠宏观共性。
🔑 关键术语
- style:LaRue 定义中的核心概念,分四层:(1)单部作品的主导选择;(2)一组作品的反复相似选择;(3)作曲家整体的稳定与变化偏好;(4)学派或时代的共性。本节以此作为风格证据在归属论证中的概念基础。
- stylistic elements vs. bibliographic elements:本节区分的两类归属证据:前者指乐谱内部的音乐要素与写作选择,后者指版本、抄本、署名、题献等外部书目学证据。整段的前提即"仅有前者可用"的归属情境。
- dual approach:风格归属分析的规范方法:聚焦细读候选作曲家全部作品(close study of one composer’s output)与横向比较同时期或传统音乐(broader examination of contemporaneous or traditional music)并举。
- predominant choices:LaRue 定义中"风格"的核心成分——作曲家在塑造乐章时反复做出、占据主导地位的选择;并非所有出现过的要素或手法都构成风格证据。
- individualize (a school or period):LaRue 用语,指共性特征反而使某学派或时代被识别为可分辨的"个体”。在本节中提示:共性可作分类标签,但不能直接用于归因具体作曲家。
s14 [描述性拆分] Quantitative Style Measurement and the SHMRG Framework
第1段(P0130)
原文复述
Measurements of style according to LaRue’s Guidelines are derived from the musical elements he classifies as ‘SHMRG’: Sound, Harmony, Melody, Rhythm, and Growth.
中文讲解
本句说明:依据LaRue《Guidelines》所做的风格测量,建立在他本人所分类的一组音乐元素之上,这些元素被统称为"SHMRG”,即Sound(音色)、Harmony(和声)、Melody(旋律)、Rhythm(节奏)、Growth(展开/成长)。换言之,风格的量化测量并非凭空进行,而是以这五类音乐要素为分析对象;这一缩写也是把LaRue的风格描述接上统计语言的入口。
第2段(P0131)
原文复述
…continued: from the musical elements he classifies as ‘SHMRG’: Sound, Harmony, Melody, …
中文讲解
本句承接P0130,展开缩写SHMRG的前三项:Sound(音色)、Harmony(和声)、Melody(旋律)。该段为本节的题眼所在——作者借这一缩写把LaRue的方法定位为一套可与统计学对接的范畴系统。
第3段(P0132)
原文复述
Rhythm, and Growth. $^{9}$ The procedure outlined in the excerpt above shows a decidedly quantitative approach to the analysis of those elements.
中文讲解
本句补完SHMRG的最后两项:Rhythm(节奏)与Growth(展开),并附有脚注9标记(按出版体例指向正文之外的注释区域)。随后作出本段的关键判断:上文摘录中所展示的那套操作程序,对上述五类音乐元素采取了一种明确无误的(decidedly)量化分析路径。本句为整段定调——作者在告诉读者,下面要展开的并非定性描述,而是一套可以对接统计学的量化做法。
补充说明
脚注9属于附加材料,其具体内容须查正文之外的注释区域;本段正文未对其展开说明。
第4段(P0133)
原文复述
decidedly quantitative approach to the analysis of those elements. The …
中文讲解
本句保留原文用词decidedly(意为"明确地、毫不含糊地”,正确拼写为decidedly而非decidely),强调LaRue这套程序并非带有定性色彩,而是带有明显的量化取向。作者通过对"定量"二字的强调,为后文把LaRue用语改写为统计学语言作铺垫。需要注意的是,decidedly在此处是修辞强度副词,作者借此把LaRue方法定性为一项"不容含混的量化项目”。
第5段(P0134)
原文复述
The terms ‘predominant,’ ‘recurrent,’ ‘consistent’ and ‘changing’ all describe statistical measures of central tendency and distribution.
中文讲解
本句点出LaRue用语中的四个关键词:predominant(占主导的)、recurrent(反复出现的)、consistent(一贯的)、changing(变化的)。作者在此作出一项关键的等同性主张:这些看似描述性、日常化的形容词,在LaRue的方法中实际上承担着统计量度量的功能。这是把"风格描述词"改写为"统计学术语"的第一步,也是本节论证的核心动作。
第6段(P0135)
原文复述
…all describe statistical measures of central tendency and distribution (i.e., ‘mean’ and …
中文讲解
本句进一步说明:上述四个LaRue用语所描述的是集中趋势(central tendency,即数据聚集的中心位置)和分布(distribution,即数据的散布形态)的统计度量,并用括号注明它们对应的具体统计量——“均值(mean)"。也就是说,predominant等四个词在量化框架下被归到描述均值与离散程度这两类指标的范畴之内。
第7段(P0136)
原文复述
…and ‘standard deviation’). The last sentence quoted embodies the statistical determination of stylistic identity.
中文讲解
本句补完对统计量的列举:除均值外,另一项是"标准差(standard deviation)"。随后转向一个新的判断——上文摘录中的最后一句本身就体现了对风格身份的统计测定。所谓"风格身份”,指某位作曲家或某件作品的风格特征如何被识别与归属;作者认为,这一识别过程在LaRue的方法中是以统计方式完成的,而非凭主观印象。本句的功能是为下一段引出更具体的统计技术作过渡。
第8段(P0137)
原文复述
“As these shared choices become increasingly general” — the quoted phrase is the last sentence referred to, and it embodies the statistical determination of stylistic identity.
中文讲解
本句引入LaRue原文中的关键短语:“随着这些共享的选择变得越来越具有一般性(As these shared choices become increasingly general)"。所谓shared choices,指在多位作曲家或多个作品中共同出现的风格选择;作者在此只是引用原话,不对它做额外的术语性引申。该引语正是P0136所提到的"最后一句”,承担着风格身份统计测定的核心论据。
第9段(P0138)
原文复述
“increasingly general” describes a region of measurement that can most effectively be pinpointed by a statistical procedure known as discriminant analysis.
中文讲解
本句原文仅陈述:“increasingly general"这一表述描述了一个测量区域(a region of measurement),该区域可以由某种统计程序最有效地加以定位。作者在此只是把LaRue的语言改写为测量语言,并未引入"样本/总体"或"由特殊到一般"之类的统计推断框架;这些是判别分析在统计学语境中的常见解释,但并非本句原文所主张的内容,因此讲解不替作者补出这些推论,只把本句锁定在"一个可定位的测量区域"这一原文表述上。
第10段(P0139)
原文复述
…by a statistical procedure known as discriminant analysis.
中文讲解
本句点出该统计程序的名称:判别分析(discriminant analysis)。这是把LaRue的定性表述最终落到具体统计方法上的关键一步;作者把与一般化程度相关的测量区域与判别分析对接起来。需要提示的是,本句只是把名称落到纸面,并不展开判别分析的技术细节。
第11段(P0140)
原文复述
analysis.
中文讲解
句尾收束词。与P0139合在一起,构成完整短语"discriminant analysis”(判别分析)。本段不引入新信息,只完成句法上的收尾。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节范围内出现一处脚注标记(位于P0132的’Growth. $^{9}$’),指向第9号注释,其具体内容须查阅正文之外的注释区域;本节正文未对该脚注作展开说明。本节未出现图表、乐谱或边栏材料。
💡 本节核心要点
- LaRue的《Guidelines》把风格测量建立在五类音乐元素(SHMRG:Sound、Harmony、Melody、Rhythm、Growth)之上。
- 作者判定LaRue的分析程序呈现明确的量化取向(a decidedly quantitative approach)。
- LaRue的四个描述性用语——predominant、recurrent、consistent、changing——在量化框架下被改写为描述集中趋势(均值)与分布(标准差)的统计量。
- 作者认为,“风格身份"的识别在LaRue方法中是一个统计测定过程,而非纯定性判断。
- 作者把LaRue原话中的"increasingly general"改写为一个可由统计程序定位的测量区域(a region of measurement)。
- 作者进一步指出,判别分析(discriminant analysis)是定位该测量区域的有效统计手段。
🔑 关键术语
- SHMRG:LaRue《Guidelines》中风格分析的五类范畴缩写:Sound(音色)、Harmony(和声)、Melody(旋律)、Rhythm(节奏)、Growth(展开)。在本节中,它是把LaRue方法接上统计语言的共同载体。
- decidedly quantitative approach:作者对LaRue程序性质的判定,意为"明确的量化分析取向”。该判定是本节论证的起点,决定了后续把LaRue用语改写为统计学术语的合法性。
- central tendency / distribution (mean, standard deviation):统计学中描述数据集中位置与散布形态的两类度量。作者用均值与标准差作为LaRue四个描述词(predominant、recurrent、consistent、changing)的统计对应物。
- statistical determination of stylistic identity:指风格身份的识别过程在LaRue方法中以统计方式完成;这是作者从LaRue文本中提取并加以再表述的核心命题。
- region of measurement:作者对LaRue原话"increasingly general"的改写,指可由统计程序定位的一段测量空间;本节讲解并不在此引入样本/总体之类的额外推论。
- discriminant analysis:判别分析。作者在本节指认它是定位上述测量区域的有效统计手段。
s15 [描述性拆分] Discriminant Analysis as a Model for Style Separation
第1段(P0141)
原文复述
Discriminant analysis provides a model for separating the individual
中文讲解
本句是该小节的总论点:判别分析(discriminant analysis)被作者用作一种模型,其功能是把“个体倾向”(individual tendency)与“共性”(the general)区分开来。这是一种典型的统计分类思路——在多变量样本中,既要识别总体规律,又要识别每位作者/作曲家的独特偏移。放在小节标题“Discriminant Analysis as a Model for Style Separation”之下,这句话承担了“方法—目的”配对的功能声明。
补充说明
原文把方法(discriminant analysis)与目的(style separation)配对提出,下一句立刻补充了实施条件。
第2段(P0142)
原文复述
tendency from the general, once variables based upon LaRue’s five musical
中文讲解
承接 P0141,分号逻辑是“一旦……就……”:要把个体倾向从共性中分离出来,前提是先把基于 LaRue 五个音乐要素的变量建立起来。这里 LaRue 的“五要素”是作者整套方法论的观察单位,意味着判别分析的输入不是任意特征,而是有理论依据的变量集合。
补充说明
LaRue 指音乐学者 Jan LaRue,其“Style and Ideas in the Western Musical Tradition”之中的分析框架将音乐作品拆解为若干要素层,本节用作变量来源。
第3段(P0143)
原文复述
elements have been put into quantitative form and counted from pieces by
中文讲解
继续承接条件链:上述变量必须被“转化为定量形式”(quantitative form),并对多位作曲家的作品进行计数(counted)。这说明该方法的可行性依赖于两点——把音乐学概念操作化为可测量变量,以及对若干作品进行系统计数。
补充说明
“quantitative form”是该方法从传统风格学转向计量风格学的关键步骤。
第4段(P0144)
原文复述
several composers. Not only can it indicate from a total group’s data what
中文讲解
条件链完结,开始陈述判别分析的两类功能。第一类功能:从总体样本数据中指出哪些变量能够区分个体成员(indicate … what variables distinguish individual members)。注意“not only”提示后文还有第二类功能,作者用并列递进结构来强化判别分析的双重价值。
补充说明
“total group’s data”强调分析的对象不是单件作品,而是一组多位作曲家的样本集合。
第5段(P0145)
原文复述
variables distinguish individual members, but it can classify “unknown”
中文讲解
承接“not only … but …”结构,第二类功能是对“未知样本”(“unknown” examples)进行归类。未知样本被加上引号,提示这是方法论术语,指尚未确定作者/归属的待测作品。
补充说明
“unknown”一词在风格归属研究中是常用术语,指归属未定的待考作品。
第6段(P0146)
原文复述
examples as being most or least similar to individuals in the group.
中文讲解
补全第二类功能的具体含义:判别分析可以根据相似度把未知样本归入与组内某位个体“最相似”或“最不相似”的类别。这是一种连续性的、概率式的归属判断,而不是简单的二元判断。这一段为本节后半部分由音乐学转向文学案例提供了逻辑桥梁——判别分析的分类能力正是后文 Federalist Papers 案例所要展示的。
补充说明
“most or least similar”说明判别分析输出的是距离/概率量纲,而非硬分类。
第7段(P0147)
原文复述
Though no current literature describes the use of discriminant analysis
中文讲解
转折开始,作者承认在音乐学领域目前(“current”)尚无文献记载使用判别分析。这种“though”让步结构一方面诚实地交代方法在音乐学中尚属首次应用,另一方面也为下文引入跨学科先例做铺垫。
第8段(P0148)
原文复述
in musicology, $^{10}$ there are examples of research in literary style employing
中文讲解
让步与转折同时完成:虽然音乐学无前例,但文学风格研究中存在成功运用判别分析的案例。脚注 10 应对应音乐学领域中方法来源的注释(本输入未提供脚注内容,故不作推测)。这一句是小节从“方法介绍”转向“跨学科类比”的桥梁。
补充说明
上标 10 为脚注标记,本输入未提供其正文。
第9段(P0149)
原文复述
it successfully. The most famous case is the disputed authorship of
中文讲解
点名“文学风格”领域中最著名的判别分析应用案例——“作者归属争议”。作者用“the most famous case”暗示读者该案例在学界具有标杆地位,这不仅赋予方法以合法性,也提示读者:此案例的论证逻辑与本节将要做的事情(把音乐风格按作者区分)结构同构。
第10段(P0150)
原文复述
twelve of the eighty-five “Federalist Papers” written variously by John
中文讲解
交代案例的具体规模:85 篇《联邦党人文集》中有 12 篇归属存疑,作者署名为“variously by John”——即下文的 Jay、Madison、Hamilton 三人中的不同人。这里的数字(85、12)以及限定语“variously”共同构成历史背景。
补充说明
《联邦党人文集》是 1787–1788 年间发表于纽约报纸的政论合集,原本署名“Publius”。
第11段(P0151)
原文复述
Jay, James Madison, and Alexander Hamilton. $^{11}$ The papers represent news-
中文讲解
补全三位可能作者——Jay、Madison、Hamilton。脚注 11 应对应 Federalist Papers 案例的出处注释(本输入未提供脚注内容)。从论证角度看,作者列出三位候选人但下文立刻把焦点收窄到“the two most probable authors”,这是为案例简化做铺垫。
补充说明
上标 11 为脚注标记,本输入未提供其正文。
第12段(P0152)
原文复述
paper articles written from 1787-88 in very similar rhetorical style urging
中文讲解
说明这些论文的体裁与写作条件:1787–88 年间发表于报纸的政论文章,措辞修辞风格“非常相似”(very similar rhetorical style)。作者强调“very similar”这一限定十分关键——正因为文体相似,才使得归属问题无法仅靠印象判断,必须借助计量方法。
第13段(P0153)
原文复述
New York residents to ratify the U.S. Constitution. With inadequate
中文讲解
补全写作目的:说服纽约居民批准美国宪法。这进一步说明这些文章在题材、立场上趋同,使归属问题更具方法论挑战性——传统历史证据(“inadequate”一句即将出现)已无法独立回答归属。
第14段(P0154)
原文复述
historical evidence to answer the question, Frederick Mosteller and David
中文讲解
正式交代案例的方法论动机:历史证据“不足以”(inadequate)回答归属问题。这构成了引入计量方法的合理性基础——传统史学路径走不通,所以需要风格计量学。作者署出 Mosteller 与 Wallace 两位研究者的名字,为方法背书。
补充说明
Frederick Mosteller 与 David Wallace 是统计学家,1960 年代起以 Bayes 方法研究 Federalist Papers 归属问题。
第15段(P0155)
原文复述
Wallace used analysis of frequencies of certain words to distinguish the
中文讲解
说明 Mosteller 和 Wallace 采用的具体方法:对“某些词的出现频率”(frequencies of certain words)进行分析。把这句与本节方法论对照:LaRue 的“五要素”被定量计数,与此处“词频计数”在结构上同构——都是以可计量的低层特征来推断高层归属。
第16段(P0156)
原文复述
sets of known papers by Madison and Hamilton, the two most probable authors.
中文讲解
补全案例逻辑:用已知归属的 Madison 与 Hamilton 论文为训练集,区分二者的语言习惯,再用以判断那 12 篇归属存疑论文的作者。作者再次用“the two most probable authors”收窄分析对象——Jay 被排除在外,因为只有 Madison 与 Hamilton 的已知样本最充足。这一收束也暗示:本节计划对多位作曲家作品所做的判别分析,将采用类似的“已知 vs. 未知”结构。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节含两个上标脚注引用:上标 10 位于 P0148,对应音乐学领域判别分析文献出处;上标 11 位于 P0151,对应 Federalist Papers 案例的出处。两则脚注正文均未包含在当前 task_input 中,故无法复述其具体内容;按教学规范,仅记录其位置与功能,不作推测性补充。
💡 本节核心要点
- 判别分析在本节中被定位为一种把个体风格与共性区分开的统计模型,其输入须基于 LaRue 五要素的定量计数。
- 该方法具有双重功能:一是识别区分个体的关键变量,二是将未知样本按相似度归入已知个体。
- 作者承认在音乐学文献中尚无判别分析应用先例,故转入文学风格领域的跨学科类比。
- Federalist Papers 案例(85 篇中 12 篇归属存疑)因其作者三人、修辞高度趋同、史料不足,被用作判别分析归属研究的标杆案例。
- Mosteller 与 Wallace 以词频分析区分 Madison 与 Hamilton 的已知论文,是“已知样本训练—未知样本分类”结构的经典实现。
- 案例与本节音乐学应用在结构上同构:定量特征 + 已知样本 + 待判样本,为后续把判别分析引入作曲家风格区分提供合法性。
🔑 关键术语
- discriminant analysis:判别分析,一种多元统计方法,依据若干已知分类样本的变量,构造分类函数以判别新样本归属;本节中用作区分个体作曲家风格的统计模型。
- LaRue’s five musical elements:音乐学者 LaRue 提出的五项音乐要素框架,本节将其作为定量变量的来源,是判别分析的输入特征。
- “unknown” examples:归属未定的待测作品样本,文中以引号标出,指尚未确定作者或归属的作品。
- Federalist Papers:《联邦党人文集》,1787–88 年间由 Jay、Madison、Hamilton 以“Publius”笔名发表于纽约报纸的政论合集,其中 12 篇归属存疑,是判别分析归属研究的经典案例。
- most or least similar:判别分析输出的连续相似度量度,强调归属判断的概率/距离性质,而非硬性二元分类。
s16 [描述性拆分] The Federalist Papers Study as a Model for Authorship Verification
第1段(P0157)
原文复述
Those word-rates that showed the greatest discrepancy between them were
中文讲解
本句以关系从句起头:‘Those word-rates that showed the greatest discrepancy between them’是主语,‘were’为谓语的开头,尚未给出过去分词补语。‘word-rates’指单位文本中某词出现的频次;’the greatest discrepancy between them’强调这些词在已知作者之间使用频率的差异最大。整句的功能是对前文所述方法做收束式回顾:差异最大的那些词频被挑选出来,用作后续归属性判别的工具。
补充说明
本段与P0158、P0159合为一个完整句子。
第2段(P0158)
原文复述
used to build profiles against which identical word counts from the questionable papers
中文讲解
承接上段,补全整句:那些差异最大的词频被用来构建’侧写’(profiles),再把争议文章中相同词类的出现次数拿来与之比对。‘profiles’在此处指基于一组词频统计所建立的作者特征档案;‘identical word counts’指同一组词在争议文章里的统计计数;‘against which…were tested’(动词见P0159)显示比对是’针对’侧写进行的检验。
补充说明
本段与P0157、P0159合为一句。
第3段(P0159)
原文复述
were tested.
中文讲解
完整句的谓语收尾——‘were tested’为被动语态,表明争议文章中的词频是被拿来接受检验的对象。这一句实际上定义了Mosteller和Wallace归属研究的判别机制:以’高区分度词频侧写’为基准,让争议文本中相同词类的频次与之比对,由此推断归属。
补充说明
本段是P0157-P0158所述方法句的谓语收尾。
第4段(P0160)
原文复述
In choosing the words to count in the essays, Mosteller and Wallace
中文讲解
本段开启新一层论证:解释Mosteller和Wallace是如何’挑选要计数的词’的。‘In choosing the words to count in the essays’以介词短语点出方法论中的关键决策节点——并非随意挑词,而是有策略地挑选。‘Mosteller and Wallace’是研究者姓名(与P0157-P0159所暗示的方法相对应)。此句承上启下:从’方法是什么’过渡到’方法的选词策略是怎样形成的’。
第5段(P0161)
原文复述
first tried stylistic “markers”: words which an author used so consis-
中文讲解
承接P0160:他们’最先尝试’(first tried)的策略是寻找’风格标记词’(stylistic markers)。冒号后立即给出操作性定义——指作者使用极其稳定、其出现与否即可强烈指示作者身份的词。‘first’一词暗示这只是初步方案,下文将说明其局限,并最终过渡到P0157-P0159所述的’词频侧写’方法。‘markers’在此为隐喻性术语,强调标记性、指示性功能。
补充说明
本段与P0162合为一句;‘consis-‘为行末断词,应读作’consistently’。
第6段(P0162)
原文复述
tently that their appearance might give a strong indication of authorship.
中文讲解
完成风格标记词的定义。‘so consistently that… might give a strong indication of authorship’从’使用频率稳定’推出’归属指示力’。注意情态动词’might’——作者刻意使用may/might而非will,表示概率性推断而非确定性结论。这与下文对该策略’不充分’(inadequate)的判断形成呼应:归属判断本质上是概率问题,仅靠少数高特异词并不足以作出可靠结论。
补充说明
与P0161合为一句完整定义。
第7段(P0163)
原文复述
They were advised by historian Douglass Adair that Madison used “whilst”
中文讲解
本段引入新信息——历史学家Douglass Adair向研究者建议:Madison惯用’whilst’。‘They’回指Mosteller和Wallace;‘were advised by’的被动结构表明这条线索来自外部专家的指点,而非研究者自己首先发现。‘historian’一词点出Adair的身份,其建议代表了来自人文/历史学背景的专家知识。这段叙事的功能是引入风格标记词策略的一个具体范例。
第8段(P0164)
原文复述
in place of Hamilton’s fairly consistent “while.“¹² Basing discrimination
中文讲解
完成Adair建议的引述:Madison用’whilst’代替Hamilton较为一贯使用的’while’,二者构成一对候选风格标记词。‘in place of’(替代)点明二词在使用习惯上的对照关系。句末脚注12出现于此(应为对Adair观点的来源或补充说明)。随后以’Basing discrimination’开启新一句:‘Basing…on the occurrence of such words’是悬垂分词结构,等于条件状语’如果我们把判别建立在这类词的出现之上’,其中’discrimination’指归属判别,不含贬义。
补充说明
脚注12标记位于本段,需查阅原页脚注区以确认其内容。
第9段(P0165)
原文复述
on the occurrence of such words was inadequate. Discovering a longer list
中文讲解
承接P0164的悬垂分词结构,完成批判句:‘把判别建立在whilst/while这类风格标记词出现与否之上是不充分的’(inadequate)。‘such words’回指上文讨论的具有作者特异性的标记词。‘Discovering a longer list’引出第一项不足——发现更长的同类标记词列表需要耗费大量精力,这构成了从’成本’角度提出的批评。
补充说明
本段与P0164、P0166、P0167合为同一论证段。
第10段(P0166)
原文复述
of such words takes a great deal of time, and this pair of markers did not
中文讲解
承接P0165:第一项不足——发现更长的此类标记词列表需要耗费大量时间(’takes a great deal of time’)。‘and’连接并列原因,转入第二项不足:’this pair of markers’特指上文’whilst/while’这对最佳候选词,‘did not’提前预示将说明其频率方面不可靠。从’耗时’到’频率’,两条否定理由依次展开。
第11段(P0167)
原文复述
occur with enough frequency throughout each essay to be reliable.
中文讲解
完成论证:连’whilst/while’这对最被看好的标记词,在每篇文章中都没有以足够频率出现,因而不足以支撑可靠的归属判断。这是双重否定的核心:即便标记词本身具有作者特异性(语义层面有效),若其在单篇文章中的频次过低(统计层面不足),归属判断就缺乏稳定性。该结论构成向’词频侧写’(P0157-P0159所述方法)转向的根本动因——只有借助高频词所提供的充足统计样本,才能实现稳定判别。
补充说明
本段是本小节论证段的收束。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节含脚注标记一处(脚注12),位于P0164中’while.‘之后,疑为对历史学家Douglass Adair所提’whilst/while’对照观点的来源说明或补充。原文正文未直接展开脚注内容,需查阅原页脚注区方可确认其性质。
💡 本节核心要点
- Mosteller和Wallace的核心归属方法:以已知作者间词频差异最大的一组词构建’作者侧写’,再用争议文章的同组词频与之比对。
- 他们最先尝试的策略是寻找少数’风格标记词’——作者反复、稳定使用、其出现与否即可强烈指示作者身份的少数词汇。
- 历史学家Douglass Adair建议以Madison惯用的’whilst’与Hamilton惯用的’while’作为风格标记词对的具体范例。
- ‘whilst/while’策略被判定为不充分,理由有二:发现更长的同类标记词列表耗时巨大;且即便是这一对最佳候选词,其在每篇文章中的出现频率也不足以支撑可靠的归属判断。
- 本节在小节整体论证中起’动机铺垫’的作用——通过揭示’风格标记词’策略在统计样本层面的局限,反衬出以高频词频差异为核心的’词频侧写’方法的合理性。
🔑 关键术语
- word-rates:词频,单位文本长度内某词的出现次数。在Mosteller和Wallace归属方法中是核心量化指标,用于刻画不同作者的语言使用习惯差异。
- stylistic markers:风格标记词,指作者反复、稳定使用、其出现与否即可强烈指示作者身份的少数词汇。本节论证其因发现耗时与单篇频率不足而不充分。
- profiles:作者侧写,基于一组词频统计构建的作者特征档案,作为归属比对的基准。
- questionable papers:归属存在争议的文章,即文中需鉴别作者身份的若干文本。
- Douglass Adair:向Mosteller和Wallace建议以’Madison的whilst/Hamilton的while’作为候选风格标记词对的历史学家,体现专家知识对该研究的辅助作用。
- whilst / while:本节作为风格标记词对的具体范例:Madison倾向使用古体形式’whilst’,Hamilton较为一贯使用现代形式’while’。本节论证该词对在单篇文章中频率过低,不足以可靠指示归属。
- Mosteller and Wallace:本节所述归属研究的两位主要执行者,其方法论的核心为以高频词频差异为基础的作者侧写。
s17 [描述性拆分] Filler Words as Discriminators in the Federalist Papers Study
第1段(P0168)
原文复述
Even more effective than the counts on “while” and “whilst” were the
中文讲解
这一行承接前文关于 while/whilst 计数分析的讨论,开启一个新的比较层级:某项指标比前述 while 和 whilst 的词频计数更具判别力。由于这是被版面拆开的句子片段,需要与下一段连读才能得知所谓"更具判别力"的具体对象。在小节论证上,它标志着论述重点从前两个连接副词转向下一组指标——填充词。
第2段(P0169)
原文复述
combined rates of nine common “filler” words–also, an, by, of, on, there,
中文讲解
本段承接 P0168 的比较,说明更具判别力的对象是"九个常见’填充词’的合计频率”。破折号后开始列举这九个词:also, an, by, of, on, there,…… 这一列举由原文跨行换行完成(属于排版拆行,并非作者分点列举),因此需要与下一段拼接才能读出完整词表。这里"filler words"被作者加上引号,表示这是借用术语化的概念——指语义较虚、语法功能为主的常用词,作者认为它们反而比实义词更能体现作者风格。
补充说明
filler 一词带引号,提示它是术语用法,而非其日常义"填充物”。
第3段(P0170)
原文复述
this, to, and upon–per 1,000 words in each essay. It may be wondered why
中文讲解
本段完成九个词的列举(this, to, and upon),并指明计量单位:每 1,000 字(per 1,000 words in each essay)。随后以"It may be wondered why"引出一个反问,预告作者将解释为什么这类看似无意义的词反而能产生显著判别。在小节论证上,这是从陈述结果转向解释原因的关键过渡。
补充说明
per 1,000 words 是文体计量学常用的归一化方法,使不同长度的文本可在同一基准上比较频率。
第4段(P0171)
原文复述
such words and not more meaningful contextual ones should produce signifi-
中文讲解
本段延续 P0170 的反问,完整表述为:为什么是这样一些词、而不是更有意义的语境词,产生了显著的判别?这是研究方法学上一个反直觉的发现——表面最有意义的实词反而难以稳定地用于风格识别。它为下一段作者给出解释埋下伏笔。
第5段(P0172)
原文复述
cant discriminations. It was apparent that contextual nouns and verbs were
中文讲解
本段以"cant discriminations"完成 P0171 拆开的"significant discriminations"一词,并切入原因说明:作者坦言,语境性的名词和动词……(未完)。“It was apparent"提示这一判断来自经验观察,而非纯理论推导。它承上启下——既是对前述反问的回应入口,也是论证从"为什么不用实词"过渡到"为什么用填充词"的桥梁。
补充说明
signifi- / cant 的拆行属于排版连字符处理,不影响词义。
第6段(P0173)
原文复述
less a part of the author’s stylistic choices than part of the subject
中文讲解
本段继续 P0172 的判断:语境性名词和动词较少属于作者的"风格选择”(stylistic choices),而较多属于"主题选择"(subject choice)。这是一个重要的区分——词的使用一方面受作者风格偏好驱动,另一方面受话题内容约束。该句以 less… than… 比较结构把重点放在后半句(主题约束),把"风格选择"的解释留到下一段。
补充说明
“stylistic choice"与"subject choice"的对立是文体计量学中区分"风格信号"与"内容信号"的标准思路。
第7段(P0174)
原文复述
choice. Given the set of 18 essays, there would be no way of guaranteeing
中文讲解
本段完成 P0173 的句子,并给出实证层面的理由:考虑到那 18 篇论文的集合,研究者根本无法保证……“Given the set of 18 essays"指向前文建立的争议论文集(disputed papers),它是论证的关键经验基础——正因为样本论文数量有限且话题各异,主题词的不稳定性才成为方法学上的实质问题。
补充说明
“the set of 18 essays"指向本研究的核心语料——联邦党人文献中归属有争议的论文集合。
第8段(P0175)
原文复述
a consistent profile of counts based on words that may or may not be appro-
中文讲解
本段继续 P0174 的解释:研究者无法保证基于"可能适用、也可能不适用于各自主题"的实词的计数具有一致轮廓。这句话直接说明了为什么用实词做频率统计不可靠——同一作者在不同议题下使用不同的名词动词,就会破坏频率分布的稳定性。这是对前述"风格 vs 主题"二分在方法学上的延伸论证。
补充说明
appro- / priate 的拆行属于排版连字符处理。
第9段(P0176)
原文复述
priate to the topic of each. The commonly used prepositions and articles
中文讲解
本段完成"appropriate to the topic of each(essay)",并切换到新句子,引入对比性的肯定结论:常用的介词和冠词…… 这一转折在结构上把论证由"为什么不用实词"反推到"为什么用功能词”,引出研究的主要实证发现。
补充说明
“prepositions and articles"在语法功能上属于封闭类词(closed-class words),成员有限且高度高频,与开放类实词(nouns, verbs)形成对照。
第10段(P0177)
原文复述
did discriminate effectively enough to show a decided stylistic slant toward
中文讲解
本段承接 P0176,指出常用介词和冠词的频率确实足以产生有效判别,并显示出对 Madison(麦迪逊)鲜明的风格倾向。“decided stylistic slant"意味着判别结果并非模糊,而是方向清晰。这是本研究的关键结论之一,与前几段的方法学推理形成前后呼应:从理论质疑到实证支持。
补充说明
“decided"在文中表示"明确、确定”,语气强烈,说明研究结论的方向性而非统计噪声。
第11段(P0178)
原文复述
Madison in the disputed papers. Such results indicate that the authors’
中文讲解
本段完成 P0177 的句子,明确争议论文的风格倾向指向 Madison,并以"Such results indicate"领起一段更一般性的推论——作者的风格更多体现在何处。这是把小节结论提升到方法学结论的关键过渡:从"频率判别有效"上升到"风格究竟栖居在语言的哪个层面”。
补充说明
“the disputed papers"即归属有争议的联邦党人文献,与上文 the set of 18 essays 指代同一研究对象。
第12段(P0179)
原文复述
style was expressed more in the way they connected their “contextual”
中文讲解
本段延续 P0178 的推论:作者的风格更多表现在他们"如何连接"自己的语境词汇上。“contextual"带引号,与下文呼应——指真正承载意义的实词。这句话的含义是:决定作者风格的不是用了哪些实词,而是用什么样的功能词(介词、冠词等)把实词串起来。这是小节的核心论断之一。
补充说明
“contextual"在引号内被重新定义,与 “filler words” 在引号内的术语化处理方式一致,提示读者它是技术性用法。
第13段(P0180)
原文复述
vocabulary than in the choice of that vocabulary itself.
中文讲解
本段完成整个推论句:与其说风格体现于实词本身的选择,不如说体现于对实词的连接方式(vocabulary than in the choice of that vocabulary itself)。这一句是小节的收束之言,也是对前述实证发现(介词与冠词的频率判别有效)的理论总结:在文体计量识别中,“连接词"比"实义词"更能反映作者身份的稳定信号。它回应了开篇的反直觉问题——为什么看似无意义的填充词反而是更好的风格指纹。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节无脚注、图表或边栏等附加材料。
💡 本节核心要点
- 九个常用填充词(also, an, by, of, on, there, this, to, upon)的合计归一化频率比 while/whilst 的单点计数更能判别争议论文的作者归属。
- 实义词(语境性名词和动词)的使用更多受主题而非风格驱动,因此在 18 篇议题各异的样本中无法提供稳定的频率轮廓。
- 封闭类功能词(介词、冠词)的频率反而能够有效判别,并显示出对 Madison 的明确风格倾向。
- 研究由此得出方法学结论:作者风格更稳定地栖居于"如何连接实词"而非"选择哪些实词”,这一反直觉发现是本节最重要的一般化成果。
🔑 关键术语
- filler words(填充词):指 also、an、by、of、on、there、this、to、upon 这类语义较虚、语法功能为主的常用词;本研究中它们在判别作者身份上比实义词更稳定。
- contextual vocabulary(语境词汇):指真正承载话题意义的实义词(名词、动词等);其使用受主题制约,难以单独作为稳定的风格指纹。
- stylistic choice vs. subject choice(风格选择 vs. 主题选择):文体计量学中区分的两类用词驱动因素:本节论证实义词更多属于主题选择,而功能词更多承载风格选择。
- per 1,000 words(每千词归一化):文体计量学常用频率单位,用以在不同长度的文本间公平比较词频。
- the disputed papers / the set of 18 essays(争议论文 / 18 篇论文集合):联邦党人文献中作者归属存在争议的样本集合,是本研究计数分析与判别结论的基础语料。
s18 [描述性拆分] Parallels Between the Federalist Papers Method and Musical Style Analysis
第1段(P0181)
原文复述
The appropriateness of Mosteller and Wallace’s procedure to musical
中文讲解
本片段开启本节的核心主张:Mosteller 与 Wallace 的统计鉴别程序适用于音乐分析。Mosteller 与 Wallace 指 Frederick Mosteller 与 David Wallace,他们发展了用于《联邦党人文集》作者归属的贝叶斯统计方法(其成果是 1964 年的 Inference and Disputed Authorship,但本节内并未出现具体年代与著作名,按输入不补)。本片段是句首成分,与下一片段(P0182)连读构成完整断言:这种适用性"无需过分依赖语言学/音乐学的类比"即可成立。也就是说,作者不打算靠"语言学统计 ≈ 音乐学统计"这种表面类比来为方法辩护。
第2段(P0182)
原文复述
analysis can be asserted without undue reliance on linguistic/musical
中文讲解
承接 P0181,本片段补出被截断的宾语 “analysis”,并完成第一句的限定性条件:“can be asserted without undue reliance on linguistic/musical [analogies]"。关键词是 “without undue reliance”(无需过分依赖),它表达了作者的克制——并不否认语言学与音乐学之间存在类比,而是主张本方法的恰当性可以独立于这类类比被论证。这一限定为本节的论证设定了立足点:方法论的合法性来自 LaRue 的风格定义与统计程序的内在契合,而非简单的跨学科类比。
第3段(P0183)
原文复述
analogies. LaRue’s previously cited definition of musical style as a
中文讲解
本片段以 “analogies.” 结束第一句,并以 “LaRue’s previously cited definition of musical style as a” 开启第二句。“previously cited” 表明 LaRue 对风格的定义在前文(本节之前)已经出现过,本节只是再次援引;本片段不重述完整定义,而把定义内容留到下一片段。LaRue 指音乐学家 Jan LaRue,其风格定义即下一片段引出的引文 “predominant choices of elements and procedures”。本句的功能是从方法论的过渡(第一句讲程序适用性)转入概念的对应(第二句讲 LaRue 风格定义 ↔ 联邦党人案统计画像)。
第4段(P0184)
原文复述
composer’s "predominant choices of elements and procedures" aptly describes
中文讲解
本片段引出 LaRue 的核心定义——作曲家对"元素与手法的最主要选择”(predominant choices of elements and procedures),并用 “aptly describes”(贴切地刻画)将其与下一片段(M&W 在联邦党人案中寻求的统计画像)连接起来。引文必须保留 LaRue 原文用语,不得意译。“aptly describes” 一词至关重要:它表明 LaRue 音乐风格定义与 Mosteller/Wallace 统计画像不是"勉强类比”,而是概念上同构——两者都关心创作者在可量化单位上反复出现的偏好性选择。这为本节后文铺路:因为定义同构,所以方法可以直接迁移。
第5段(P0185)
原文复述
the statistical profile sought in the Federalist Papers. The elements
中文讲解
本片段结束第二句:LaRue 的定义"贴切地刻画"了 Mosteller/Wallace 在《联邦党人文集》研究中寻求的统计画像(statistical profile)。“statistical profile” 指的是通过词频分布等可量化指标形成的作者"指纹”。随后以 “The elements” 开启第三句,引出对该统计画像中被量化对象的讨论——即下一片段揭示的"看似无足轻重的虚词”(filler words)。本片段在论证链上完成了一次桥接:先确立概念同构(LaRue 定义 ≈ 统计画像),再揭示统计画像的具体载体(虚词)。
第6段(P0186)
原文复述
quantified in that case were seemingly insignificant filler words. In this
中文讲解
本片段结束第三句并开启第四句。第三句揭示 Mosteller/Wallace 实际量化的对象是"看似无足轻重的虚词”(seemingly insignificant filler words,例如 while、such、on 等功能性小词)。“seemingly insignificant” 是限定语,强调这些词在日常阅读中毫无意义、却恰是统计辨伪的关键信号——这是 Mosteller/Wallace 研究方法的一个标志性特征。“In this” 紧接着开启转折/对比,引导第四句(下一片段):本研究将量化"音符时值”(notational values)而非虚词,建立音乐学中的对应物。
第7段(P0187)
原文复述
study measures of notational values will be used. According to LaRue,
中文讲解
本片段结束第四句并开启第五句。第四句完成与 Mosteller/Wallace 的对比:本研究将使用"音符时值的度量”(measures of notational values),而非虚词。“notational values” 指乐谱中音符的时值长度(如全音符、二分音符、四分音符等),它们是音乐记谱体系中最基本的可量化单位,对应于 Mosteller/Wallace 文本中的"虚词"。随后 “According to LaRue,” 引出权威背书——LaRue 认为量化乐谱中的可观察变化是一项基本分析程序,这为本研究的统计路径提供了方法论上的合法性。
第8段(P0188)
原文复述
quantifying the observable changes in a score is an essential analytical
中文讲解
本片段延续第五句,揭示 LaRue 主张的具体内容:“quantifying the observable changes in a score is an essential analytical procedure”——量化乐谱中可观察变化是一项基本分析程序。“observable changes in a score” 强调量化对象必须是乐谱上可直接观察的变化,而非依赖听觉印象;“essential analytical procedure” 表明这种量化在 LaRue 看来不是可选的方法,而是音乐分析的基础步骤。这一背书为本研究的统计取向提供了同行权威的支持:作者并不是在做一个新奇的方法实验,而是在实践 LaRue 已倡导的基本程序。
第9段(P0189)
原文复述
procedure. Important as a well-trained ear is, the memory of the music
中文讲解
本片段以 “procedure.” 结束第五句,并以 “Important as a well-trained ear is, the memory of the music” 开启第六句。“Important as … is” 是一个让步状语从句结构(“尽管……很重要”),承认训练有素的耳朵(well-trained ear)在传统音乐学中的核心地位。紧接着出现的是下一片段要完成的主句:音乐分析者的记忆"better served by separating out individual elements one usually hears simultaneously, then counting their occurrences"——即通过分离通常同时听到的各个元素并计数其出现次数来更好地服务于分析者记忆。这是从 LaRue 的方法论背书过渡到对传统听音方法的温和修正。
第10段(P0190)
原文复述
analyst is better served by separating out individual elements one usually
中文讲解
本片段延续第六句的主句:音乐分析者的记忆"better served by separating out individual elements one usually"——通过分离通常同时听到的各个元素,分析者的记忆能得到更好的服务。“better served” 这一比较级是关键:作者并不是否定听音训练(已在前一句让步承认),而是论证在记忆辅助方面,元素分离与计数胜过单纯依赖听觉。“individual elements one usually hears simultaneously” 指音乐中通常同时响起的多个声部/要素(如旋律、和声、节奏、音色等),它们在听感上融合在一起,但在分析时必须被拆开——这是从综合听感走向分析性认识的关键一步。
第11段(P0191)
原文复述
hears simultaneously, then counting their occurrences.
中文讲解
本片段以 “hears simultaneously, then counting their occurrences.” 结束第六句和全节。“then counting their occurrences” 给出方法论建议的第二步:在分离元素之后,统计它们各自的出现次数。把 P0190 与 P0191 合起来读,主张的方法论程序是:(1) 把通常同时听到的元素逐一分开,(2) 计数每个元素的出现次数。这一程序直接呼应本节开头的论证:LaRue 风格定义中的"最主要选择"(predominant choices)只有通过这种分离 + 计数才能被客观地揭示出来。第六句以这一操作化建议收束,使全节从方法适用性的论证(句 1-2)、概念同构(句 2-3)、量化对象对比(句 3-4)、权威背书(句 5),最终落到具体分析步骤(句 6),形成完整的论证链。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为纯论述性文字,无脚注、图表、谱例或边栏;段落编号 P0181–P0191 均为同一连续论述被按行拆开后的产物,组合起来共构成 6 个完整句子。无附加版面材料需要另行汇总。
💡 本节核心要点
- Mosteller 与 Wallace 的统计归属方法对音乐分析的适用性,可以不依赖语言学/音乐学的类比而被论证——本节开篇即明确这一立足点。
- LaRue 对音乐风格的定义(作曲家对"元素与手法"的"最主要选择")与 Mosteller/Wallace 在《联邦党人文集》中寻求的统计画像在概念上同构,这是方法迁移合法性的核心依据。
- 在具体量化对象上,本研究与 Mosteller/Wallace 形成对应:他们量化"看似无足轻重的虚词",本研究量化"音符时值"(measures of notational values)。
- LaRue 主张量化乐谱中可观察变化是基本分析程序,为本研究的统计取向提供了同行权威的背书。
- 作者以让步结构承认训练有素的耳朵之重要,但主张分析者的记忆通过"分离通常同时听到的元素并计数其出现次数"得到更好服务——这是从综合听感走向分析性认识的操作化程序。
🔑 关键术语
- Mosteller and Wallace’s procedure:指 Frederick Mosteller 与 David Wallace 在《联邦党人文集》作者归属研究中发展出来的贝叶斯统计鉴别程序;本节主张该程序可被合法地迁移到音乐风格分析中。
- LaRue’s definition of musical style:指音乐学家 Jan LaRue 对音乐风格的定义,即作曲家对元素与手法的"最主要选择"(predominant choices of elements and procedures);本节认为该定义与 Mosteller/Wallace 的统计画像概念上同构。
- statistical profile:统计画像,指通过词频等可量化指标形成的作者/作曲家指纹;本节认为这是 Mosteller/Wallace 研究的核心产出,也是 LaRue 风格定义在量化层面的对应物。
- filler words:虚词,指 Mosteller/Wallace 实际量化的对象——看似无足轻重但具有统计辨伪价值的功能性小词;本研究中由音符时值充当其音乐学对应物。
- notational values:音符时值,指乐谱中标注的音符持续长度(如全音符、二分音符、四分音符等);本节主张它们是音乐学中与"虚词"位置相当的可量化单位。
- well-trained ear:训练有素的耳朵,指传统音乐学倚重的听觉能力;本节以让步结构承认其重要性,但主张它与分析性的元素分离 + 计数程序并不冲突,且后者更能服务于分析者的记忆。
- separating out individual elements:分离各个元素,指把音乐中通常同时听到的多层声部/要素(旋律、和声、节奏、音色等)逐一拆开,以便后续单独计数——这是从综合听感走向分析性认识的关键操作步骤。
s19 [描述性拆分] Eliminating Evaluative Bias Through Notational Counts
第1段(P0192)
原文复述
A count of this sort lacks evaluative bias. In disregarding con-
中文讲解
本句开门见山地给出本节的核心论点:这种计数方法不带评价性偏差(evaluative bias)。句子随即开始一个长复合句,用来展开解释为什么计数法被认为无偏——因为它在分析中主动“忽略上下文词汇”(disregarding contextual words)。由于原文在 con- 处发生跨行连字符换行,这只是排版上的换行,并不构成独立的论点,但完整句子的开端必须在这里呈现出来,以保持与原文行界的对应。中文学术读者应注意:所谓“evaluative bias”,指的是研究者对作品好坏、重要性或美学价值的预判会影响统计结果;而本方法通过只统计音符时值等客观量化指标,宣称可以规避这种主观预判。
补充说明
本句承接上一节对计数方法本身的介绍,进一步从方法论的“中立性”角度为其辩护;它也是整段论述的论点(topic sentence)。
第2段(P0193)
原文复述
textual words for analysis, Mosteller and Wallace may have overlooked
中文讲解
这一行是上一句的延续,补全了“con-textual”这一跨行词。作者在此引入一项著名的前人研究:Mosteller and Wallace(即 Frederick Mosteller 与 David L. Wallace 的《推断《联邦党人文集》作者身份的决策与统计方法》)。作者承认,本方法在“剥离上下文词汇后进行分析”时,可能忽略了某些对特定学术领域(如 Madison 或 Hamilton 的政治修辞研究)极为重要的内容。这里的关键限定是“may have”——并非断言他们一定错失了什么,而是承认方法选择必然伴随取舍。
补充说明
Mosteller 与 Wallace 是统计文体学(stylometry)的奠基性案例,他们通过功能词频率来推断《联邦党人文集》的匿名作者;本节作者与之对比,是为了说明本方法的相似性与差异性。
第3段(P0194)
原文复述
aspects of political rhetoric that a Madison or Hamilton scholar considers
中文讲解
承接上句,进一步具体化被忽略的内容:那些在 Madison 或 Hamilton 研究专家眼里“具有意义”的政治修辞层面。所谓“Madison or Hamilton scholar”,指的是专门研究这两位美国“国父”政治著作的学者——他们所关心的修辞特征、政治立场、论证策略,正是单纯的词汇或音符计数所难以触及的。作者借此提醒读者:方法论的简化必然以丢失某些专业视角为代价。
第4段(P0195)
原文复述
significant. Similarly, a chord or figuration that one composer is known
中文讲解
结束关于 Mosteller 与 Wallace 的讨论,并以“Similarly”(同样地)开启类比:作者把统计学方法应用到音乐鉴别中所面对的取舍,与政治文献鉴别中的取舍相提并论。一个被某位作曲家以独特方式使用而闻名的“和弦”或“音型”(chord or figuration),可能并不足以将其作品与他人作品区分开来。也就是说,某些极具个人风格的音乐特征并不必然具备统计学意义上的“判别力”。这一行也以跨行连字符 figu-ration 拆开,需与下一行合并阅读。
补充说明
本句的关键术语 chord(和弦)与 figuration(音型/装饰型)在音乐分析中分别指纵向与横向的局部织体单位;作者以它们为例子,是要说明“作曲家的标志性手法”≠“可用于自动归属的稳定特征”。
第5段(P0196)
原文复述
to have used characteristically may not discriminate his or her works from
中文讲解
延续上句的类比:将“某作曲家标志性地使用过的和弦或音型”是否足以将其作品与他人作品区分开,作为类比的承载内容。这里暗含的方法论警示是:一个研究者凭直觉判断“很重要”的特征,并不一定在统计学上具有真正的区分能力。这种直觉与统计结果之间的鸿沟,正是作者主张用“累积判别力”(cumulative discriminating power,下文将出现)而非单一特征来鉴别作者的依据。
第6段(P0197)
原文复述
another’s. This study leaves the task of examining style from an aesthetic
中文讲解
结束音乐方面的类比,并明确划定本研究的工作边界:作者宣称本研究将“从美学或历史角度审视风格”的任务,留给其他研究者去做(leaves the task … to others)。这是一种典型的学术“边界声明”(disclaimer),既回应了可能的批评——即本研究忽略了作品的审美与历史维度——又重申本研究的范围只限于客观、量化的作者归属问题,不进入价值判断的领域。这同时也回应了 Mosteller/Wallace 案例中关于“忽略有意义的修辞维度”的批评。
补充说明
这一句是本节论证的转折点:承认遗漏、划定边界,从而为本方法的合法性进行辩护。
第7段(P0198)
原文复述
or historical standpoint to others. In the process of scrutinizing note
中文讲解
继续边界声明:将“美学或历史视角”完整列出,与上一行共同构成本研究“让渡出去”的工作领域。随后作者转入正面阐述:在“审视音符时值”(scrutinizing note values)以获取其“累积判别力”(cumulative discriminating power)的过程中,本研究假设——也就是明确假定——作品的质量(quality)不会影响结果。这是本方法对“评价性偏差”进行系统性规避的关键一步。
第8段(P0199)
原文复述
values for their cumulative discriminating power, it is assumed that the
中文讲解
这一行提出本研究方法论的核心假设之一:在评估音符时值的累积判别力(即组合使用多种时值特征时,整体鉴别作者的能力)时,假定“作品的质量”(the quality of the works)不会使结果产生偏差。所谓“累积判别力”,意味着单一音符时值可能判别力不足,但多种时值组合起来却能形成稳定可靠的作者指纹。这种“累积”思路是对单一特征鉴别力不足之回应——也是作者在前文以 Mosteller/Wallace 案例和音乐案例所铺垫的方法论选择。
第9段(P0200)
原文复述
quality of the works will not bias the results.
中文讲解
完成关键假设的陈述:作品质量不会使研究结果产生偏差。这一假设之所以重要,是因为如果不成立,那么我们用以“鉴别作者”的统计特征实际上可能只是在反映“作品质量/重要性”,从而混淆了“作者身份”与“作品价值”两类完全不同的信息。作者通过明确提出这一假设并把它作为方法前提,确保了本研究的统计结论是关于作者归属的,而非关于作品优劣的。这也呼应了本节标题中的核心方法论承诺——通过音符计数来消除评价性偏差。
补充说明
本句与开篇句“A count of this sort lacks evaluative bias”形成首尾呼应,使整段论证在结构上闭合:先宣告方法无偏,再逐一说明可能丢失的内容、划定研究边界,最后以方法论假设作为确保无偏性的形式化保障。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节无脚注、无图、无表,主要由一段连续文字构成。其核心功能是为随后将出现的方法(基于音符时值的累积判别力统计)提供方法论上的“中立性辩护”,并明确将美学与历史层面的风格研究排除在本研究之外。
💡 本节核心要点
- 本节的核心主张是:基于客观可计量的特征(如音符时值)来鉴别作者,不会受到评价性偏差的影响。
- 作者承认这种方法必然以忽略某些对专门学者(Madison/Hamilton 研究者、作曲家研究专家)而言“重要”的内容为代价。
- 通过 Mosteller/Wallace 案例与音乐类比,作者说明直觉上重要的特征不一定具有统计学意义上的判别力。
- 本研究明确将美学与历史层面的风格考察“让渡”给其他研究者,以保持方法边界的清晰。
- 关键方法论假设是:作品的质量(好坏、美学价值)不会使鉴别作者归属的统计结果产生偏差。
- 首尾呼应:开篇宣称计数法无评价性偏差,结尾以“作品质量不使结果产生偏差”这一明确假设作为形式化保障。
🔑 关键术语
- evaluative bias(评价性偏差):指研究者在分析作品时,因对作品好坏、重要性或美学价值的预判而影响统计或鉴别结果的主观倾向;本节宣称通过只使用客观可计量的特征来规避它。
- Mosteller and Wallace(Mosteller 与 Wallace 研究):指 Mosteller 与 Wallace 通过功能词频率推断《联邦党人文集》匿名作者的统计文体学经典研究;本节以其作为对比,说明本研究“剥离上下文词汇”这一选择的方法论取舍。
- cumulative discriminating power(累积判别力):指将多种特征(此处为多种音符时值)组合起来使用时,对不同作者进行归属鉴别的整体能力;与单一特征的判别力相对应。
- chord / figuration(和弦 / 音型):音乐分析中的两个基本织体单位,分别对应纵向同时性与横向线条特征;本节以二者为例,说明作曲家的标志性手法并不必然具备统计学上的判别力。
- Madison or Hamilton scholar(Madison 或 Hamilton 学者):指专门研究 James Madison 或 Alexander Hamilton 政治著作的专家;本节以其作为“专门语境知识”的代表,用以说明本方法可能忽略的维度。
s20 [描述性拆分] Multivariate Analysis of Composers, Pieces, and Variables
第1段(P0201)
原文复述
It should be evident that a statistical approach to quantifying musical
中文讲解
这是该段开头的断行片段;与下一段拼合后的完整句为 “It should be evident that a statistical approach to quantifying musical data is permissible”。译为:‘显而易见,对音乐数据进行量化的统计学方法是可被允许的。’ 该片段承接上一节的结论,将’量化音乐数据可被允许’作为本节的既定前提;‘It should be evident’ 这一措辞表明作者把该前提视作前文已经确立、无需再论证的共识,从而把本节的重心转向新的论题——多元模型是否同样恰当。
补充说明
原文此处是断行处,‘musical’ 一词在该行末尾被截断,下一段 (P0202) 补全为 ‘data is permissible’。
第2段(P0202)
原文复述
data is permissible. The use of a multivariate model to analyze that data
中文讲解
本片段包含两句的尾部与起首:(1) 收束前句 ‘……data is permissible’(……音乐数据是可被允许的);(2) 起首新句 ‘The use of a multivariate model to analyze that data’(使用多元模型来分析那些数据……)。此处出现一次关键的术语收紧:从较为宽泛的 ‘statistical approach’(统计学方法)过渡到更具体的 ‘multivariate model’(多元模型),表明作者在本节中已选定一种特定的统计学工具,并准备围绕它展开论证。
补充说明
本片段同时跨越两句边界;前句尾 ‘data is permissible’ 完成 P0201 的引出句,后句头 ‘The use of a multivariate model to analyze that data’ 由 P0203 收尾。
第3段(P0203)
原文复述
can now be shown to be appropriate when studying a group of composers.
中文讲解
本片段完成第二句。译为:’……现在可以证明,在研究一组作曲家时使用多元模型来分析那些数据是恰当的。’ 此处有两个关键限定:(1) ‘can now be shown’(现在可以证明)暗示作者将在本节中实际给出论证,而非仅作宣称;(2) ‘when studying a group of composers’(当研究一组作曲家时)明确了多元模型的应用范围——群体层面的研究,而非个案分析。
第4段(P0204)
原文复述
Multivariate analyses provide “assessments of patterns within, among and
中文讲解
本片段开启作者给出的多元分析工作定义。译为:‘多元分析提供’对变量群内部、之间以及……’(模式)的评估’。’ 内嵌的引文标记表明作者正在引用某个权威表述作为定义依据。‘Within, among and between’ 三个方位词将在下一片段以 ‘clusters of variables’ 收尾,对应于本研究需要同时处理的三个层级——同一变量群内部、同一变量群之间、以及不同变量群之间。
补充说明
引文起始处的双引号在此片段出现,闭合点位于下一片段 (P0205) 的 ‘variables.’ 之后。
第5段(P0205)
原文复述
between clusters of variables.“13 The variables in this study fall into
中文讲解
本片段完成引文并引入本研究的三类变量。译为:’……群之间的模式的评估。¹³ 本研究中的变量分为三种类型:’ 引文闭合后紧跟一个上标 ‘13’,标识该定义引自来源 13。本片段也正式宣告:本研究涉及三种类型的变量,下文将逐一列举。
补充说明
脚注 13 在本片段中出现,标记附于引文末尾,但脚注 13 的正文未包含在当前 task_input 中;如需补全该脚注的具体内容,应另行提供。
第6段(P0206)
原文复述
three types: 1) six individual composers 2) fifty-six keyboard pieces, and
中文讲解
本片段开始列举三类变量中的前两类。译为:‘三种类型:1) 六位个别作曲家;2) 五十六首键盘作品,以及……’ 第一个数字 6 限定了研究对象的作曲家数量,第二个数字 56 限定了被分析的作品数量;‘keyboard’(键盘)这一体裁限定表明样本来自键盘体裁,而非全部器乐或声乐作品。‘Individual’ 与 ‘pieces’ 的搭配暗示作者把作曲家视为离散的’个体’,把作品视为离散的’件’——这两类构成了多元分析中的样本与观测对象。
第7段(P0207)
原文复述
- fourteen quantified stylistic variables expected to distinguish, or dis-
中文讲解
本片段引入第三类变量并开始其描述。译为:‘3) 十四个量化的风格变量,预计用于区分或辨别(dis-/……)各作品。’ 第三个数字 14 是将被纳入分析的量化特征数量。‘Quantified’(量化的)一词强调这些变量是数值化的测量结果,而非定性描述。‘Expected to distinguish, or discriminate’ 双重措辞把第三类变量定位为’区分项’或’辨别项’——即研究者假设它们能在不同作品之间造成可观测的差异。
补充说明
‘dis-’ 是排版换行连字符,对应完整单词 ‘discriminate’ 的前半部分,下一片段 (P0208) 起首的 ‘criminate’ 与之拼合。
第8段(P0208)
原文复述
criminate between the works. If one had no statistical model with which to
中文讲解
本片段完成第三类变量的描述,并开启一个反事实条件句。译为:’……辨别各作品。如果没有统计模型可以用来……’ 前半部分与 P0207 拼合后得到 ‘……or discriminate between the works’(……或辨别各作品),完成了对第三类变量的功能性描述。后半部分 ‘If one had no statistical model with which to’ 引入假设性条件——‘假如没有统计模型可用’,构成作者为多元模型进行辩护的反事实论证的开端。
补充说明
‘criminate’ 与前段的 ‘dis-’ 拼合为完整单词 ‘discriminate’。
第9段(P0209)
原文复述
compare these groups, it would be difficult to assess all of the interrela-
中文讲解
本片段延续反事实条件句。译为:’……比较这些组,要评估……的所有相互关系将会很困难。’ ’these groups’(这些组)回指上一片段已完成列举的三类变量;‘it would be difficult’(将会很困难)构成了反事实论证的结论性陈述。‘Interrela-’ 是 ‘interrelationships’(相互关系)的断字前缀,揭示作者真正担忧的对象不是单一关系,而是’所有’(all of)三类变量之间的多重相互关系。
补充说明
‘interrela-’ 是排版换行连字符,对应完整单词 ‘interrelationships’ 的前半部分,下一片段 (P0210) 起首的 ’tionships’ 与之拼合。
第10段(P0210)
原文复述
tionships among composers, pieces, and style variables. Using a multi-
中文讲解
本片段完成反事实句并开始正向论证。译为:’……要评估作曲家、作品和风格变量之间的所有相互关系将会很困难。使用多元(multi-/……)模型……’ 前半段收束反事实论证,并明确三类对象——‘composers, pieces, and style variables’(作曲家、作品和风格变量)——与 P0206–P0207 所列举的三类变量一一对应。后半段 ‘Using a multivariate model’(使用多元模型)开始正向陈述,是反事实论证的转折点。
补充说明
’tionships’ 与前段的 ‘interrela-’ 拼合为完整单词 ‘interrelationships’;‘multi-’ 是排版换行连字符,对应完整单词 ‘multivariate’ 的前半部分,下一片段 (P0211) 起首的 ‘variate’ 与之拼合。
第11段(P0211)
原文复述
variate model, one could evaluate the significance of a given style choice to
中文讲解
本片段延续正向陈述,译为:’……多元模型,人们可以评估某一风格选择对(……)的意义。’ 作者把多元模型的具体能力具象化为两项操作:(1) ’evaluate the significance’(评估显著性/意义),即对某一风格特征是否具有统计意义上的区分作用做出判断;(2) 对象是 ‘a given style choice’(某一具体风格选择),表明评估可以细化到单个变量而非笼统的整体。
补充说明
‘variate’ 与前段的 ‘multi-’ 拼合为完整单词 ‘multivariate’。
第12段(P0212)
原文复述
a particular piece and composer. Distinctions among pieces by one composer
中文讲解
本片段完成前句并开启新句。译为:’……评估某一风格选择对特定作品和作曲家的意义。对一位作曲家各作品之间的差异(……)’ 前半部分补全了 ’evaluate the significance of a given style choice to’ 的对象——既可指向 ‘a particular piece’(某一作品)也可指向 ‘a particular composer’(某一作曲家),表明分析粒度可在作品级与作曲家级之间切换。新句 ‘Distinctions among pieces by one composer’ 引出多元分析所支持的差异类型枚举,第一类是一位作曲家内部各作品之间的差异。
第13段(P0213)
原文复述
as well as among several composers’ pieces can be estimated at the same time.
中文讲解
本片段完成关于’差异类型’的句子。译为:’……对一位作曲家各作品之间的差异,以及对几位作曲家作品之间的差异,可以同时进行估计。’ 与 P0212 拼合后呈现并列的两类差异:(1) ‘among pieces by one composer’(一位作曲家各作品之间);(2) ‘among several composers’ pieces’(几位作曲家作品之间)。‘At the same time’(同时)这一副词短语是方法论上的关键限定,表明多元分析在单次建模中即可同时估计这两类差异,而非分两步独立处理。
第14段(P0214)
原文复述
Statistical analyses allow one to assess the extent to which certain vari-
中文讲解
本片段开启一个更一般的陈述,作为本节末尾的方法论总结。译为:‘统计分析使人们能够评估某些变量(vari-/……)在多大程度上……’ 与前述具体能力描述相比,此处转为抽象命题:统计分析的总体功能是衡量变量对现象解释的贡献程度。‘The extent to which’(在多大程度上)为后续片段中出现的 ‘contribute to an explanation of some phenomenon’ 预留语法位置。
补充说明
‘vari-’ 是排版换行连字符,对应完整单词 ‘variables’ 的前半部分,下一片段 (P0215) 起首的 ‘ables’ 与之拼合。
第15段(P0215)
原文复述
ables contribute to an explanation of some phenomenon. Discriminate
中文讲解
本片段完成一般陈述并引入本节末尾的特定技术。译为:’……某些变量在多大程度上有助于解释某种现象。判别性(Discriminate)多元分析(……)’ 前半句收束一般命题,明确统计分析与’变量对现象解释之贡献’之间的功能关系。后半句 ‘Discriminate’ 作为形容词,开启 ‘Discriminate multivariate analysis’ 这一特定技术术语。该词在原文按 ‘Discriminate’ 形式照录(而非统计学中更常见的形容词 ‘Discriminant’),作者意在以’具有辨别功能的’这一含义修饰多元分析。
补充说明
‘ables’ 与前段的 ‘vari-’ 拼合为完整单词 ‘variables’。本片段中 ‘Discriminate’ 在英语统计学语境下作为形容词修饰 ‘multivariate analysis’ 时,标准用法通常为 ‘Discriminant’(判别),但本段严格按原文照录,未作改动。
第16段(P0216)
原文复述
multivariate analysis will indicate the relative importance of the stylistic
中文讲解
本片段延续末尾的特定技术陈述。译为:’……判别性多元分析将指出风格变量的相对重要性(……)’ 与 P0215 拼合后得到完整主句 ‘Discriminate multivariate analysis will indicate the relative importance of the stylistic……’。此处把该技术的功能具象化为:揭示各风格变量的’相对重要性’(relative importance),即在区分作品时哪些变量权重更大、哪些权重更小——构成一种排序或权重比较。
第17段(P0217)
原文复述
variables as discriminators.
中文讲解
本片段完成本节末句。译为:’……将指出风格变量作为辨别因子的相对重要性。’ ‘as discriminators’(作为辨别因子)把’风格变量’的角色回扣到本节较早出现过的措辞——P0207 中把第三类变量描述为 ’expected to distinguish, or discriminate between the works’(预计用于区分或辨别各作品)。至此,‘辨别因子’这一身份既是初始假设,也是判别分析的输出指向;首尾呼应闭合了本节关于多元分析功能的论证。
脚注 / 边栏 / 图表 / 附加信息(如有)
- 本节中段(P0205)出现上标 13,标识作者所引多元分析定义出处的脚注编号;但脚注 13 的具体正文未包含在当前 task_input 中。如需引用脚注 13 的内容,应另行提供。2) 整段文字在 OCR/排版中按行拆分为 17 个 source_paragraphs 条目,因此 source_restatement 中保留了若干英文换行连字符痕迹:P0207–P0208 的 dis-/criminate(→ discriminate)、P0209–P0210 的 interrela-/tionships(→ interrelationships)、P0210–P0211 的 multi-/variate(→ multivariate)、P0214–P0215 的 vari-/ables(→ variables)。这些连字符是原书排版的断字痕迹,不构成词义。3) 末句中 ‘Discriminate multivariate analysis’ 在统计学语境下作为形容词短语通常写作 ‘Discriminant multivariate analysis’(判别分析),但本段严格按原文照录为 ‘Discriminate’。
💡 本节核心要点
- 作者先承袭前文已成立的’量化音乐数据的统计方法可被允许’这一前提,并把它收紧为更具体的命题:在研究一组作曲家时,多元模型的使用同样恰当。
- 作者以一条引文式定义刻画多元分析的工作机制:它提供’对变量群内部、之间与群之间的模式的评估’,对应本研究需同时处理的群内、群间与跨群三类关系。
- 本研究的变量被显式分为三类:六位作曲家、五十六首键盘作品、十四个量化风格变量;风格变量被预设承担’区分或辨别作品’的功能。
- 作者用反事实论证为多元模型进行方法论辩护:若没有统计模型,要评估作曲家、作品、风格变量之间的’所有相互关系’将很困难;多元模型则可同时完成这些评估。
- 多元分析的具体能力被具象化为两点——可同时估计’一位作曲家内部各作品之间’与’几位作曲家之间各作品’两类差异,且可在作品级与作曲家级之间切换分析粒度。
- 本节以’判别性多元分析将揭示各风格变量作为辨别因子的相对重要性’收尾,把风格变量的’辨别功能’这一初始假设与最终分析输出闭合起来。
🔑 关键术语
- multivariate analysis / multivariate model:多元分析 / 多元模型:同时处理多个变量的统计方法。在本节中用于同时评估作曲家、作品与风格变量三类对象之间的相互关系,是作者为研究作曲家群体所选定的核心方法论工具。
- cluster of variables:变量群:本节把研究对象按类型分成三个’群’——作曲家、作品、风格变量。多元分析所考察的’within, among and between’三种模式分别对应群内、群间与跨群三个层级。
- discriminate (multivariate) analysis:判别性(多元)分析:本节末尾出现的术语 ‘Discriminate multivariate analysis’。在原文照录的形式下作为形容词短语修饰多元分析,意指’具有辨别作品之功能的多元分析’;其作用是揭示各风格变量作为辨别因子的相对重要性。
- stylistic variable:风格变量:本研究第三类变量,共十四个,被量化为数值化指标,预期用于区分或辨别作品,是判别分析所评估的对象。
- discriminator:辨别因子:本节末句中 ‘variables as discriminators’(作为辨别因子的变量)所标识的角色——风格变量在判别性多元分析中被作为区分不同作品的工具来评估其相对重要性。
- interrelationships:相互关系:本节反事实论证中所担忧的对象,指作曲家、作品与风格变量这三类变量之间’所有’的相互依赖。该词与多元分析的’内部、之间、群之间’三层评估相对应。
s21 [描述性拆分] Two Questions Addressed by Discriminant Analysis
第1段(P0218)
原文复述
Discriminate analysis is a multivariate procedure that can answer two
中文讲解
这是本节第一句的开头部分(断行所致)。它把判别分析(discriminant analysis)定位为一种"multivariate procedure”——多元程序,意味着它同时处理多个变量,而非一次只看一个变量。“can answer two"预示后文将逐一给出判别分析所能回答的两个问题,从而奠定了本节的论述框架。
第2段(P0219)
原文复述
related questions: 1) Given a large amount of data in the form of several
中文讲解
承接上句,把"answer two"补全为"answer two related questions”,并以冒号引出第一个问题。“Given a large amount of data in the form of several"是第一个问题的前提:以"若干测量(several measures)“形式存在的大量数据。作者用 “Given…"(给定……)这一条件结构,提示后续推理都建立在这一假设之上。
第3段(P0220)
原文复述
measures taken of several cases, which measures separate the mass of cases
中文讲解
延续第一个问题:“measures taken of several cases”——对若干案例采集到的多个测量值;“which measures separate the mass of cases…"——“哪一个(哪些)测量能把大量案例(the mass of cases)分离开”。这里"the mass of cases"强调面对的是大批量观测;“separate…into groups"明确第一个问题的核心目的:在多个变量中识别具有区分能力者。
第4段(P0221)
原文复述
into groups? 2) Given a set of discriminated groups, can a single unknown
中文讲解
这一行同时结束第一个问题(“separate the mass of cases into groups?")并以"2)“标记第二个问题。“Given a set of discriminated groups”——给定若干已经分好组的"已判别组(discriminated groups)",这是第二个问题的输入前提。注意"discriminated groups"用的是过去分词,说明这些组已经通过某种方式被区分好了,从而把问题限定在"归类未知案例"这一环节。
第5段(P0222)
原文复述
case be classified as belonging to one of them? Assuming that one had no
中文讲解
完成第二个问题:“can a single unknown case be classified as belonging to one of them?"——能否把一个未知的单一案例归入这些已判别组中的某一组?两个问题由此形成对照:第一个问"哪些变量能区分”,第二个问"如何对新案例分类”。紧接着"Assuming that one had no"开始一个假设性陈述,为下文铺垫:若没有判别分析这种技术可用,人们将如何应对?
第6段(P0223)
原文复述
such technique available, one’s procedure in answering the second question
中文讲解
承接假设:“Assuming that one had no such technique available”——若没有判别分析这种技术可用;“one’s procedure in answering the second question”——回答第二个问题(即对未知案例归类)时人们会采取的方法。作者借此把读者带入"假如没有判别分析"的反事实情境,以便凸显该技术的必要性。
第7段(P0224)
原文复述
would involve taking the averages of each measurement from one group to
中文讲解
描述朴素的归类方法:“would involve taking the averages of each measurement from one group to…"——逐组对每个测量求平均值。这一思路是"组内求均值,然后做比较”,是直觉上最朴素的分类策略。
第8段(P0225)
原文复述
the next and comparing them to the measurement from the unknown case. The
中文讲解
完成朴素方法的描述:“the next and comparing them to the measurement from the unknown case”——把每个组的各测量均值与未知案例的对应测量逐一比较。由此朴素分类逻辑被刻画为:“看未知案例更像哪一个组的均值”。句末"The"开启下文对该方法缺陷的指出。
第9段(P0226)
原文复述
weakness in this procedure becomes apparent when one has to summarize from
中文讲解
转折开始:“The weakness in this procedure becomes apparent when one has to summarize from…"——当需要从"一整套比较过的均值"中作出综合判断(summarize)时,这种朴素做法的弱点就变得明显了。这暗示:变量和组别一多,逐个比较均值会产生"如何整体综合"的困难。
第10段(P0227)
原文复述
the entire set of compared means. A useful illustration is offered by
中文讲解
完成转折:“summarize from the entire set of compared means”——对所有比较过的均值进行综合判断,作者在此点出朴素方法的根本局限。接着过渡到图形说明:“A useful illustration is offered by…"——下面给出一个有用的图示。
第11段(P0228)
原文复述
Lalitha Sanathanan in her description of discriminant analysis. (see
中文讲解
标明图示的来源:“Lalitha Sanathanan in her description of discriminant analysis”——Lalitha Sanathanan 在她对判别分析的描述中提供了这一图示。"(see"为图号和脚注留下位置。
第12段(P0229)
原文复述
Figure I-A).14
中文讲解
完成图示指引:“Figure I-A"指 Figure I-A 图;末尾的"14"是脚注编号,对应 Sanathanan 的出处。该图用于直观演示"增加变量可减少组间重叠"这一思想。
补充说明
原文标注的脚注 14 指向 Sanathanan 对判别分析的描述,是 Figure I-A 的出处,本节中仅作为引用出现。
第13段(P0230)
原文复述
The elipses surrounding A and B represent a cluster of observations
中文讲解
进入对图示本身的解读:“The elipses [ellipses] surrounding A and B represent a cluster of observations…"——围绕 A 和 B 的椭圆代表观测值的聚集(cluster)。原文写作 “elipses” 系 OCR 误差,原意为 ellipses(椭圆)。在图中,A 与 B 分别代表两个组,椭圆把它们各自的观测集合圈出。
第14段(P0231)
原文复述
taken from two measurements, or variables. Groups A and B are seen along
中文讲解
承接上句:“taken from two measurements, or variables”——这些观测来自两个测量,等同于两个变量。“or variables"是作者用同位语将 measurements 与 variables 互换使用,提醒读者二者在本节同义。继续:“Groups A and B are seen along…"——A 与 B 沿……可见。
第15段(P0232)
原文复述
the axes for measure 1 to overlap each other. The addition of the vertical
中文讲解
沿第一个测量轴方向看:“Groups A and B are seen along the axes for measure 1 to overlap each other”——A 与 B 在测量 1 这一条轴上彼此重叠。结论:单凭测量 1 一个变量,无法把 A 与 B 区分开。接着:“The addition of the vertical axis for measure 2…"——加入测量 2 这条垂直(vertical)轴。
第16段(P0233)
原文复述
axis for measure 2 creates the potential for separation of the clusters.
中文讲解
完成关键转折:“creates the potential for separation of the clusters”——增加测量 2 这条垂直轴,为分离两个聚类(clusters)创造了潜力。这是判别分析"多变量可提升分辨力"这一核心思想的直观体现:单变量不足以分开两组,但加上第二个变量,区分就成为可能。
第17段(P0234)
原文复述
While “x” falls within the overlapping area for measurement 1, it lies just
中文讲解
用一个具体的"未知案例 x"来说明:“While ‘x’ falls within the overlapping area for measurement 1”——仅在测量 1 上看,x 落在 A 与 B 重叠的区域内。这意味着若只用测量 1,无法判断 x 属于哪一组。
第18段(P0235)
原文复述
outside the overlap area from measurement 2, within A’s ellipse. The more
中文讲解
对照之下:“it lies just outside the overlap area from measurement 2, within A’s ellipse”——而在测量 2 上看,x 刚好落在重叠区之外、且位于 A 组的椭圆之内。两变量联合判断时,x 即可被归入 A 组。这正是判别分析第二个问题(对未知案例归类)的直观演示。
第19段(P0236)
原文复述
measurements one has available for study, the greater the chance that groups
中文讲解
把结论推广:“The more measurements one has available for study, the greater the chance that groups…"——可供研究的测量(变量)越多,组与组之间被无重叠地区分开的概率就越大。这是一条"变量数 → 区分能力"的递增关系。
第20段(P0237)
原文复述
can be distinguished without overlapping. Details of the discriminant
中文讲解
完成结论:“can be distinguished without overlapping”——各组可以在无重叠的情形下被区分开。这是判别分析能够达到的总体效果。随后:“Details of the discriminant…"——判别函数(discriminant function)的具体细节将随后给出,承启下一章。
第21段(P0238)
原文复述
function which accomplishes this will follow in Chapter Three.
中文讲解
章节过渡:“Details of the discriminant function which accomplishes this will follow in Chapter Three”——实现上述分离效果的判别函数的具体形式将在第三章给出。这句话既是对本节图示论证的小结,也把读者引向下一章关于判别函数形式化讨论的内容。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节包含一处脚注编号"14”,对应 Figure I-A 的引用,出自 Lalitha Sanathanan 对判别分析的描述。该图(Figure I-A)是本节论证的核心图示,被用于直观演示"增加测量变量可以减少组间重叠并实现分离"这一思想,是连接抽象定义与具体判别函数的桥梁。
💡 本节核心要点
- 判别分析被定位为一种多元程序,可同时回答两个相关问题。
- 第一个问题:在以"多个测量"形式存在的大量数据中,找出哪些测量能把大量案例分离成不同组。
- 第二个问题:在已分好的若干判别组中,能否把一个未知的单一案例归入其中某一组。
- 若没有判别分析,朴素做法是逐组求均值再与未知案例的测量值比较;这一做法在多变量情形下难以对全部均值作出综合判断。
- Figure I-A 直观演示:单变量下 A 与 B 重叠,但加入第二个变量后即出现分离的潜力。
- 变量越多,组被无重叠区分开的概率越大;实现这一效果的判别函数的具体形式将在第三章给出。
🔑 关键术语
- Discriminant analysis:判别分析。本节将其定义为一种多元统计程序,可同时回答两个相关问题:识别哪些变量能区分不同组,以及把新案例归入已分好的组。
- Multivariate procedure:多元程序。同时处理多个变量(而非单一变量)的统计方法类别,判别分析即属于此类。
- Measurements / variables:测量 / 变量。在本节中互换使用,指对案例进行观测得到的多个特征值,是判别分析的操作对象。
- Discriminated groups:已判别组。已经被某种方式区分开的若干组群,是判别分析第二个问题的输入前提。
- Cluster:聚类。观测值在测量空间中形成的聚集,本节图中以椭圆表示,对应一个判别组。
- Discriminant function:判别函数。用于实现组间分离的数学函数,本节预告其具体形式将在第三章给出。
s22 [描述性拆分] Figure I-A and the Need for High Variable Counts
第1段(P0239)
原文复述
FIGURE I-A: Effectiveness of Two Measurements Taken Simultaneously in Separating Two Groups (A and B). The choice of variables will determine the effectiveness of a discriminate approach to authorship verification. Because the number of counted observations as well as the number of variables should be high, the items examined need to occur throughout a sample piece. Rather than looking for discrete musical passages or counting the occasional occurrence of certain chord types, this study focuses on each piece’s total rhythmic and notational values. The fourteen variables that were tested are drawn from only two of Jan LaRue’s five musical elements (See “Discriminating Variables”, Chapter 3). ([Embedded image data omitted; position and caption preserved.])
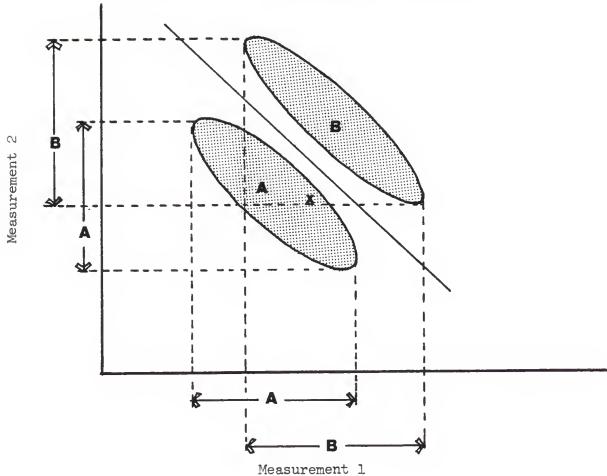
中文讲解
本段以图 I-A 的标题开头,说明该图展示了同时使用两个测量维度来区分 A、B 两组的有效性,作为论证变量的统计识别能力可被几何化、可视化的引子。
核心主张有两层:其一,变量选择直接决定"判别式方法”(discriminate approach)在作者身份验证中是否有效;其二,方法有效的前提同时落在两个数量条件上——被计数的观测值要多,变量本身也要多。这两个"高"是相互独立的:观测值多意味着样本规模足以支撑统计推断,变量多则意味着可以在多维空间中同时观察多个区分维度,从而在两个作者样本的分布之间形成清晰的分离边界(这正是图 I-A 想表达的几何直觉)。
由此引出一个方法学要求:被考察的变量必须在样本作品的整个篇幅中反复出现,而不是只集中在某几段。这是一种"分布密度"上的要求——如果一个特征只在作品中出现一两次,无论它多有区分力,也凑不出足够的观测值。
作者在此明确排除了两类常见策略——寻找离散的(断片化的)音乐段落、或统计某些和弦类型的偶尔出现——理由正是它们无法保证观测值密度。本研究转而聚焦于"每部作品的节奏值总集"与"记谱值总集”(total rhythmic and notational values),这类聚合性指标天然贯穿全曲,符合"遍布全文"的方法学要求。
最后一句交代了具体规模:共测试十四个变量,它们来自 Jan LaRue 五大音乐要素中的两类。“仅取两类"看起来与"变量要多"的诉求有张力,但作者实际想说的是:在选定的两类要素内部仍能切出十四个可量化变量,颗粒度足够,而非说变量类型覆盖很广。Jan LaRue 的框架作为理论参照被调用,详细论述被推迟到第 3 章"Discriminating Variables”,因此本段只点明出处而不展开。
本段在小节论证中承担方法学定位的功能:先用一个直观的几何图形(双测量分离两组)让读者建立信心,再交代本研究选择何种变量来满足该方法所要求的高观测密度与高变量数量。
补充说明
图 I-A 的实际散点/分类图形在当前输入中不可见,仅保留了标题与定位;其"两个测量同时区分两组"的几何含义,由本段正文的解释(即多变量才能形成可分离的判别空间)支撑,阅读时需对照原图。“Jan LaRue 的五大音乐要素"作为术语在本段仅被引用,详细定义见第 3 章同名章节;此处不引入该术语的外部解释。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段同时包含一个图表(Figure I-A)的标题和一个内嵌图像占位符。图像数据本身在输入中已被省略,仅保留图注文字与位置标记;该图在正文中被用作论证"多变量可提升判别效果"的直观几何示意,其具体坐标与分组细节需回到原始图像查证。文中"See ‘Discriminating Variables’, Chapter 3"是章内互引,指出 14 个变量与 LaRue 框架的具体来源在第 3 章展开。
💡 本节核心要点
- 作者身份验证的判别式方法,其有效性取决于变量选择。
- 该方法同时要求两个数量条件:被计数观测值要多,变量本身也要多。
- 因此被考察的变量必须贯穿样本作品,而非集中在个别段落或个别和弦。
- 本研究由此排除离散段落和偶尔性和弦,改为聚合每部作品的全部节奏值与记谱值。
- 共测试 14 个变量,全部取自 Jan LaRue 五大音乐要素中的两类,框架细节见第 3 章。
- 图 I-A 以几何方式直观展示两个测量维度同时使用时对 A、B 两组的分离能力。
🔑 关键术语
- discriminate approach:判别式方法,一种在已知分组前提下寻找能区分不同类别(此处为不同作者)的统计方法;其有效性依赖所选变量能否在高维空间中拉开组间距离。
- counted observations / number of variables:分别指每个变量下的样本计数(观测密度)与变量的总数;本段明确二者皆需足够大,缺一不可。
- total rhythmic and notational values:每部作品的节奏值总集与记谱值总集,指把全曲所有节奏时值与记谱符号聚合起来得到的整体特征,而非局部片段。
- Jan LaRue’s five musical elements:音乐学家 Jan LaRue 提出的五大音乐要素框架;本研究的 14 个变量仅取自其中两类,详细分类与依据见第 3 章。
s23 [描述性拆分] Sample Selection: Pavan Variations and Six Elizabethan Composers
第1段(P0240)
原文复述
In order to deal with as uniform a musical sample as possible the
中文讲解
本句是本小节主题句的前半部分。之所以把研究对象限定得很窄,是为了在最大程度上保证所考察的音乐样本在风格上具有一致性(as uniform a musical sample as possible)。换言之,作者认为若要把一件作品的归属问题说清楚,前提是先把所有待比较的作品放在同一种体裁、同一段历史里,让外部变量尽量被压制掉。该从句由 In order to 引导,表明这是一项方法论上的主动选择,而非由既有材料倒逼而成的安排。
补充说明
此句与下一段(P0241)乃至 P0242 的开头在语法上属于同一句话,只是因为分页或排版原因被切断;“the” 之后的内容在 P0241 续写。
第2段(P0241)
原文复述
choice of Elizabethan-period keyboard pieces was limited to keyboard varia-
中文讲解
承接 P0240,本句谓语动词被补出:作者所做的具体限定是——只选取伊丽莎白时期的键盘作品,而且仅限于以帕凡(Pavan)为定题的一类键盘变奏曲(keyboard variations)。这一选择是双重收紧:先限定时代,再限定体裁。行末 “varia-” 是一个换行连字符,与 P0242 开头的 “tions” 拼合成 “variations”。
补充说明
“keyboard varia-” 与下段 “tions” 拼合,是排版造成的换行断词;“Elizabethan-period” 在此仅作为时代定语,不展开年限。
第3段(P0242)
原文复述
tions based on the Pavan. The style of this dance is strongly controlled
中文讲解
本段同时完成两件事:补全 “variations” 一词并结束限定从句(以帕凡为基础的变奏曲);随即开启一个新句,开始描述帕凡这种舞蹈本身的体裁特征——它的风格被某种结构性的东西"强烈制约"着(strongly controlled),而制约的具体内容则要在下一段才正式给出。
补充说明
“Pavan”(帕凡)作为变奏的固定主题,是整份研究的基线材料。
第4段(P0243)
原文复述
by its 8-bar phrasing and stately 4/2 meter, so that the task of tracing
中文讲解
本段补出"制约"的两项具体特征:八小节的乐句结构(8-bar phrasing)和庄重的 4/2 拍子(stately 4/2 meter)。随后用 “so that” 引出因果推论——这种体裁上的强约束会令追溯作品归属(tracing authorship)的任务变得格外困难。注意本句的结论性部分尚未写完,要到 P0244 才能结束。
补充说明
4/2 拍即每小节四拍、以二分音符为单位拍,节奏庄重缓慢,是帕凡的典型节拍。8 小节乐句则是该体裁在结构上的标准单元。
第5段(P0244)
原文复述
one composition’s authorship is even more challenging. For each composer,
中文讲解
承接 P0243 的 “so that”,本段补完因果句:因为帕凡风格被体裁规则高度统一,所以单凭听感或表面风格去辨认某首作品的作者,反而比在风格差异更大的曲目中更难(even more challenging)。紧接着以 “For each composer,” 开启新句,预示后文要谈针对每位作曲家所采用的处理流程。
补充说明
作者的论证逻辑是:体裁越规整,不同作曲家之间的风格差异就被规则压得越平,归因难题因此被放大。
第6段(P0245)
原文复述
all known pavans were studied from the modern editions listed in Appendix I.
中文讲解
本句说明了数据来源:对于每一位入选的作曲家,研究者穷尽地查阅了他们全部已知的帕凡曲,而这些曲谱来自附录 I 所列的现代编辑版(modern editions)。“all known pavans” 这一措辞提示,研究覆盖的是全集层面,而非抽样;以保证后续统计的稳健性。
补充说明
附录 I 在本节内仅以引用方式出现,未展开其具体内容。
第7段(P0246)
原文复述
A list was made of dubious or disputed pavans noted in editors’ prefaces
中文讲解
本句承前说明研究者接下来做了什么:在已知帕凡曲中,他们根据现代编辑者所写的前言(editors’ prefaces),把所有归属可疑或存在争议(dubious or disputed)的帕凡单独整理成一张清单。本句未结束,要到 P0247 才补出 “or appendices to those editions”。
补充说明
“editors’ prefaces” 指现代评注版中编辑者撰写的序言,编辑者通常会在其中标注归属问题。
第8段(P0247)
原文复述
or appendices to those editions. These formed the group of pieces to be
中文讲解
承接 P0246,补充另一处编辑者注明归属疑问的来源——附录(appendices)。随后以指示代词 “These” 主语开启下一句,预告这份清单的功能:它将构成待分类的曲目群。句子在 “to be” 处停下,谓语部分留待 P0248 完成。
补充说明
“appendices to those editions” 与 “editors’ prefaces” 并列,二者都是现代编辑版中常见的归属说明位置。
第9段(P0248)
原文复述
classified once the discriminations between composers had been established.
中文讲解
本段完成从 P0247 开始的句子:这些归属可疑的帕凡将构成待分类的对象集(the group of pieces to be classified),但前提是作曲家之间的风格判别标准已经建立(once the discriminations between composers had been established)。这一句是整个抽样逻辑的关键——它揭示了研究的两阶段流程:先用归属明确的曲子建立判别基准,再用它去检验归属可疑的曲子。
补充说明
“discriminations between composers” 指在第一阶段基于归属清晰作品所提炼出的风格区分特征,是后续分类所依赖的判别模型。
第10段(P0249)
原文复述
All of the composers chosen were prominent keyboard musicians during
中文讲解
本句开启对作曲家选择标准的说明。第一项标准是:所有被选中的作曲家都是某段历史时期的著名(prominent)键盘乐家。这句话并未结束,时代定语要由下一段补出。
补充说明
“prominent keyboard musicians” 是本句给出的入选门槛之一。
第11段(P0250)
原文复述
the reign of Elizabeth I (1568-1603), though their collected works cover
中文讲解
本段补出时代定语——伊丽莎白一世在位期间,并标出具体年份 1568-1603。接着以 “though” 引出让步转折:尽管他们是同时代的人物,但其传世作品集所覆盖的时间跨度更大,超过了伊丽莎白一世这一朝代本身。这一让步从句要留到 P0251 才结束。
补充说明
文中给出的 1568-1603 是原文所示年代,应按原样保留而不予改写;伊丽莎白一世实际在位年份与此处数字的关系,原文并未进一步说明。
第12段(P0251)
原文复述
a period of three generations. William Byrd, Giles Farnaby, John Bull,
中文讲解
本段同时完成两件事:补完 P0250 的让步从句——他们的作品集跨越了三代人(a period of three generations),随后开始罗列入选的六位作曲家,前三位是 William Byrd、Giles Farnaby、John Bull,名单将继续。“three generations” 暗示六人的活跃期彼此重叠而又有前后之分,使作品在风格上呈现自然的演变。
补充说明
六位作曲家的完整名单在 P0252 给出。
第13段(P0252)
原文复述
Thomas Morley, Orlando Gibbons, and Peter Philips were selected on the basis
中文讲解
本段补完作曲家名单的后三位——Thomas Morley、Orlando Gibbons、Peter Philips——并以 “were selected on the basis” 引出选择依据。谓语部分将在 P0253、P0254 中由三个并列标准补足。
补充说明
至此六位作曲家全部到齐:Byrd、Farnaby、Bull、Morley、Gibbons、Philips。
第14段(P0253)
原文复述
of their contemporary reputation, the number of works available for study,
中文讲解
本段开始逐项列出选择依据。第一项:当时的名声(contemporary reputation);第二项:可供研究的作品数量(the number of works available for study)。第三项由 P0254 给出。
补充说明
“contemporary reputation” 强调这是当时同行所认可的名声,而非后世评价。
第15段(P0254)
原文复述
and the existence of disputed pieces attributed to them by modern editors.
中文讲解
本段补出第三项,也是方法论上最关键的一项:现代编辑者所归属给他们的作品中存在归属争议(disputed pieces)。如果某位作曲家名下不存在归属可疑的作品,那么前文那张待分类清单就是空的,整套分析无从谈起。这条标准与 P0246-P0248 的筛选直接呼应,把作曲家选择与样本选择连成一体。
补充说明
第三项标准把作曲家筛选与归属可疑作品筛选这两条线索扣合在一起。
第16段(P0255)
原文复述
A more detailed discussion of these composers, of Elizabethan keyboard
中文讲解
本句开始指向后文,预示对这些作曲家的更详细讨论将在别处展开,从而为读者标示出本节的"摘要性质”。句子由 P0256 收尾。
补充说明
“A more detailed discussion” 表明本节不展开作曲家小传与风格背景,仅作概要交代。
第17段(P0256)
原文复述
style in general, and the hypotheses of this study follow in Chapter Two.
中文讲解
承接 P0255,本段给出指向:第二章(Chapter Two)将系统讨论这六位作曲家、伊丽莎白键盘音乐的整体风格,以及本研究的具体假设(hypotheses)。由此把本节定位为"研究设计与样本交代”,把理论铺垫与人物背景一并后置。
补充说明
“hypotheses of this study” 指本研究将要检验的研究假设,其正式陈述被推迟到第二章。
第18段(P0257)
原文复述
Succeeding chapters will cover the methodology employed, describe the
中文讲解
本句开启对后续章节内容的总览,“Succeeding chapters” 指第二章之后的章节。第一项内容是所采用的方法(the methodology employed)。谓语部分在 P0258 中由另外两项内容补足。
补充说明
本节所在的位置早于第二章,故此处"后续章节"是相对于第二章而言的下文。
第19段(P0258)
原文复述
results of the statistical analysis, and summarize and explore conclusions.
中文讲解
承接 P0257,本段补出后两项:呈现统计分析的结果(results of the statistical analysis),并对结论进行总结与延展讨论(summarize and explore conclusions)。三句话合在一起勾勒出典型的实证研究骨架——方法、结果、结论——也提示读者接下来章节的功能分工。
补充说明
“methodology → results → conclusions” 是经验性研究的标准叙事顺序。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为单页(第 15 页)文字,未出现脚注、图表、谱例或边栏。文中出现一处外部引用——附录 I(Appendix I),其中列出研究所采用的现代编辑版清单,但该附录的具体内容不在本节范围内。此外,行末连字符造成的跨段断词(如 P0241 的 “varia-” 与 P0242 的 “tions”)属于排版现象,不构成独立信息。
💡 本节核心要点
- 样本通过双重收紧以保证风格统一:先限定伊丽莎白时期,再限定为以帕凡为基础的键盘变奏曲。
- 帕凡体裁本身高度规整——八小节乐句与 4/2 拍——这种规整反而抬高了归属判断的难度。
- 研究采用两阶段流程:先以归属清晰的全部已知帕凡建立作曲家间的风格判别基准,再以此基准去分类现代编辑者标注的归属可疑帕凡。
- 六位入选作曲家——Byrd、Farnaby、Bull、Morley、Gibbons、Philips——活跃于伊丽莎白一世在位时期,但传世作品集跨越约三代人的时间。
- 选择作曲家的三条标准是同时代名声、可用作品数量,以及其名下存在现代编辑者标注的归属争议作品。
- 第二章承担背景与假设的展开,后续章节分别覆盖方法、统计结果与结论,呈现典型的实证研究结构。
🔑 关键术语
- Pavan:帕凡,一种缓慢庄重的文艺复兴宫廷舞蹈,体裁上以 8 小节乐句和 4/2 拍为典型特征;在本研究中是全部变奏的固定主题基础。
- 4/2 meter:4/2 拍,每小节四拍、以二分音符为单位拍;赋予帕凡庄重、缓慢的节奏感。
- 8-bar phrasing:以 8 小节为一个乐句单元的结构组织方式;是帕凡体裁的标准化段落格式。
- keyboard variations:键盘变奏曲,指以一首固定旋律(本研究中的帕凡)为定题,反复以不同织体、装饰或对位加以变化的成套作品。
- modern editions:现代编辑出版的乐谱版本,通常包含学术性前言、注释与归属说明;本研究的全部已知帕凡均取自此类版本。
- Appendix I:论文附录 I,列出本研究使用的现代编辑版清单;本节仅引用其名,未展开具体内容。
- disputed pavans:归属可疑的帕凡曲,指在现代编辑者前言或附录中被标注为归属存疑或归属有争议的作品;构成本研究的待分类对象集。
- discriminations between composers:作曲家间的风格判别,指在归属明确的作品基础上所提炼出的、能够区分不同作曲家风格特征的统计指标或模型;这是分类归属可疑作品的前提。
- contemporary reputation:同时代名声,指这些作曲家在伊丽莎白时代被同行所认可的地位;本研究中作为作曲家人选标准之一。
s24 [描述性拆分] Overview of a Common Variation School
第1段(P0259)
原文复述
CHAPTER II: HISTORICAL REVIEW
中文讲解
本段是第二章的章节标题,原文为“## CHAPTER II: HISTORICAL REVIEW”,意思是“第二章:历史回顾”。它标示出本书正式进入历史层面的论述阶段。承接第一章对六位作曲家及其帕凡变奏作品的提出,第二章把视角转向历史研究与风格分析,目的是用历史证据来支撑前文已经浮现的“共同变奏实践”这一假说,而不是继续停留在作品本身的形态描述上。
第2段(P0260)
原文复述
Historical research and style analysis convey the close proximity of these six composers to each other. Their variations, on pavans in particular, collectively illustrate a “school” of composition; it undoubtedly had its leaders and its followers, but many stylistic elements, techniques, and even some thematic material were common to each. This chapter will examine the evidence of a common variation practice that existed during this brief period, and the resulting ambiguity in attributions to its composers.
中文讲解
本段是第二章的导言性段落,集中提出了全章的核心论点。
首先,作者通过“historical research and style analysis”两类研究路径得出一个总体判断:六位作曲家彼此之间在历史上距离很近(close proximity)。这意味着无论从外部史实还是从内部风格特征来看,他们都处于同一个可识别的群体之中,而不是各自孤立的个体作者。
其次,作者把他们在帕凡舞曲(pavans)上的变奏作品作为最有力的例证,指出这些作品共同呈现出一个加引号的“school”,即一种作曲流派或传统。值得注意的是,作者用引号标注了“school”,暗示这一概念是他为了概括现象而提炼出来的术语,而非现成的历史标签。在承认这个流派内部并非铁板一块的前提下,作者进一步指出它“undoubtedly had its leaders and its followers”——既有领袖也有追随者,存在影响力上的层级差异。然而,正是因为在“stylistic elements, techniques, and even some thematic material”这三大层面(风格要素、写作技法、甚至部分主题材料)上六位作曲家彼此共通,作者才得以把他们归入同一个“school”。
最后一句给出了本章的研究承诺:要审视两类材料:一是这段短暂时期(brief period)内确实存在过的“common variation practice”的证据,二是这种共同实践所导致的归属性模糊(ambiguity in attributions to its composers)。也就是说,作者既要把“共同变奏实践”作为一种历史事实加以论证,也要正面回应因风格共性太强而带来的归属争议。
就论证作用而言,本段承担着双重功能:一方面为本章确立了论证目标——证明共同实践的存在并解释归属模糊;另一方面也预告了本章的方法将综合历史研究与风格分析两条线索,与第一章侧重谱面形态的讨论形成互补。
补充说明
原文中“brief period”提示作者认定这种共同实践在时间上范围有限,是短暂的群体性现象,而非长时段传统;“ambiguity in attributions”则预告本章末尾或后续章节将出现归属争议问题,二者均为后续论点的伏笔。无其他额外补充。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节本身仅由第二章标题与章首导言段组成,没有脚注、图表、边栏或谱例。章首导言段同时承担全章摘要与论证预告的功能,提示读者本章将以历史研究与风格分析双线展开,回应归属模糊问题。
💡 本节核心要点
- 历史研究与风格分析共同表明,六位作曲家彼此之间关系极为接近,具备构成同一群体的条件。
- 他们在帕凡舞曲上的变奏作品被用作最集中、最有说服力的证据,集体勾勒出一个加引号的“school”。
- 这一流派内部既有领袖也有追随者,但在风格要素、写作技法乃至部分主题材料上高度共通。
- 作者承认这种共通性既是定义流派的基础,也是引发归属模糊的根源。
- 本章将论证“共同变奏实践”这一历史事实的存在,并正面处理由此产生的归属争议。
- 本章的研究路径(历史+风格分析)与第一章侧重谱面形态的路径形成互补,共同支撑六位作曲家构成一个短暂但可辨识的变奏流派的判断。
🔑 关键术语
- school:作者加引号使用的概念,指六位作曲家因帕凡变奏等作品在风格、技法、主题上高度共通而形成的作曲流派,强调它是作者为了概括现象而提出的术语,而非现成的历史称谓。
- pavans:帕凡舞曲,一种源自文艺复兴时期的庄重二拍子舞曲体裁;本节指出六位作曲家在该体裁上的变奏是构成“school”最关键的作品群。
- common variation practice:共同变奏实践,指六位作曲家在一段有限时间内共享的变奏写作惯例,是本章需要用历史与风格证据加以论证的核心概念。
- ambiguity in attributions:归属模糊,指由于共同实践使作品在风格上彼此相似,导致难以确定具体作品的作者;是本章需要回应的方法论难题。
s25 [描述性拆分] Composers Treated in this Analysis
第1段(P0261)
原文复述
Composers Treated in this Analysis
中文讲解
这是本页的小节标题,宣告接下来的内容是“本分析所涉及的作曲家”。它本身不是论证性段落,而是一个导引,提示读者接下来会看到一组被纳入研究范围的人物及其年代信息。
第2段(P0262)
原文复述
Similarities of style among the six composers under study may be due to their physical proximity to one another during the reigns of Elizabeth I and James I (1568-1603 and 1603-1625).
中文讲解
本段提出本节的核心前提:本书研究的六位作曲家在风格上的相似性,可能源于他们在伊丽莎白一世(在位1568-1603)与詹姆斯一世(在位1603-1625)时期彼此地理上的接近。注意两点:第一,作者使用的是“may be due to”,即这是一种可能性解释而非定论;第二,作者把“地理接近”视为风格趋同的潜在原因,暗示同一时期的英国音乐文化环境塑造了这些作曲家的共同语言。这为接下来以时间轴呈现六人的生卒年与两位君主在位期奠定了逻辑基础——读者可以通过时间轴直观地判断这些作曲家在地理和时间上的重叠程度。
补充说明
原文标注伊丽莎白一世的在位年为1568-1603,这并非其加冕年份(1558/1559),而可能是作者所引用的特定起算点;詹姆斯一世的在位期1603-1625则是其实际统治年代。读者在阅读时应将其视为作者为配合时间轴所选用的时间区间。
第3段(P0263)
原文复述
1540 50 60 70 80 90 1600 10 20 30 40
中文讲解
这是一条时间轴的刻度标记,从1540年起,每隔十年标注一次,依次为1540、1550、1560、1570、1580、1590、1600、1610、1620、1630、1640。它本身没有论述内容,但为下一页的时间轴图提供了年份参照,使读者能够将每位作曲家的生卒年份与两位君主的在位期进行对照。
补充说明
这是一条图表刻度轴文字,需结合原图查看其视觉布局。
第4段(P0264)
原文复述
William Byrd (1543-1623)
中文讲解
时间轴上的标签之一,标明威廉·伯德(William Byrd)的生卒年为1543至1623年。他是六位作曲家中最早出生者,跨越了伊丽莎白一世和詹姆斯一世两朝,是本节所说的“同时代共同地理环境”中的核心人物之一。
补充说明
仅依据本节信息可知其生卒年,其音乐贡献需要查看正文相关章节。
第5段(P0265)
原文复述
Thomas Morley (1557-1602)
中文讲解
时间轴标签,标明托马斯·莫利(Thomas Morley)的生卒年为1557至1602年。他是六人中去世最早的一位,未能进入詹姆斯一世时期;其活跃期主要落在伊丽莎白一世朝代中后期。
补充说明
仅依据本节信息可知其生卒年。
第6段(P0266)
原文复述
Giles Farnaby (1560-1640)
中文讲解
时间轴标签,标明杰尔斯·法纳比(Giles Farnaby)的生卒年为1560至1640年。他的寿命几乎跨越了从伊丽莎白一世中后期一直到查理一世初期,是六人中在世时间最长、跨越王朝最多者之一。
补充说明
仅依据本节信息可知其生卒年。
第7段(P0267)
原文复述
Peter Philips (1560-1628)
中文讲解
时间轴标签,标明彼得·菲利普斯(Peter Philips)的生卒年为1560至1628年。与法纳比同年出生,但去世更早。
补充说明
仅依据本节信息可知其生卒年。
第8段(P0268)
原文复述
John Bull (1562-1628)
中文讲解
时间轴标签,标明约翰·布尔(John Bull)的生卒年为1562至1628年。他在世时期同样跨越了伊丽莎白一世后期与詹姆斯一世全期。
补充说明
仅依据本节信息可知其生卒年。
第9段(P0269)
原文复述
Orlando Gibbons (1583-1625)
中文讲解
时间轴标签,标明奥兰多·吉本斯(Orlando Gibbons)的生卒年为1583至1625年。他是六人中最晚出生者,去世时正值詹姆斯一世统治末期,与两位君主的在位期几乎完全吻合。
补充说明
仅依据本节信息可知其生卒年。
第10段(P0270)
原文复述
Elizabeth I /James I
中文讲解
时间轴上的另一类标签,对应伊丽莎白一世与詹姆斯一世两位君主的在位期间(分别为1568-1603与1603-1625)。这一标签与上文作曲家姓名标签并列出现,使读者能在视觉上将每位作曲家的在世时段与两位君主的统治期重叠比对,从而直观验证P0262所提出的“地理与时代接近导致风格相似”的论断。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节主要由一个时间轴图表构成,附加材料仅有时间刻度(P0263)以及标注文字——六位作曲家的姓名与生卒年(P0264-P0269)和两位君主标签(P0270)。这些图表元素服务于P0262的论点:将人物年代与王统治期进行视觉对照。
💡 本节核心要点
- 本节标题明确指出接下来呈现“本分析所涉及的作曲家”。
- 作者提出核心假设:六位作曲家风格相似,可能源于他们在伊丽莎白一世与詹姆斯一世时期的地理接近。
- 本节实际内容是一张以十年为刻度的时间轴,呈现六位作曲家的生卒年与两位君主的在位期。
- 六位作曲家按出生顺序为:William Byrd (1543)、Thomas Morley (1557)、Giles Farnaby (1560)、Peter Philips (1560)、John Bull (1562)、Orlando Gibbons (1583)。
- 时间轴设计的目的是让读者直观地看到这些人物的在世时段与伊丽莎白一世(在位1568-1603)和詹姆斯一世(在位1603-1625)在位期的重叠程度,从而支持风格趋同的解释。
🔑 关键术语
- Elizabeth I / James I:英国两位君主,分别于1568-1603与1603-162年在位。本节中作为时间轴的参照标尺,用以判断作曲家的活跃期与王统治期的重叠关系。
- physical proximity:指作曲家们在地理上的接近,是作者解释其风格相似性的潜在原因,强调共同的音乐文化环境。
- similarities of style:作者认为六位作曲家之间存在的风格相似性,并将其归因于他们所共处的时代与地理环境。
s26 [描述性拆分] Three Points of Convergence Among the Six Composers
第1段(P0271)
原文复述
To examine the probability that they were familiar with each other’s music, one must look at three possible points of convergence in their lives: their connections with the musical establishment of the Chapel Royal; their formal educations; and their political/religious affiliations.
中文讲解
本段是一句过渡性、纲领性的方法论宣告,并不展开任何具体史料,而是为后文设定考察框架。作者要回答的核心问题是:这六位作曲家彼此是否有可能熟悉对方的音乐?注意作者用词为 probability(可能性、概率),而非 certainty 或 fact——这表明后文的论证属于基于外部传记证据的间接推断,而非依靠直接文献(如通信、抄本归属记录)来证明互知。
作者提出三个 convergence(汇合点、交汇处),即判断他们生活轨迹是否可能相交的三条线索:其一,与皇家礼拜堂(Chapel Royal)这一音乐建制的关系;其二,所接受的正规教育;其三,政治与宗教上的立场归属。这三条线索的选择逻辑值得注意:它们都不是“音乐风格相似性”这种内在美学维度,而是外部的、机构性的、社会身份性的维度。换言之,作者的策略是——若这些作曲家在制度、教育、政治宗教网络中处于同一圈子,则他们听到、抄写、演出彼此作品的机会就会显著增加,从而支持“互知”的推断。
因此,本段在整节中的功能是充当路线图:它告诉读者接下来会逐一审视这三个方面,并以此为标尺去衡量“彼此熟悉其音乐”这一假设的概率。这一句虽短,却确立了后文所有讨论的提问方式——不是“他们是否真的互相认识”,而是“他们有没有合理的渠道互相了解”。
补充说明
本段在结构上属于段落首句(topic sentence),承担的是“提出分析框架”的功能,而非“提供证据”。因此本栏无需补充额外史实;后文若逐一展开 Chapel Royal、正规教育与政治宗教倾向三块材料,本节即可据实论证。
脚注 / 边栏 / 图表 / 附加信息(如有)
无额外附加材料(无脚注、图表或边栏)。
💡 本节核心要点
- 本段是方法论过渡句,宣告了考察“六位作曲家是否彼此熟悉其音乐”这一问题的三条外部线索。
- 作者使用 probability 一词,明确后文属于基于传记与机构背景的间接推断,而非直接文献证据。
- 三条汇合点分别是:与皇家礼拜堂的机构关联、所接受的正规教育、以及政治/宗教立场——皆为社会性与制度性维度,而非音乐风格维度。
- 段落的论证策略是:以生活轨迹是否交叉来推断作品互知的可能性,把“互识”问题转化为“是否有共同的制度与社交网络”问题。
🔑 关键术语
- Chapel Royal:英国君主专属的皇家礼拜堂及其音乐机构,是都铎与斯图亚特时期英国最重要的宫廷音乐建制之一;本章用它作为判断作曲家是否进入同一宫廷音乐圈的第一条线索。
- points of convergence:作者自创的分析术语,指六位作曲家生活轨迹中可能相交、会合的具体领域;本节将其限定为机构、教育与政治宗教三类外部维度,用以评估互知的概率。
- political/religious affiliations:指作曲家在宗教改革、王朝更替等政治—宗教格局中所归属的阵营(如天主教/新教、保皇/议会派),本节将其视作另一种社会网络,影响作品流传与唱诗班归属。
s27 [描述性拆分] The Chapel Royal as a Convergence Point
第1段(P0272)
原文复述
The Chapel Royal, that is, the ecclesiastical establishment of the Queen (or King), offered the most prestigious positions available to musicians in English society. Young boys who were recruited there as singers received a formal training in musicianship, which included plainsong, fabourdon, discant, counter-tenor, and sometimes keyboard instruction (as indicated by footnote 15), while they simultaneously served as the choir for the services. Once the boys’ voices broke, royal support continued with further training, including a university education. A successful scholar might then pursue a career in the church or remain at the Chapel as a singer, keyboardist, copyist, or Master of the Children.
中文讲解
本段交代了小节的核心命题:王室礼拜堂(Chapel Royal,即女王或国王的教会机构)是英国社会中音乐家所能获得的最高声望的职位。作者并不是在泛泛赞美这一机构的地位,而是在描述它所提供的一条完整的职业—教育通道:童声歌手被招募进来后,接受包括plainchant(素歌)、fabourden(花彩对位式四度叠唱)、discant(狄斯坎特,即早期的复调对位写作)、counter-tenor(假声男高音或高男高音唱法)以及偶尔键盘演奏在内的系统音乐训练(脚注15补充了史料来源),与此同时他们也兼任礼拜仪式唱诗班的实际歌手。这种“在训练中服务、在服务中训练”的双重身份,是英国王室礼拜堂传统中音乐教育的核心特征。当男孩变声之后,王室的支持并未终止,而是延伸到大学教育层级,意味着王室实际上承担了从童声阶段到成年专业阶段的一条龙培养。完成这一链条的“成功学者”有两条出路:一是进入教会从事神职与音乐并重的职业,二是留在礼拜堂内担任歌手、键盘演奏者、抄写员或“童声合唱团领唱”(Master of the Children)。作者通过这一段实际上是在为后面讨论Gentlemen的来源做准备——童声阶段的受训者,正是Gentlemen这一群体的前身或平行来源之一。理解本段的关键在于:Chapel Royal不是单纯一个演出机构,而是一个集招募、训练、任用、社会身份授予于一体的制度化平台,这正是“convergence point(汇聚点)”这一小节标题的依据。
补充说明
本段中脚注15标记在训练科目列表之后,应在additional_information中提示其作为这些训练科目的史料依据。plainchant、fabourdon、discant、counter-tenor四个术语同时出现,说明王室童声训练覆盖了从单声部圣咏到早期复调写作再到人声音域拓展的完整谱系,这本身即为Chapel Royal地位之“prestigious”的具体内涵。
第2段(P0273)
原文复述
The “Gentlemen” who were sworn to service in the Chapel Royal were either individuals who continued in the functions listed above or persons of exceptional ability—particularly in composing and performance—who were granted an honorary title (as indicated by footnote 16). The honorary status of Gentleman usually remained attached to the musician for the rest of his life, even if he were subsequently employed elsewhere. It is, however, difficult to determine how long and how frequently individual musicians were actually active in the Chapel Royal after their recorded swearing-in.
中文讲解
本段在P0272描述童声培训通道之后,进一步说明了“绅士”(Gentlemen)这一更高一级身份的性质。作者用“either…or…”句式明确把Gentlemen划分为两类来源:一类是“continued in the above-listed functions”,即从童声阶段晋升、继续承担歌手、键盘手、抄写员或童声团领唱等职务的成年音乐家;另一类是凭借在作曲与演奏上的卓越才能而被授予这一荣誉头衔的人(脚注16为此提供史料依据)。这一区分揭示了Gentlemen身份的双重性质:它既可以是一种实际的在职职位,也可以是一种脱离日常服务、仅作荣誉保留的称号。更关键的是,作者指出荣誉性的Gentleman身份通常终身保留,即便当事人后来受雇于其他机构,这说明该头衔具有独立于具体任职状态的、永久的社会声望价值。最后一句则转向研究层面的限制:即使某人已被记录为宣誓就职于Chapel Royal,他此后在该机构中的实际活跃时间和频次往往难以确认,这是后续研究者在利用这一史料群体时必须面对的史料局限。从论证功能上看,本段与P0272共同把Chapel Royal定位为多重身份的汇聚地:童声歌手受训于此,成年音乐家服务于此,外部卓越人才被吸纳于此,并由此获得终身性社会身份的认证,因此小节标题“a convergence point”得到落实。
补充说明
脚注16标注于“honorary title”之后,应在additional_information中说明其为荣誉性头衔授予的史料来源。P0272与P0273之间的逻辑关系是“培训—任用—荣誉化”的递进,二者共同支撑小节标题中“convergence point”的判断。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节包含两处脚注标记:脚注15附于P0272的训练科目列表(plainsong, fabourdon, discant, counter-tenor, keyboard instruction)之后,作用是为这些训练内容提供史料依据,属于支持性来源标注;脚注16附于P0273的“honorary title”处,作用是为Gentlemen身份的荣誉性授予提供史料依据,同样属于来源标注。本节没有图像、表格或边栏材料。
💡 本节核心要点
- 王室礼拜堂(Chapel Royal)是英国社会中音乐家所能获得的最高声望职位,其地位来源于一套完整的招募—训练—任用机制,而非单纯的演出机构身份。
- 童声歌手在服役于礼拜仪式唱诗班的同时接受涵盖plainchant、fabourdon、discant、counter-tenor及偶尔键盘演奏在内的系统音乐训练,变声后王室支持继续延伸至大学教育层级。
- 完成训练的学者可进入教会或留任为歌手、键盘手、抄写员或童声团领唱(Master of the Children),从而形成从童声到成年的连续职业通道。
- “绅士”(Gentlemen)身份同时承担实际职位与荣誉头衔两种功能:既可由内部晋升者获得,也可授予具备卓越作曲或演奏才能的外部音乐家。
- 荣誉性的Gentleman身份通常终身保留,即便当事人此后受雇于其他机构,这使该头衔成为一项独立于具体任职的永久性社会声望标识。
- 史料上的局限性必须被承认:已记录的宣誓就职并不等于实际活跃,研究者难以仅凭宣誓记录判断个体在Chapel Royal中的活动时长与频次。
🔑 关键术语
- Chapel Royal:王室礼拜堂,即女王或国王的教会机构;在本节中不仅是礼拜与音乐演出场所,更是英国社会中音乐家所能获得的最具声望的职位来源,集招募、训练、任用与荣誉授予于一体。
- plainsong:素歌,单声部无伴奏的教会圣咏,是Chapel Royal童声训练的基础科目,确立了音准、调式与教会礼仪音乐的基本语汇。
- fabourdon:花彩对位式的四度叠唱,常见于十五、十六世纪英国与欧洲大陆圣咏的传统;列于训练科目中说明Chapel Royal的童声培训已涉及多声部对位实践。
- discant:狄斯坎特,指依据素歌定旋律在其上方添加对位声部的早期复调写作技术;作为训练科目表明童声阶段已开始接触真正的复调作曲训练。
- counter-tenor:假声男高音或高男高音唱法,以成男声区假声演唱高音声部;在Chapel Royal中作为童声之外的成人高音补充,使高声部旋律在童声断档后仍可维持。
- Master of the Children:童声合唱团领唱,负责童声歌手的训练、纪律与音乐事务;是Chapel Royal内部可由成功受训者晋升的固定职位之一。
- Gentlemen:宣誓服务于Chapel Royal的“绅士”群体,来源有二:一是继续承担前列职务的内部晋升者;二是凭卓越作曲或演奏才能被授予此头衔者;该身份既可为在职职位,也可为终身保留的荣誉称号。
s28 [描述性拆分] Table II-B: Chapel Royal Children and Gentlemen
第1段(P0274)
原文复述
TABLE II-B: Composers as Chapel Royal Children and Gentlemen
中文讲解
这是一个表格标题:表II-B,主题为「作为皇家礼拜堂儿童与Gentleman的作曲家们」。它告诉读者本表将以年表方式,列出特定几位作曲家在英国皇家礼拜堂(Chapel Royal)中所担任过的具体职务及其任职时间。表II-B与前文的表II-A属于并列关系,本表聚焦的是作曲家们的「任职身份」轨迹,而非作品或曲目内容。皇家礼拜堂是英国君主宫廷中负责宗教礼拜音乐的机构,作曲家常以「Child(唱诗班儿童)」身份进入机构,后逐步晋升至Organist(管风琴师)、Virginalist(维金纳琴师)或Gentleman(宣誓就任的资深成员)等更高级的职位。
第2段(P0275)
原文复述
1570 - Byrd sworn as Gentleman
1574 - Bull recorded as Child
1583 - Bull recorded as Master of the Children
1586 - Bull sworn as Gentleman
1592 - Morley sworn as Gentleman
1597 - Bull recorded as Organist
1603 - Gibbons recorded as Choirster
1615 - Gibbons recorded as Organist
1619 - Gibbons recorded as Virginalist
1627 - Gibbons sworn as Gentleman
中文讲解
本段以年表形式按时间顺序列出四位作曲家(Byrd、Bull、Morley、Gibbons)在皇家礼拜堂的职务记录,时间跨度从1570年到1627年,共计十项条目。可将其分组阅读以理解作者编排意图:
一、Byrd(伯德):仅出现一次,即1570年「sworn as Gentleman」。这并不意味他此前没有任职,而是表示本表只在此记录了他可考据为Gentleman的时点;作为当时英国最重要的天主教作曲家之一,他在更早期可能已在宫廷中担任较低职务,但本表未列。
二、Bull(布尔):条目最多,达四项,覆盖完整晋升链。1574年为「Child」(唱诗班儿童),这是儿童阶段;1583年成为「Master of the Children」(儿童训练主管),负责管理并训练唱诗班男童;1586年「sworn as Gentleman」,进入宣誓就任的资深成员行列;1597年再被记录为「Organist」(管风琴师)。Bull的四次记录呈现一条清晰的从童年唱诗班→管理人员→资深成员→键盘演奏家的多重身份发展轨迹。
三、Morley(莫利):仅出现一次,1592年「sworn as Gentleman」。与Byrd类似,本表只取其作为Gentleman的可考时点。
四、Gibbons(吉本斯):条目四次,跨越1603至1627年。1603年「Choirster」(唱诗歌手),与「Child」含义相近但用词不同;1615年「Organist」;1619年「Virginalist」(维金纳琴师);1627年「sworn as Gentleman」。Gibbons的晋升耗时最长(约24年),并最终集礼拜堂内部三大器乐演奏头衔于一身,再晋升为Gentleman,是表中展现完整、长期职业生涯的典范。
本表的整体论证作用在于:通过把四位作曲家的任职节点统一并置,证明他们都曾直接隶属于皇家礼拜堂这一英国最高的宫廷宗教音乐机构,并以可考据的誓言或记录为据。读者由此可推断:本论文所讨论的作曲实践并非来自外圈作曲家,而是来自机构内部成员的「亲历者经验」。同时,「sworn」「recorded」等动词的精确使用,暗示作者在区分第一手入职誓词记录与后来被归档追记的二手记录,这是史料学层面的细节。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节仅为一张纯年表(Table II-B)的内容,原文中无脚注、图例说明或边栏文字,所有信息均集中在按年份排序的任职记录列表中。
💡 本节核心要点
- 本表以年表形式列出Byrd、Bull、Morley、Gibbons四位作曲家在英国皇家礼拜堂的任职记录,时间跨度为1570至1627年。
- 皇家礼拜堂内部存在可辨识的职务晋升链:Child/Choirster(唱诗童)→ Master of the Children(童声训练主管)→ Organist / Virginalist(管风琴师/维金纳琴师)→ Gentleman(宣誓就任的资深成员)。
- Bull(1574–1597)与Gibbons(1603–1627)均完整经历了从儿童唱诗班到Gentleman的漫长过程,是表中体现完整职业轨迹的两例。
- Byrd(1570)与Morley(1592)仅作为Gentleman被记录,作者未在此表中列入他们更早期的儿童阶段,说明本表聚焦的是可考据的特定任职时点而非全部生平。
- 本表的史料作用在于以可考据的入职誓言(sworn)或归档记录(recorded)证明这四位作曲家均曾隶属皇家礼拜堂这一英国宫廷宗教音乐最高机构。
🔑 关键术语
- Chapel Royal:英国君主宫廷中的皇家礼拜堂,是负责宫廷宗教礼拜音乐的机构,本节四位作曲家均在此机构中任职。
- Child (Chapel Royal Child):皇家礼拜堂中的唱诗班男童,以童声参与礼拜音乐演唱,多为作曲家职业生涯的起点。
- Master of the Children:皇家礼拜堂中负责训练并管理唱诗班男童的负责人,属于成人音乐家的职务。
- Organist:皇家礼拜堂中的管风琴师,负责在礼拜仪式中演奏管风琴。
- Virginalist:维金纳琴(virginal,一种键盘乐器)演奏者,常见于伊丽莎白与雅各宾时期宫廷音乐机构中。
- Choirster:唱诗歌手,本表中用于Gibbons 1603年的记录,与「Child」含义相近但措辞不同,可能指年龄段稍长的歌者。
- Gentleman:皇家礼拜堂中宣誓就任的资深成员,需要正式誓言(sworn),地位高于普通乐师与歌手。
- sworn:本表用语,指通过正式宣誓就任Gentleman这一高级职务,强调入职程序的仪式性与可考据性。
- recorded:本表用语,指在档案中被记载、记录的任职事实,与「sworn」相比不一定伴随入职宣誓,史料性质略有不同。
s29 [描述性拆分] Byrd, Bull, Morley, Gibbons, and the Chapel Royal
第1段(P0276)
原文复述
Four of the six composers under study who were part of the Chapel Royal.
中文讲解
本句是前一句的延续,确立了本章的讨论范围:在作者研究的六位作曲家中,有四位曾隶属宫廷教堂(Chapel Royal)。这是为后续讨论这四位作曲家彼此之间的关系和互动所做的范围限定。
补充说明
Chapel Royal指英国王室专属的宗教音乐机构,兼具礼拜与仪式音乐功能,是当时英国最重要的宫廷音乐职位之一。
第2段(P0277)
原文复述
…were Byrd, Bull, Morley and Gibbons. From the chronological list of recorded memberships…
中文讲解
明确指出这四位作曲家是 Byrd、Bull、Morley 和 Gibbons,并引出本节的论证依据——依据表 II-B 中按时间排列的成员记录名单。这是把叙事从“范围限定”推进到“关系论证”的过渡句。
第3段(P0278)
原文复述
…corded memberships in Table II-B, it can be assumed that at least the first…
中文讲解
作者提示读者去查阅表 II-B 中按时间顺序排列的 Chapel Royal 成员名单,并以 it can be assumed 提出一个温和的推断:“至少前三位”彼此知晓存在的可能性。这一限定语 at least 很重要,它承认对第四位(Gibbons)的情况尚有保留。
第4段(P0279)
原文复述
…three knew of each others’ existences. Morley’s relation to Byrd is established…
中文讲解
承接上句:作者推断至少 Byrd、Bull、Morley 这三位彼此知道对方的存在。随后话题转向最具证据支撑的 Morley 与 Byrd 的关系,为下句具体证据做铺垫。
第5段(P0280)
原文复述
…lished by his dedication to Byrd, his “Master”, of the Plaine and Easie…
中文讲解
作者给出第一条关键证据:Morley 于 1597 年将其理论著作《Plaine and Easie Introduction to Practical Musicke》题献给 Byrd,并称 Byrd 为 “Master”(师)。这一题献既是师承关系的公开声明,也是两位作曲家之间社会与专业纽带的直接文献证据。
补充说明
《Plaine and Easie Introduction to Practical Musicke》(《实用音乐简明入门》)是英国早期音乐理论的重要文献,原文标注 Byrd 为 “Master” 体现了伊丽莎白时期以师承相称的风气。
第6段(P0281)
原文复述
…Introduction to Practical Musicke in 1597 (footnote 17). Morley also received the…
中文讲解
句尾确认题献的具体年份为 1597 年,并以脚注 17 给出文献出处(脚注内容本节未显示)。随后话题转向第二条证据——印刷专利权,把 Morley 与 Byrd 在制度层面上的连接揭示出来。
补充说明
脚注 17 的具体内容在当前输入中未给出,无法补写。
第7段(P0282)
原文复述
…monopoly over music printing in 1598 that William Byrd had shared with…
中文讲解
作者指出 Morley 在 1598 年获得了音乐印刷的独占权(monopoly),而这一权利此前曾由 William Byrd 持有。这表明在制度资源上,Morley 是 Byrd 既有特权的直接承继者,从而坐实二者之间的紧密职业联系。
第8段(P0283)
原文复述
…Thomas Tallis from 1575 to 1596 (footnote 18). It could be inferred that Morley had…
中文讲解
补全上一句:Byrd 此前与 Thomas Tallis 共同持有此专利,时间为 1575 至 1596 年(共 21 年),脚注 18 为来源。专利 1596 年终止、次年由 Morley 接替——作者用此制度史事实巩固“彼此相识”的推断。
补充说明
脚注 18 的具体内容在当前输入中未给出,无法补写。
第9段(P0284)
原文复述
…some familiarity with Bull’s works because the date of his swearing-in falls…
中文讲解
作者转向 Morley 与 Bull 的关系:Morley 的宣誓入职日期落在 Bull 在 Chapel Royal 任职的两个连续日期之间,因此可以推断 Morley 对 Bull 的作品有一定熟悉程度。这是从任职时间重叠推断作品认知的典型史学方法。
第10段(P0285)
原文复述
…between successive dates of Bull’s employment there, but Morley probably…
中文讲解
承接上一句对 Morley–Bull 关系的肯定,紧接着用 “but Morley probably” 转折,进入对 Morley 与 Gibbons 关系的相反判断,逻辑结构是先立后破。
第11段(P0286)
原文复述
…knew nothing of the younger Gibbons, who became a singer in the Chapel…
中文讲解
作者明确指出:Morley 大概率不认识更年轻的 Gibbons。理由随即给出——Gibbons 进入 Chapel Royal 合唱团是在 Morley 死后一年。这是用生命时间错位来推断“不可能相识”的史学论证。
第12段(P0287)
原文复述
…Royal choir one year after Morley’s death in 1602. John Bull, William Byrd…
中文讲解
补全上一句:Morley 卒于 1602 年,Gibbons 翌年(1603 年)才加入 Chapel Royal 唱诗班,因而二人在制度空间上没有交集。随后作者把视角拉远,从四位作曲家切回三位键盘作曲家:Bull、Byrd、Gibbons。
第13段(P0288)
原文复述
…and Orlando Gibbons’ births were about 20 years apart, respectively, and they…
中文讲解
作者给出关键的人口学事实:Bull、Byrd、Gibbons 三人出生年代大约各相差 20 年。这一代际结构解释了为何 Gibbons 是“younger”,并为下句把他们合称为键盘乐代表做铺垫。
第14段(P0289)
原文复述
…were collectively represented as the major keyboard composers of England…
中文讲解
作者指出这三位被共同视为英格兰主要的键盘乐作曲家。注意 collectively 一词——这不仅是个体成就的并列,更暗示一种公认的“三人组”式的身份认定,这一认定由《Parthenia》一书所固化。
第15段(P0290)
原文复述
…in Parthenia (footnote 19). This first English publication of keyboard music was dedicated…
中文讲解
承接上句:把“三人共同代表英格兰键盘乐”的具体文献证据锁定到《Parthenia》。作者进一步定义此书的史学地位——“第一部英国出版的键盘乐作品集”,并指出其题献对象,脚注 19 提供来源。
补充说明
脚注 19 的具体内容在当前输入中未给出,无法补写。
第16段(P0291)
原文复述
…cated to James I’s daughter Elizabeth in 1613, the year Bull left England…
中文讲解
句首补全:《Parthenia》于 1613 年题献给詹姆斯一世的女儿伊丽莎白。同年,Bull 永久离开英格兰。这两个时间点重合,使 1613 年成为衡量这三位作曲家之间彼此认知的关键节点。
第17段(P0292)
原文复述
…permanently and 10 years before Byrd’s death. It is very probable that…
中文讲解
补出 Byrd 去世的时间参照:Byrd 卒于 1623 年(1613 年加 10 年),从而把 Bull、Byrd、Gibbons 三人的生命跨度在同一时间坐标系内定位清楚,并以 It is very probable that 引出全节的核心结论。
第18段(P0293)
原文复述
…these three knew of each others’ work by this time.
中文讲解
本节结论句:到 1613 年时,这三位作曲家极有可能已经知道彼此的作品。综合前面的证据链条——制度交集、题献关系、印刷专利、出版物的集体代表性——作者把“彼此知晓存在”的弱推断升级为“彼此知晓作品”的强推断。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节正文涉及三个脚注:脚注 17(关于 1597 年 Morley 题献 Byrd《Plaine and Easie Introduction to Practical Musicke》一事的文献来源)、脚注 18(关于 Byrd 与 Tallis 自 1575 至 1596 年共享音乐印刷专利权的文献来源)、脚注 19(关于《Parthenia》作为英国首部键盘乐出版物及其题献等信息的文献来源)。三个脚注均起到来源支撑作用,分别对应文中三条主要证据链。脚注具体内容未在当前输入中给出,无法补录。另本节依赖一张名为 Table II-B 的表格提供 Chapel Royal 成员按年代排列的就职记录,文中以推断依据的方式引用此表。
💡 本节核心要点
- 研究范围内六位作曲家中,Byrd、Bull、Morley、Gibbons 四位均曾隶属 Chapel Royal,构成讨论其相互关系的制度背景。
- Morley 与 Byrd 之间有两条相互独立的硬证据:1597 年题献称 Byrd 为 “Master”,以及 1598 年由 Byrd 手中接管音乐印刷专利。
- Morley 与 Bull 因 Chapel Royal 任职时间重叠,可推断对其作品有所熟悉;但 Morley 与 Gibbons 因 Morley 1602 年去世而不可能相识。
- Bull、Byrd、Gibbons 三人出生各相距约 20 年,并在 1613 年的《Parthenia》中被共同列为英国主要键盘乐作曲家。
- 到 1613 年(Bull 永久离英、Byrd 去世前十年),这三位极有可能已经知道彼此的作品;这是本节论证的最终结论。
🔑 关键术语
- Chapel Royal:英国王室礼拜堂机构,兼具宗教仪式与宫廷音乐功能,是本章用以界定四位作曲家共同制度空间的关键词。
- Plaine and Easie Introduction to Practical Musicke:Morley 于 1597 年出版的英文音乐理论著作;本节用它作为 Morley 与 Byrd 师承关系的直接文献证据。
- monopoly over music printing:英国王室授予的音乐印刷独占专利权;本节借此说明 Morley 在制度资源上承继了 Byrd 与 Tallis 自 1575 至 1596 年的特权。
- Parthenia:1613 年出版的英国首部键盘乐合集,题献给詹姆斯一世之女伊丽莎白;本节将其作为 Bull、Byrd、Gibbons 三人被共同视为英国主要键盘乐作曲家的核心证据。
- Table II-B:按年代排列的 Chapel Royal 成员任职记录表;本节以其作为推断“任职时间重叠”与“彼此相识”可能性的主要依据。
s30 [描述性拆分] Philips, Farnaby, and Non-Chapel-Royal Composers
第1段(P0294)
原文复述
Peter Philips was never a member of Queen Elizabeth’s Chapel Royal.
中文讲解
本段开门见山,给出一个关键否定性事实:Peter Philips 从未成为伊丽莎白女王(Queen Elizabeth)王室教堂(Chapel Royal)的成员。这一定位之所以重要,是因为本节标题即讨论’非王室教堂作曲家’,作者在此以一个绝对否定句(’never’)明确将 Philips 从 Chapel Royal 编制中排除,为后文说明其作品如何在体制之外传播、为何需要单独归类奠定基础。读者应特别注意句中 ’never’ 一词——它是一个强否定,语气上等同于’任何时候都不是’,区别于下一段 Farnaby 所用的’无记录’(not recorded)。
第2段(P0295)
原文复述
He had left Reformation England to receive a Catholic education and employ-
中文讲解
本段文字承接上一段谈 Peter Philips 的去留原因:为求天主教(Catholic)的教育与工作,他离开了宗教改革后的英格兰(Reformation England,即已脱离罗马天主教会、由新教主导的英国)。句末的 ’employ-’ 以连字符结尾,是因排版换行而被截断,该词剩余部分在下一段 P0296 开头出现。理解本句的关键在于对’Reformation England’的把握——它指已经宗教改革完成的英格兰,故无法满足一个天主教徒对’Catholic education and employment’的需求;’education and employment’ 同时出现,则说明 Philips 离开英国后在大陆同时寻求学业与生计的保障。
补充说明
本段在原文中以一个未完成的词 ’employ-’ 结束,是版面换行造成的断裂,完整单词 ’employment’ 在 P0296 开头出现,阅读时需将两段合并为一句理解。
第3段(P0296)
原文复述
ment in 1582, and remained in Europe for the rest of his life. 20 Giles
中文讲解
本段承接上一段未完成的 ’employ-’,补完 ’employment’ 一词,并给出关键年份与余生归属:Philips 于 1582 年在欧洲获得天主教教育与工作,并余生都留在欧洲(remained in Europe for the rest of his life)。句末的上标 ‘20’ 指向脚注 20,为这一史实提供学术出处。末尾孤悬的 ‘Giles’ 一词实为下一段主语’Giles Farnaby’ 之名的首字,因此本段同时承担三个功能:补完 ’employment’、给出 Philips 1582 年赴欧的精确时间、并以 ‘Giles’ 一词作过渡,自然引出本节讨论的第二位作曲家。
补充说明
段末的上标 ‘20’ 为脚注编号,指向该书关于 Philips 1582 年离开英国这一陈述的学术出处;脚注的具体内容在当前输入中不可见。
第4段(P0297)
原文复述
Farnaby is not recorded in connection with the Chapel Royal.
中文讲解
本段以对称的否定句引入第二位作曲家 Giles Farnaby:现存档案中没有任何关于 Farnaby 与 Chapel Royal 关联的记录。措辞上与 P0294 形成呼应——P0294 用 ’never a member’(绝对否定),本段用 ’not recorded in connection’(文献证据缺失),两者语气略有差异:前者是基于确凿事实的断言,后者是基于文献沉默的推断。理解这一点有助于把握作者对两位作曲家体制归属的判定逻辑:Philips 是确知’不在’,Farnaby 是’无证据显示在’,两者以不同的否定力度为后文将他们单独成类提供了文献学依据。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节在 P0296 引用了脚注 20,但脚注的具体内容在当前输入的可见范围之外;其作用应为 P0296 中关于 Philips 1582 年离开英国并定居欧洲这一陈述的学术来源。
💡 本节核心要点
- Peter Philips 从未成为伊丽莎白女王 Chapel Royal 的成员,作者以绝对否定句 (’never a member’) 明确将其从 Chapel Royal 编制中排除。
- Philips 于 1582 年离开宗教改革后的英格兰 (Reformation England),赴欧洲大陆接受天主教教育并获得工作,此后余生未曾回国。
- Giles Farnaby 同样与 Chapel Royal 没有文献记载的关联——但措辞由 ’never’ 转为 ’not recorded’,两者所依据的证据强度不同。
- 本节通过这两位作曲家,划分出’非 Chapel Royal 作曲家’这一类别,与此前讨论的 Chapel Royal 作曲家形成对照。
- P0295 与 P0296 在原文中实为同一句因换页/排版分段而被截断,理解时需合并为 ‘receive a Catholic education and employment in 1582’。
- 脚注 20 为 P0296 中 Philips 1582 年离开英国这一史实提供学术出处支持。
🔑 关键术语
- Chapel Royal:英国君主直辖的王室教堂及其音乐机构,负责宫廷礼拜音乐;本节讨论的核心即是哪些作曲家被排除在此机构之外。
- Reformation England:宗教改革后的英格兰,指已脱离罗马天主教会、由新教主导的英国;这一宗教环境是 Philips 无法获得天主教教育与就业、因而离开的根本背景。
- Catholic education and employment:天主教教育与工作机会,是 Philips 在 Reformation England 中无法获得故赴欧洲寻求的两项实际需求。
- Giles Farnaby:本节与 Peter Philips 并列讨论的第二位作曲家,作者基于档案沉默 (not recorded) 判定其与 Chapel Royal 无关联。
s31 [描述性拆分] Table II-C: Musical Degrees at Oxford
第1段(P0298)
原文复述
TABLE II-C: Composers Receiving Musical Degrees at Oxford
中文讲解
本段是表格 II-C 的标题行,说明该表的主题是:在牛津大学获得音乐学位的作曲家。该标题把表中要呈现的核心信息——学位授予机构(牛津)、学位类型(音乐相关)、受授对象(作曲家)——一次性集中交代,便于读者把后续条目理解为同一类事实的清单,而非零散记录。
补充说明
标题中的罗马数字 II-C 表明该表属于第二章中的第三张表(C),暗示原书采用了分组编号体系;这一定位有助于读者在书中检索相关数据。
第2段(P0299)
原文复述
1586 - Bull, Bachelor of Music
中文讲解
表中第一条记录:1586 年作曲家 Bull(约翰·布尔)获得音乐学士学位(Bachelor of Music)。这是全表最早的条目,确立了牛津授予作曲家音乐学位这一记录的起点,也意味着 Bull 在随后出现的博士学位记录之前,曾先走过学士这一阶段。
补充说明
原表未给出 Bull 的全名或出生年;本条只复述表内可读信息,不作外部补全。
第3段(P0300)
原文复述
1588 - Morley, Bachelor of Music
中文讲解
第二条记录:1588 年作曲家 Morley(托马斯·莫利)获得音乐学士学位。与 Bull 的记录相隔两年,且同样为 Bachelor of Music,说明 16 世纪 80 年代后期牛津对作曲家授予的初始学位集中在学士层级,尚未出现博士学位的授予。
第4段(P0301)
原文复述
1592 - Farnaby, Bachelor of Music
中文讲解
第三条记录:1592 年作曲家 Farnaby(吉尔斯·范纳比)获得音乐学士学位。该年与下一条记录同为 1592 年,但本条仍属 Bachelor of Music,提示同一年中牛津可在学士与博士两个层级同时授予学位给不同的作曲家。
第5段(P0302)
原文复述
1592 - Bull, Doctor of Music
中文讲解
第四条记录:同样在 1592 年,Bull 获得音乐博士学位(Doctor of Music)。这一条与表中最早的 1586 年 Bull 学士记录呼应,表明 Bull 在六年间从 Bachelor 晋升到 Doctor,构成全表中唯一一例在牛津内部完成学位递进的案例,也把博士级别学位的授予时点固定在 1592 年。
补充说明
Bull 在表中的两次出现是该表内部可直接对照的信息,可视为表内自洽的纵向证据。
第6段(P0303)
原文复述
1622 - Gibbons, Doctor of Music
中文讲解
第五条,也是表中最后一条记录:1622 年作曲家 Gibbons(奥兰多·吉本斯)获得音乐博士学位。该条距前一条已隔 30 年,构成全表的时间下限,表明在 16 世纪末之后,牛津对作曲家授予的可见音乐学位活动归于沉寂,至少在本表所收范围内如此。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节实质为一整张表格(TABLE II-C),由标题一行加五条数据条目组成;表格自身已闭合,不含脚注、图例或旁注。表中可见的唯一自洽关系是 Bull 在 1586 与 1592 两条记录之间的学位递进。
💡 本节核心要点
- 该表聚焦于在牛津获得音乐学位的作曲家,时间跨度自 1586 年至 1622 年,共记录五位作曲家。
- 表中五位作曲家分别为 Bull、Morley、Farnaby、Bull、Gibbons,其中 Bull 出现两次,对应学士与博士两级学位。
- 学位层级在 1586–1592 年之间由 Bachelor of Music 提升到 Doctor of Music,Bull 是表内唯一完成这一晋升的案例。
- 1592 年同时授予一位作曲家学士、另一位作曲家博士两个层级的音乐学位。
- 1622 年的最后一条记录与前一条相隔 30 年,显示本表所覆盖的时间窗内,牛津对作曲家授予的音乐学位记录较为稀疏。
🔑 关键术语
- Bachelor of Music:音乐学士学位,表内出现于 1586、1588、1592 三个年份,对应 Bull、Morley、Farnaby 三位作曲家;它是表中记录的最低音乐学位层级。
- Doctor of Music:音乐博士学位,表内出现于 1592 与 1622 两个年份,对应 Bull 与 Gibbons;它是表中记录的最高音乐学位层级,仅在表的后半段才出现。
- TABLE II-C:原书第二章第三张表(C 为组内序号),主题限定为作曲家在牛津取得的音乐学位,是本节所有条目的归类依据。
s32 [描述性拆分] Formal Education and Degrees at Oxford
第1段(P0304)
原文复述
According to John Stevens, a Doctor’s degree in music could be granted by the university.
中文讲解
本段以约翰·史蒂文斯(John Stevens)的论述为权威依据,引出关于牛津大学音乐博士学位的话题。‘Doctor’s degree in music’即音乐博士学位,是当时大学可以授予的最高音乐学位。‘according to John Stevens’这一归属语表明作者在此并非自陈,而是援引二手学术权威,为后续关于学位授予标准的讨论提供可信度。
第2段(P0305)
原文复述
The Doctor’s degree was awarded on the basis of a musician’s proven ability in composing, rather than on the completion of formal studies at the university.
中文讲解
本段说明音乐博士学位的授予标准——依据的是音乐家在作曲方面已证实的实际能力,而非是否在大学完成过正式学业。这一标准的关键意义在于:它把’实际创作成就’置于’修课毕业’之上,体现出对实务型音乐才能的认可。这种授予逻辑正是后文推测布尔凭作品获荣誉博士的历史依据。
第3段(P0306)
原文复述
By contrast, the Bachelor’s degree is described as having “conferred the right of reading and lecturing” upon its holder in the science of music.
中文讲解
本段将话题从博士学位转向学士学位,并把两者作对照:博士学位依据作曲能力授予,学士学位则赋予持有人’讲授与诵读的权利’。‘right of reading and lecturing’是中世纪大学学术术语,指获得正式讲授某门学科的资格;‘science of music’即’音乐的科学’,是中世纪对音乐理论学科的称呼。作者以’By contrast’提示读者注意两种学位在性质上的根本差异。
第4段(P0307)
原文复述
The right was conferred within the science of music, that is, the science of music as represented by Boethius.
中文讲解
本段明确’音乐的科学’的具体所指:即以波埃修斯(Boethius)著作为代表的中世纪音乐理论体系。括号中的’i.e. Boethius’是关键的同位语注释,说明牛津的学士学位所对应的’音乐’,并非实践性的演奏或作曲,而是以波埃修斯为权威的理论学科。
第5段(P0308)
原文复述
For the Bachelor’s degree, no practical musical ability was required. (Footnote 21.) The passage then turns to consider whether this latter (Bachelor’s) degree, if earned by Morley and Farnaby, might be understood in a particular way.
中文讲解
本段先总结学士学位的核心特征:不需要任何实际演奏或作曲能力(其后附脚注21作为出处)。随后作者笔锋一转,开始推测:如果莫利(Morley)与法纳比(Farnaby)也曾获得过这种学士学位,那么其学位意义就需要重新审视。这为下一段引入’皇家教堂赞助’的解释埋下伏笔。
补充说明
脚注21附于’no practical ability was required’之后,应是对’学士学位不要求实际演奏能力’这一陈述的来源注释,承载本节的关键事实依据。
第6段(P0309)
原文复述
If the Bachelor’s degree had been earned by Morley and Farnaby as an extension of the Chapel Royal’s sponsorship for choirboys…
中文讲解
本段延续上一段的假设:莫利与法纳比的学士学位(如曾获得)可能只是’皇家教堂(Chapel Royal)对唱诗班少年(choirboys)赞助体系’的延伸。中世纪及近代早期英国,皇家教堂常以赞助唱诗班少年教育的方式培养音乐人才,这与大学学位授予体系并不完全等同。这一推断帮助读者理解,为何不能仅凭学位就推断作曲家与牛津大学的实质学术联系。
第7段(P0310)
原文复述
…then perhaps both composers had been connected with that establishment after all.
中文讲解
本段以’after all’收束前述假设,得出委婉推论:如果莫利与法纳比的学士位来自皇家教堂的赞助体系,那么他们二人或许终究还是与该机构有所关联。‘after all’一词提示这一结论呼应了前文曾对他们与该机构关系的疑问,给出’二人可能确有关联’的开放性回答。
第8段(P0311)
原文复述
The passage then considers a different case: if an honorary Doctor’s degree were awarded to Bull in 1592…
中文讲解
本段开启关于约翰·布尔(John Bull)的另一种假设:1592年他可能获得了牛津大学的荣誉博士学位(honorary Doctor’s degree)。‘honorary’一词本身已暗示:授予依据并非正式学业,而是受奖者的声望或作品成就——这与本节开篇史蒂文斯所述的’以作曲能力而非正式学业’的博士位标准一致。‘if’和’might be’等限定语则保持论述的推测性质。
第9段(P0312)
原文复述
…this fact, awarded for his musical compositions, would be insufficient reason to think that he personally knew Farnaby.
中文讲解
本段提出方法论上的关键判断:仅凭布尔获荣誉博士这一事实,不足以推论他个人认识法纳比。‘insufficient reason’是核心限定语,体现作者意识到读者可能从学位时间重合联想到二人相识,但作者明确否定其逻辑充分性。这种谨慎态度反映历史研究中避免’过度推断’的学术自觉。
第10段(P0313)
原文复述
Farnaby received his Bachelor’s degree from Oxford in the very same year.
中文讲解
本段补全上述判断的关键背景:法纳比在同一时间(1592年)也从牛津获得了学士学位。’the same year’这一时间巧合是引发’二人或相识’猜想的事实基础,但作者已经限定这一巧合不构成相识的充分证据。
第11段(P0314)
原文复述
Orlando Gibbons earned his Doctor’s degree from Oxford so much later than the others discussed…
中文讲解
本段将讨论扩展到奥兰多·吉本斯(Orlando Gibbons):他从牛津获得博士学位的时间,比本节讨论的其他作曲家(如布尔、法纳比)要晚得多。‘so much later’所强调的时间差距,是作者接下来对其与他们关系作细分判断的基础。
第12段(P0315)
原文复述
…he may have been acquainted with their music without having known them as individuals.
中文讲解
本段提出关键的细分判断:吉本斯晚得博士意味着,他完全可能熟悉前面那些作曲家(如布尔、法纳比)的音乐作品,却未必认识他们本人。作者在此区分了’了解其作品’与’认识其个人’这两个不同层次,呼应前段对’学位重合≠个人相识’的谨慎立场。
第13段(P0316)
原文复述
…without knowing them as individuals at the university.
中文讲解
本段以’in the university’的地点限定收束全节:在牛津这一具体场所,吉本斯与他们是否以个人身份相识,仍无法从学位证据中确定。原文在此处戛然而止,留给读者一个开放性的判断空间——这是作者刻意营造的论证克制:他列举了所有可用的学位证据,但没有做出超越证据的结论。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节包含一条脚注(脚注21),位于P0308’no practical ability was required’之后。该脚注为支撑’学士学位不要求实际演奏能力’这一陈述的来源注释,应指向约翰·史蒂文斯关于牛津大学音乐学位的研究著作。其作用是为本节的核心事实提供学术依据,并强化作者论点的可信度。
💡 本节核心要点
- 牛津大学的音乐博士学位可基于作曲的实际能力授予,不要求完成正式学业;这使得’博士’头衔本身并不证明受奖者与大学有过系统学习。
- 学士学位授予的是讲授波埃修斯音乐理论体系的资格,不要求实际演奏或作曲能力;因此学士位也不能证明作曲家受过系统的实践训练。
- 如果莫利与法纳比获得过牛津音乐学士,他们的学位可能仅是皇家教堂对唱诗班少年赞助培养体系的延伸,不能据此认定他们与牛津有真正的学术联系。
- 布尔1592年获荣誉博士、法纳比同年获学士,两位作曲家时间重合并不足以推论二人个人相识——作者明确反对这一过度推断。
- 吉本斯的博士位时间远晚于上述诸人,因此他可能熟悉他们的作品却未必认识他们本人;本节以’了解作品’与’认识个人’的细致区分收束论证。
- 全节体现出作者的方法论自觉:可用的’学位’证据只触及学术活动与机构赞助的表层,无法单独证明作曲家之间的私人交往。
🔑 关键术语
- Doctor’s degree in music:牛津大学授予的音乐博士学位;据约翰·史蒂文斯所述,其授予依据可以是作曲方面的实际能力,而非完成大学正式学业。
- Bachelor’s degree (in music):牛津大学的音乐学士学位;其授予的实质是’讲授与诵读’音乐科学(即波埃修斯体系)的学术资格,不要求实际演奏或作曲能力。
- “right of reading and lecturing”:源自中世纪大学的术语,指获得在某门学科正式开讲与讲解权威文本的资格;本节中特指讲授波埃修斯音乐理论的权利。
- Boethius:波埃修斯,其著作是中世纪大学音乐学科的基础文本;‘science of music’即指以波埃修斯为权威的音乐理论体系。
- Chapel Royal / choisters:皇家教堂与唱诗班少年;英国王室常以赞助唱诗班少年教育的方式培养音乐人才,是独立于大学学位体系之外的音乐训练途径。
- honorary Doctor’s degree:荣誉博士学位;本节以布尔1592年的获奖为例,体现牛津博士位可脱离正式学业,仅凭声望或作品成就授予。
- John Stevens:本节援引的权威学者,作为’牛津音乐博士可凭作曲能力授予’这一陈述的来源。
s33 [描述性拆分] Religious Affiliations and the Fitzwilliam Virginal Book
第1段(P0317)
原文复述
The third area of convergence for the group of six composers is religi-
中文讲解
本句是本节开篇第一行,指出六位作曲家群体汇聚的第三个领域是宗教。句末的连字符 “relig-” 表示原词 “religious” 在此处因换行被截断,将由下一行 P0318 续接为完整词形。
第2段(P0318)
原文复述
gious. Elizabeth Cole established the common Catholic link between the
中文讲解
续接上一行的 “relig-” 完成 “religious”,随后点出本节核心引证人 Elizabeth Cole,并由她建立了连接该群体中作曲家与抄写员的共同天主教纽带。本句承上启下:前一句引出"宗教"这一话题,本句立即把论题具体化为"天主教"以及 Cole 的学术贡献。
第3段(P0319)
原文复述
composers and copyist of the Fitzwilliam Virginal Book, copied between 1613
中文讲解
承接上一行,说明 Cole 所论证的天主教纽带所牵涉的对象——菲茨威廉维金纳琴曲集(Fitzwilliam Virginal Book)的作曲家与抄写员,并给出抄写年代的起点 “1613”。该年代范围将由下一行 P0320 补全至 “1619”。在本节论证中,这部曲集被视为揭示作曲家共同宗教背景的关键实物证据。
第4段(P0320)
原文复述
and 1619. ²² This definitive collection includes Peter Philips, but excludes
中文讲解
补全抄写年代为 “1613 至 1619 年”。随后的上标 “²²” 指向上文已存在的脚注 22,应理解为关于这一年代断定的文献来源。紧接着一句概括曲集的内容性质:它收入了 Peter Philips,却未收入 Orlando Gibbons,明确界定该曲集涵盖的作曲家范围,并暗示 Gibbons 不在天主教这一共同纽带之内。
第5段(P0321)
原文复述
Orlando Gibbons. Francis Tregion (“the Younger”) was the compiler of the
中文讲解
承接上一行完成"未收入 Orlando Gibbons"这一信息,随即引出该曲集的编纂者——Francis Tregian(小 Francis Tregian,文中称 “the Younger”,即"小 Tregian”,以区别于其同名的父亲)。这一信息的关键性在于:编纂者本人的身份直接关系到下文对其宗教与政治处境的论述。
第6段(P0322)
原文复述
collection, completed presumably while he was imprisoned in the Fleet for
中文讲解
续接上句,说明 Tregian 是该曲集的编纂者,其完成时间被推测为他因反新教活动被关押在弗利特监狱(Fleet Prison)期间。“presumably” 一词点出这只是推断而非确证,留有学术余地;“anti-Protestant activities”(反新教活动)则与本节开篇确立的"天主教纽带"主题形成呼应。
第7段(P0323)
原文复述
anti-Protestant activities. All composers included and many of the patrons’
中文讲解
完整表述 Tregian 之所以被囚的原因——反新教活动。随后笔锋转向曲集内部社会网络的事实陈述:所有被收入曲集的作曲家,以及许多在献辞中被提到的赞助人,都属于一个在天主教改革(Reformation)期间维持紧密社会联系的天主教少数群体。本句是本段论证的核心命题之一。
第8段(P0324)
原文复述
named in dedications were part of a Catholic minority that maintained close
中文讲解
承接 P0323 的 “patrons’” 完成"献辞中所提到的赞助人"这一短语,明确这些赞助人属于上文提到的天主教少数群体。“maintained close” 由下一行 P0325 续写为 “maintained close social ties”,强调在天主教改革大背景下这群人保持着紧密的社会纽带。
第9段(P0325)
原文复述
social ties during the Reformation. The many connections Cole brings out
中文讲解
补全 “maintained close social ties during the Reformation” 这一关键短语,把"天主教少数群体"放进宗教改革这一历史时空中加以理解。随后笔锋转向对 Cole 学术工作的评价——Cole 揭示出的变奏曲标题中所提到的政治与赞助人之间的诸多联系是"引人入胜的”(intriguing)。这一句为本段第二主题的展开作了铺垫。
第10段(P0326)
原文复述
between politics and patrons named in the variation titles are intriguing.
中文讲解
完整呈现 Cole 工作所揭示的内容:在变奏曲标题中出现的赞助人与当时政治之间存在诸多联系,这些联系被作者评价为"引人入胜”。这句话既是对 Cole 研究的肯定,也为本段接下来展开具体政治—赞助人案例埋下伏笔——下一句即开始列举 Thomas Paget 与 Lord Montegle 的例子。
第11段(P0327)
原文复述
Thomas Pagget of Peter Philips’ “Paget Pavan and Galliarda"²³ was a double
中文讲解
承接上一段对"政治与赞助人联系"的概括,本句开始列举第一个具体例证:Peter Philips 作品《Paget Pavan and Galliarda》(帕吉特帕凡与嘉利亚舞曲)标题中所提到的 Thomas Paget,被描述为西班牙与英格兰两国政府之间的双重间谍(double agent)。上标 “²³” 对应脚注 23,应理解为关于 Philips 此曲或 Paget 这一人物的文献依据。
第12段(P0328)
原文复述
agent between the governments of Spain and England. Lord Montegle of Byrd’s
中文讲解
完整呈现 Paget 作为双重间谍的政治身份——他在西班牙政府与英格兰政府之间斡旋。紧接着引出第二个例证:Byrd 作品中的 Lord Montegle(蒙特格尔勋爵),其姓氏也将由下一行 P0329 续写为完整的曲名《Montegle Pavan》。这一系列例证都旨在说明,变奏曲标题中所涉及的人物并非随意命名,而往往牵涉重大政治事件。
第13段(P0329)
原文复述
“Montegle Pavan” ²⁴ was involved in the Essex uprising of 1601. Morley is
中文讲解
补全 Byrd 作品名为《Montegle Pavan》(蒙特格尔帕凡),并指出 Lord Montegle 卷入了 1601 年的埃塞克斯叛乱(Essex uprising),这是伊丽莎白一世晚期一次重要的政治事件,对天主教同情者而言尤其敏感。上标 “²⁴” 对应脚注 24,提供出处依据。句末引出第三位作曲家 Thomas Morley,由下一行 P0330 续写其具体处境。
第14段(P0330)
原文复述
recorded as having repented of his Protestant associations while serving
中文讲解
承接上一行引出 Morley,记述他在为 Charles Paget 服务期间曾对其新教关联表示悔过(repented of his Protestant associations)。这一细节提示:宗教身份并非作曲家简单的标签,而是在不同语境下可被声称、可被调整的策略性姿态。该悔过行为发生在安特卫普——一个天主教氛围浓厚、与英国新教官方立场相对的城市。
第15段(P0331)
原文复述
Charles Pagget in Antwerp, but apparently he kept up a patriotic, anti-
中文讲解
续接 P0330,将 Morley 悔过新教关联的时间地点具体化为"在安特卫普为 Charles Paget 服务期间”。随后用 “but apparently” 转折:回到英格兰后,Morley 表面上维持了一种爱国、反天主教的姿态。“anti-” 由下一行 P0332 续为 “anti-Catholic posture”,这一对照展现出 Morley 宗教立场的两面性与策略性。
第16段(P0332)
原文复述
Catholic posture after returning to England. ²⁵ John Bull’s departure for
中文讲解
补全 Morley 回到英格兰后所维持的姿态为"爱国、反天主教”。上标 “²⁵” 对应脚注 25,是关于 Morley 此种姿态的文献来源。紧接着引出第四位作曲家 John Bull,他的离境动因将由后续几行展开。本句起到案例间过渡的作用。
第17段(P0333)
原文复述
the Netherlands in 1613 is politically ambiguous. It was explained as
中文讲解
承接上一行指出 John Bull 于 1613 年前往荷兰(尼德兰),并强调此事的政治含义是模糊的(politically ambiguous)。句中 “It” 由下一行承接,指代"此行"或"此离境”,并开始给出两种相互矛盾的解释——一边是来自欧洲大陆的文件,一边是来自英格兰的说法。
第18段(P0334)
原文复述
escape from religious persecution in documents from the continent, and de-
中文讲解
承接上一行 “It was explained as”,开始给出第一种解释——按来自欧洲大陆的文件所言,Bull 的离境是为逃避宗教迫害(escape from religious persecution)。“and de-” 是 “described” 一词在该行末尾被截断,将由下一行 P0335 续写为 “described as”,引出第二种解释。
第19段(P0335)
原文复述
scribed as evasion of punishment for adultery by some in England. ²⁶ His
中文讲解
补全 “described as evasion of punishment for adultery by some in England”,完成第二种解释:英格兰一些人的说法是 Bull 离境是为逃避通奸(adultery)的惩罚。两种说法——宗教迫害 vs. 通奸——之间的张力,恰是作者强调其"政治含义模糊"的具体内容。上标 “²⁶” 对应脚注 26,提供出处。句末引出 Bull 与 Peter Philips 的友谊,由下一行续写。
第20段(P0336)
原文复述
friendship with the Catholic Peter Philips is recorded from a trip to
中文讲解
承接上一行,引出 Bull 与天主教徒 Peter Philips 的友谊在文献中有记载,记载来源是两人某次出行(“a trip to” 后文本在此行末尾截断,原本应接一个目的地名词)。这一友谊在论题上回扣到"天主教纽带”——Bull 即便其离境动机存在争议,仍被记录为与一位天主教作曲家交往密切。
补充说明
本行末尾 “a trip to” 在所提供文本中未完成,疑似后续段落(P0337 起新句)前存在缺漏;此处仅按原文复述,不补造地名或时间。
第21段(P0337)
原文复述
The existence of the Fitzwilliam Virginal Book provides the strongest
中文讲解
本句开启本节最后一个论证段落,重新回到菲茨威廉维金纳琴曲集这一实物证据,并把它定位为支持六位作曲家构成"共同作曲学派”(common school of composition)这一主张的最有力依据。“strongest” 一词提示,作者将在最后两行中收束全文、做出结论性判断。
第22段(P0338)
原文复述
support for a common school of composition. That all of the music was
中文讲解
完整呈现作者的核心主张:菲茨威廉维金纳琴曲集的存在为"共同作曲学派"提供了最强支持。“That all of the music was” 是结果从句的开头,由下一行 P0339 续写为 “That all of the music was written by members of a close political minority”,将"音乐"与"政治少数群体"联系起来。
第23段(P0339)
原文复述
written by members of a close political minority argues for some exchange
中文讲解
承接上一行,补全结果从句为"曲集中所有音乐皆由某一紧密政治少数群体的成员所写”。这一事实据作者看来能够论证(argues for)这些作曲家之间存在某种音乐思想的交流(some exchange)。“argues for” 用词审慎,表明作者承认这是基于证据的推断,而非直接确证。
第24段(P0340)
原文复述
of musical ideas as well.
中文讲解
补全 P0339 的 “some exchange” 为 “some exchange of musical ideas as well”,完成全节最后一句。“as well” 一词点出此句的隐含对照:作者已经论述了政治与宗教层面的紧密联系,本句进而把这一联系延展到音乐思想本身的交流。整节由此收束于"共同政治—宗教背景促成共同音乐语言"这一总体性主张。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节涉及的脚注编号为 22–26(见 P0320、P0327、P0329、P0332、P0335 各行末尾的上标)。脚注 22 提供菲茨威廉维金纳琴曲集抄写年代(1613–1619)的文献依据;脚注 23 与 Philips《Paget Pavan and Galliarda》及其相关人物 Thomas Paget 有关;脚注 24 与 Byrd《Montegle Pavan》及其所涉 Lord Montegle 在 1601 年埃塞克斯叛乱中的角色有关;脚注 25 支撑 Morley 在回国后维持反天主教爱国姿态的记述;脚注 26 则与 John Bull 1613 年离境英伦的两种相互矛盾的解释(欧洲大陆的"宗教迫害"与英格兰的"逃避通奸惩罚”)相关。这些脚注均为本节具体人事论断的来源支撑,而非单纯的旁注。此外,P0336 行末 “a trip to” 在所提供的文本中未完成,疑为后续段落前的缺漏,本节讲解未据此补造任何具体地点或时间。
💡 本节核心要点
- 本节论证六位作曲家群体汇聚的第三大领域是宗教,具体表现为共同的天主教纽带。
- Elizabeth Cole 的研究把菲茨威廉维金纳琴曲集中的作曲家、抄写员与赞助人共同定位为宗教改革期间维持紧密社会联系的天主教少数群体。
- 菲茨威廉维金纳琴曲集(1613–1619 年抄成)由 Francis Tregian(小 Tregian)在弗利特监狱服刑期间编纂,他本人因反新教活动被囚。
- Cole 揭示出变奏曲标题中所提到的赞助人与英国国内外重大政治事件之间的诸多联系,文中列举 Paget(西—英双重间谍)、Lord Montegle(1601 年埃塞克斯叛乱参与者)、Morley(在安特卫普悔过新教关联、回国后维持反天主教姿态)以及 John Bull(1613 年离境原因在大陆与英格兰两地有截然不同的解释)等例证。
- John Bull 与天主教作曲家 Peter Philips 的友谊在文献中有明确记载,进一步印证该群体的天主教纽带。
- 本节以菲茨威廉维金纳琴曲集的存在作为最强证据,论证这些作曲家不仅共享政治—宗教身份,还共享某种音乐思想的交流,从而支持一个"共同作曲学派"的存在。
🔑 关键术语
- Fitzwilliam Virginal Book:菲茨威廉维金纳琴曲集,一部抄写于 1613 至 1619 年间的英国维金纳琴音乐手稿抄本,由 Francis Tregian(小 Tregian)在弗利特监狱服刑期间编纂。该曲集是本节用以论证六位作曲家构成"共同作曲学派"的最关键实物证据。
- Catholic minority:天主教少数群体,指宗教改革时期在英格兰维持天主教信仰并保持紧密社会联系的群体。本节把六位作曲家及部分赞助人均归入这一群体,以此作为其音乐活动共享的宗教背景。
- Reformation:宗教改革,此处特指 16 世纪英格兰脱离罗马天主教会、建立英国国教(圣公会)的进程。该进程造成天主教徒在英格兰成为政治与宗教上的少数派,本节所讨论的作曲家群体的形成背景即与此相关。
- Fleet:弗利特监狱(Fleet Prison),伦敦历史上著名的羁押场所。本节指明 Francis Tregian 因反新教活动被关押于此,并推测菲茨威廉维金纳琴曲集在其服刑期间完成。
- Essex uprising:1601 年的埃塞克斯叛乱,伊丽莎白一世晚期由 Earl of Essex 发动、失败的一次政治起事,因牵涉天主教同情者而对本节所讨论的群体具有特殊意义。Lord Montegle 因参与此事件而在 Byrd《Montegle Pavan》的标题中留下印记。
- double agent:双重间谍,即同时为对立双方服务的情报人员。本节以 Peter Philips《Paget Pavan and Galliarda》标题中的 Thomas Paget 为例,说明变奏曲标题中的人物往往具有跨国跨阵营的政治身份。
- common school of composition:共同作曲学派,作者用以概括六位作曲家在政治、宗教与音乐语言上彼此关联的概念。本节结尾以菲茨威廉维金纳琴曲集为最强证据论证该学派的存在。
s34 Development of the Variation Genre
第1段(P0341)
原文复述
Development of the Variation Genre
中文讲解
本条为二级小节标题“变奏体裁的发展”。作者在此将论述由前文背景切换到变奏这一具体体裁本身的演进史,宣告接下来要梳理英国键盘变奏传统的形成脉络与前驱。
第2段(P0342)
原文复述
Though Byrd, Bull, Morley, Gibbons, Farnaby and Philips each wrote in several genres for various instruments, the variation seems to have been the predominant form for their keyboard writing, and most of them were acknowledged as keyboard performers. The history of the keyboard variation was still young when they employed it in the late sixteenth century. Early secular forerunners can be seen in the British Library Manuscript Roy.App. 58 (dated c.1530) and in the Spanish lute variations by Louis Milan of 1536. $^{28}$ The former contains dances written or transcribed for the virginals. Hugh Aston’s “Hornpype” and “My Lady Carey’s Dompe” (Anon.) are both grounds in this collection, and represent the earliest models of basso ostinato keyboard variation. Spanish songs are the source material for the sixteenth century lute variations by Milan, Navarro, Mudarra and Valderabanno; $^{29}$ but Antonio de Cabezon is credited with the first of such variation sets for keyboard. His possible influence on the English–or
中文讲解
本段为小节的开篇史述,确立两条并行的前驱线索——英格兰方面与伊比利亚方面——以解释16世纪晚期英国键盘变奏传统的由来。
作者先以 Byrd、Bull、Morley、Gibbons、Farnaby、Philps 六位英国作曲家为例,指出他们虽跨足多种体裁与乐器,但在键盘写作中变奏是主导体裁,且大多本身即是公认的键盘演奏家。这一“写作与演奏合一”的事实,构成了变奏在键盘上得以盛行的内在条件。紧接着,作者强调:当这些人在16世纪晚期运用键盘变奏时,这一体裁的历史仍属“年轻”,从而为追溯前驱提供必要性。
随后给出两个早期世俗前驱:其一是大英图书馆藏手稿 Roy.App. 58(约1530年),其中包含为维吉纳琴(virginals)写作或转录的舞曲;Hugh Aston 的《Hornpype》与佚名曲《My Lady Carey’s Dompe》都是“ground”(以固定低音为基础的变奏),代表了最早的固定低音(basso ostinato)键盘变奏范例。其二是1536年西班牙作曲家 Luis Milan 的鲁特琴变奏。注释28应为这两条早期来源提供更详尽的文献指引。
接下来作者把目光转向16世纪西班牙鲁特琴变奏(Milan、Navarro、Mudarra、Valderrabano),指出其素材均取自西班牙歌曲;但在键盘领域,首位被公认为创作此类变奏组曲的,是 Antonio de Cabezon。注释29应与这一组西班牙鲁特琴变奏的文献有关。
末句“His possible influence on the English–or”在排印上未完,可判断延续至下页(即次段的开头将以“on the English …”继续展开 Cabezon 对英国传统可能产生的影响)。本段的功能,是先建立“键盘变奏体裁年轻、英国作曲家受欧洲大陆前驱影响”这一基本判断,为后文细化 Byrd 等人的具体贡献做铺垫。
理解时需注意三点:(1)ground 与 basso ostinato 是同一概念,指在低声部反复出现的固定音型;(2)virginals 是16世纪英国常见的方形或矩形羽管键琴,与现代钢琴不同;(3)本段将英国变奏的源头同时指向本土手稿与西班牙鲁特琴/键盘传统,暗示16世纪欧洲键盘变奏存在跨国流动。
补充说明
段内文献关系说明:注释28对应“British Library Manuscript Roy.App. 58 (dated c.1530)”与“Spanish lute variations by Louis Milan of 1536”两条早期前驱;注释29对应后文提及的 Milan、Navarro、Mudarra、Valderrabano 四位西班牙鲁特琴变奏作者。Aston 的《Hornpype》与佚名《My Lady Carey’s Dompe》同属 Roy.App. 58 中的 ground 类曲目,作者借以论证英格兰本土已有最早的固定低音键盘变奏雏形。Cabezon 被定位为键盘变奏组曲的开创者,从而与西班牙鲁特琴变奏(仅用西班牙歌曲作素材)形成对比,体现“鲁特琴先行、键盘跟进”的体裁迁移路径。
脚注 / 边栏 / 图表 / 附加信息(如有)
脚注28与脚注29承担文献支撑作用:28指向 Roy.App. 58 手稿及 Milan 1536 年鲁特琴变奏两条最早世俗前驱;29指向16世纪西班牙多位鲁特琴变奏家(Milan、Navarro、Mudarra、Valderrabano)的文献出处。本段末尾“His possible influence on the English–or”显示句子在版面边界处被截断,相关论述应在下一页续完。本节无图示或表格。
💡 本节核心要点
- 16世纪晚期英国键盘作曲家(Byrd、Bull、Morley、Gibbons、Farnaby、Philps)的键盘写作以变奏为主导,且多数兼具键盘演奏家身份,说明体裁与演奏实践深度绑定。
- 这些作曲家运用键盘变奏时,该体裁的历史仍属年轻,因此必须向前追溯更早的世俗前驱。
- 英格兰方面的世俗前驱见于大英图书馆手稿 Roy.App. 58(约1530),其中 Hugh Aston 的《Hornpype》与佚名《My Lady Carey’s Dompe》是最早的固定低音(basso ostinato)键盘变奏范例。
- 伊比利亚方面的世俗前驱以1536年 Milan 的西班牙鲁特琴变奏为代表,显示变奏实践在16世纪欧洲已跨国流通。
- 16世纪西班牙鲁特琴变奏(Milan、Navarro、Mudarra、Valderrabano)皆以西班牙歌曲为素材;而 Antonio de Cabezon 被认为是键盘领域首批此类变奏组曲的作者。
- 段末关于 Cabezon 可能影响英国传统的句子被截断,预示下一段将继续讨论这一跨国的体裁传播问题。
🔑 关键术语
- ground / basso ostinato:固定低音变奏,即在低声部反复出现同一音型,上方声部围绕其作变奏;本段中 Aston 的《Hornpype》与佚名《My Lady Carey’s Dompe》即属此类,被作者视为最早的键盘固定低音变奏范例。
- virginals:维吉纳琴,16世纪英国常见的方形或矩形羽管键琴,Roy.App. 58 中的舞曲即为此类乐器而作;与现代钢琴不同,需以手指直接拨动琴弦发声。
- variation set:变奏组曲,指围绕同一主题或固定低音连续作多段变奏而成的成套作品;本段将西班牙鲁特琴变奏与 Cabezon 的键盘变奏均归入此类体裁范畴。
s35 [描述性拆分] Early Secular Forerunners and the English Tradition
第1段(P0343)
原文复述
vice versa–has been discussed by Charles Van den Borren in connection with
中文讲解
本段是接续上一页的句尾片段,并非独立段落。原文出现 “vice versa”(反之亦然),结合上下文语境,可推断此前讨论的是某一方向的传播影响(如西班牙→英国),而 Van den Borren 的研究则同时讨论了反向(vice versa)的影响路径,并把它与下文将提及的 Cabezon 1554 年赴伦敦之行相关联。
补充说明
本段中 “vice versa–” 的双连字符在原文中起破折号作用;该词组的反身含义需要依赖上一节论述方向才能完整理解,本节输入未提供,故此处只指出其语言信号而不补写具体内容。
第2段(P0344)
原文复述
Cabezon’s travel to London in London in 1554. The lack of surviving variation manu-
中文讲解
本句承接上段,说明 Van den Borren 讨论的具体史实事件:西班牙键盘作曲家 Antonio de Cabezon 于 1554 年到访伦敦,并随之指出,从 1554 年到他身后出版的《Obras de musica》(1578) 之间,并没有变奏曲手稿存世。原文 “manu-” 在此处为行末断字,下一段 “scripts” 将续接。
补充说明
Cezon 在原文中写作 Cabezon(保留伊比利亚语发音拼写)。原文中 “manu-” 与下一段 “scripts” 拼合成 “manuscripts”,是排版断字而非词义断裂。
第3段(P0345)
原文复述
scripts between then and his posthumously printed Obras de musica (1578)
中文讲解
本段续接上段 “manu-",拼成 “manuscripts”(手稿),与上段合为完整一句:“The lack of surviving variation manuscripts between then and his posthumously printed Obras de musica (1578)"。“then” 指代 1554 年 Cabezon 抵伦敦;“posthumously printed”(身后出版)说明《Obras de musica》刊于 1578 年,是他去世后才印行的曲集。括号内 (1578) 是出版年份。
补充说明
《Obras de musica》在原文中保留西班牙语原名,未译为英语。“Obras” 即 “works”(作品)。
第4段(P0346)
原文复述
leaves Cabezon the credit for the first variations written specifically for
中文讲解
本段续接上段:作者据此断言,由于 1554–1578 年间并无变奏手稿存世,Cabezon 因此被认定为"专为键盘写作的第一批变奏曲"的作者。“leaves … the credit for …” 的句式强调:因为没有更早的存世作品,所以桂冠只能归于 Cabezon。这是基于"存世证据”(surviving evidence)的逻辑,而不是绝对意义上的首创证明。
补充说明
“credit for” 在此意为"把……的荣誉归于”,而非"信用”。作者用此措辞体现了对"存世证据缺失"和"真正首创"之间区别的谨慎态度。
第5段(P0347)
原文复述
keyboard. Two years later, Peter Philips’ Pavan (FWI, P.343) represents
中文讲解
本段与上段连读:”…the first variations written specifically for keyboard”。“Two years later” 应指《Obras de musica》(1578) 出版两年后,即 1580 年。Peter Philips 的帕凡舞曲(Pavan,作品位置 FWI, P.343)便代表了英国变奏传统中最早带有明确日期的范例。FWI 很可能是该书/曲集中的索引缩写(Page 343),原文中未加展开。
补充说明
FWI 在原文中未给出全称,本节输入亦未提供,故不应补写其代表的具体出版缩写。“Pavan” 是文艺复兴时期常见的宫廷舞曲体裁。
第6段(P0348)
原文复述
the first dated copy in a long succession of English variations. $^{30}$
中文讲解
本段完成上一句的结尾:Peter Philips 的帕凡曲是英国变奏传统中"最早带有日期的抄本/版本"(first dated copy),并由此开启了绵延甚久的英国变奏曲谱系。句末附有脚注标记 $^{30}$,但本节输入未给出脚注 30 的内容,因此无法展开其支持/限定作用。
补充说明
“long succession”(绵延不绝的谱系)暗示作者将随后讨论的 1588–1625 年间的英国键盘变奏视为这一传统的延续与繁盛期。脚注 30 的具体内容需查阅原书脚注。
第7段(P0349)
原文复述
Whatever the cross-currents of influence were, it was the English who
中文讲解
本段开始一个新的论断。“Whatever the cross-currents of influence were”(无论相互影响多么错综复杂)是一种让步式铺垫——作者承认 Cabezon、Philips 等案例显示英欧之间确有双向交流,可是他仍要强调:真正把世俗键盘变奏发扬光大的,是英国人。“cross-currents” 一词形象地暗示影响并非单向,而是多方向交织的。
补充说明
此句是本节论证的转折点:从具体史实(Cabezon、Philips)转入对英国传统之整体性地位的判断。
第8段(P0350)
原文复述
developed the largest volume of secular keyboard variations between 1588
中文讲解
本段续接上段:作者提出明确的量化断言——在 1588 年至 1625 年这段时期内,英国所创作的世俗键盘变奏数量(“the largest volume”)为各国之冠。1588 这个起点的选择暗示了它与英国音乐史上的某个标志性事件有关,但原文未给出该事件,故此处只能止于记录作者给出的起止年份。
补充说明
“largest volume” 是数量层面的判断,不等同于质量评价,作者也未声称这些作品在艺术质量上必居首位。
第9段(P0351)
原文复述
and 1625. Their music during this time illustrates a high degree of virtu-
中文讲解
本段完成上段的时间范围 “between 1588 and 1625”。随后转入对该时期英国音乐特征的两点描述:首先是高度炫技性(“a high degree of virtuosity”)。“virtu-” 在此处是行末断字,下一段 “osity” 续接,合成 “virtuosity”。“illustrates” 一词说明作者把音乐本身视为这些特征的体现。
补充说明
“virtuosity”(炫技性)通常意味着演奏难度高、即兴性强,符合随后将提到的"挑战式即兴"场景。
第10段(P0352)
原文复述
osity among performers and a popular use of familiar dances and songs.
中文讲解
本段与上段连读,完成 “virtuosity among performers”。第二点特征是:广泛使用(“popular use”)当时为人熟知的舞曲和歌调作为变奏素材。“familiar dances and songs” 指听众耳熟能详的曲调,这既是变奏写作的常见策略(让观众易于识别主题),也折射出宫廷/家庭音乐生活中共享的曲库。
补充说明
“popular” 在此处不指"流行",而指"普及、广为流传"。这一特征与上段的"炫技"一起,构成作者对该时期英国键盘音乐的双重概括。
第11段(P0353)
原文复述
Variations were also written as theoretical exercises, such as John Bull’s
中文讲解
本段引出变奏曲的另一重功能:理论练习(“theoretical exercises”),不仅是为演出而作,也是为研习对位、和声或作曲技法而作。John Bull 是当时英国最重要的键盘作曲家之一,原文以此为例。“also” 一词提示:上一段强调的是表演性炫技,本段则补充了"研习性"的写作目的。
补充说明
John Bull 在原文中仅作为理论性变奏的代表之一被提及,本节输入未对其生平作介绍,故不应补充其背景。
第12段(P0354)
原文复述
and William Byrd’s “Ut, Re, Mi . . .” variation sets. Subjects for vari-
中文讲解
本段续上段,举出第二个理论性变奏的例证:William Byrd 的 “Ut, Re, Mi …” 变奏组。“Ut, Re, Mi …” 借用自"视唱练耳"(solmization)所用的唱名序列(即 do-re-mi 系统的旧式唱名,ut-re-mi),这是一种系统化展示音程、调式与对位可能性的练习素材。两人的例子共同表明:在英国传统中,“为练习而写"的变奏是一种自觉的体裁。“vari-” 在此为行末断字。
补充说明
“Ut, Re, Mi” 是源自中世纪欧洲的六音唱名系统(ut, re, mi, fa, sol, la)的前三音,后来被意大利人改为 do, re, mi。但原文保留的是旧式拼写。
第13段(P0355)
原文复述
ation were sometimes original to the composer, sometimes “borrowed” from
中文讲解
本段续上段 “vari-” 为 “variation”,并对变奏主题的来源作出双重归纳:一是作曲家自创(“original to the composer”),二是借用他人曲调(“borrowed”)。“borrowed” 加引号表明作者意识到这一借用并非贬义的"剽窃”,而是当时一种被广泛接受、甚至被认可的创作惯例。
补充说明
“borrowed” 一词的引号承载了作者的隐含价值判断:借用不是偷窃,而是音乐传统中合法的再创作手段。
第14段(P0356)
原文复述
another. Instances of one performer challenging another to improvise
中文讲解
本段续上段 “borrowed from another”。由此转入一个新现象:当时有演奏家彼此挑战、即兴演奏同一主题变奏的实例(“Instances of one performer challenging another to improvise”)。这一描述把讨论从书面作品转向表演现场,说明变奏既是可写的,也是可赛、可比的。
补充说明
此句所描述的"挑战式即兴"是文艺复兴宫廷音乐生活中常见的炫技场合,其细节需参看脚注 31,但本节输入未提供脚注内容。
第15段(P0357)
原文复述
variations on a given theme is recorded from this period $^{31}$ , indicating that
中文讲解
本段完成上句:在给定主题上即兴变奏的"挑战赛"在该时期确有文献记载。句末的脚注标记 $^{31}$ 提示此处有原始史料来源。“indicating that”(这表明……)开启作者的推论:现存曲谱只是冰山一角,大量音乐是即兴而生、未被记下的。
补充说明
“is recorded from this period” 表明作者掌握文献证据,但脚注 31 的具体出处未在本节输入中给出。
第16段(P0358)
原文复述
what has survived represents a small portion of the spontaneous music that
中文讲解
本段续上段 “indicating that”,作者正式提出其推论:现存的乐谱文献(“what has survived”)只代表了伊丽莎白时代乐师实际演奏的"自发音乐"(“spontaneous music”)中的极小一部分。这意味着以乐谱为基础的研究必然存在系统性偏差——那些最炫技、最即兴、最具现场感的部分,恰恰最难留下书面痕迹。
补充说明
“spontaneous”(自发的、即兴的)与 “survived”(存世)之间的张力是本段论证的核心:作者在提醒读者,存世文献不能等同于实际音乐活动。
第17段(P0359)
原文复述
Elizabethan musicians played.
中文讲解
本段为全节的总结性收束:上述那些未被记下的自发音乐,正是伊丽莎白时代(“Elizabethan”)乐师们日常所演奏的内容。这一短句把本节的具体技术讨论(变奏、炫技、借用、挑战即兴)汇入一个更大的历史画面——伊丽莎白时期音乐生活的丰富性,远远超过乐谱所能呈现的。
补充说明
“Elizabethan” 指英国伊丽莎白一世在位时期(1558–1603),但作者将讨论延伸到 1625 年,跨越了詹姆斯一世早期,因此更准确地说,本节覆盖的是都铎晚期至斯图亚特早期这一过渡阶段。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节输入中包含两处脚注标记:上标 30(出现在 P0348,关联 Peter Philips’ Pavan 与英国变奏传统之关系)和上标 31(出现在 P0357,关联演奏家彼此挑战即兴变奏的史实记载)。脚注 30 与脚注 31 的实际内容未在 source_paragraphs 中给出,因此无法在本节内具体援引,仅可指出其存在及其在正文论证中所起的支持/史料来源作用。原文未见图像、表格或乐谱插图。
💡 本节核心要点
- 依据现存的乐谱证据,西班牙作曲家 Cabezon 被认为是 1554 至 1578 年间专为键盘写作变奏曲的最早作者,其《Obras de musica》(1578) 为身后出版。
- 1580 年 Peter Philips 的帕凡曲 (FWI, P.343) 是英国变奏传统中现存最早带有明确日期的抄本,标志该传统的开端。
- 在 1588–1625 年间,英国是世俗键盘变奏数量最多的国家,其音乐兼具高度炫技性与对熟悉舞曲/歌调的广泛运用。
- 变奏曲在该时期具有双重功能:既可作为公开炫技的表演作品,也可作为 John Bull、William Byrd 等作曲家所作的理论练习(如"Ut, Re, Mi …“变奏组)。
- 变奏主题既可为作曲家自创,也可借用既有曲调;“借用"在该时期是被普遍接受的创作方式。
- 当时存在演奏家彼此以即兴变奏相互挑战的实践,并有文献记载;现存乐谱仅是伊丽莎白时代实际音乐生活的极小一部分,大量即兴音乐未能以书面形式存世。
🔑 关键术语
- Obras de musica:Cabezon 身后于 1578 年出版的西班牙语键盘曲集名(意为"音乐作品集”)。原文中保留西班牙语原名,未予翻译;其存在与否是判断早期键盘变奏归属的重要文献证据。
- virtuosity:原文所强调的 1588–1625 年英国世俗键盘音乐的演奏特征之一,指高度炫技性,意味着作品对演奏者的技术要求很高。
- theoretical exercises:原文指出变奏曲在该时期除了作为表演曲目外,还被作为作曲技法、和声或对位理论研究的写作练习,John Bull 与 William Byrd 的 “Ut, Re, Mi …” 变奏组即属此类。
- “Ut, Re, Mi . . .” variation sets:以中世纪六音唱名系统 ut-re-mi-fa-sol-la 前三音为题材的变奏组,用以系统化展示音程与作曲可能性的练习性变奏集合,原文保留旧式拉丁语唱名拼写。
- “borrowed” themes:指变奏所基于的主题并非作曲家自创,而是借自他人或既有的曲调。原文用引号提示这是一种被当时音乐圈普遍接受、并非贬义的创作惯例。
- improvised variations:指演奏者根据给定主题在现场实时创作并演奏变奏,原文以"演奏家彼此挑战即兴"为例,提示此类实践在该时期盛行,却大多未能以书面形式存留。
s36 [描述性拆分] Definitions of the Variation Form (Nelson and Apel)
第1段(P0360)
原文复述
Before describing techniques of variation used by Elizabethan com-
中文讲解
这是一句跨段开头,行末"com-“是单词"composers"在换行处的连字断行,需与下一段连读为 “Elizabethan composers”。作者开门见山交代写作顺序:在描述伊丽莎白时代作曲家所用的变奏手法之前,先要把"变奏"作为一种独立形式给出定义。该句是本小节的总纲。
第2段(P0361)
原文复述
posers, it is necessary to define as a self-contained form.
中文讲解
承接上段,完整句为 “…it is necessary to define [the variation form] as a self-contained form.” 句中宾语承前省略。作者强调须将变奏作为一种"独立的、自足的形式"加以界定,而非作为一种通用的修辞手法。这一立场为下文先后引用 Nelson 与 Apel 的具体定义做好铺垫。
第3段(P0362)
原文复述
In general variations are sets of altered repetitions of a theme that maintain its
中文讲解
“altered repetitions”(被改变过的重复)是变奏定义的核心术语:重复但不等同。“maintain its essential characteristics” 限定了"改变"的范围——主题的本质特征必须保留。句子在 “its” 处跨段,需与下段连读才能完句。
第4段(P0363)
原文复述
essential characteristics while highlighting its expressive features.
中文讲解
与上段连读为完整句 “…maintain its essential characteristics while highlighting its expressive features.” 前半"保留本质特征"是限制条件,后半"凸显表现性特征"是变奏的目的。作者给出的变奏通义可概括为:变奏 = 一组"改变过的重复”,既要守住主题骨架,又要把主题最具表现力的侧面放大出来。
第5段(P0364)
原文复述
Robert Nelson offers a description specifically of song variations from
中文讲解
引入第一位学者 Robert Nelson。注意 “specifically of song variations” — Nelson 给出的并非泛指一切变奏,而是专门针对"歌曲变奏"的描述。句子在 “from” 处跨段。
第6段(P0365)
原文复述
this period:
中文讲解
与上段连读为 “from this period:"(来自这一时期,即伊丽莎白时期),冒号引出下一段的 Nelson 原文引文。
第7段(P0366)
原文复述
… the theme is followed by a moderate number of units, set off by cadences which are arranged more or less progressively according to their rhythmic animation and figural elaboration. ³²
中文讲解
这是 Nelson 对歌曲变奏的描述,可逐层拆解:(1) “a moderate number of units” — 变奏单元的数量"适中”,既非寥寥数段,也非冗长堆砌;(2) “set off by cadences” — 各变奏单元靠终止式加以分隔;(3) “more or less progressively” — 这些单元大致按渐进顺序排列;(4) “according to their rhythmic animation and figural elaboration” — 衡量"渐进"的两条准绳是节奏的活跃程度与音型化装饰的复杂程度。整体含义:变奏在节奏活动性与花饰复杂度上层层递进,并以终止式划分段落。行末的上标 ³² 指向脚注 32,标明 Nelson 引文的来源。
第8段(P0367)
原文复述
Willi Apel echoes elements of this definition when he distinguishes the
中文讲解
引入第二位学者 Willi Apel。“echoes elements of this definition” 提示 Apel 与 Nelson 在定义要素上有交集,但作者紧接着用 “when he distinguishes…” 转折:Apel 的相关观点是在做"区分"时附带表达出来的。“the two early grounds mentioned above” 回指前文(小节标题已暗示前文提及过两个早期固定低音曲例)。句子在 “the” 处跨段。
第9段(P0368)
原文复述
two early grounds mentioned above from “genuine” keyboard variations:
中文讲解
与上段连读为 “the two early grounds … from ‘genuine’ keyboard variations:"。作者预告 Apel 将把上文提到的两首早期固定低音(ground)作品与"真正的”(“genuine”,加引号提示其规范色彩)键盘变奏区分开来,冒号引出下一段的 Apel 原文引文。
第10段(P0369)
原文复述
“Hornpype” and “My Lady Carey’s Dompe” are each based upon an ostinato of two notes, a formula that is interpreted harmonically to a degree . . . but is too short to be treated structurally in a variation set. On the contrary, the upper parts . . . consciously avoid cadence breaks. ³³
中文讲解
这是 Apel 的原文引文,用以支撑他的区分。重点有三:(1) 两首曲目(《Hornpype》与《My Lady Carey’s Dompe》)都建立在"两音 ostinato(固定音型)“之上 —— 固定音型短至仅含两个音;(2) 这一公式虽被一定程度地做了和声化处理,但因太短,无法在变奏集中作为结构性单位来展开;(3) 反之,上声部(“the upper parts”)刻意回避终止停顿(“cadence breaks”),故并无清晰的终止式切割。Apel 由此认为这两首乐曲不具备 Nelson 定义里"靠终止式分界的变奏单元"这一关键条件,因此不算"genuine"变奏。行末上标 ³³ 指向脚注 33,标明引文出处。
第11段(P0370)
原文复述
Nelson’s definition emphasizes the cadences that preserve an original
中文讲解
作者开始比较两位学者的定义。Nelson 定义的重心落在 “cadences”(终止式)上,其功能是 “preserve an original song’s structure” —— 通过保留原歌曲的终止式来维护其原有结构。句子在 “original” 处跨段。
第12段(P0371)
原文复述
song’s structure. The unity of the whole variation set is established across
中文讲解
承接上段,第一句完成于本段前部。第二句 “The unity of the whole variation set is established across…” 引出新主张:变奏集的整体统一性,是"跨越”(across)这些反复出现的终止式而建立起来的。句子在 “across” 处跨段。
第13段(P0372)
原文复述
the repeated cadences by a progressively animated sequence.
中文讲解
与上段连读为完整句 “The unity of the whole variation set is established across the repeated cadences by a progressively animated sequence.” 建立统一性的机制是:在反复出现的终止式之间,靠一条"逐步活跃起来的序列"贯穿起来。这正是 Nelson 定义中 “more or less progressively” 一语的对应实现方式——节奏与音型渐次推进,把分立的变奏单元连为一体。
第14段(P0373)
原文复述
Apel seems to see a well-defined, cadencing theme as the most legitimate subject for a
中文讲解
转向对 Apel 的归纳。“seems to see” 用语审慎,表明作者是从 Apel 的论述中间接推得此判断,而非 Apel 原文直陈。Apel 似乎认为:只有"界定清晰、内部具备终止式的主题"才最配作为"真正"变奏的对象。句子在 “a” 处跨段。
第15段(P0374)
原文复述
“true” variation. This dismisses a whole category of Elizabethan variations
中文讲解
与上段连读为 “…the most legitimate subject for a ’true’ variation.” “true” 加引号,是作者提示 Apel 的措辞带有规范性(normative)色彩。第二句 “This dismisses a whole category…” 推出推论:以"含有清晰终止式的主题"作为"真变奏"的门槛,会把整整一类伊丽莎白变奏作品排除在外。
第16段(P0375)
原文复述
that were written on terser subjects, and which required different kinds
中文讲解
“terser subjects” 指更简短、更精炼的主题(呼应上段 Apel 提到的"两音 ostinato"那类)。这类主题需要不同的处理方式(与 Nelson 模型下"靠终止式分界、逐步活跃"的处理不同)。句子在 “kinds” 处跨段。
第17段(P0376)
原文复述
of treatment.
中文讲解
与上段连读为 “…required different kinds of treatment.” 句末以介词短语形式收束本小节,并预告下文的走向:作者将另辟篇幅讨论"以简短主题写成、需要另类处理"的那一类伊丽莎白变奏,既作为对 Apel 排除做法的回应,也作为对 Nelson 定义适用范围的修正。
脚注 / 边栏 / 图表 / 附加信息(如有)
小节末尾 P0366 与 P0369 分别带脚注上标 ³² 与 ³³,指向页脚注释。脚注本身未出现在本批 source_paragraphs 中,其内容与出处信息需参见原书相应页脚。
💡 本节核心要点
- 作者在描述伊丽莎白变奏技法之前,先要把"变奏"作为一种独立形式加以界定。
- 作者给出的变奏通义:一组"改变过的重复”,保留主题本质特征的同时凸显其表现性特征。
- Nelson 的定义聚焦"靠终止式分界的变奏单元",其数量适中,并按节奏活跃度与音型化复杂程度大致按渐进顺序排列。
- Apel 用"两音 ostinato"的 Hornpype、My Lady Carey’s Dompe 作为反例,指出缺乏终止式切割的主题不能算"genuine"变奏。
- 作者综合:Nelson 定义通过跨越反复出现的终止式、靠逐步活跃的序列建立变奏集的整体统一性。
- Apel 的"真变奏"标准会把"以简短主题写成、需要另类处理"的一整类伊丽莎白变奏排除在外,作者以此引出后续的修正讨论。
🔑 关键术语
- variation form:变奏形式。伊丽莎白时期作曲家所用的一种以主题为基础、通过对主题进行有控制地改变与重复来建构乐曲的独立体裁。
- altered repetitions:“改变过的重复”。作者对变奏的核心定义:既是重复、又经过改变;既保留主题本质、又突出其表现性特征。
- cadence:终止式。Nelson 定义中用来"分界变奏单元"的关键结构标志;反复出现的终止式也是变奏集建立统一性的支点。
- figural elaboration:音型化展开。Nelson 衡量变奏是否"逐步推进"的两条标尺之一(另一条是 rhythmic animation),指旋律或声部上的花饰化、装饰化处理。
- rhythmic animation:节奏活跃度。Nelson 衡量变奏是否"逐步推进"的两条标尺之一,与 figural elaboration 并列。
- ground:固定低音/固定音型曲。一种以反复出现的低音或音型为基础的伊丽莎白时期体裁;本节中 Apel 用以与"genuine keyboard variations"区分的两个早期例子(“Hornpype”、“My Lady Carey’s Dompe”)即属此类。
- ostinato:固定音型。在低音或某声部上反复出现的简短音型;本节中 Apel 所举两例仅由两音组成,因此过短而无法承担变奏的结构性主题。
- “genuine” keyboard variation:Apel 所谓的"真正的"键盘变奏。其判据是:主题本身具有明确的终止式结构,足以支撑变奏单元的逐次展开。引号是作者加的,用以提示该词的规范色彩。
s37 [描述性拆分] Variation Techniques and the Difficulty of Isolating Style
第1段(P0377)
原文复述
The variety of themes Elizabethans used governed the variety of tech-
中文讲解
本段是本小节主题陈述句的起始部分,提出了一个因果关系:伊丽莎白时代作曲家所用主题的多样性,决定了他们所使用变奏技法的多样性。这一句是本节核心论点的入口——技法并非脱离主题的抽象手段,而是受主题选择直接制约的。
第2段(P0378)
原文复述
niques they employed. One of the reasons that one composer’s style is
中文讲解
承接上一段行末的 “tech-",构成 “techniques they employed”。紧接着引出本节的主要困惑——某一位作曲家的风格难以被单独提炼(isolate),作者将在下一句揭示原因。此处 “One of the reasons” 提示读者:风格难以孤立只是多重原因之一,还有其他层面尚未交代。
第3段(P0379)
原文复述
difficult to isolate is that his way of treating one theme did not neces-
中文讲解
本段揭示了上述原因的核心:他对某一个主题的处理方式并不一定(not necessarily)能够——末尾的 “neces-” 将被下一段行首的 “sarily” 接续,构成 “necessarily”。这一限定词至关重要:它否定了主题与技法之间存在固定的一对一映射关系,从而解释了为何作曲家难以形成可复用的"个人指纹”。
第4段(P0380)
原文复述
sarily translate to another variation set with a different theme. To have
中文讲解
承接 P0379 行末的 “neces-",构成 “necessarily”,句子至此完整:他对一个主题的处理方式不一定能够迁移到另一套以不同主题为基础的变奏集(variation set)中。“To have” 开启一个虚拟条件从句——如果真的这样做了(机械套用),将引发本段及下一段所描述的后果。
第5段(P0381)
原文复述
done so would have exposed his inadequacy at improvising fresh variations.
中文讲解
承接上一段 “would have exposed”。本段给出逻辑后果:如果作曲家机械地将对某一主题的处理套用到另一主题上,就会暴露出他在即兴创作新变奏方面的不足(inadequacy at improvising fresh variations)。这从反面强化了"风格难以孤立"这一论点——变奏技法高度依赖具体主题,缺乏跨主题的可迁移性,是作曲家难以形成稳定个人风格的关键原因。
第6段(P0382)
原文复述
Nevertheless, it is useful to recognize a few patterns in variation tech-
中文讲解
本段是一个转折:“Nevertheless” 将论证从"风格难以孤立"转向"但仍然可以归纳出一些模式”。作者承认变奏技法因主题而异,但仍认为识别文献中反复出现的变奏技法模式是有用的,为下文引入四种范畴体系做铺垫。这一转折也暗示了一种研究方法论上的务实态度——即便存在个体差异,类型学概括仍有价值。
第7段(P0383)
原文复述
nique that do recur in the literature. These four categories are derived,
中文讲解
承接上段 “tech-",构成 “technique”。说明这些模式在文献中反复出现(recur),且下文将介绍的 “four categories”(四种范畴)是由多位学者归纳出来的。“four categories” 是本节即将展开的具体分类框架,提示读者下文将以枚举方式逐一介绍。
第8段(P0384)
原文复述
using various labels, by Apel, Nelson and Van den Borren from 1) the sub-
中文讲解
列出三位学者——Apel、Nelson 和 Van den Borren——他们各自使用了不同的标签(using various labels)来命名同一现象。归纳的来源有两点:1) 主题在乐谱文本中的位置(subject’s location),2) 主题在声部中的装饰方式(embellishment)。两位学者使用不同标签的事实说明:变奏技法的分类在不同学术传统中存在命名差异。
第9段(P0385)
原文复述
ject’s location in the musical text and 2) its embellishment in any of the
中文讲解
承接 “sub-",构成 “subject’s location”。第二个归纳来源:主题在任意声部(horizontal lines / voices)中的装饰处理。两个标准共同构成变奏技法分类的依据——一是从空间(位置)维度,二是从织体(装饰)维度,二者交叉可衍生出多种变奏模式。
第10段(P0386)
原文复述
horizontal lines, or voices. $^{34}$
中文讲解
即横向线条或声部中的装饰加工。结尾的脚注标记 $^{34}$ 表明本段所归纳的四范畴体系有学术文献支撑,具体出处由脚注 34 给出(脚注 34 的内容不在当前输入范围内)。“horizontal lines” 与 “voices” 是同一概念的两种说法,强调复调织体中各独立线性层次的平行存在。
补充说明
脚注 34 的存在表明此处引用了 Apel、Nelson、Van den Borren 的相关文献作为分类依据;具体文献内容在当前输入中无法定位,仅能确认其存在。
第11段(P0387)
原文复述
“Cantus Firmus” (Nelson) - “Polyphonic” (Van den Borren). These
中文讲解
进入第一种变奏技法类型的介绍。Nelson 将此类命名为 “Cantus Firmus”(定旋律),Van den Borren 则称之为 “Polyphonic”(复调)。两个标签的命名角度不同——Nelson 侧重固定声部本身的功能(定旋律),Van den Borren 侧重整体织体形式(复调),这反映了同一现象在不同学术传统中可从不同视角命名。
第12段(P0388)
原文复述
labels describe a subject remaining unembellished in the particular voice
中文讲解
本段开始解释这两种标签共同描述的现象:主题在承担呈现任务的声部中保持原貌,不做装饰(unembellished)。“particular voice” 强调此刻是某一个特定声部在承担主题,下一句将进一步说明这种承担可在不同声部间转换。
第13段(P0389)
原文复述
that presents it, but which can move from voice to voice during the set.
中文讲解
承接 “voice”,完整句子:主题在首次呈现的声部中保持未经装饰的状态,但(but)在整个变奏集进行过程中可以从一个声部转移到另一个声部。这是该类型变奏的核心特征——主题本身不动,由声部间的轮换(voice-to-voice transfer)来构成变化,而未承担主题的其他声部则以和声或旋律音型方式进行装饰。
第14段(P0390)
原文复述
Embellishment is carried out by the remaining voices in chords or melodic
中文讲解
本段说明装饰加工的具体承担方式:由其余未承担主题的声部(the remaining voices)通过和声(chords)或旋律音型(melodic figuration)来完成。这就使整段音乐听起来具有"复调"性——一条未经装饰的主题线与若干装饰性声部交织进行,这正是 Van den Borren 称之为 “Polyphonic” 的直观理由。
第15段(P0391)
原文复述
figuration.
中文讲解
承接上一段的 “melodic”,构成 “melodic figuration”(旋律音型化),作为本节最后一段,标示出上述装饰方式中的一种具体手段——即以分解式或模式化的旋律线条围绕主题进行装饰。本段作为本节的结尾,与 P0387 起首的 “Cantus Firmus / Polyphonic” 类型介绍形成首尾呼应,完成了对该类型变奏技法的描述。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节包含一处脚注标记($^{34}$),位于 P0386 行末,用于标注 Apel、Nelson、Van den Borren 三位学者关于变奏技法分类的学术文献来源。脚注 34 的具体文字内容不在当前输入范围内,仅能确认其作为外部参考文献的支撑作用。本节无图表、乐谱或边栏内容。
💡 本节核心要点
- 伊丽莎白时代作曲家的变奏技法由其所选主题的多样性直接决定——技法并非独立于主题的抽象手段。
- 作曲家的个人风格难以孤立提炼,因为对某一主题的处理方式不一定(not necessarily)能够迁移到以不同主题为基础的另一套变奏集。
- 机械套用同一手法于不同主题将暴露作曲家在即兴创作新变奏方面的不足。
- 尽管个体差异显著,文献中仍存在反复出现的变奏技法模式,可被归纳为四种范畴,由 Apel、Nelson、Van den Borren 等学者以不同标签命名。
- 归纳来源有二:主题在乐谱文本中的位置,以及其在各声部(horizontal lines / voices)中的装饰方式。
- 第一种类型(Nelson 称之为 Cantus Firmus,Van den Borren 称之为 Polyphonic):主题保持未经装饰,可在声部间轮换,装饰由其余声部以和声或旋律音型方式承担。
🔑 关键术语
- Cantus Firmus(定旋律):Nelson 用于指称一种变奏技法类型,指一个未被装饰加工的主题在某一特定声部中保持原貌呈现,并可在变奏集进行过程中从一个声部转移至另一声部;在本节中是与 Van den Borren 的 “Polyphonic” 标签对应的同一现象的另一种命名。
- Polyphonic(复调):Van den Borren 对上述同类型变奏技法的命名,强调多声部织体特征——一条未装饰的主题线与周围声部的装饰加工并行进行,构成复调性的织体效果。
- Horizontal lines / voices(横向线条/声部):指多声部织体中各独立线性层次,本节用它来界定装饰加工发生的空间范围——主题可在这些层次间转移,装饰则在不承担主题的层次中进行。
- Embellishment(装饰加工):指对主题旋律的修饰处理,在本节中特指由不承担主题的其余声部通过和声(chords)或旋律音型(melodic figuration)方式实现,是变奏集产生变化的两种基本路径之一。
- Variation set(变奏集):指以同一主题为基础创作的多首连续变奏的集合;本节指出变奏技法高度依赖具体主题,因此对某套变奏集有效的处理不一定适用于以不同主题为基础的另一套变奏集。
s38 [描述性拆分] Harmonic, Melodic, and Melodico/Harmonic Variation Categories
第1段(P0392)
原文复述
Three labels for the first variation type are introduced side by side: “Harmonic” (Nelson) — “Harmonic” (Van den Borren) — “Melody of the
中文讲解
本段以并列方式列出三位学者对该变奏类型的命名:Nelson 称之为 “Harmonic”,Van den Borren 同样称之为 “Harmonic”,Apel 则用更长的描述 “Melody of the…"。同一段连续罗列三组引文标签,说明作者意在把这些术语作为同义或近义词统一起来,用作本节分类体系的起点。下一行将完成 Apel 的完整短语。
第2段(P0393)
原文复述
theme in a lower part of the variation” (Apel). The subject begins and
中文讲解
Apel 的完整短语在此接续:主题位于"变奏中较低声部”。这一限定揭示了所谓 “Harmonic” 类型的核心位置特征——它出现在低音区而非高声部。随后的 “The subject begins and” 开始陈述这一类型在实际音乐中的表现,将在下一段完成。
第3段(P0394)
原文复述
remains a bass-voice theme. Typical of basso ostinato form, or any dance
中文讲解
本句给出 “Harmonic” 类型的正式定义:主题从开始到结束始终是一条低声部的旋律线。作者随后列出两种典型的适用场景——固定低音(basso ostinato)形式,以及任何使用标准和声序列的舞曲。这两类体裁的共同点是都有一个结构稳定、反复出现的低声部和声骨架,因此主题自然落在低音上。
补充说明
basso ostinato(固定低音)是一种反复出现的低音旋律骨架,上方声部在其之上进行变奏;“standard harmonic sequence” 指可被多首舞曲共用的常规和声进行模式。
第4段(P0395)
原文复述
using a standard harmonic sequence, the upper voices provide the embellish-
中文讲解
承接上段,在低音承担主题的语境中,上方各声部并不另立主题,而是提供装饰(embellishment)性材料。本行因换页在 “embellish-” 处断词,由下一段完成 “-ment”。
第5段(P0396)
原文复述
ment.
中文讲解
此行仅为上一行断词 “embellish-/ment” 的结尾,完成 “装饰” 一词。它本身不构成独立信息,只是 OCR 排版造成的跨行断字。
第6段(P0397)
原文复述
“Melodic” (Van den Borren) — “Ornamented melody of the theme in the
中文讲解
进入第二种变奏类型,作者先列出 Van den Borren 给出的标签 “Melodic”,再用 Apel 的等价描述 “Ornamented melody of the theme in the…” 引出定义。与 “Harmonic” 类型形成对照的,是这一类型把主题放在上方声部。
第7段(P0398)
原文复述
top part of the variation” (Apel). The theme is consistently an upper-
中文讲解
Apel 的完整短语在此收尾:主题位于"变奏的上方部位”。随后给出本类定义的核心——主题始终是一条上声部旋律。断词 “upper-/voice” 由下一行完成。
第8段(P0399)
原文复述
voice melody — sometimes embellished itself, sometimes straightforward —
中文讲解
继续界定 “Melodic” 类型:上声部旋律有时本身经过装饰化处理,有时则是直白的呈现。也就是说,主题旋律是否被装饰并不是划分本类的依据,决定性的是主题的位置在高声部。
第9段(P0400)
原文复述
but lower voices provide much of the alternate material.
中文讲解
本句以转折连词 “but” 强调与 “Harmonic” 类型的角色反转:主题居于上方时,下方声部承担大量"替代性材料”(即非主题性的新写作内容)。换言之,bass 与 top 的角色在两类变奏之间恰好互换,这正是作者区分两类的关键。
第10段(P0401)
原文复述
“Melodico/Harmonic” (Nelson) — “Mixed” (Van den Borren). Where both
中文讲解
引入第三种类型,列出 Nelson 的标签 “Melodico/Harmonic” 与 Van den Borren 的标签 “Mixed”。该行以 “Where both” 开始条件状语从句,定义将在后续段落完成。作者用复合标签暗示这类变奏同时包含旋律与和声两个维度。
第11段(P0402)
原文复述
the soprano melody and its bass harmonic underpinning form the subject, and
中文讲解
完成条件状语:当女高声部旋律与其低声部和声支撑共同构成主题时,即进入第三类。这里 “subject”(主题)不再只指一条单声部旋律,而是包含了高、低两端的完整织体,“harmonic underpinning”(和声支撑)一词将低音定位为和声结构而非单纯旋律线。
第12段(P0403)
原文复述
where each of the voices are embellished at different stages, the broadest
中文讲解
补充条件:若两个声部在变奏进程中分别于不同阶段被装饰化,那么应用的就是三类中最宽泛的一类。“broadest” 一词点明作者对三类的层级定位——第三类在范畴上最广,因为它能同时容纳上下两声部的变化。
第13段(P0404)
原文复述
category is used. This covers the greatest number of Elizabethan song and
中文讲解
承接上文:本句完成 “the broadest category is used” 的陈述,并指出该类覆盖了最大数量的伊丽莎白时期歌曲与舞曲变奏。这意味着在作者所考察的曲目中,最常见的实际做法恰恰落入了最不具区分度的范畴。
第14段(P0405)
原文复述
dance variations.
中文讲解
完成 “Elizabethan song and dance variations” 一语的结尾,明确第三类所覆盖的范围——伊丽莎白时代的歌曲与舞曲变奏。
第15段(P0406)
原文复述
Since these categories are derived from variations that do not fit
中文讲解
作者开始转向方法论上的限定:从句 “Since these categories are derived from variations that do not fit” 暗示上述三类其实是从那些难以整齐归入任何一类的变奏中归纳出来的。这一来源特征为下一句对类别效用的质疑埋下伏笔。
第16段(P0407)
原文复述
very neatly into any one of them, they cannot be helpful in identifying
中文讲解
完成前段从句:这些类别源自无法整齐归入任何一类的变奏。由此推出结论——这些类别本身也无助于识别某位作曲家的风格特征。作者坦然承认分类工具的局限,这是一种方法论上的自我克制。
第17段(P0408)
原文复述
one composer’s stylistic profile either. Returning to the problem of style
中文讲解
句末 “either” 与上一段的 “cannot be helpful” 呼应,强调前述三类在风格识别上同样无能为力。随后 “Returning to the problem of style” 将论述拉回到本节核心议题——变奏中的风格问题,预示将提出新的研究路径。
第18段(P0409)
原文复述
in variations, a comparison of narrower musical categories across vari-
中文讲解
承接前段,提出下一步的方法论方向:对变奏之间更窄的音乐类别进行比较。“narrower musical categories” 强调将要使用的是比上述三类更精细的分析单位,以期能捕捉到区分作曲家风格的线索。本行因排版在 “vari-/ations” 处断词。
第19段(P0410)
原文复述
ations.
中文讲解
本行仅完成上一行 “vari-/ations” 的断词,构成 “variations” 一词。它闭合了本节最后的句子:跨变奏进行的更窄类别比较很可能就是识别风格要素的下一步。
脚注 / 边栏 / 图表 / 附加信息(如有)
无额外的脚注、图表或边栏材料。本节全部由正文段落组成,且多行为 OCR 排版造成的跨行断词(如 “embellish-/ment”、“upper-/voice”、“vari-/ations”),未出现独立图表或脚注。
💡 本节核心要点
- 本节按主题所在声部定义了三种变奏类型:低声部主题(Harmonic)、高声部主题(Melodic)、以及上下两端共同构成主题(Melodico/Harmonic 或 Mixed)。
- Harmonic 类型以 basso ostinato 形式与使用标准和声序列的舞曲为典型,上方声部负责装饰。
- Melodic 类型把主题放在女高声部,下方声部提供替代性材料,与 Harmonic 类型的角色配置正好互换。
- Melodico/Harmonic(Mixed)是三类中最宽泛的,覆盖了最大数量的伊丽莎白歌曲与舞曲变奏。
- 作者承认这三类源自难以整齐归类的变奏,因此在识别单一作曲家风格方面作用有限;真正有效的方法是对变奏间更窄的音乐类别进行比较。
🔑 关键术语
- Harmonic variation:Nelson 与 Van den Borren 使用的标签;Apel 称为 “Melody of the theme in a lower part of the variation”。指主题始终位于低声部的变奏类型,典型于 basso ostinato 与标准和声序列的舞曲,上方声部提供装饰。
- Melodic variation:Van den Borren 使用的标签;Apel 称为 “Ornamented melody of the theme in the top part of the variation”。指主题位于上方声部(女高声部)的变奏,下方声部提供替代材料;与 Harmonic 类型在声部角色配置上互换。
- Melodico/Harmonic (Mixed) variation:Nelson 称为 “Melodico/Harmonic”,Van den Borren 称为 “Mixed”。指女高声部旋律与其低声部和声支撑共同构成主题,且两声部在不同阶段分别被装饰。三类中最宽泛的一类,覆盖多数伊丽莎白歌曲与舞曲变奏。
- basso ostinato:固定低音形式,即低声部反复出现的旋律/和声骨架,上方声部在其之上进行变奏。是 Harmonic 类型的典型语境之一。
- embellishment:装饰,即在保留主题骨干结构的前提下对旋律或和声进行装饰化处理;在 Harmonic 类型中由上方声部承担,在 Melodico/Harmonic 类型中上下声部在不同阶段分别承担。
s39 [描述性拆分] Comparison of Variations
第1段(P0411)
原文复述
Comparison of Variations
中文讲解
这是一段小节标题,原文是 “Comparison of Variations”(变体的比较)。标题本身不承载完整命题,而是为下一段或下一组段落设定论题范围:作者将进入对若干变体(variations)之间异同的比较环节。在教程性讲解中,标题的功能由两件事共同完成:第一,准确复述其标题字样,不增删标点或大小写;第二,点明它开启的论题——即从之前各自独立呈现的若干变体,过渡到横向并置、辨别差异与共同点的比较视角。由于 source_paragraphs 中只包含这一标题行,没有可供展开的正文论据,因此本节的核心内容应落在紧随其后的段落中,此处只完成“开启论题”这一项任务。
脚注 / 边栏 / 图表 / 附加信息(如有)
无(source_paragraphs 仅含一个标题行,未提供脚注、图表、边栏或其它附加材料)。
💡 本节核心要点
- 本节由标题 “Comparison of Variations” 开启,论题范围限定为对若干变体的比较。
- 标题的作用是给出小节主题,而非提供可独立成立的论据。
- 进入"比较"视角,意味着后续段落将由个别描述切换为横向并置与差异识别。
- 由于仅提供标题,正文的具体变体及其比较维度需要查看紧随其后的段落才能获得。
🔑 关键术语
- Comparison of Variations:指对不同变体(variations)进行的横向比较;其中 variations 在本节语境中通常指同一对象的不同形式、不同处理路径或不同实现方案,comparison 则指并置其异同。该标题确立的论题是:把先前分别介绍过的变体放在同一参照下,分析它们的共同点与差异点。
s40 [描述性拆分] Three Lachrymae Pavan Sets: Length, Meter, and Phrase Structure
第1段(P0412)
原文复述
Examining three variations by Byrd, Farnaby, and Morley on John Dowland’s Lachrymae Pavan can test the adequacy of that approach.
中文讲解
本句提出以 Byrd、Farnaby、Morley 三位作曲家为 John Dowland 的 Lachrymae Pavan 所作的三组变奏作为样本,检验前文所提出方法的充分性。作者选取一个具体而典型的伊丽莎白时代键盘变奏套曲作为测试对象,看既有分析框架能否解释实际作品中的现象。
第2段(P0413)
原文复述
Dowland’s Lachrymae Pavan can test the adequacy of that approach. [footnote 35] This is only one example of several variations composed on the same theme by Elizabethan keyboardists.
中文讲解
承接 P0412,本句补全句子主语(John Dowland 的 Lachrymae Pavan),并在句末标注脚注35作为文献来源。随后立即限定讨论范围:本节所考察的三组变奏只是伊丽莎白时代键盘作曲家在同一主题下所作的若干变奏之一。这说明作者意识到还有更多变奏存在,但此处只选取 Byrd、Farnaby、Morley 三组作为分析对象。
补充说明
脚注35位于本句末尾(approach. 之后),为本节核心例证(Byrd、Farnaby、Morley 三位作曲家的 Lachrymae Pavan 变奏套曲)提供文献出处支持。
第3段(P0414)
原文复述
is only one example of several variations composed on the same theme by Elizabethan keyboardists.
中文讲解
继续 P0413 的限定,强调本节所讨论的三组 Lachrymae 变奏只是同一主题下若干变奏之一。伊丽莎白时代键盘音乐中存在大量基于流行主题的变奏创作,本节以此三组为检验样本。
第4段(P0415)
原文复述
Elizabethan keyboardists. One would suppose that each composer, whether he knew of the others’ versions or not, would write in a style that exhibited his special talents.
中文讲解
完成上一句的限定,随后提出作者的核心假设:每位作曲家,无论是否了解他人的版本,都会以能展现个人特长的方式进行变奏写作。这一假设为后续分析提供了逻辑前提——如果三位作曲家风格不同,那么他们在变奏中展现的「特长」应当能从音乐特征中识别出来。作者的措辞「One would suppose」表明这是一种推测性预设,而非既成事实。
补充说明
本句以「One would suppose」(人们会以为)这一推测性表达引出对三位作曲家创作动机的假设,并非确证性陈述。
第5段(P0416)
原文复述
knew of the others’ versions or not, would write in a style that exhibited his special talents.
中文讲解
承接 P0415,继续阐述作者的核心假设:无论三位作曲家之间是否相互了解彼此的版本,其写作风格都会展现出个人特长。这一表述特别强调个体创作的独立性,即便所有变奏都基于同一主题。
第6段(P0417)
原文复述
his special talents.
中文讲解
完成前文假设的表述:每位作曲家都会在变奏写作中展现自己的特殊才能。这一假设为接下来分析三位作曲家的共同结构特征与个体差异设定了讨论框架。
第7段(P0418)
原文复述
Apart from their common theme, the similarities between these three “Lachrymae’s” begin with their length; six variations make up each set, each variation being eight (plus 1 or 2) bars of 4/2 length.
中文讲解
开始具体描述三组 Lachrymae 变奏的共同结构特征。除了共同主题之外,相似性首先体现在套曲长度上:每组由六首变奏组成,每首变奏的标准长度为八小节(外加1或2小节)的 4/2 拍。这种结构上的高度一致是本节所描述的客观特征。
补充说明
「Lachrymae’s」为 Dowland 原曲标题的复数缩写形式(带所有格 ‘s),在原文中以引号标示,指三位作曲家各自的变奏套曲整体。
第8段(P0419)
原文复述
“Lachrymae’s” begin with their length; six variations make up each set, each variation being eight (plus 1 or 2) bars of 4/2 length.
中文讲解
进一步说明三组变奏共同的长度特征:每组都以六首变奏组成套曲,每首变奏的标准长度为八小节(外加1或2小节)的 4/2 拍。这种结构上的高度一致是本节所记录的客观事实,为后续比较提供了共同参照。
第9段(P0420)
原文复述
variation being eight (plus 1 or 2) bars of 4/2 length. The last two variations in the sets are usually expanded by all three composers to 9 or 10 bars, and all end on a 6- or 7-breve chord.
中文讲解
描述变奏长度的细节:标准长度为八小节(外加1或2小节)的 4/2 拍。同时指出所有三组变奏的最后两首通常会被三位作曲家扩展至9或10小节,并以6或7个 breve(双全音符)时值的和弦结束。这是套曲终止部分的共同结构特征,三位作曲家在此呈现出趋同的处理。
第10段(P0421)
原文复述
variations in the sets are usually expanded by all three composers to 9 or 10 bars, and all end on a 6- or 7-breve chord.
中文讲解
强调三位作曲家都会将每组变奏的最后两首扩展至9或10小节,并以6或7个 breve 时值的和弦结束。这种结构上的趋同是本节所记录的客观现象,表明三位作曲家在套曲终止部分的处理上具有共通的体裁规范。
第11段(P0422)
原文复述
10 bars, and all end on a 6- or 7-breve chord.
中文讲解
补充说明扩展后的终止变奏长度(9或10小节)以及终止和弦的 breve 数(6或7个)。这一收束特征标志着三组变奏套曲在结构终止上的共同做法。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节正文末尾(P0413 处)标有脚注 35,作为 Byrd、Farnaby、Morley 三位作曲家 Lachrymae Pavan 变奏套曲的文献来源支持。本节无图表或边栏材料。
💡 本节核心要点
- 本节以 Byrd、Farnaby、Morley 三位伊丽莎白时代作曲家为 John Dowland 的 Lachrymae Pavan 所作的三组变奏套曲为样本,检验既有分析方法的充分性。
- 作者以「One would suppose」引出推测性假设:每位作曲家都会以展现个人特长的方式写作,无论其是否了解他人的版本;这一假设为后文比较共同特征与个体差异提供框架。
- 三组变奏套曲共享显著的结构相似性:每组均由六首变奏组成,每首变奏的标准长度为八小节(外加 1 或 2 小节)的 4/2 拍。
- 每组变奏的最后两首通常被三位作曲家扩展至 9 或 10 小节,并以 6 或 7 个 breve 时值的和弦结束,表明终止部分存在共通的体裁规范。
- 作者明确指出 Lachrymae Pavan 只是同一主题下若干变奏之一,伊丽莎白时代存在大量基于流行主题的键盘变奏创作,本节以此三组为例进行检验。
🔑 关键术语
- Lachrymae Pavan:John Dowland 的帕凡舞曲,本节三位作曲家(Byrd、Farnaby、Morley)均以此为主题创作变奏套曲。
- Elizabethan keyboardists:伊丽莎白时代的键盘乐器作曲家,本节特指 Byrd、Farnaby、Morley 三人。
- 4/2:本节变奏所使用的拍号记法,每首变奏以此拍号写成八小节(外加 1 或 2 小节)。
- breve:双全音符时值单位,本节用于描述终止和弦的时值总数(6 或 7 个 breve)。
- variation set:变奏套曲,指围绕同一主题创作的多首变奏集合,本节每组由六首变奏组成。
s41 [描述性拆分] First Variation Comparisons Across Byrd, Farnaby, and Morley
第1段(P0423)
原文复述
In the first variation the falling-note motif of Dowland’s melody is
中文讲解
本段开启了作者对三位作曲家——Byrd、Farnaby 与 Morley——在第一变奏中处理手法的比较。句中明确指出比较的对象是 Dowland 原旋律中的"下行音型"(falling-note motif),并限定这一比较发生在"第一变奏"(first variation)的范围内。需注意此句为不完整句,将在下段继续。这一行的作用是设定本节的论述焦点:下行音型在三人笔下的不同处理。
第2段(P0424)
原文复述
treated by all three with some imitation among voices, and its harmonic
中文讲解
承接上段,说明 Dowland 下行音型在 Byrd、Farnaby、Morley 三人的第一变奏中都被处理过,且三人都运用了"声部间的某些模仿"(some imitation among voices)。这种模仿写作是文艺复兴与早期巴洛克对位变奏的常见手法。同时还指出该音型的"和声轮廓"(harmonic outline)仍可辨认,但此处句子再度中断,将于下段补完。
第3段(P0425)
原文复述
outline can be seen in whole-note values. Byrd’s first variation utilizes
中文讲解
此段补完上文的复合句:三人虽以声部模仿处理下行音型,但原旋律的"和声轮廓仍以全音符时值可辨"(can be seen in whole-note values),即骨干和声保留在长音符上。句末另起一句,引出 Byrd 个性化特征的论述——他的第一变奏采用了某种织体手段,将在下段具体说明。
第4段(P0426)
原文复述
extensive sixteenth- and thirty-second-note figuration, which occurs more
中文讲解
承接上段,说明 Byrd 第一变奏的特征是大量使用十六分音符与三十二分音符的"装饰性音型"(figuration)。这种快速音符群在伊丽莎白时代的键盘变奏中通常承担炫技或装饰骨干旋律的功能。句子再次于行末中断,比较对象将引向 Farnaby 与 Morley。
第5段(P0427)
原文复述
in later variations by the other two composers, and he uses the key of
中文讲解
此段完成了 Byrd 特征的论述:Byrd 第一变奏中先行使用的大规模十六与三十二分音符装饰,在 Farnaby 和 Morley 的作品中要到"更后面的变奏"(later variations)中才出现,这构成 Byrd 与另外两位作曲家在变奏内部时序安排上的差异。同时句末再次中断,将引出 Byrd 在调性上的不同选择。
第6段(P0428)
原文复述
d-minor instead of their a-minor. The way that all three composers treat the
中文讲解
此段补完 Byrd 与其他两位在调式选择上的区别:Byrd 采用 d 小调,而 Farnaby 与 Morley 则用 a 小调。这是变奏写作中"移调变奏"(transposed variation)的常见现象,作者以此作为对比维度之一。段末另起一句,将比较引向新的视角——三人在第一变奏中对旋律"中点"(half-way point)的处理。
第7段(P0429)
原文复述
melody at its half-way point through the first variation is another point
中文讲解
承接上段,作者提出第二组比较维度:三位作曲家对旋律进行到"中点"(half-way point)时的处理方式是又一个比较点。句子于行末中断,具体论述将由下段引入。这一转折表明,作者在比较 Byrd、Farnaby、Morley 时并非笼统对比,而是从多个具体维度切入。
第8段(P0430)
原文复述
of comparison. Morley highlights by three repeated whole notes on E in the
中文讲解
此段补完上句并开启对 Morley 处理方式的描述:Morley 通过三个"全音符"(whole notes)E——位于上声部——来突出旋律中点。作者用"highlights"一词,暗示 Morley 是以节奏上的延宕与力度上的强调来标记此结构位置。句子再度中断,将补充下声部的处理。
第9段(P0431)
原文复述
upper voice and C in the lower, the tension between a-minor and c-major
中文讲解
补完 Morley 的处理:上声部的 E 与下声部的 C 同时发声,形成对 a 小调与 C 大调"音响"(sonorities)之间张力的强调。E 音与 C 音的纵向叠加暗示了和声色彩的暧昧——既可以解读为 a 小调的属音持续,亦可解读为向 C 大调的属七和弦倾向。这正是 Morley 用"延宕全音符"突出旋律中点的意图所在:让听者感知到调性内部的方向性张力。
第10段(P0432)
原文复述
sonorities. From that climax the melody descends to its completion. At
中文讲解
此段说明 Morley 处理中点的后果:从上述张力的"高潮"(climax)出发,旋律下行直至结束。作者用"climax"一词为 Morley 的中点处理定性——这是三首变奏中戏剧性最强的一处。段末另起一句,将比较转入 Farnaby 的做法。
第11段(P0433)
原文复述
the same measure Farnaby substitutes c# as an ornamental passing tone on a
中文讲解
承接上段,作者指出在同一小节(same measure,即旋律中点对应位置)Farnaby 的处理方式:将升 C(c#)作为"装饰性经过音"(ornamental passing tone)放在弱拍上。与 Morley 用全音符强调张力不同,Farnaby 选择以短暂的半音经过来点缀同一结构位置。句子于行末中断,将引出 Byrd 的处理。
第12段(P0434)
原文复述
weak beat. Byrd’s progress to the second half of the melody is smoother
中文讲解
补完 Farnaby 的处理:c# 出现于"弱拍"(weak beat),强调其经过性、装饰性而非结构性。作者随即转入 Byrd 的对比:Byrd 由旋律前半进入后半的过渡显得更"平滑"(smoother)。这一形容词既可指节奏上的连贯,亦可暗示和声上没有制造 Morley 式的紧张。句子于段末中断,将给出最终的对比总结。
第13段(P0435)
原文复述
than Farnaby’s and less climactic than Morley’s.
中文讲解
此段为整节对比作结:Byrd 的处理比 Farnaby 更平滑,又不如 Morley 那样具有"高潮感"(less climactic)。三个形容词——Byrd 的平滑、Farnaby 的装饰性、Morley 的高潮——构成三角对照,把三位作曲家在中点处理上的风格差异清晰定格。这句总结同时回应了本节标题"描述性拆分"的意图:通过多个具体维度的并置,让读者自行感知 Byrd、Farnaby、Morley 的变奏个性。
脚注 / 边栏 / 图表 / 附加信息(如有)
无额外的脚注、图表或边栏材料需汇总。本节全部内容均来自正文段落,未出现编号脚注、图像说明或独立边栏。
💡 本节核心要点
- 比较维度一:三人对 Dowland 下行音型的模仿处理方式相似,骨干和声以全音符保留。
- 比较维度二:Byrd 在第一变奏率先使用密集的十六与三十二分音符装饰,而 Farnaby、Morley 将类似装饰推迟到更后面的变奏。
- 比较维度三:Byrd 使用 d 小调,Farnaby 与 Morley 使用 a 小调,体现移调变奏的选择差异。
- 比较维度四(旋律中点):Morley 用全音符重复 E 与 C 制造 a 小调/C 大调的调性张力高潮;Farnaby 在同一位置以 c# 作为弱拍装饰性经过音;Byrd 的过渡则更为平滑、缺少戏剧性高潮。
- 作者并未判定孰优孰劣,而是通过多维度并置展示三人风格个性。
🔑 关键术语
- falling-note motif:Dowland 原旋律中的下行音型,是本节第一变奏比较的核心素材——三位作曲家都在变奏中对其加以保留与改写。
- whole-note values:全音符时值。作者指出三首第一变奏虽然声部间加入模仿,但原旋律的和声轮廓仍可在全音符的缓慢节奏中被辨识。
- sixteenth- and thirty-second-note figuration:十六分与三十二分音符构成的快速装饰音型,是 Byrd 第一变奏的标志特征,Farnaby 与 Morley 将类似手法推迟到后续变奏。
- half-way point:旋律进行到一半时的结构位置,作者以此作为第二个比较切入点,展示三位作曲家对中点的不同处理策略。
- sonority (a-minor vs. c-major):音响色彩对比。Morley 通过 E 与 C 的全音符叠加制造 a 小调属音持续与 C 大调属和弦之间的调性张力,是中点高潮的核心来源。
- ornamental passing tone on a weak beat:弱拍上的装饰性经过音。Farnaby 用 c# 替代 Morley 的全音符结构安排,以短促的半音经过点缀同一位置。
- climactic / smoother contrast:本节最终用以定性三人风格的三组形容词:Morley 高潮化、Farnaby 装饰化、Byrd 平滑化,由此构成清晰的三角对照。
s42 [描述性拆分] Five Rhythmic and Textural Variables for Comparison
第1段(P0436)
原文复述
One could proceed with categorical comparisons of the three composers’
中文讲解
这是本节首句的前半段。原句完整为:“One could proceed with categorical comparisons of the three composers’ variations without coming to any convincing conclusion on each one’s style.“作者开门见山地承认"类别式比较"是处理三位作曲家变奏曲的一种可能路径,但立刻暗示这条路径无法对每位作曲家各自的风格做出令人信服的判断。这一开篇为下文从"类别比较"转向"量化变量"埋下伏笔——既是一种让步,也是论证转折的起点。
第2段(P0437)
原文复述
variations without coming to any convincing conclusion on each one’s style.
中文讲解
承接 P0436,本句完成判断的核心。“without coming to any convincing conclusion” 表明单纯依靠类别划分去归纳风格,会陷入各说各话的困境;“each one’s style” 强调问题不在于群体差异,而在于能否为每位作曲家确立独立、清晰的风格特征。这种否定语气把后文的方法论改良从"另一种选择"升级为"必要的替代”。
第3段(P0438)
原文复述
The composers’ choices that were just contrasted represent melodic expan-
中文讲解
新句子起头,关键词是 “melodic expansions”(旋律展开)。这是变奏创作的典型手法:在既有曲调之上进行装饰、加花或扩展。“were just contrasted” 回指前文已经做过的那一组类别式对比,把读者带回先前的内容,使其意识到那些对比所处理的对象正是旋律展开层面的选择。这样做是为接下来的方法论诊断——这些选择具有不可复现性——做铺垫。
第4段(P0439)
原文复述
sions on the given tune. Such choices won’t necessarily repeat themselves
中文讲解
完成 “expansions” 一词并抛出关键限定:前文比较的那些"旋律展开选择"在另一首曲调上"won’t necessarily repeat themselves”(不一定重现)。这意味着以旋律展开为切入点的对比天然依附于具体的曲调,无法构成跨曲调稳定的作曲家指纹。论证由此推进了一步:从"未能得出结论"升级到"为何无法得出结论"——旋律选择具有曲调依赖性。
第5段(P0440)
原文复述
in another tune. To avoid such problematic melodic variables, it would be
中文讲解
句子在 “another tune” 处把曲调依赖性说满,紧接着给出方法论回应:“To avoid such problematic melodic variables, it would be…"。“problematic” 把前一节得出的诊断压缩成一个标签:此类变量不可靠。“it would be” 是英语中典型的让步/条件语气,比平铺直叙更具节制,作者借此把后续的替代方案呈现为"审慎的优先选择”,而非绝对正确的唯一途径。
第6段(P0441)
原文复述
preferable to examine what characterizes the rhythmic variation a melody
中文讲解
终于亮出替代方案:考察每首变奏曲中"rhythmic variation a melody undergoes"——旋律在每一次变奏中所经历的节奏变化。把分析对象从"旋律扩展"横向切换到"节奏变化",是因为节奏参数(音符时值、音型)相对独立于具体曲调的轮廓,更容易在多首曲调间保持稳定。本句是方法论转向的明确宣告。
第7段(P0442)
原文复述
undergoes with each piece. Five related variables can build a quantifiable
中文讲解
完成上句后正式提出分析工具:“Five related variables”。“related” 一词暗示这五个变量并非孤立指标,而是一组协同观测。“quantifiable profile” 是本节核心方法论术语——通过一组可度量的指标合成一个能刻画作曲家风格特征的"轮廓"。“with each piece” 强调这种构建是对每一首变奏曲分别进行,然后再做横向比较。
第8段(P0443)
原文复述
profile of each composer’s rhythm and texture: 1) durational note values
中文讲解
在 “rhythm and texture” 两个音乐维度之下,第一个变量是 “durational note values most-to-least used within the variations”,即对每首变奏曲内部所有出现的音符时值(全音符、二分、四分、八分、十六分、三十二分等)按"由多到少"做频次排序。“rhythm and texture” 同时出现,表明作者将这五个变量视为节奏与织体两个维度的联合刻画,而不只是单维节奏的考量。
第9段(P0444)
原文复述
most-to-least used within the variations; 2) changes in (1) over the entire
中文讲解
变量 1 的描述补完,紧接着引入变量 2:“changes in (1) over the entire variation set”,即观察变量 1 在整个变奏序列中的演变。括号编号 “(1)” 显示变量之间存在层级关系:变量 2 直接建立在变量 1 的基础上,关注的是变量 1 的"二阶变化"——整首变奏集中最常用/最罕用音符时值是否在不同变奏间更替。这种"变量上的变量"设计是后文 P0446 变量 4 的模板。
第10段(P0445)
原文复述
variation set; 3) degree of chordal (vs. monophonic) texture within the
中文讲解
变量 3 把分析从节奏层面切到织体层面:“degree of chordal (vs. monophonic) texture”。括号中的 “vs. monophonic” 明确设定了对比的另一极——单声部。“degree” 一词提示这是程度问题而非非此即彼,反映出文艺复兴变奏曲中织体浓淡变化丰富的实际样态。从节奏转向织体,也回应了 P0442 中 “rhythm and texture” 的双维度承诺。
第11段(P0446)
原文复述
variations; 4) changes in (3) over the entire variation set; 5) average
中文讲解
变量 4 完整表述为 “changes in (3) over the entire variation set”——结构和变量 2 完全平行,只不过追踪的是织体而非节奏。变量 5 用 “average size of chords” 暂留半句,预示从"质"(chordal/monophonic 之比)转到"量"(和弦中音的多少)。整个列表刻意保持节奏/织体的对称:1 与 3 测单变量横切面,2 与 4 测该横切面在变奏序列中的演变,5 单独量化和弦密度。
第12段(P0447)
原文复述
size of chords within variations. The first variable, a count of durational note values, is the crudest, since it does not consider the notes’ vertical alignment. Table II-D shows results of durational note counts for the three pieces examined.
中文讲解
变量 5 补完为 “average size of chords within variations”,即每次变奏中典型的和弦内含多少音。紧接着是关键的"方法论告警":变量 1 被作者自评为"the crudest"(最粗糙),理由是 “does not consider the notes’ vertical alignment”——只统计时值频次,却忽略同时发响的纵向音高关系。这一限定显示作者清醒于自身方法的局限,并预告后文其余四个变量正是用来弥补这一不足。最后一句把分析从方法切换到数据,引入 Table II-D 作为承载三位作曲家时值统计结果的可视化表。“Table II-D” 在文本之外存在,故本节只能指引读者查看原表。
补充说明
Table II-D 作为本节实证依据出现,但其内容在当前输入中无法读取;判断方法时应只采用原文中明述的数据。
第13段(P0448)
原文复述
Whole notes in Farnaby and Byrd are consistently the least frequently used, and their most frequently-used note durations are either eighth- or sixteenth-note values. Morley’s whole notes, on the other hand, are dispersed unevenly throughout the variations. His most-used durations range from thirty-second to half-notes. Examining downward the progression of most- and least-used durations reveals the amount of change occurring in this element over the entire set. Judging from the above table, it might appear that Farnaby’s and Byrd’s pieces don’t alter their rhythm as radically as Morley’s from variation to variation. The next variables measured should reinforce or qualify that observation.
中文讲解
本段报告 Table II-D 的核心发现,构成第一个变量的实证层。Farnaby 与 Byrd 的特征是:全音符 consistently(一致地)最罕用,最常用时值集中在短音符区间(八分、十六分),即"以短促为主"。Morley 显著不同:一是其全音符分布"unevenly"——某些变奏中多、某些变奏中少,并非稳定最罕;二是其最常用时值跨度极大,从三十二分到二分音符,意味着节奏语言多样。在变量 2 的视角下,纵向对比整组变奏中"最常用/最罕用时值"的递进,可以看出某位作曲家的"最常用"是否在不同变奏间剧烈更替。初步判断是 Farnaby 与 Byrd 的变奏间节奏切换不如 Morley 剧烈,但作者刻意保留余地——“The next variables measured should reinforce or qualify that observation”——把最终结论的得出推迟到变量 2–5 的实证。这种"先给初判、再明确说"要等后面验证"的双层结构,是本节论证克制、严谨的标志。
脚注 / 边栏 / 图表 / 附加信息(如有)
Table II-D 承载变量 1 的实测数据,但表格本身在本节原文中未以文字形式呈现。仅可从文字推断其结构:纵列为作曲家/变奏曲,横行为最常用至最罕用的音符时值排序。
💡 本节核心要点
- 类别式旋律比较的局限源于旋律展开的曲调依赖性,因此不能作为跨曲调的稳定风格指标。
- 本节以五个可量化变量构建每位作曲家节奏与织体的 “profile”:节奏类的 1(单首变奏内的时值频次)和 2(整组变奏中 1 的演变),织体类的 3(单首变奏中 chordal/monophonic 程度)和 4(整组变奏中 3 的演变),以及密度类的 5(和弦的平均音数)。
- 变量被刻意组织成层级:变量 2 追踪 1 的二阶变化,变量 4 追踪 3 的二阶变化,使单变量横切面与其纵向演变相互校准。
- 变量 1 被作者自评为"最粗糙",因仅做时值频次统计而忽略纵向同时发响的关系;后续四个变量在功能上是对这一粗糙性的修正。
- Table II-D 显示出 Farnaby 和 Byrd 均偏短时值(全音符一致最罕用,八分/十六分主导);Morley 全音符散布不均且最常用时值跨度广(从三十二分到二分音符)。
- 基于变量 1 的初步印象是 Farnaby 与 Byrd 的节奏风格在变奏间变化较平缓,Morley 的变化较剧烈;但作者明确将最终判断推迟至变量 2–5 的进一步验证。
🔑 关键术语
- categorical comparison:依据定性类别而非定量测量来进行的对比;本节判其无法对每位作曲家得出令人信服的风格结论。
- melodic expansion:在既定曲调之上所作的装饰性、加花性或延伸性的旋律处理,是变奏创作的典型手法;因其依赖具体曲调,被本节排除在跨曲调稳定风格指标之外。
- rhythmic variation:旋律在不同变奏之间所经历的音符时值与节奏形态变化;是本节建议替代旋律展开的分析对象。
- quantifiable profile:由五个可量化变量综合而成的作曲家风格轮廓,是本节提出的方法论核心工具。
- durational note values:音符时值(全音符、二分、四分、八分、十六分、三十二分等),按"由多到少"统计其在变奏中的使用频次,构成变量 1。
- chordal (vs. monophonic) texture:织体在多声和弦化与单声部线条之间的程度对照,构成变量 3。
- vertical alignment:多个音符在同一时点上同时发响的纵向关系;变量 1 因忽略此维度而被称为"最粗糙"。
s43 [描述性拆分] Table II-E and Texture Ratios by Variation
第1段(P0449)
原文复述
The degree of chordal (as opposed to homophonic) texture can be measured by taking the ratio of simultaneously struck notes—tied notes being counted as one—over the total number of notes per measure. Table II-E shows the average ratios for each variation in the set. It would also have been possible to calculate percentages of the remaining “solo” notes and to label such a percentage a measure of homophonic texture, or texture in which melody prevails over accompaniment.
中文讲解
本段是整个小节的方法论铺垫。作者在这里不是描述某首作品的具体音响效果,而是先给读者交代:本节用来比较三位作曲家各变奏"和声化程度"的数值,是怎么算出来的。
核心做法是"比值法":把每一小节里同时被敲响的音(即和弦式织体)作为分子,把该小节全部音符数作为分母,得出一个0到1之间的比值。分子里做了一个关键规定——把连音(tied notes)只算成一个,这样做的目的是防止同一音高被持续延音时被人为放大成"和弦",从而扭曲织体判断。
随后作者说明:表II-E呈现的正是用此法算出的"每个变奏的平均比值"。紧接着作者用一句话指出方法的互补性——用剩下的"独奏"音符做百分比,本来也可以被称作"主调织体"或"旋律压过伴奏的织体"的度量。这一句的功能是告诉读者:本节选用的指标是"和声化"一侧,而非"主调化"一侧,但二者数学上是互补关系。
理解这一段的关键在于:它解释了接下来所有数值陈述的依据,使读者明白表II-E里的数字不是凭印象,而是按一个统一规则从谱面统计出来的。
第2段(P0450)
原文复述
The resulting grand means for Farnaby and Morley are identical, providing further testimony to editors’ authorship dilemmas. All three composers’ textures are slightly more chordal than homophonic. A plot of the above means illustrates the direction of change in texture over time. (See Figure II-A on following page.)
中文讲解
本段用上一段定义的方法,对三位作曲家各组变奏的全集平均值进行汇总陈述。其中最值得讲解的不是"略微和声化"这个一般性结论,而是Farnaby与Morley的总均值完全相同这一现象。
作者特意把这一巧合与"编辑者面临的归属困境"(editors’ authorship dilemmas)联系起来。所谓"归属困境",指的是在菲茨威廉维吉纳曲集等键盘曲集中,某些作品署名在Farnaby与Morley之间长期摇摆不定,编辑出版时往往要在两位作者之间做出取舍。本段的逻辑是:既然两位作曲家在织体比值上的均值毫无差别,那么仅从这一项数值指标看,他们彼此之间的差异比通常想象的还要小,从而为"归属难定"的现状又增加了一项量化佐证。
第二句是横向比较的总体结论:三位作曲家——隐含地包括Byrd——的织体都只是"略偏和声化",意味着他们写的不是通篇密集和弦,但也不是纯粹的旋律加伴奏,而是介于两者之间。
第三句将表II-E的"每个变奏均值"交由图II-A展示,并指向下一页。从小节结构看,这一句起到了承上启下的作用:它给出了一个全节整体走向的图示入口,而下一段才会真正展开"走向"是什么。
第3段(P0451)
原文复述
Morley makes radical changes of texture with every new variation, alternating primarily chordal with more figural movement in a methodical fashion. Farnaby’s movement is more gradual, and excepting the change of direction between variations #3 and #4, goes from a more chordal to a less chordal texture. Byrd’s fourth variation is outstanding in its contrast to the other, less chordal ones. Without that particular variation, his set would exhibit the narrowest range of textural changes.
中文讲解
本段是整个小节的实质性收束句,把三位作曲家各自的织体变化"轨迹"逐一勾勒出来。作者不是在重复表II-E里的数字,而是在告诉读者这些数字背后呈现的形态差异。
对Morley的描述有两个要点:一是"激进"(radical),即每写一个新变奏就立刻大幅度改换织体;二是"交替式、有方法"(methodical),即他不是随意摇摆,而是有规律地在"偏和声"和"偏花奏"(figural movement,指分解和弦、装饰性走句等音型化织体)之间来回切换。Morley的处理方式属于"对比型"结构编排。
对Farnaby的描述则强调"渐进"(gradual)。总体趋势是从较和声化走向较不(更花奏),即织体随变奏推进而逐渐变得疏松。但作者特别指出了一个例外:变奏#3到#4之间方向发生了反转。“渐进+局部反转"是Farnaby轨迹的特征。
对Byrd的描述最为关键,作者用"outstanding"一词意味着他的变奏#4在整组里是突出的离群值——它比Byrd的其他变奏明显更和声化。如果没有这一变奏,Byrd全组的织体变化幅度反而是三位作曲家中最小的。这一句的论证效果是:Byrd通常被认为风格统一、变化不大,但表II-E的数据显示,他的"窄幅"印象其实是单凭变奏#4撑起来的;去掉它之后,Byrd比Farnaby和Morley都更"一成不变”。
本段把小节的论证从"数值汇总"推进到"风格判读",是上一段图II-A的文字版解说。它让抽象的"走向"一词落实为三位作曲家三种不同的织体叙事策略:Morley交替、Farnaby渐变、Byrd靠一个变奏撑住反差。
脚注 / 边栏 / 图表 / 附加信息(如有)
无。本小节范围内的附加材料包括表II-E和图II-A(位于下一页),两者均为统计图示,已在正文段落P0449和P0450中提及并指向,未提供额外文字说明,故无进一步附加内容可汇总。
💡 本节核心要点
- 本小节用"同时被敲响的音符数 / 每小节总音符数"的比值来量化织体的和声化程度,连音只计一次,以保证统计规则一致。
- Farnaby与Morley的全集均值完全相同,这一巧合被作者用作"编辑归属困境"的又一项量化佐证。
- 三位作曲家的织体都只是"略微"和声化,整体处于和声织体与主调织体之间。
- 三位作曲家呈现三种不同的织体变化轨迹:Morley在变奏之间做规则性大幅交替;Farnaby整体渐变但#3至#4处方向反转;Byrd整体变化幅度最窄,几乎全靠变奏#4的突出反差才显出对比。
- 图II-A把上述"走向"以图形方式呈现,与本小节文字描述互为补充。
🔑 关键术语
- chordal texture(和声化织体):在本节中指多个音同时被敲响的织体形态,是被测量指标的"分子"一侧;越接近1表示小节内同时发音的成分越多。
- homophonic texture(主调织体):指旋律与伴奏分明、旋律压过伴奏的织体形态,在本节中由比值中剩下的"独奏"音符百分比来体现,与和声化织体在数学上互补。
- tied notes(连音):本节方法论规定只计为一个音,避免同一音高被持续延音时被重复计入"同时发音",从而扭曲和声化指标。
- grand mean(全集总均值):把某位作曲家所有变奏的均值再取一次平均得到的整体水平,本节用此比较Farnaby与Morley的总体和声化程度。
- figural movement(花奏式运动):指分解和弦、装饰性走句等以音型化线条为主的织体,与密集和声织体相对,是Morley与Farnaby轨迹中"偏疏松"一端的标签。
- editors’ authorship dilemmas(编辑的归属困境):指在键盘曲集中Farnaby与Morley之间长期归属不明的现象,本节借两位作曲家均值相同这一点进一步量化支持。
s44 [描述性拆分] Table II-F and Within-Variation Textural Variety
第1段(P0452)
原文复述
The variety of textures within each variation is illustrated better by standard deviation than by means. The standard deviations, averaged over each movement in Table II-F, show a composer’s tendency toward consistency or changeability within one variation. They are plotted in Figure II-B on the following page.
中文讲解
本段的核心主张是:用标准差(standard deviation)来刻画每首变奏曲内部织体的多样性,比用平均值(means)更合适。
所谓"平均值",指的是表 II-F 中各乐章的均值;它反映的是整体水平,但不能显示个别变奏之间的离散程度。而"标准差"则是对每个变奏内部各次测量离散程度的统计指标:标准差小,说明该变奏内部织体变化少,作曲家风格更稳定(consistency);标准差大,则说明同一变奏内部织体起伏多,作曲家更倾向于变化(changeability)。
作者在 Table II-F 中先按乐章取标准差的平均,再将三个作曲家(Byrd、Farnaby、Morley)的结果在下一页的 Figure II-B 中以图示方式呈现,以便读者直观比较"一致性 vs 多变性"这一维度的风格差异。
承接关系上,本段是从统计方法选择(为什么要用标准差)过渡到实证呈现(表与图的位置提示),为下一段对三组数据具体数值的解读做铺垫。容易误解之处:这里的"movement"指的是一首变奏曲内部的乐章或段落单元,而不是整个作品集本身;“averaged over each movement"指的是把每个乐章的标准差先计算出来,再取这些标准差的平均。
补充说明
Table II-F 与 Figure II-B 是本节论证的两个视觉支撑:前者给出标准差的数值,后者给出三组折线轨迹,二者配合 P0453 的数字解读共同说明"变奏集末尾织体变化加大"这一论点。
第2段(P0453)
原文复述
Again, Farnaby’s and Morley’s grand means are slightly more comparable, each showing a more changeable character within variations than Byrd, whose style is more consistent. The three plotted averages all move from a lower degree of deviation to a higher point, substantiating what has been noted earlier about an accelerated or intensified movement toward the end of most variation sets. The similar ranges of their standard deviations (Byrd 8.6-18.4; Farnaby 10.5-21.3; Morley 10.9-19.3) are another indication of similarity in choices. Their starting and ending deviations are within 5.00 and 2.93 points of each other respectively, another highlight of close stylistic proximity.
中文讲解
本段在前段统计方法说明的基础上,对 Byrd、Farnaby、Morley 三位作曲家的具体数据做对比,得出三个递进的结论。
第一,整体对比:Farnaby 与 Morley 的"grand means”(总平均值)比较接近,二者都表现出比 Byrd 更多的变奏内部织体变化(more changeable character),而 Byrd 的风格更稳定(more consistent)。这里的对比维度是"标准差的平均水平",反映的是三人在’一首变奏之内倾向于变化还是维持’上的差异。
第二,趋势对比:三条折线(three plotted averages,即 Figure II-B 中三人的曲线)都呈现出"由低到高"的走向,即标准差从变奏集开头到末尾逐步增大。作者借此印证前文(“noted earlier”)的观察——大多数变奏集在末尾会出现加速或加强(accelerated or intensified)的运动/织体推进。这是从个别数据点上升为一般规律的论证步骤。
第三,范围与端点对比:三人的标准差范围非常接近——Byrd 8.6–18.4、Farnaby 10.5–21.3、Morley 10.9–19.3——表明三人在’最稳定到最不稳定’之间跨越的幅度大致相当,是"选择相似性"(similarity in choices)的又一证据。再看端点:起点处的标准差彼此差距不超过 5.00 个点,终点处的差距不超过 2.93 个点,作者称之为"风格相近的又一亮点"(another highlight of close stylistic proximity)。
整体作用:本段把表 II-F 与图 II-B 的数字、走势、范围、端点逐项串联起来,使读者同时看到"谁更变化 / 谁更稳定"、“三人都末尾加强”、“三人总体选择接近"这三层结论,从而支撑作者关于 Byrd、Farnaby、Morley 在变奏集织体处理上具有风格亲缘性的论断。
补充说明
本段出现的三个范围数字(Byrd 8.6-18.4、Farnaby 10.5-21.3、Morley 10.9-19.3)以及端点差距(5.00 与 2.93)均直接对应 Table II-F 或 Figure II-B 中的可核对数值;“noted earlier” 指向前文对小节/乐章末尾织体加速现象的论述,是本节与前文论点之间的承接点。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节涉及两件附加材料:Table II-F(按乐章平均后的标准差数值表)与 Figure II-B(位于下一页的三位作曲家标准差轨迹图)。Table II-F 提供原始数值,是 P0453 中所有范围与端点数字的依据;Figure II-B 把这些数值绘制成曲线,使 P0453 中"由低到高"的趋势论断成为可视证据。两件材料共同支撑本节的核心结论:三位作曲家的变奏集在织体变化上呈现风格相近的"末尾加速"特征。
💡 本节核心要点
- 作者选择用标准差而非平均值来衡量变奏内部织体的多样性,因为它能直接体现一致性与多变性。
- Farnaby 与 Morley 在变奏内部比 Byrd 表现出更多织体变化(changeable),而 Byrd 风格更稳定(consistent)。
- 三位作曲家的标准差轨迹均从低到高,印证了变奏集末尾出现加速或加强织体的整体趋势。
- 三人的标准差范围(Byrd 8.6–18.4、Farnaby 10.5–21.3、Morley 10.9–19.3)相近,显示选择上的相似性。
- 起点与终点的标准差差距分别不超过 5.00 与 2.93 个点,被作者强调为风格亲缘性的进一步证据。
🔑 关键术语
- standard deviation:标准差,统计离散度指标。在本节中用于衡量单个变奏内部织体变化的幅度,标准差小表示作曲家风格更一致,标准差大表示更倾向变化。
- grand mean:总平均值,在本节指三位作曲家各自所有变奏标准差的整体平均,用以在’一致 vs 多变’维度上对 Byrd、Farnaby、Morley 进行宏观比较。
- movement:在本节上下文中指变奏集内部的乐章或段落单元,而非整部作品;‘averaged over each movement’ 是把每个乐章的标准差先算出后再做平均的处理步骤。
- Table II-F:本节引用的数值表,给出按乐章平均后的标准差,是 P0453 中所有范围与端点数字的直接来源。
- Figure II-B:位于下一页的折线图,把 Table II-F 的数值绘制成三位作曲家的轨迹,用以直观呈现"由低到高"的趋势与三人的接近程度。
s45 [描述性拆分] Table II-G and Average Chord Size
第1段(P0454)
原文复述
A final variable related to texture is a measure of chord voices. The results of averages by variation of total chords reveals some significant difference among the three composers.
中文讲解
本段引出本小节的最后一个与织体(texture)相关的变量——和弦声部数(chord voices),即一首作品中平均一个和弦由多少个声部同时发声构成。作者明确指出,如果按变奏(variation)分别统计三位作曲家(Morley、Byrd、Farnaby)的平均和弦声部数,会在三人之间发现显著差异。这一句本身只交代"变量是什么"和"将看到差异”,具体的数值与差异留给后文表格(TABLE II-G)及其解读段落。它承接本节前面对其他织体变量的讨论,在结构上起到收束性引子的作用,告诉读者下面要看的不是新的乐曲片段,而是对前述变量统计的最后一个补充维度。
补充说明
本段中"by variation of total chords"指的是按变奏为单位,分别计算该变奏内所有和弦的平均声部数,再把这些平均数呈现给读者。
第2段(P0455)
原文复述
TABLE II-G: Average Chord Size (Number of Voices) Per Variation
中文讲解
这是表格的标题行,功能是为读者标明下方数据表的编号、含义和计量方式。Table II-G 表示这是论文中编号为 II-G 的表格,与前文其他 II 系列表格(已在更前面的小节中出现)属于同一统计报告体系。标题中的 Average Chord Size (Number of Voices) Per Variation 说明:表格的每一格数值代表某位作曲家在某一段变奏中,所有和弦的平均声部数(即每个和弦平均包含几个同时发声的音)。Per Variation 这一限定意味着按变奏分列,因此不同变奏会产生不同平均值,既可以比较作曲家之间的差异,也可以观察同一作曲家在不同变奏中的起伏。
第3段(P0456)
原文复述
Although these averages represent a considerable variety of textures from contrapuntal to homophonic the ranges illustrate tendencies either toward an idiomatic keyboard style or a more choral writing style. Morley’s numerous compositions for voices may have influenced his higher score on chord size. Byrd’s chords come near to a three-voiced mean. And Farnaby, who wrote primarily for keyboard, has the smallest chord size. It should be noted that the values for the last variation are highest because the final breve chord is counted as a full measure.
中文讲解
本段是 TABLE II-G 的解读段,作者从两个层次展开:
-
总体观察:尽管平均和弦声部数涵盖了从对位风格(counterpoint,声部独立流动)到主调风格(homophonic,一个旋律加伴奏)的多种织体,但三人之间声部数的差异范围,实际上反映了两种不同的写作传统——一种是键盘器乐化的写作风格(idiomatic keyboard style,适合手指在键盘上演奏、较少厚重和声),另一种更接近合唱式的写作风格(choral writing style,模仿人声合唱,自然会产生更饱满的多声部和弦)。
-
三位作曲家的具体定位:Morley 因写过大量声乐作品(numerous compositions for voices),其和弦声部数最高,作者推测这一声乐经验抬高了平均声部数;Byrd 的平均接近三声部(three-voiced mean),属于居中;Farnaby 主要为键盘写作,因此和弦声部数最小。这里作者实际上是用作曲家的主要创作体裁来解释统计差异,把外部的写作习惯作为差异成因。
-
方法学提醒:作者提醒读者,最后一个变奏的数值最高,原因是该变奏末尾的 breve 和弦(时值较长的全音符和弦)被计为一整小节(full measure),这会人为拉高该变奏的平均声部数。这是一项重要的统计说明,提醒读者最后一列数据含有计数约定造成的偏倚,不应被误读为"最后变奏的音乐本身特别厚重"。
这段在小节中的作用是把抽象数字转译为可解释的音乐史和写作体裁判断,并主动披露统计约定,体现了方法上的严谨。
补充说明
breve 在此处指一个时值较长的全音符或相当于一小节长度的和声音符,在变奏结束处通常作为收束性、饱满的全和弦出现。“counted as a full measure"指的是在按小节统计和弦声部数时,这一长音和弦被整小节计入,而不是按其实际占的拍数计入,因而抬高平均值。
第4段(P0457)
原文复述
Summarizing the above measures, one gets a complicated and inconsistent comparison of three pieces. While Morley’s stands out in the first variable, Byrd’s is distinctive in the second and fourth, and all three composers are distinctive in the fifth. The weighting of these chosen variables for importance is a technique that musicology provides no standard procedure for at this time. Some special combination of these and additional variables comprises the composers’ unique stylistic profiles.
中文讲解
本段是对前文所有织体与结构变量的小结,具有三重要义:
-
诚实承认结果的复杂性:作者直言,把前面若干变量放在一起比较三首作品,得到的是"复杂而不一致"的图景(complicated and inconsistent),不同变量各自指向不同的作曲家,难以用一个总分简单排序。这是作者对自身方法局限性的坦白。
-
给出每一变量中"突出者"的分布:第一个变量中 Morley 最突出;第二个和第四个变量中 Byrd 最突出;第五个变量中三位作曲家都各有特色(all three composers are distinctive)。这相当于告诉读者,任何一位作曲家都不是在所有维度上同时领先,这进一步说明作曲家风格是多面而非单一的。
-
揭示方法论的开放性问题:作者明确指出,目前音乐学界对这些被选变量如何加权(weighting)以决定其重要性,尚无标准程序(no standard procedure)。这是一个重要的方法学声明,说明本文并非要在数学意义上给出"作曲家风格的客观排名”,而是承认加权本身是研究者的判断。
-
引出"风格剖面"概念:作者最后提出,这些变量与可能加入的其它变量以某种特殊组合(special combination),就构成了每位作曲家独特的"风格剖面"(stylistic profile)。这既是本节也是更大论证的收束语——风格不能被单一变量定义,只能被多变量的整体形态刻画。
本段在小节层面起收尾作用,在全文层面则把统计学分析与风格学判断之间的张力清晰地摆出来,为后续讨论留下空间。
补充说明
“the fifth"指的是前文所讨论的五个变量中的第五个,即本小节(平均和弦声部数);“the first”、“the second”、“the fourth"则对应此前的若干变量,具体含义需结合前几节内容确认,本节文本本身未给出前四个变量的具体名称。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节包含一个数据表格标题(TABLE II-G)及其解释段落,无脚注、边栏、插图或乐谱占位符。表格的具体数值未出现在本小节文本中,需查看原表方可获得每位作曲家在每个变奏中的平均和弦声部数。
💡 本节核心要点
- 平均和弦声部数是继其他织体变量之后的最后一个统计维度,目的是比较 Morley、Byrd、Farnaby 三位作曲家作品中的和弦饱满程度。
- 三位作曲家的差异并非偶然,而是与各自的创作体裁传统相关:Morley 因多写声乐作品平均声部数最高,Farnaby 主要为键盘写作故声部数最小,Byrd 居中接近三声部。
- 最后一个变奏的数值偏高的原因不在音乐本身,而在于统计约定——终曲的 breve 和弦被整小节计入,从而抬高平均声部数,这一说明体现了作者的方法学自觉。
- 作者坦承把多个变量合并比较会得到复杂而不一致的图景,任何单一变量都无法单独定义作曲家风格。
- 目前音乐学对这些变量如何加权尚无统一标准,因此本文所给出的只是多变量组合所构成的"风格剖面”,而非可量化的综合排名。
- 本段收束性的论点是:作曲家的独特风格需要由若干变量(包括可能进一步加入的新变量)的特殊组合来描述,而不是由某一单一指标决定。
🔑 关键术语
- chord voices (chord size, number of voices):本节中的核心统计量,指一个和弦实际同时包含多少个独立声部(音)。平均值越高,代表作品和声越饱满、越接近合唱式织体;平均值越低,代表作品越接近键盘器乐化的、相对精简的织体。
- idiomatic keyboard style:专为键盘乐器(古钢琴、羽管键琴等)写作的风格,考虑手指在键盘上演奏的物理便利,通常声部较少、和弦较薄、不强求像人声合唱那样的饱满和声。
- choral writing style:为合唱(或声乐合奏)而写的风格,自然倾向于让多个声部同时发声,因此和声声部数较多,和弦较为饱满。
- breve:一种时值较长的音符,在这里指变奏结束处作为收束的全音符长和弦,在本节的统计中被算作一整小节(full measure),因此会抬高该变奏的平均和弦声部数。
- stylistic profile:作者在本节末尾提出的概念,指把若干变量(包括本文已选的和可能进一步加入的)以某种特殊组合所形成的、专属于某位作曲家的风格整体形态。它强调风格只能由多变量的整体来刻画,而无法被单一指标定义。
s46 [描述性拆分] Summary and Transition to Discriminant Analysis
第1段(P0458)
原文复述
Even given that the optimum number and combination of variables had
中文讲解
本片段是一个让步状语从句的开头。“Even given that…"(即便假定……)是一种让步性假设结构:作者先在假设层面承认一种有利的前提(变量及其组合的最优数量已经测得),随后将通过主句给出转折与反驳。从功能上看,这个片段承担着"先退一步再展开批评"的修辞作用,为后文指出前几章方法学的不足埋下伏笔。
补充说明
原文使用虚拟语气"had been measured”,表明所让步的内容属于一种假设情境而非既成事实。
第2段(P0459)
原文复述
been measured for these pieces, there is no basis for a generalization from
中文讲解
本片段承接 P0458,让步从句在此结束,主句以否定结构"there is no basis for…"(没有依据……)开始。这一否定式开门见山地提出作者的核心批评:即便最优变量已经测定,仍然缺乏由个别样本推断整体的依据。片段本身是承上启下的桥梁——上承让步假设,下启具体的批评对象。
第3段(P0460)
原文复述
three individual cases to the complete works of each. The means and
中文讲解
本片段完成第一句的批评:“three individual cases”(三个个案)指前几章实际分析的若干具体作品,“the complete works of each"指每位作曲家名下全部的作品。句子末尾的句号标志一个完整批评句的结束。作者随即以"The means and"开始第二句,将批评从一般性层面下沉到具体的统计量层面。
第4段(P0461)
原文复述
standard deviations of “Pavan Lachrymae” might be entirely different from
中文讲解
本片段延续第二句:“means and standard deviations”(均值和标准差)是描述集中趋势与离散程度的两项基本统计量。“might be entirely different"使用情态动词 + 程度副词,表达了较强的不确定性判断。“Pavan Lachrymae"被加引号引用,作为具体的乐曲例子出现,作者借此暗示即便是同一作曲家、同一类型的作品,其统计特征仍可能差异悬殊。
补充说明
曲名中的"Pavan”(帕凡)是一种慢速的二拍子宫廷舞曲,“Lachrymae”(泪)暗示其哀婉情调;这些只能从曲名本身所暗示的常识中略作说明,原文并未展开介绍。
第5段(P0462)
原文复述
another Pavan. What is needed is an approach to highly similar works such
中文讲解
本片段以"another Pavan”(另一首帕凡)结束第二句,进一步强化"同名/同类作品之间统计量也可能截然不同"的论点。句号之后,作者以强调句型"What is needed is…"(所需要的是……)从问题陈述转入方法论要求,开启第三句,并引出对一种新方法的期待。“highly similar works such as these"界定了这种新方法应当适用的对象特征。
第6段(P0463)
原文复述
as these that will provide the necessary weightings for variables, and also
中文讲解
本片段继续第三句,承接"highly similar works such as these”,以定语从句形式对新方法提出第一项要求:“provide the necessary weightings for variables”(提供变量的必要权重)。“weightings"是多元统计分析中的常见概念,指赋予不同变量以不同的相对重要性。句末的"and also"提示还有第二项要求紧接在后。
第7段(P0464)
原文复述
be usable in a comparison of a broad array of pieces. In the next chapter
中文讲解
本片段完成第三句:“be usable in a comparison of a broad array of pieces”(能够用于比较范围广泛的乐曲)即前述新方法的第二项要求——除了能给出变量权重,还必须可推广到多样化的曲目比较之中。本节整体到此完成对前几章方法的批判与对新方法的期待。其后以"In the next chapter"另起一句,作为段落末的过渡预告。
第8段(P0465)
原文复述
the statistical procedure known as discriminant analysis will be described
中文讲解
本片段承接 P0464 的过渡句,引出下一章的核心方法——“the statistical procedure known as discriminant analysis”(一种被称为判别分析的统计程序)。“will be described"使用将来时被动语态,明确这是一种预告性陈述,本节并不展开介绍其细节。该方法正是作者用以回应前文两项要求(变量权重 + 广泛曲目比较)的工具。
第9段(P0466)
原文复述
in application to these problems.
中文讲解
本片段以介词短语"in application to these problems”(应用于上述问题)结束整个段落与过渡预告句。“these problems"回指前文提出的所有批评与要求:外推困难、描述统计量差异、变量赋权与广泛比较的需求。该短语将下一章的判别分析与本章所揭示的问题明确挂钩,使过渡既承上又启下。
脚注 / 边栏 / 图表 / 附加信息(如有)
无。本节为单一过渡段落,不含脚注、图表、边栏或额外附注。
💡 本节核心要点
- 本节承担小结与过渡双重功能:在小结层面,它系统回顾前几章方法在从三首个案推断作曲家全部作品时所面临的统计外推困难。
- 作者以"Pavan Lachrymae"与"另一首帕凡"为具体例证,说明均值与标准差等描述统计量在高度相似的作品之间仍可能差异极大。
- 作者对新方法提出两项必备要求:能为变量提供必要的权重(weightings for variables),并且能够用于广泛的乐曲比较(a broad array of pieces)。
- 新方法的适用对象被界定为"高度相似的作品”(highly similar works),呼应作者聚焦风格归属问题的研究旨趣。
- 作者预告下一章将引入"判别分析”(discriminant analysis)这一统计程序,并明确该程序将被应用于本节所揭示的所有问题。
🔑 关键术语
- discriminant analysis:判别分析。一种多变量统计程序,依据若干变量把样本归入已知类别;在本节中,作者计划将它用于风格归属与作品比较,是回应前文方法学批评的方案。
- generalization:概括/外推。从样本推断总体的统计推理过程;本节指作者批评前几章方法无法从三首个案合理推及每位作曲家全部作品的问题。
- means and standard deviations:均值与标准差。描述集中趋势和离散程度的两项基本统计量;本节用它们说明不同乐曲之间统计特征可能差异悬殊。
- weightings for variables:变量的权重。在多变量分析中对不同变量赋予的相对重要性;本节将其列为作者所期待的新方法应满足的第一项要求。
- a broad array of pieces:范围广泛的乐曲集合。本节用以表述新方法应具有的可推广性,即不局限于个案而能适用于多样化的曲目比较。
s47 [描述性拆分] Variables of Musical Style
第1段(P0467)
原文复述
CHAPTER III: METHODOLOGY
中文讲解
该段是第三章的章标题,原文以 Markdown 二级标题形式呈现,文字为 “CHAPTER III: METHODOLOGY”。“CHAPTER III” 表明这是论文(或著作)的第三章,按罗马数字顺序排列;“METHODOLOGY”(方法论)宣告本章的功能是交代研究方法,而非讨论音乐风格本身的实质性议题。从章节序列看,这一章在结构上通常处于文献综述/理论铺垫之后、实证分析或案例研究之前的环节,作用是为后续具体分析提供可重复、可检验的操作框架。该标题本身不含论证内容,但它的存在界定了随后所有段落所属的论域:作者即将展开的不是风格描述,而是分析风格时所使用的方法与变量。
第2段(P0468)
原文复述
Variables of Musical Style
中文讲解
该段是第三章下的一个小节标题,原文为 “Variables of Musical Style”(音乐风格的变量)。作为节标题,它本身不展开论证,只点明本节将要处理的主题:在方法论框架内,作者将把"音乐风格"拆解为若干可识别、可测量的"变量”(variables)。“变量"一词暗示作者采取的是一种分析性、量化或至少是系统化归纳的路径——把原本整体性的"风格"概念分解为若干维度,每个维度对应一个或一组可观察、可操作的特征。换言之,本节承担的论证功能是建立一套用于描述与比较风格的工具集,为后续章节对具体作品的风格分析提供通用词汇与判定标准。读者阅读本节时应关注作者如何界定这些变量、如何选取样本、如何处理变量之间的相互关系。
💡 本节核心要点
- 本小节由两个结构性元素组成:第三章章标题与该章下的一级节标题,本身不含实质性论证。
- 章标题 “CHAPTER III: METHODOLOGY” 宣告本章的研究功能是交代方法论,而非直接讨论音乐风格本身。
- 节标题 “Variables of Musical Style” 揭示作者将"音乐风格"操作化为若干可分析变量的研究取向。
- 两个标题共同界定了即将展开内容的论域边界与分析路径:先说明用什么方法,再说明分析对象如何被拆解。
🔑 关键术语
- METHODOLOGY(方法论):在学术写作中指对研究设计与操作程序的系统说明。本章以此为题,表明作者将在此交代分析音乐风格时所采用的研究方法、变量选取与判定标准,而非进行风格描述本身。
- Variables of Musical Style(音乐风格的变量):指作者在方法论框架内为分析音乐风格所设定的若干可识别、可测量的维度或特征。本节标题表明作者将以"变量"这种分析性、归纳性的单位来拆解"风格"这一整体概念,为后续章节的比较与判定提供通用工具。
s48 [描述性拆分] Measurement Scales and Their Application to Style
第1段(P0469)
原文复述
To narrow down the range of possible variables worth studying, the author must put forward two questions.
中文讲解
本句开启本节的方法论铺垫:作者宣布要把研究对象中的变量加以筛选与限制,为此将提出两个需要回答的问题。这一段是整节论证的总入口,决定了后面将围绕"采用哪种测量尺度"和"研究哪种风格维度"两条主线展开。
第2段(P0470)
原文复述
questions have to be addressed: 1) From a methodological point of view, which
中文讲解
承接前句,正式列出两个并列问题,并开始写第一个问题——它从方法论视角出发,问的是测量形式的取舍。句首冒号表明接下来是分项列举,1) 2) 是对应原文的编号。
第3段(P0471)
原文复述
forms of measurement—that is, nominal, ordinal, interval, or ratio scales—are
中文讲解
这一片段给出了第一种测量形式的四种具体类型:定类尺度(nominal)、定序尺度(ordinal)、定距尺度(interval)、定比尺度(ratio)。这是测量理论中的经典四分法,作者把它们作为本节方法论问题的核心候选答案。
补充说明
nominal、ordinal、interval、ratio scale 是 S. S. Stevens 在1946年提出的测量水平分类;本段虽然未给出出处,但术语本身已在本节内自洽。
第4段(P0472)
原文复述
meaningful and useful? 2) Which stylistic dimensions of those usually
中文讲解
前半句收束了第一个问题:在这四种尺度中,哪几种对本研究"有意义且有用”。后半句紧接着开始第二个问题:从通常在音乐分析中被援引的若干风格维度中筛选。注意两个问题之间用"2)“分隔,构成并列结构。
第5段(P0473)
原文复述
cited in musical analysis—such as harmony, melody, rhythm, and so forth—seem the
中文讲解
用举例的方式补全"通常被援引的风格维度”:和声(harmony)、旋律(melody)、节奏(rhythm)等。“etc.“表明这里只列出代表性例子,并非穷尽列举。
第6段(P0474)
原文复述
preeminent sources of style variation in the given works?
中文讲解
第二个问题的收束:在常见的风格维度中,哪几种是本研究所涉及作品内部风格差异的最主要来源(preeminent sources of style variation)。“preeminent"暗示作者承认差异源于多因素,但要在多因素中排出主次。
第7段(P0475)
原文复述
Nominal measurement scales come into play when the variable types representing
中文讲解
开始定义第一种尺度——定类尺度(nominal scale)。触发条件:变量代表的是某种类别(category)。这是接下来对其形式与例子的展开。
第8段(P0476)
原文复述
a category are each assigned a symbol or number that marks their unique identity
中文讲解
补全定类尺度的定义:每个类别被赋予一个符号或数字,用来标识该类别的唯一身份。关键限制是——这些符号/数字仅起"贴标签"作用,没有数值大小或顺序含义。
第9段(P0477)
原文复述
(for example, “A = major chord,” “B = minor chord”). Ordinal scales assign a
中文讲解
给出定类尺度的音乐实例:A 代表大调和弦,B 代表小调和弦——只是命名不同类别,不蕴含"A 大于 B"之类的数值关系。紧接着转入对定序尺度的介绍。
第10段(P0478)
原文复述
sequence of numbers or symbols that imply an ordered relation among the variables,
中文讲解
定义定序尺度(ordinal scale)的形式特征:所赋数字或符号能表达变量之间的"有序"关系。这里的"ordered relation"是关键词——它比定类尺度多了顺序信息,但仅仅是顺序。
第11段(P0479)
原文复述
but without specifying limits or intervals of the order (for example, “1 = Allegro,
中文讲解
补全定义的关键限定:定序尺度虽然能排序,但并不规定相邻等级之间的距离或量级。这是一个本质性的限制——它解释了为什么不能用 Allegro、Presto、Vivace 的数字差做加减乘除。紧接着引入音乐实例。
第12段(P0480)
原文复述
2 = Presto, 3 = Vivace”). Interval- and ratio scales assign numbers to
中文讲解
完成定序尺度例子的收尾:1=Allegro、2=Presto、3=Vivace,这三个标记仅表示快慢的等级顺序。然后开始同时介绍定距尺度和定比尺度——两者共享核心结构(assign numbers to observations),仅在零点性质上有别。
第13段(P0481)
原文复述
observations based on equally-intervalled scales that have, respectively, arbitrary or abso-
中文讲解
延续定距与定比尺度的定义:两者都基于等距刻度(equally-intervalled scales)给观察值赋值。“arbitrary or abso-“是单词 absolute 被强行断行,下一行将补全。这句已经预告了两种尺度的本质差别——零点是任意的还是绝对的。
补充说明
注意原文断行:“abso-” 在 P0481 末尾,“lute” 在 P0482 开头;合成单词为 absolute。
第14段(P0482)
原文复述
lute zero-points, respectively. $^{36}$ For instance, designating the tonic note of a
中文讲解
承接上一行完成 absolute 一词,并把定义收束:定距尺度具有任意零点,定比尺度具有绝对零点。句末附带脚注 36 标记——这通常意味着作者对这一测量学区分引入了来源注释。随后开始举例:把调式主音标记为"1”。
补充说明
脚注标记 $^{36}$ 出现在此处,但脚注 36 的具体内容未包含在本节输入段落中,无法在本节内复述其信息。
第15段(P0483)
原文复述
scale “1” and numbering the notes that occur above and below it throughout a piece
中文讲解
延续比例说明:以主音为"1”,对作品中该音上方与下方的音依顺序编号,这一动作本身就在搭建一个等距的数值序列——尽管音乐中各音之间的物理振动频率其实并不等距。
第16段(P0484)
原文复述
would constitute an interval scale. Counting notes by their frequencies illus-
中文讲解
上一例子的收束——把作品中的音按与主音的相对顺序编号,构成了一个定距尺度的实例。然后转向定比尺度的例子:按频率(vibrations per second)来计数音高。同样,“illus-” 是单词 illustrates 的断行。
补充说明
注意原文断行:“illus-” 在 P0484 末尾,“trates” 在 P0485 开头;合成单词为 illustrates。
第17段(P0485)
原文复述
trates the use of a ratio scale, with zero vibrations per second serving as
中文讲解
承接上行的 illustrates 单词补全,并完成定比尺度例子的核心定义:用频率计数的关键意义在于存在一个绝对的零点——每秒振动零次,即"没有声音”,这正是定比尺度的本质特征。
第18段(P0486)
原文复述
the bottom limit.
中文讲解
本节最后一句对上一行例子作收束:“零振动/秒"作为定比尺度的下限(bottom limit)。这一句表面简短,实际上点出了定比尺度区别于定距尺度的全部依据——即是否拥有非任意的、绝对意义的零点。
脚注 / 边栏 / 图表 / 附加信息(如有)
脚注:本节正文在 P0482 处出现脚注标记 $^{36}$,但脚注 36 的具体内容并未包含在所提供的 source_paragraphs 之中,因此无法在本节内对其内容进行复述或讲解;仅能确认该脚注与"interval- 与 ratio scales 之分"的测量学界定相关。无其他图表、边栏或附录条目出现。
💡 本节核心要点
- 本节的方法论入口由两个并列问题构成:一是选择何种测量尺度(定类、定序、定距、定比),二是从常见的风格维度(和声、旋律、节奏等)中确认哪些是风格差异的主要来源。
- 四种测量尺度由弱到强递进:定类尺度只赋予类别标签;定序尺度在标签之上增加顺序但无等距信息;定距尺度增加等距刻度但零点任意;定比尺度在等距基础上进一步引入绝对零点。
- 作者用音乐学例子分别演示四种尺度:大三和弦/小三和弦贴标签→定类;Allegro/Presto/Vivace 排序→定序;以主音为"1"对音编号→定距;按每秒振动次数计数并以零振动为底→定比。
- 例子同时承担教学与论证双重功能:既让读者直观把握抽象测量学概念,又暗示了音乐现象中真正可作定比测量的对象(如频率)数量稀少,这为后续讨论中尺度选择的限制埋下伏笔。
🔑 关键术语
- nominal scale:定类尺度,本节定义为仅为类别贴上符号或数字标签、不蕴含顺序或数值关系的测量尺度;例:大三和弦=A,小三和弦=B。
- ordinal scale:定序尺度,本节定义为可表达变量顺序但不能刻画相邻等级间距离的测量尺度;例:1=Allegro,2=Presto,3=Vivace。
- interval scale:定距尺度,本节定义为基于等距刻度但零点任意的测量尺度;例:以主音为"1"对作品中各音按相对位置编号。
- ratio scale:定比尺度,本节定义为基于等距刻度且具有绝对零点的测量尺度;例:以每秒振动次数计量音高,零振动/秒为下限。
- absolute zero-point:绝对零点,定比尺度的本质特征,代表"数量上的完全不存在”,与定距尺度的任意零点形成对照;本节以"零振动/秒"作为音乐学中的实例。
s49 [描述性拆分] Arguments for Interval- and Ratio-Scaled Variables
第1段(P0487)
原文复述
The passage opens by announcing that there exist arguments against the practice of constructing categorical variables on the basis of nominal scales.
中文讲解
本段作为整节的起句,预告本节主题:反对把名义量表(nominal scale)上的变量强行转写为类别变量(categorical variable)。标题虽为"Arguments for Interval- and Ratio-Scaled Variables”,但作者并未直接陈述支持意见,而是先从对面入手——先说明为什么基于名义和顺序量表的类别化做法有问题,再反衬出区间/比例量表的优势。这种"先破后立"的结构是社会科学方法论文献的常见写法。
补充说明
本句在原文是横跨两页段落的开头一行;它之所以单独成段,是因为源文本在排版上于第32页开头处换行。下文P0488紧接其后,构成同一句的延续。
第2段(P0488)
原文复述
These arguments extend the same objection to variables built on ordinal scales, and the author attributes them to two analysts working in the social sciences.
中文讲解
本句延续P0487,将反对对象从名义量表扩展到顺序量表(ordinal scale),并交代论点的来源——两位社会科学领域的分析者。读者需要注意:作者是在引用他人观点为自己的小节主题服务,而不是在进行原创论证。“two analysts"预告了接下来要介绍的两条不同理由。
第3段(P0489)
原文复述
The first of those social-science analysts, Hubert Blalock, maintains that categorical measures of this sort turn out, on closer inspection, to be multidimensional.
中文讲解
本句引入第一位学者Hubert Blalock的核心论点:这些类别化测量在仔细检视之下其实是多维的(multidimensional)。所谓"多维”,指的是表面上只是一个类别标签(例如"大调/小调”),实际却把多个本应区分的维度(如调式、调性、旋法、终止式)压缩在了一起。“on closer inspection"这一限定很重要——它说明问题不是类别化本身有错,而是粗看与细看的结果不一致。
补充说明
Blalock是著名社会学家与统计学家,主张类别变量易混淆多个分析维度;但本节并未提供其著作出处,脚注37应承担这一来源功能。
第4段(P0490)
原文复述
Because such measures are multidimensional when examined closely, Blalock holds that they are too broad to be relied upon as a basis for comparing samples.
中文讲解
本句给出Blalock观点的推论:多维性导致测量过宽( too broad ),从而无法用于样本间的可靠比较(comparisons between samples)。换言之,当一个类别同时承载了多个维度的差异,用它去比较两组样本时,研究者无法判断两组之间的差异究竟落在哪个维度上,比较结果因此失去诊断意义。这是Blalock反对名义/顺序类别的关键一步:测量过宽→无法定位差异→比较失效。
第5段(P0491)
原文复述
It is for that reason that they cannot be trusted for cross-sample comparisons (footnote 37). To illustrate the point, one may invoke musical examples drawn from the Elizabethan period.
中文讲解
本句承接Blalock论证的结论(类别变量不可靠用于样本比较),并在脚注37处给出Blalock观点的文献来源;随后笔锋一转,从社会科学领域切换到音乐学领域,准备用伊丽莎白时期的例子来具体说明Blalock抽象论点的含义。这一转折的关键在于:作者要让读者看到,类别化的问题并非社会科学的特例,音乐学同样深受其困。脚注37虽然未在本节正文出现,但应当承担支持Blalock观点的来源标注功能。
补充说明
脚注37由本句触发但内容未在本节文字中复现;按照脚注处理的最低要求,仅指出它对Blalock观点起来源/支持作用。
第6段(P0492)
原文复述
From the Elizabethan repertoire one can find cases in which the labels “major” and “minor” themselves function as categories.
中文讲解
本句开始用具体音乐语汇落实Blalock论点。“大调"与"小调"在伊丽莎白时期的实际作品中,并不是后世理论教科书里那种干净对立的二元类别,而是各自内部仍有多种细分——例如不同的调式终结方式、不同音程结构。作者即将借这一历史事实说明:一个看似简单的二元类别,实际上承载着比表面更复杂的内容。
第7段(P0493)
原文复述
Yet those labels turn out to be too broad to capture the varieties of mode actually present within a given piece. With that illustration complete, the author turns to the second social-science analyst, Jerald Hage.
中文讲解
本句结束Blalock部分的音乐例证:“major/minor"作为类别过宽,无法描述作品中实际存在的调式变体(varieties of mode)。这正是Blalock"多维性→过宽→无法比较"链条的音乐学版本。然后作者把镜头切给第二位学者Jerald Hage,准备引出第二条反对理由。读者应注意:两位学者的出发点不同——Blalock聚焦"测量内部的多维性”,Hage则聚焦"测量随时代的变化性”,两条线索在本节末尾汇合为对区间/比例量表的共同推荐。
第8段(P0494)
原文复述
Hage’s objection is that categorical variables are bound to the modes of interpretation that happen to be current and transient at a given moment.
中文讲解
本句给出Hage的核心论点:类别变量受制于当下流行的、瞬变的解释方式(current, transient modes of interpretation)。与Blalock的多维性批评相比,Hage的批评是时间性的——他强调类别不是永恒的,而是与某一时代占主导的解释框架挂钩。“bound to"和"current, transient"两个短语共同传达出"类别无法独立于时代背景而成立"的含义,这是Hage与Blalock的关键区别。
第9段(P0495)
原文复述
Footnote 38 attaches to this criticism. Once again, music history demonstrates that interpretive vocabulary undergoes evolution.
中文讲解
本句在Hage论点之后标注脚注38(应为Hage观点的文献出处),并再次以音乐史为例进行印证。作者用"Again"显式提示:Blalock用了音乐例,Hage这里也用音乐例,形成对称结构;下面P0496将完成这个例证的展开。
补充说明
脚注38内容未在本节文字中出现,仅作为Hage观点的来源标注存在。
第10段(P0496)
原文复述
That evolution reaches the point where the established analytical vocabulary ceases to fit the categories of musical style under examination in certain repertoires.
中文讲解
本句将Hage的时间性批评具体化为音乐史现象:分析词汇不断演化,有时会发展到不再能描述当下研究对象所属的某些音乐风格类别。也就是说,研究者惯用的类别标签可能源自更早的风格传统,而当遇到新的音乐语汇时,原有类别会显得力不从心。这正是Hage所谓"类别受制于当下解释方式"在音乐学中的体现。
第11段(P0497)
原文复述
This drift means that vocabulary no longer describes the style under study in some music. With this historical illustration in place, the author states Hage’s preference: he favors interval- or ratio-scaled variables.
中文讲解
本句完成对Hage音乐例证的收束,并自然过渡到Hage本人的正面建议——他更倾向于使用区间或比例量表(interval- or ratio-scaled)的变量。这是本节标题"Arguments for Interval- and Ratio-Scaled Variables"在Hage部分的正式落点。读者应注意:作者在此并未宣称Hage的结论已被普遍接受,而只是报告Hage本人的立场;Hage偏好的理由将在P0498给出。
第12段(P0498)
原文复述
Hage endorses interval- or ratio-scaled variables specifically because of their generalizability to different historical periods or social groups.
中文讲解
本句给出Hage偏好区间/比例量表的核心理由——可推广性(generalizability)。区间与比例量表具有明确的数值单位和可比距离,因此不像名义或顺序类别那样依赖某一时代占主导的解释框架;把它们用在不同时期或不同群体的样本上,仍然可以保持测量意义的一致性。这与Blalock的"过宽"批评恰好形成镜像:Blalock批评类别化变量太宽,Hage则在批评类别化变量太窄(受时代局限)的同时,认为区间/比例量表既精准又跨时代可比。两位学者出发点不同,结论却都指向同一推荐——这正是本节标题所要论证的中心。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节正文共出现两处脚注标记:脚注37位于P0491句末,对应Blalock"类别变量多维、不可靠用于样本比较"的观点;脚注38位于P0495句中,对应Hage"类别变量受制于当下瞬变解释方式"的观点。两处脚注的完整内容均未在本节文字中复现,仅以数字上标形式出现,因此本节无图、无表、无乐谱占位符,亦无章节小标题或边栏文本。
💡 本节核心要点
- 本节采取"先破后立"结构,先列举反对名义/顺序类别变量的论点,再据此推荐区间/比例量表。
- Blalock的论点核心是测量层面:名义/顺序类别在细看时其实是多维的(multidimensional),因此过宽而无法用于样本间可靠比较。
- Hage的论点核心是时间层面:类别变量受制于当下流行的、瞬变的解释方式,因而难以跨越不同时期或群体使用。
- 两位学者各以伊丽莎白时期"大调/小调"以及分析词汇的历史演化作为音乐学印证,使抽象的方法论批评落到具体曲目与术语史层面。
- 两位论点最终汇合于同一推荐:使用区间或比例量表的变量,因为它们具有跨时期、跨群体的可推广性(generalizability)。
- 本节作为标题所标"支持区间/比例量表"的论据章节,本身不提供原创论证,而是报告并综合Blalock与Hage两位社会科学分析者的观点。
🔑 关键术语
- categorical variable(类别变量):将观测值划入有限个互斥类别的变量类型;本节中被批评的对象,主要指由名义或顺序量表转写而成的类别化测量。
- nominal scale(名义量表):仅用于区分类别、不具内在顺序的测量层次;本节被列为类别化的来源之一,与顺序量表并提。
- ordinal scale(顺序量表):类别间存在等级顺序但相邻等级间距未定义的测量层次;与名义量表一同被本节视为类别变量的基础。
- multidimensional(多维的):Blalock用以批评类别变量的关键概念,指表面单一类别实际承载多个应区分的分析维度。
- current, transient modes of interpretation(当下流行的、瞬变的解释方式):Hage用以批评类别变量的关键概念,指类别标签总是与某一时代占主导的解释框架挂钩,缺乏跨时代的稳定性。
- interval- or ratio-scaled variable(区间或比例量表的变量):具有明确可比数值与距离的测量层次;本节作为Blalock与Hage共同推荐的替代方案,其优势在于跨时期、跨群体的可推广性。
- generalizability(可推广性):Hage推荐区间/比例量表的具体理由,指测量结果可应用于不同历史时期或社会群体而保持意义一致。
s50 [描述性拆分] Selection of Rhythm and Texture as Primary Variables
第1段(P0499)
原文复述
When the selected Elizabethan variations were initially studied for
中文讲解
本句是一个跨行断句的起始部分,引出研究背景:作者在最初研究一批选定的伊丽莎白时期变奏曲时,是为「选择变量」这一目的而展开分析的。这为下文论述为何最终选定节奏与织体作为主要变量埋下伏笔。读者需要知道,作者关心的不是音乐史的一般描述,而是为定量比较寻找合适的测量维度。
第2段(P0500)
原文复述
a choice of variables, it was found that musical dimensions lending them-
中文讲解
承接上一行,说明研究目的与初步发现:「为选择变量而研究时发现,那些最适用于 ratio-scaling 与 interval-scaling 的音乐维度是……」后半部分尚未出现。这种「研究目的 → 初步结论」的结构提示读者:选择变量不是任意决定,而是基于测量可行性筛选出来的。
第3段(P0501)
原文复述
selves most to ratio- and interval-scaling were rhythmic and textural.
中文讲解
本段给出该小节的核心结论:在所有音乐维度中,「节奏(rhythm)」与「织体(texture)」最适用于「比率尺度(ratio-scaling)」与「区间尺度(interval-scaling)」两种定量测量方法。这是后文排除和声、旋律、音色的判据:能否进行区间或比率型测量,是变量入选与否的关键门槛。需注意「区间尺度」与「比率尺度」是测量理论中比类别尺度更高级的量纲,能进行加减或乘除运算,区分度远高于「是/否」式的分类。
补充说明
本段「ratio- and interval-scaling」与「rhythmic and textural」两对术语是本节论证枢纽,详见 terms 栏。
第4段(P0502)
原文复述
Harmony and melody were obviously categorical variables, there being no
中文讲解
作者开始排除其他维度,首先指出「和声(harmony)」与「旋律(melody)」显然是「类别变量(categorical variables)」。类别变量意味着其取值只能落入有限的几类(例如大调或小调),不能在数轴上展开为连续序列。这里「there being no」是修饰整个短句的独立主格结构,对「为何它们属于类别变量」给出原因说明,下一句即给出具体例证。
第5段(P0503)
原文复述
continuous range of “majorness” or “minorness”. Further, given that the
中文讲解
本句补全原因:以「majorness(属大调程度)」和「minorness(属小调程度)」为例,不存在一个可在数值上连续变化的范围——一首作品要么更接近大调,要么更接近小调,无法用连续标度衡量。「Further」表示作者还要给出第二条理由,引出下一段关于变奏主题的论述。
补充说明
「majorness / minorness」是作者自造的口语化说法,用以形象说明连续程度不可量化,并非音乐理论正式术语。
第6段(P0504)
原文复述
theme for variation is based on a melodic and/or harmonic progression, it
中文讲解
作者进一步给出第二条排除理由:由于变奏的主题本身就建立在「旋律和/或和声进行」之上,下一句将进一步指出和声与旋律在各变奏之间难以成为区分风格的要素。本句是论证的中间过渡句,作用是把「主题—变奏」这一音乐体裁特性纳入推理。
第7段(P0505)
原文复述
is unlikely that they contribute greatly to style change from one vari-
中文讲解
承接上文,作者判断:和声与旋律「不太可能在各变奏之间显著推动风格变化」。这是关键的逻辑跳跃——即使它们是连续变量,正因为变奏主题本身以它们为基础,它们在各变奏之间反而保持稳定,从而无法承担「区分风格」的功能。
第8段(P0506)
原文复述
ation to the next. Their very redundancy is the unifying element of the
中文讲解
本句承接 P0505,把思想落到一个看似矛盾却精炼的论断:「它们(和声、旋律)的冗余性恰恰是作品的统一要素」。换言之,在变奏曲体裁中,各变奏共享相同的和声与旋律骨架,正因这种「重复 / 冗余」,听者才能把多个段落识别为同一首作品的多个变体。这是变奏曲体裁的内在美学特征,也是和声、旋律无法充当区分变量的根本原因。
补充说明
「redundancy(冗余)」在此并非贬义,而是被作者当作一种统一机制来使用,体现信息论与体裁分析在本文中的结合。
第9段(P0507)
原文复述
work. Timbre, in reference to the choice of instrumentation, is also an
中文讲解
在排除了和声与旋律之后,作者转入对「音色(timbre)」的讨论,并明确将其范围限定为「乐器选择(choice of instrumentation)」这一层含义。这是一个重要的范围声明:此处讨论的「音色」不是泛指演奏法或发音法,而是具体的乐器配置。本句结尾点出「也是一个……」即将说明音色同样不适用。
第10段(P0508)
原文复述
unuseable variable for discrimination in these cases since all pieces are
中文讲解
给出排除音色的具体理由:因为这些作品「全部是为 harpsichord(大键琴)」而作,演奏乐器没有任何变化,所以音色在本批样本中无法成为区分变量。注意作者用的是「unuseable」这一较强措辞,强调的不是音色本身有问题,而是「在当前样本中」失去区分力,暗示换一批乐器多样的曲目时情况就会不同。
第11段(P0509)
原文复述
for harpsichord. The two other major musical elements, rhythm and texture,
中文讲解
补全上一句「均为大键琴作品」,并以「The two other major musical elements」过渡到核心讨论对象「节奏与织体」。注意「other」一词暗示作者心中有一个音乐要素清单:和声、旋律、音色已被逐一排除,剩下的两大要素即节奏与织体,构成本研究的实际测量维度。
第12段(P0510)
原文复述
not only are suitable for interval- and ratio-scaling, but are primarily
中文讲解
本句以「not only …, but …」递进结构,为节奏与织体提供双重论证:第一,它们「不仅」适用于区间与比率尺度(满足测量学门槛);第二,它们还是「primarily(首要地)」——下句给出第二层论断的具体内容。递进结构的修辞效果在于:先满足方法论要求,再从音乐学角度强调其在体裁中的核心地位。
第13段(P0511)
原文复述
responsible for the stylistic development within Elizabethan variation.
中文讲解
全段收束于一个明确结论:「节奏与织体是伊丽莎白时期变奏曲体裁内风格发展的首要驱动因素」。这与开篇 P0499–P0501 形成首尾呼应:从「最适用于比率与区间尺度」到「首要地承担风格演变」,完成了从方法论筛选到音乐学论证的双重论证。读者由此理解,作者并非仅出于测量便利才选用节奏与织体,而是因为它们本身在伊丽莎白变奏传统中就是风格变化的主要来源。
补充说明
本段为本节乃至后续定量分析的总纲;下游小节将围绕节奏与织体的具体可测指标展开。
脚注 / 边栏 / 图表 / 附加信息(如有)
无。该小节仅由正文段落组成,未出现脚注、图表、谱例或边栏内容。所有例证(如「majorness / minorness」「harpsichord」「主题基于旋律与和声进行」)均嵌入正文叙述之中,无独立附加材料。
💡 本节核心要点
- 作者在选择变量时遵循测量学标准:只有能进行区间或比率尺度的维度才适合做定量区分,因此排除了类别变量和声与旋律、并在当前样本中无变化的音色。
- 和声与旋律在本批伊丽莎白变奏曲中被排除的更深层原因是体裁特性:变奏主题本就建立在它们之上,它们的「冗余性」正是作品的统一要素,无法承担区分功能。
- 音色(具体指乐器选择)被排除不是因为概念本身有问题,而是因为所有样本都是大键琴作品,缺少可供比较的变化。
- 节奏与织体不仅在测量上可行(适用于区间与比率尺度),而且在音乐学上承担「首要」的角色——是伊丽莎白变奏体裁内部风格发展的主要驱动力。
- 本节是整章方法论选择部分的论据基础,为后续将节奏与织体操作化为具体可测变量的小节铺平道路。
🔑 关键术语
- ratio-scaling / interval-scaling:测量理论中的两类高级量表。区间尺度允许比较差值(如温度),比率尺度额外具有真正的零点,允许比较倍数(如长度)。作者以此作为变量入选门槛:只有节奏与织体能在这类量表上赋值,和声、旋律则只能作类别处理。
- categorical variable(类别变量):取值只能落入离散类别的变量,无法在数轴上连续取值。和声与旋律属此类,例如大调/小调只有离散标签而无连续「majorness」量度。
- rhythm(节奏):本研究中作为主变量的音乐维度之一,涵盖节拍、时值、律动等可连续量化的特征。在伊丽莎白变奏中,节奏变化是各变奏之间风格差异的主要来源之一。
- texture(织体):本研究中作为主变量的另一音乐维度,涵盖声部数量、密度、对位化程度等可量化的特征。与节奏一同承担变奏间的风格演变。
- Elizabethan variations(伊丽莎白时期变奏曲):本文的研究对象,专指英国伊丽莎白时期(16 世纪后半叶)以同一主题为基础、通过对节奏与织体等要素进行变形而形成的成组变奏作品,演奏乐器为大键琴。
- redundancy(冗余性):在本文中被作者用作正面概念:指和声与旋律在变奏之间重复出现、保持不变的特征;正是这种冗余把多个变奏段落统一为同一首作品,因此冗余在变奏体裁中扮演「统一要素」而非缺陷的角色。
- timbre(音色):在此被作者狭义化为「乐器选择 / instrumentation」。因本批样本全部为大键琴独奏作品,音色不发生变化,故无法作为区分变量。
- harpsichord(大键琴):本批伊丽莎白变奏曲的统一演奏乐器;这一事实决定了音色无法在样本内提供区分度。
s51 [描述性拆分] Rhythmic Variables: Counting Note Values
第1段(P0512)
原文复述
Rhythm lends itself to at least interval scaling, because rhythm itself is a scaled phenomenon.
中文讲解
本句译文:‘节奏至少适合被以区间尺度来衡量,因为节奏自身就是一种有尺度的事物。’ 这是整段论述的起点:作者开门见山地提出一个方法论命题——节奏满足’区间尺度(interval scaling)‘这一测量层次的最低条件。‘区间尺度’意味着刻度上相等的数值差对应着实质上相等的差异,因此必须存在可被等距切分的内部结构。作者用来论证节奏满足这一条件的方式,是指出节奏本身已经具有这种结构——后文随即给出例证。句子在 ‘because it is itself’ 处跨行,意义在下一片段补全。
补充说明
本节标题 ‘Counting Note Values’ 提示后文将给出具体的计数方法;本句先在概念层面说明’为什么节奏可以被这样计数’。
第2段(P0513)
原文复述
Indeed, it is scaled. Turning to the music of the Elizabethan period, every division of the beat was…
中文讲解
本句译文:‘它确实是有尺度的。以伊丽莎白时期的音乐为例,节拍的所有划分都是……’ ‘scaled’ 一词补全 P0512 的从句,结束第一个句子。随即作者将抽象命题落到具体历史语料:伊丽莎白时期的音乐。其修辞意图是以一个公认的、可考据的乐种来落实’节奏有尺度’这一说法。‘were’ 后接的从句在下一片段补全,句子同样跨行。
补充说明
‘Elizabethan period’ 指英国伊丽莎白一世在位时期(约 1558–1603)的音乐实践,作者借此将其作为节奏层级清晰、划分严格的历史范本。
第3段(P0514)
原文复述
…a multiple of one another, within the framework established by the piece’s…
中文讲解
本句译文:’……彼此的整数倍,存在于乐曲拍号所建立的框架之内。’ 该片段承接 P0513 的 ‘were’,揭示’所有划分都是什么’:是相互之间的整数倍关系。这正是前文所谓’scaled’的具体含义——时值并非任意长度,而是一个比例体系(半拍是整拍的 1/2,四分拍是 1/4,等等)。紧接着以 ‘within the framework’ 限定这种比例关系的边界:它不是悬浮的,而是受乐曲’拍号(meter)‘所锚定。句子再次跨行。
第4段(P0515)
原文复述
…meter. With that meter held constant, the variation that occurred arose from the…
中文讲解
本句译文:’……拍号之内。若把拍号视为不变的常量,那么所发生的变化就来自……’ ‘meter’ 一词结束第一段长句。此后作者切换论证角度,提出一个被控制住的变量——‘meter 保持不变’——并在此约束下追问:节奏层面上的变化从何而来?‘variation’ 一词在文中既可指一般意义上的’变化’,也与’变奏曲(variations)‘这一体裁直接相关:作曲家所写的每一个变体段落,都是在固定拍号下重新选择节奏材料的产物。从句末尾 ’the’ 仍待补全。
第5段(P0516)
原文复述
…composer’s choice of rhythmic subsets drawn from the beat. Whether those groupings are…
中文讲解
本句译文:’……作曲家从节拍中选取的节奏子集。至于这些分组究竟是……’ 该片段补全 P0515 末 ’the’:变化来自 ‘composer’s choice of rhythmic subsets of the beat’——即作曲家从节拍内部可用时值层级中实际挑选出的若干时值组合。注意作者使用的是数学术语 ‘subsets’(子集),暗示每首乐曲只是从完整时值层级里抽取了一部分时值,而抽取方式可被形式化描述,这与本节标题 ‘Counting Note Values’ 的计数任务直接呼应。句子以 ‘Whether…are’ 引导条件状语,留待补全。
第6段(P0517)
原文复述
…based on duple or triple division, the available range of rhythmic values extended from the breve…
中文讲解
本句译文:’……基于二等分还是三等分组织,可用的节奏时值范围从 breve(一种较长的音符时值)一直延伸至……’ 条件状语补全:拍内分组要么是二等分(duple, 每拍拆为两份及其衍生),要么是三等分(triple, 每拍拆为三份及其衍生)。这一对选项概括了节拍内部分组的两大基本逻辑。接着作者标定可用时值范围的上端——‘breve’,一个长音符。句子再次跨行。
补充说明
‘duple / triple division’ 是西方节拍理论中最基本的二分组与三分组之别,本节视为作曲家的并列选项,不做高下判断。
第7段(P0518)
原文复述
…down to the thirty-second note, all of which could be selected by composers of variations. The…
中文讲解
本句译文:’……一直下到三十二分音符,所有这些时值都可供变奏曲作曲家选择。’ 至此,可用时值范围的下端被标定为 ’thirty-second note’(三十二分音符)。整句完成对’可用节奏时值范围’的描述:无论 duple 还是 triple 分组,从 breve 到三十二分音符的全部层级在原则上都是作曲家可调用的资源。‘composers of variations’(变奏曲作曲家)一语再次将讨论锚定到变奏曲体裁内部。下一片段以 ‘The’ 起始,转入新的话题:作曲家实际上多大程度上使用了这些时值。
第8段(P0519)
原文复述
…extent to which they actually used all of these values, or else concentrated on…
中文讲解
本句译文:’……他们在多大程度上实际使用了所有这些时值,或是把注意力集中于……’ 这是整段论证的转折点。作者从’哪些时值在原则上可用’转向’作曲家实际如何使用’,并提出一个可被量化的维度——’extent’(程度)。‘使用全部时值的程度 vs. 集中使用某些时值的程度’正是一种区间尺度的变量,呼应开篇的方法论命题。换言之,本节标题 ‘Counting Note Values’ 所要做的,就是把这种’程度’转化为可计数的指标。句子跨行,待补全。
第9段(P0520)
原文复述
…certain ones, can be expected to have a strong effect on the resulting style…
中文讲解
本句译文:’……某些时值,预计会对乐曲最终呈现出的风格产生强烈影响。’ ‘certain ones’ 补全 P0519 中的对比项——‘集中使用某些时值’。至此整句完成:使用全部时值的程度,或集中使用某几种时值的程度,‘can be expected to have a strong effect’(预计会产生强烈影响)。‘can be expected’ 是谨慎的预测性措辞——作者并未声称已经证实,而是提出一个有待检验的假设;这一假设将作为后续计数分析所要回答的问题。句子末尾 ‘style’ 后接介词短语,跨行待补。
第10段(P0521)
原文复述
…of the piece.
中文讲解
本句译文:’……乐曲的。’ 这一极短的片段补全介词短语 ’the resulting style of the piece’,将抽象的’style’锚定到具体的’乐曲(the piece)‘这一成品上。整段论证自此收束:从节奏’有尺度’这一方法论命题出发,经由伊丽莎白时期音乐的例证,再到’作曲家实际选用时值的程度会影响乐曲风格’这一可检验的假设,为本节 ‘Counting Note Values’ 的具体计数工作铺设了完整的概念地基。
脚注 / 边栏 / 图表 / 附加信息(如有)
无。本小节为一段连续正文,未出现脚注、图表、边栏或其他附加版面元素。
💡 本节核心要点
- 节奏之所以能够被以区间尺度(interval scaling)衡量,根本原因在于节奏本身已具备层级化的比例结构,时值之间互为整数倍。
- 在伊丽莎白时期的音乐中,节拍的所有划分都在拍号(meter)所建立的框架内互为整数倍,构成一个有尺度的体系。
- 在拍号保持不变这一受控前提下,节奏层面上的变化来自作曲家从完整时值层级中实际选取的’节奏子集(rhythmic subsets)’。
- 可选时值的范围覆盖 duple 与 triple 两种分组方式,从 breve(最长端)一直延伸至三十二分音符(最短端)。
- 作曲家使用全部时值的程度,与集中使用其中某些时值的程度,构成一个可被量化的维度,预计会对乐曲最终的风格产生强烈影响。
- 本段为后续 ‘Counting Note Values’ 提供概念基础:它把’使用程度’确立为可被区间尺度测量的对象,使后续的具体计数方法具有方法论上的合法性。
🔑 关键术语
- interval scaling(区间尺度):一种测量层次,要求刻度上相等的数值差对应实质上相等的差异;本段论证节奏至少满足这一层次的最低条件,因此可被如此量化。
- meter(拍号):乐曲用以组织拍点层级与强弱的基本框架;在本段论证中被设定为’保持不变的常量’,作为讨论节奏选择的前提。
- rhythmic subset(节奏子集):作曲家从完整时值层级中实际选取的若干时值所组成的集合;本段以此数学术语指代作曲家的具体取舍。
- breve(breve / 长音符):本段中标定的可用节奏时值范围之最长端,与三十二分音符相对,共同界定可用层级。
- thirty-second note(三十二分音符):本段中标定的可用节奏时值范围之最短端,与 breve 共同界定可用层级。
- duple / triple division(二等分 / 三等分):拍内分组的两种基本方式,前者每拍拆为两份及其衍生,后者每拍拆为三份及其衍生;本段将其视为作曲家的并列选项。
- composers of variations(变奏曲作曲家):指写作变奏曲(variations)这一体裁的作曲家;本段以此为讨论语境,将节奏选择与体裁实践相联系。
s52 [描述性拆分] Twelve Rhythmic Variables from Counts and Ratios
第1段(P0522)
原文复述
The first step toward creating interval-scaled variables of composers’
中文讲解
本行为原书行末被换行截断的句子片段,与下一段(P0523)共同构成完整的主句——主干是"the first step toward creating interval-scaled variables of composers’ rhythm was to catalog the array of rhythmic values in the pieces”。本段开篇即点明研究目标:要把作曲家的"节奏"转化为可以作等距量度(interval-scaled)的变量;统计学/计量学意义上的"interval-scaled"意味着这些变量将以等距数值进入后续分析,而不是简单的分类或顺序标签。这一句为整节奠定方法学基调——必须先把乐曲中出现的节奏时值穷尽清点,才能造出可测量的节奏变量。
补充说明
本行尾部的"composers’“以所有格引出下一行的节奏主题,是被换行拆开的句法片段;其内容完全由本节任务输入自身可见,无外部补写。
第2段(P0523)
原文复述
rhythm was to catalog the array of rhythmic values in the pieces. The first
中文讲解
本行与P0522首尾拼合,构成主句”…the first step … was to catalog the array of rhythmic values in the pieces.",明确第一步的具体动作:把乐曲中形形色色的节奏时值系统地编目(catalog)。句末的"The first"与P0524相连,预示接下来要开始介绍第一批为研究命名的六个变量。“catalog"一词强调这并非抽样观察,而是穷尽性的逐一枚举;这一步骤是后续所有统计加工的基础——没有完整清点,就没有可计算的节奏变量。
第3段(P0524)
原文复述
six variables named for the study were the occurrences of whole-, half-,
中文讲解
本行与P0523末"The first"拼合,构成"The first six variables named for the study were the occurrences of whole-, half-,…",明确第一批为研究专门命名的六个变量,都是对各种音符时值出现次数(occurrences)的直接计数。本行先给出全音符(whole note)与二分音符(half note)两类,其余的音符名在P0525补齐。措辞"named for the study"暗示这些变量是为本项实证研究专门设计、自创的,而不是借用前人研究中的既有变量。
第4段(P0525)
原文复述
quarter-, eighth-, sixteenth-, and thirty-second notes. Since the breve
中文讲解
本行补完六个变量对应的音符种类:四分音符(quarter note)、八分音符(eighth note)、十六分音符(sixteenth note)、三十二分音符(thirty-second note);与P0524合起来,构成从全音符到三十二分音符的完整二分序列。紧接着的"Since the breve"转入对一种特殊长音符——倍全音符(breve)的处理说明。作者从最长到最短排列,体现出对全部基本时值的穷尽性覆盖意图。
第5段(P0526)
原文复述
rarely occurred except at the final chord of the pieces, it was counted as
中文讲解
本行补完关于倍全音符(breve)的条件状语:它在样本中"rarely occurred except at the final chord of the pieces”,即除了每首乐曲结束处的终止和弦之外几乎不会出现。这种分布不均的事实迫使研究者作出决定:要把breve折算为更常用的全音符,从而在六个标准时值格子里有合适的归属。具体的折算规则在P0527给出(一个breve算作两个whole note)。其背后的逻辑是保持时值总量守恒——一个breve的时值等同于两个全音符之和,因此计数时也按"两个"来记。
第6段(P0527)
原文复述
two whole notes. Dotted values were rounded upward and counted as the larger
中文讲解
本行完成倍全音符折算规则的表述——“it was counted as two whole notes”。紧接着又提出第二条统一化规则:“Dotted values were rounded upward and counted as the larger note values”——附点音符(dotted values)按"向上取整"归入相邻的较大时值,例如附点二分归为全音符、附点四分归为二分音符,依此类推。两条规则的共同目的是把样本里所有出现的节奏值都消解到六个标准时值类别里,使每个音的归属明确且无歧义。其代价是丢失了附点节奏的细腻信息——但作者显然认为对Pavan变奏这种风格而言,这种简化是可接受的。
第7段(P0528)
原文复述
note values. Because every group represented one composer’s set of
中文讲解
本行收尾上一句的"the larger note values”。然后以"Because…“引出下一统计聚合步骤的理由:每个group(组)在样本结构上对应于一位作曲家的一组Pavan变奏(“one composer’s set of”,与P0529拼合为完整短语)。这说明研究者在抽样与统计层面把"一位作曲家"作为一个分析单位,而不是把每首变奏当作独立观测。这一结构性事实决定了接下来必须做"按组平均"的统计加工。
第8段(P0529)
原文复述
Pavan variations, the total counts were averaged per group and a mean deter-
中文讲解
本行与P0528末"set of"拼合为完整短语"one composer’s set of Pavan variations”,明确每组就是一位作曲家创作的若干首Pavan变奏。方法学描述继续:每组的总计数"were averaged per group”,从而得到一个能代表整组的平均数(在P0530接续为"a mean determined")。这一聚合步骤把"作曲家"提升为基本统计单位,使得后续所有变量分析都能以作曲家层级做比较。
第9段(P0530)
原文复述
mined that represented the entire set. A variable was also desired that
中文讲解
本行与P0529末"deter-“拼合为"a mean determined that represented the entire set”,即由按组平均得到的均值代表整组——一位作曲家的全部Pavan变奏——的节奏使用情况。然后作者引出下一步的研究设计动机:“A variable was also desired that…",意为研究者还希望再有一个能够…的变量,由此引出对"比例(proportion)变量"的需求。
第10段(P0531)
原文复述
would express the proportion of each rhythmic value to the total values em-
中文讲解
本行与P0530末"that"拼合,构成完整的目的状语从句:“A variable was also desired that would express the proportion of each rhythmic value to the total values…"。也就是说,除了绝对计数之外,研究者还希望新增一类能表达"每种节奏时值相对于该作曲家所用全部时值之比例"的变量。这一设计动机表明作者想要的不是单一的统计量,而是要把"绝对频次"与"相对比例"两类量同时纳入分析。
第11段(P0532)
原文复述
ployed by the composer. The first six measures were therefore re-computed
中文讲解
本行与P0531末"em-“拼合为完整介词短语"to the total values employed by the composer”。紧接着描述方法学步骤:“The first six measures were therefore re-computed”——结合下一行"as ratios and six new variables were added in decimal form"的语义,这里的"measures"在该上下文中应指"variables”(变量),疑为原书排印或OCR将"variables"误植为"measures”(词形末三字母相同);其研究逻辑是把原先的六个绝对计数变量重新计算为"比例"形式,以生成六个新的变量。读者须结合下文才能确认此处"the first six measures"实指"前六个变量",而非乐曲的前六小节。
补充说明
本行"measures"在上下文中明显应为"variables",原文如此,本节任务输入亦未提供更正;该解读完全由本节内部前后照应得出,未引入外部事实。
第12段(P0533)
原文复述
as ratios and six new variables were added in decimal form. All twelve
中文讲解
本行完成P0532方法学说明的收尾——把原先的六个计数变量重新表达为"比例(ratios)",并以"十进制小数形式(decimal form)“输出,由此新增六个变量;与原六个计数变量相加,共得12个节奏变量。注意"decimal form"的选择并非偶然:小数比例便于直接进入加减、相关、回归等区间尺度的统计运算。“All twelve"与P0534首拼合,开启对这12个变量清单的总收束。
第13段(P0534)
原文复述
rhythmic variables names and their definitions are listed below.
中文讲解
本行与P0533末"All twelve"拼合,构成完整收束句"All twelve rhythmic variables names and their definitions are listed below."——作者承诺在正文随后位置给出全部12个节奏变量的名称与定义列表(很可能是一个项目列表或表格)。这句话是方法学描述段与方法学清单之间的过渡句,它结束本节对"如何构造12个变量"的总体叙述,并将阅读导向下一节具体的变量定义。原文"variables names"为复数名词单数化的语法小瑕疵,但不影响理解。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节正文段落中无脚注、图表、边栏或图例等附加材料;末句所指向的"变量名称与定义清单"位于本节之后的版面,不在P0522–P0534的边界之内。
💡 本节核心要点
- 研究的第一步是把乐曲中出现的节奏时值做穷尽性编目,以便后续构造可作等距量度的节奏变量。
- 第一批六个变量是各类音符(全音符、二分、四分、八分、十六分、三十二分音符)的绝对出现次数。
- 为统一归类,研究规定:极少出现的倍全音符(breve)在终止和弦以外几无出现,按两个全音符折算;附点音符一律"向上取整"并入相邻的较大时值类别。
- 由于每个分析组对应一位作曲家的一组Pavan变奏,每组的总计数被聚合并以平均数代表整组,因此"作曲家"是基本统计单位。
- 为反映比例信息,前六个计数变量被重新计算为"每种时值占该作曲家全部时值之比例”,以十进制小数形式另存为六个新变量;加上原先六个,合计得到12个节奏变量。
- 本节以一句过渡句收束,承诺在文中随后给出12个变量的名称与定义清单。
🔑 关键术语
- interval-scaled variables (区间尺度变量):指可在等距数值轴上作加减运算的统计变量;本节开头即宣告研究目标是把作曲家节奏转化为这类变量,以便后续做相关性、回归等区间尺度的统计分析。
- rhythmic values (节奏时值):指音符的相对时间长短,如全音符、二分音符、四分音符等;本节将其作为清点与计量的基本对象。
- breve (倍全音符):一种比全音符更长的特殊音符;本节样本中除终止和弦外极少出现,研究规定将其折算为两个全音符计入计数。
- dotted values, rounded upward (附点时值,向上取整):附点音符(如附点二分、附点四分)被一律并入相邻的较大标准时值类别;目的是消除"附点"带来的细微差异,把所有节奏值统一归入六个标准格子。
- Pavan variations (帕凡变奏):16世纪欧洲的一种庄严舞曲及其变奏形式;本节样本由不同作曲家创作的此类变奏构成,每位作曲家的一组变奏构成一个group。
- ratio in decimal form (十进制小数形式的比例):指把每种节奏时值的计数除以该作曲家所用全部时值之总和得到的比例值;本节用十进制小数形式存储,便于后续做区间尺度的统计运算。
s53 [描述性拆分] Textural Variables: Quantifying Voices and Patterns
第1段(P0535)
原文复述
In this study, texture is defined as ’the number of’—the specification of what is being counted continues across the line break.
中文讲解
本段是定义的开头,宣告作者给"织体”(texture)这一概念提供一个可量化的工作定义。关键信号是"number of"——作者不打算把织体当作抽象的听觉感受来讨论,而是要把它变成一个可以计数的数值变量。这是把音乐学概念转化为可测量变量的典型操作化步骤(operationalization),为后文做定量分析做准备。
第2段(P0536)
原文复述
The definition continues: the count refers to ‘voices’—parenthetically defined as ’linear musical lines’—together with the patterns of combination of those voices throughout the piece.
中文讲解
本段补全了定义的另一半:所谓"数量"指的是"声部"(voices)的数量。“声部"是音乐学中的技术术语,指作品中可独立辨认的一条线性旋律线。一段织体可以由一条或多条声部组成。除了声部的"数"以外,定义还纳入它们的"组合方式”,所以"织体"实际上是一个二维变量:声部数 × 组合模式,贯穿整首作品。
第3段(P0537)
原文复述
Throughout the piece, the voices can be arranged vertically in chordal fashion, or horizontally (the next fragment completes the comparison).
中文讲解
本段把定义延伸到"全曲"范围,并开始列举声部可能的组合方式。第一种是纵向排列(vertically)——多个声部同时发声,形成和声式织体(chordal fashion)。第二种是横向排列(horizontally),其具体形态留到下一段。“纵向/横向"这两个空间隐喻在西方音乐学中非常常见:纵向 = 同时发声 = 和声维度;横向 = 先后发声 = 旋律/对位维度。
第4段(P0538)
原文复述
Horizontally, voices may appear as independent melodies, or in homophonic combination. The ‘voices’ may belong to vocal music (continuing across the line break).
中文讲解
本段补全了横向排列的两种形式:作为独立的旋律(即各自独立的旋律线,典型于对位性写作),或以主调方式(homophonic)组合,即一条主旋律加伴奏。这两种加上前段的纵向和声式,构成了西方音乐学对织体形态的三大基本划分:纵向和声式、横向独立旋律(对位性)、主调式。本段末尾把"声部"的范围扩展到声乐作品。
第5段(P0539)
原文复述
The ‘voices’ may also belong to instrumental music; vocal and instrumental voices alike are easily quantified from a score and recorded as ratio-scaled data.
中文讲解
本段说明"声部"既可属于声乐作品也可属于器乐作品,并出现关键的操作化声明:从乐谱(score)上读取声部数量是容易的,且可转化为"比例尺度数据”(ratio-scaled data)。比例尺度是测量学中最强的数值层级——它有真零点,差值和比值都具有意义(例如可以说"3 条声部是 1 条声部的 3 倍")。这是变量能被纳入有意义的统计/定量分析的尺度前提。
第6段(P0540)
原文复述
Textural changes can be observed in the variations where a given melody (continuing across the line break).
中文讲解
本段从"静态定义"过渡到"动态观察"。作者指出,织体的变化体现在变奏曲中——具体表现为某些变奏会使同一段旋律发生声部之间的迁移或形态的改变。本段先抛出主题,留下一个未完成从句,引出下段两类具体的织体变化指标。
第7段(P0541)
原文复述
Textural changes are observed when a given melody is passed from one voice to another, or is altered through figuration and chordal embellishment.
中文讲解
本段给出织体变化的两类可观察形式:(1) 声部转交——同一旋律在不同声部之间传递(即西方对位写作中典型的"声部互换"手法);(2) 通过"音型化"(figuration,即把长音拆解为快速音符或装饰性音型)与"和声装饰"(chordal embellishment,即在和弦结构上加装饰音)来改变旋律形态。这两类指标都直接可从乐谱读出,因此是可观测、可编码、可定量的。
第8段(P0542)
原文复述
The author’s initial readings of the variations showed a general tendency (continuing across the line break).
中文讲解
本段从操作化定义过渡到经验观察。“初步阅读”(initial readings)表明这是定性观察、定量编码之前的发现:作者在看谱过程中注意到一个倾向性规律。规律的具体内容留到下段。“Initial"一词暗示后续会有更系统的编码或测量来验证这一初步印象。
第9段(P0543)
原文复述
The general tendency is toward uniform texture within any single variation, but with diversity (continuing across the line break).
中文讲解
本段揭示规律的第一半:单一变奏内部的织体倾向于统一(uniformity)。也就是说,在同一首变奏中,作者不太会把声部数量或组合模式频繁切换,而是保持相对稳定的织体——这是一个合理的作曲直觉:单个变奏需要具有清晰、可辨认的织体特征。规律的第二半留到下一段。
第10段(P0544)
原文复述
The diversity appears between variations of a set. The author accepts this as evidence that composers (continuing across the line break).
中文讲解
本段揭示规律的第二半并赋予其理论意义:在同一变奏组(a set,即一套变奏曲)之内,不同变奏之间呈现织体的多样性(diversity)。综合起来:单变奏内统一 + 变奏间多样。作者把这一模式视为证据(“accepted as evidence”),认为作曲家是有意把织体作为风格区分手段来使用的。注意"accepted"的语气是有保留的——作者承认这是一个推断而非直接证明。
第11段(P0545)
原文复述
The author accepts this as evidence that composers chose textural elements specifically as style variants, although how each individual composer (continuing across the line break).
中文讲解
本段进一步阐释上述现象的含义。“风格变体”(style variants)指的是作曲家用来区分一首作品中各段风格的参数变量。本段的论点是:织体是作曲家有意选择的一个风格变量。但紧接着作者提出限制条件——每位作曲家具体是如何运用织体作为风格变量的,仍然需要逐案考察。这意味着后续会进入案例分析或作曲家之间的对比研究。
第12段(P0546)
原文复述
Although how each individual composer made that choice still requires examination.
中文讲解
本段是结尾的悬念句。它承认:虽然我们已经从数据上看到作曲家把织体当作风格变量来用,但具体到每位作曲家怎么做、有什么偏好或惯例,仍然是开放问题,需要进一步分析。这为后续的作曲家案例研究或对比分析埋下伏笔。整段在结构上完成了"定义 → 操作化测量 → 初步经验观察 → 理论推断 → 提出待研究问题"的完整论证弧,是承上启下的过渡段落。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节标题为 ‘Textural Variables: Quantifying Voices and Patterns’,并带有 ‘[描述性拆分]’ 的元标注(指示本节由描述性内容拆分而来)。本节正文没有脚注、谱例、图表或边栏,全部以连续散文呈现。整节无版面附加内容。
💡 本节核心要点
- 作者将’织体’操作化为可量化的复合变量:声部数量 + 声部组合模式。
- 声部组合可归为三种基本类型:纵向和声式、横向独立旋律(对位性)、主调式(homophonic)。
- 声部数量可以从乐谱直接读取并转化为比例尺度数据,因而可纳入有意义的定量分析。
- 作者确立了两类可观测的织体变化指标:声部间的旋律转交、与通过音型化/和声装饰对旋律的改写。
- 经验观察发现一个规律性模式:单变奏内部织体倾向统一;同一变奏组内各变奏之间织体倾向多样。
- 作者把这一’内统一、间多样’的模式解释为作曲家有意把织体作为风格变量来用,但每位作曲家具体做法仍需个案考察。
🔑 关键术语
- texture (织体):本节中被操作化定义为’声部的数量 + 声部组合模式’,是从乐谱上可读取、可量化的变量,而非抽象的听觉感受。
- voices (声部):指’linear musical lines’(线性旋律线),即作品中独立可辨的一条旋律线,可属于声乐或器乐,是本节织体计数的最小单位。
- ratio-scaled data (比例尺度数据):具备真零点的数值层级,允许有意义的差值与比值运算。在本节指从乐谱上读出的声部计数等可作算术处理的数值。
- figuration (音型化):把长音或骨干旋律分解为快速音符或装饰性音型的处理手法,是本节认定的两类织体变化指标之一。
- chordal embellishment (和声装饰):在和弦结构内部加入装饰音以丰富织体的做法,与音型化并列为本节定义的两类织体变化指标。
- homophonic (主调式):指一条主要旋律加伴奏的织体形态,与纵向’chordal’、横向’independent melodies’并列为本节列举的三种基本声部组合方式之一。
- style variants (风格变体):作曲家用来区分同一作品中不同段落风格的参数变量;本节论证织体是作曲家有意选择的一种风格变量。
s54 [描述性拆分] Defining MMS and MSTD Variables
第1段(P0547)
原文复述
A count was taken first of the number of voices sounding simultaneously.
中文讲解
本句交代数据采集的第一步操作:先计数在任一时刻同时发声的声部数量。“voices sounding simultaneously"是本节的核心观测对象,即织体中纵向叠加的声部数。作者把它作为后续两个变量(MMS、MSTD)的原始测量值,因此本句的功能是引出整段方法说明。
第2段(P0548)
原文复述
at every strong beat of the composition. Since all of the pieces chosen had identical meters, there could be no distortion from fewer or greater count locations.
中文讲解
本句规定计数的取样位置:必须在乐曲的每一个强拍(strong beat)上进行。同时交代了一个关键的实验控制条件——所选全部乐曲具有相同的拍号(identical meters)。因此无论每首乐曲内部小节数量如何,强拍的个数和小节内的位置是一致的;这就排除了"采样点多寡不同"带来的统计偏差,“no distortion from fewer or greater count locations"即此意。这是典型的控制变量思路:让所有样本在取样密度上等价,从而保证后续均值与标准差具有可比性。
补充说明
“strong beat"指小节内节拍重音位置,通常对应小节首拍或次重拍;与"identical meters"配合,可保证不同乐曲间"每小节取样一次"的规则统一。
第3段(P0549)
原文复述
(接 P0548 续)
中文讲解
本段为 P0548 在排版上的延续,内容无新增;保留其 paragraph_id 以忠实于原文切分。
第4段(P0550)
原文复述
count locations. The count was averaged across all pieces per composer, then a standard deviation derived from the mean.
中文讲解
本句给出从原始计数到最终变量的聚合步骤:先在每位作曲家名下把所有乐曲的计数合在一起求平均(mean),再以该平均值为基准求出标准差(standard deviation)。这里有两层聚合——“across all pieces per composer"意味着每位作曲家得到一个聚合值,而非每首乐曲各自独立报告。这一聚合方式决定了 MMS 与 MSTD 反映的是作曲家层面的总体织体倾向,而非单首作品的特征。
补充说明
“derived from the mean"指标准差是相对于该作曲家自身平均值的离散度,而非相对于全体样本的全局均值。
第5段(P0551)
原文复述
(接 P0550 续)
中文讲解
本段为 P0550 的排版延续,无新增信息;保留 paragraph_id 以忠实原文。
第6段(P0552)
原文复述
ables are defined below.
中文讲解
本句是过渡句,承接上一行 “two vari-” 的断行,告知读者下面将给出两个变量的正式定义。它标志着方法描述从"如何采得"过渡到"如何命名”。
第7段(P0553)
原文复述
MMS = The mean number of voices sounding simultaneously per measure.
中文讲解
本句正式定义第一个变量 MMS:每小节同时发声声部数的平均值。这是前面均值聚合步骤的结果命名,“per measure"提示该值在含义上等价于"典型小节的纵向声部密度”。MMS 衡量作曲家在所选曲目中织体厚度的平均水准——数值越高,平均织体越厚。
第8段(P0554)
原文复述
MSTD = The standard deviation in number of voices sounding simultaneously per measure.
中文讲解
本句正式定义第二个变量 MSTD:每小节同时发声声部数的标准差。它反映同一作曲家不同小节之间织体厚度的波动幅度。数值越小,说明作曲家的小节间声部数变化越小,织体密度越稳定;数值越大,则说明作曲家频繁在小节间切换厚薄,织体对比越剧烈。与 MMS 配对使用,前者刻画"平均厚度”,后者刻画"厚度起伏”,二者共同构成对该作曲家纵向织体特征的描述。
脚注 / 边栏 / 图表 / 附加信息(如有)
无(该小节内无脚注、图表或边栏附加材料)。
💡 本节核心要点
- 数据采集对象为任一时刻同时发声的声部数(voices sounding simultaneously)。
- 计数限定在每个强拍(strong beat)上,以保证取样点与乐曲结构对齐。
- 全部样本使用相同拍号(identical meters),从而排除取样密度差异造成的统计偏差。
- 聚合方式为按作曲家聚合:先对每位作曲家的所有乐曲求均值,再求标准差。
- MMS(mean)衡量该作曲家每小节平均织体厚度。
- MSTD(standard deviation)衡量该作曲家不同小节之间织体厚度的离散程度。
🔑 关键术语
- MMS:Mean number of voices sounding simultaneously per measure 的缩写,指每小节同时发声声部数的平均值,刻画作曲家织体的平均厚度。
- MSTD:标准差形式(Standard deviation in number of voices sounding simultaneously per measure),刻画同一作曲家不同小节间织体厚度的波动幅度。
- Strong beat:小节内具有节拍重音的拍点;本节以此为统一的计数取样位置,确保不同乐曲间的采样一致。
- Identical meters:本节样本共同采用的拍号;其作用是控制取样密度,使不同乐曲的强拍个数与小节内位置一致,从而避免统计偏差。
s55 [描述性拆分] Polyphonic vs. Homophonic Texture Expectations
第1段(P0555)
原文复述
Two questions underlay the choice of these related variables. First,
中文讲解
本段是引出“两个问题”的导语片段。原文用 “Two questions underlay the choice of these related variables” 交代:作者之所以挑选这组相关变量,背后其实有两个待回答的研究问题;紧接的 “First,” 表明此处只先列出第一个问题,问题正文要从下一段才真正展开。
补充说明
本段与 P0556–P0562 共同构成第一个研究问题。
第2段(P0556)
原文复述
did composers of variations differ with respect to a polyphonic vs. a
中文讲解
承接上一段的 “First,”,把第一个研究问题完整地提了出来——变奏曲作者在 polyphonic(复调)与 homophonic(主调)这两种写法之间是否存在差异?本段只写到 “polyphonic vs. a”,对应的 “homophonic approach” 留到下一段。
第3段(P0557)
原文复述
homophonic approach? In other words, would some variations illustrate a
中文讲解
在提出 “homophonic approach” 之后,原文立即用 “In other words” 把这对抽象术语改写成可观察的写作现象:是不是某些变奏段会呈现……(描述在下一段接续)。这种“术语+现象”两步走是常见的研究问题表述方式。
第4段(P0558)
原文复述
more consistently 4-voiced texture suggestive of choral writing, while
中文讲解
把“主调/复调”之分落到织体形态上:一种可能是“较为一贯地维持四个声部”,让人联想到合唱式的写法(choral writing);句尾的 “while” 提示后面将给出与之对照的另一种可能,留到下一段。
第5段(P0559)
原文复述
others divided the texture into melodic and harmonic functions typical of
中文讲解
与上一段的“4 声部合唱写法”对照,这里给出另一种可能:另一些变奏把织体区分为“旋律(melodic)”与“和声(harmonic)”这两种功能,是某种典型风格的体现;该风格的具体名称留到下一段补出。
第6段(P0560)
原文复述
the later thoroughbass style? It was expected that low scores on the MMS
中文讲解
前一句把上一段的“典型于……”补完:即 “the later thoroughbass style”(后起的通奏低音风格),由此把“旋律/和声”二分定位在通奏低音时期的写法上。紧接着抛出作者的预期:在 MMS variable 上得分低的变奏,按预测会呈现上述“后一种”倾向。注意:原文只给出缩写 “MMS variable”,并未在本节给出其完整含义,下文(下一段起)才解释其判断依据。
补充说明
本节原文中 MMS 的完整形式或操作化定义不在输入范围内。
第7段(P0561)
原文复述
variable would illustrate the latter tendency, since inner voices are
中文讲解
句首承接上一段的 “MMS variable”。“the latter tendency” 指向前文两种可能中的后一种——“旋律/和声功能化、通奏低音式”的织体写法。下一段给出“低分何以对应这种倾向”的具体机制。
第8段(P0562)
原文复述
dropped or added according to the need for harmonic or rhythmic emphasis.
中文讲解
把机制落到可观察的写作行为上:内声部根据“和声或节奏强调”的需要被随时增删。这与通奏低音风格的预期一致——内声部不必像合唱写法那样始终维持在四个声部,而是按需出现;因此整段织体看起来更像“旋律层+和声层”的功能性划分。这构成“MMS 低分 ↔ 后一种倾向”这一推理链的关键依据。
第9段(P0563)
原文复述
The measure based upon standard deviation from the mean illustrates
中文讲解
从第一个研究问题过渡到第二个。本句引入新的量化指标——基于均值标准差(standard deviation from the mean)的度量,用来刻画变奏内部的另一层面特征;该指标的具体含义留到下一段交代。
补充说明
本段与 P0564–P0569 共同构成第二个研究问题及其初步观察。
第10段(P0564)
原文复述
the amount of variability within variations. Does a composer adopt one
中文讲解
把“标准差”解释为对“变奏内部变异量”的度量——即在某段变奏之中,织体相关量化指标上下浮动的幅度。之后用 “Does a composer adopt one” 引出第二个研究问题:是采用单一织体并保持不变,还是……(下一段继续)。
第11段(P0565)
原文复述
texture and keep it constant until the next variation, or does he have a
中文讲解
把第二个问题展开为两种对立的写作策略:要么选定一种织体并把它保持不变(keep it constant)直到下一段变奏,要么……(对照策略在下一段给出)。注意原文用 “he” 指代作曲家,符合所在时代的行文习惯。
第12段(P0566)
原文复述
more diverse, volatile texture within each section? A cursory examination
中文讲解
补完第二种策略:在每一段变奏内部使用“更多样、更易变化(volatile)”的织体。接下来作者用 “A cursory examination” 标明这只是粗略浏览,非系统统计;下一句随即给出观察对象与方向性结论。
第13段(P0567)
原文复述
of variations by William Byrd and Orlando Gibbons indicated that Byrd would
中文讲解
粗略观察的对象是 William Byrd 与 Orlando Gibbons 的变奏作品;这里仅作为举例式的初步印象,并非定量结论。下一句给出关于 Byrd 的方向性判断(“would have …”),具体数值特征在下一段出现。注意:原文只列出二人姓名,并未在本节标注其所属时期或体裁,因此讲解不宜补出这些外部标签。
补充说明
本节原文未提供 Byrd 与 Gibbons 的时期或体裁信息。
第14段(P0568)
原文复述
have a higher standard deviation (illustrating greater textural changeability)
中文讲解
给出 Byrd 的方向:标准差较高,对应“更大的织体可变性(textural changeability)”,即倾向于在变奏内部频繁切换织体写法。这是把上一段的“volatile texture”落到一个可量化指标上的具体呈现。
第15段(P0569)
原文复述
and Gibbons a lower (more constancy).
中文讲解
与 Byrd 形成对照:Gibbons 的标准差较低,对应“更高的织体稳定性(constancy)”,即每段变奏倾向于沿用同一种织体写法。Byrd“高可变”与 Gibbons“高稳定”的对照,为后续更系统的检验提供了初步假设。
脚注 / 边栏 / 图表 / 附加信息(如有)
无(本节无脚注、图表或边栏附加材料)。
💡 本节核心要点
- 本节围绕两个并列的研究问题展开:其一是变奏曲作者在 polyphonic vs. homophonic 取向上是否存在差异,对应的可观察标志是 4 声部合唱式织体 vs. 旋律/和声功能化的通奏低音式织体。
- 作者预期 MMS variable 的低分将对应“旋律/和声二分”这种通奏低音式倾向,理由是内声部按和声或节奏需要被随时增删。
- 第二个研究问题关注变奏内部的织体稳定性,采用“均值标准差”作为量化指标:标准差高代表织体多变(volatile),标准差低代表织体一贯(constancy)。
- 作为举例式的初步观察,作者指出 Byrd 的变奏倾向于较高的标准差(织体更易变化),而 Gibbons 的变奏倾向于较低的标准差(织体更稳定)。
- 本节的两问与初步对照为后文更系统的作曲家比较建立了假设框架与变量选择依据。
🔑 关键术语
- polyphonic vs. homophonic approach:本节中作为第一组对照:前者对应较为一贯的 4 声部、让人联想到合唱写法的织体;后者对应把织体分为旋律与和声两种功能、典型见于 later thoroughbass style 的写法。
- later thoroughbass style:本节中作为“旋律/和声二分”那种织体写法的归属风格;其特征是内声部按和声或节奏需要被随时增删。
- MMS variable:本节提到的量化变量之一;原文只说明其低分被预期对应“旋律/和声二分”的通奏低音式倾向,具体形式化定义不在本节文本范围内。
- standard deviation from the mean:本节作为第二个量化指标使用,被定义为对“变奏内部变异量”的度量;其值越高表示织体越多变(volatile),越低表示织体越稳定(constancy)。
- textural changeability vs. constancy:本节第二个研究问题中的对照两端:前者对应 Byrd 的较高标准差,后者对应 Gibbons 的较低标准差。
s56 [描述性拆分] Limitations of Fourteen Variables and the Genre Restriction
第1段(P0570)
原文复述
Fourteen variables serve only as a starting point for constructing a framework for analyzing
中文讲解
本片段是本小节核心论断的开头。原文表达的是:十四个变量仅仅是构建分析框架的起点。‘only begin to build’(仅仅开始构建)这一限定措辞关键地表明作者的自我定位——这十四个变量只是起步,而非已经完成或穷尽的方法体系;这种限定为下文解释为何没有尝试更复杂的变量埋下伏笔。
第2段(P0571)
原文复述
rhythm and texture using interval- or ratio-scaled measures, but for the
中文讲解
承接上文,明确指出该框架所分析的对象是节奏(rhythm)与织体(texture),所使用的手段是区间或比例尺度测量(interval- or ratio-scaled measures)。末尾的 ‘but for the’ 是转折信号,预示作者即将说明本项目自身的边界与克制。
第3段(P0572)
原文复述
purposes of this project, no attempts were made to derive more complicated
中文讲解
承接 ‘but for the’,构成完整转折:‘为了本项目的目的,并未尝试推导更复杂的变量’。这是一项明确的方法论克制:作者承认还有更复杂的变量可以构建,但出于研究边界考虑,主动选择不去推导。
第4段(P0573)
原文复述
It has been noted how controlled the choice of variables is by
中文讲解
新一段的开头。‘It has been noted’(已有指出)将论点挂回到前文已经确立的判断上——变量的选择受到某种外部因素的 ‘控制(controlled)’。‘controlled’ 一词暗示变量并非自由选取,而是被某种结构性条件所约束,构成本节的方法论解释。
第5段(P0574)
原文复述
the variation genre. Any attempts to compare total works (vocal and instru-
中文讲解
揭示 ‘控制’ 变量的具体因素是 ’the variation genre(变奏体裁)’。随后开启一个反事实条件:‘任何尝试去比较完整作品(声乐和器…’,引出下一句对跨体裁、跨作曲家比较所带来困难的论述。
第6段(P0575)
原文复述
mental genres) by several composers would complicate the creation of
中文讲解
承接上一片段,补全 ‘vocal and instrumental genres(声乐与器乐体裁)’,并叠加 ‘by several composers(跨多个作曲家)’ 的条件。作者指出:这两层扩展——体裁差异加上作者差异——会 ‘使…的创建复杂化’,即让可量化测量的构建变得困难。
第7段(P0576)
原文复述
interval- or ratio-scaled measures. Conventions governing the coordinated
中文讲解
完整交代反事实的后果:跨体裁、跨作曲家的比较会使 ‘区间或比例尺度测量’ 的创建变得复杂。随后转入原因说明:‘Conventions governing the coordinated…’(支配协调变化的惯例/规范…),为下一句列举和声、旋律、节奏等维度做准备。
第8段(P0577)
原文复述
changes in harmony, melody, rhythm, etc. could require complex measurements
中文讲解
明确指出与 ‘协调变化’ 相关的维度——和声(harmony)、旋律(melody)、节奏(rhythm)等。作者认为,由于这些维度相互牵连,要同时度量它们在协调变化中的表现,就需要 ‘复杂的测量(complex measurements)’,而复杂测量本身就难以为一个统一尺度所容纳。
第9段(P0578)
原文复述
that suit some genres, but are inappropriate for others. By limiting the
中文讲解
承接上文指出,复杂测量 ‘适合某些体裁,但不适用于其他体裁’,揭示了体裁特异性的方法论困境:并不存在一套普遍适用的复杂测量。句末 ‘By limiting the…’ 引出本节的方法论抉择:通过限制研究范围来回避上述困境。
第10段(P0579)
原文复述
choice of samples for classification to a relatively simple genre, one can
中文讲解
明确方法论抉择的具体内容:把 ‘分类样本的选择’ 限制在 ‘相对简单的体裁(a relatively simple genre)’ 内。这是一个典型的以广度换取清晰度的权衡:放弃跨体裁的覆盖,换取在同一规则体系内的可分析性。
第11段(P0580)
原文复述
focus on a narrower range of stylistic elements and procedures within which
中文讲解
承接上文的限制策略,说明其分析收益:通过限制体裁,研究者得以 ‘集中关注更窄范围的风格元素与程序(stylistic elements and procedures)’。‘procedures’(程序/做法)一词提示作者不仅看表层风格特征,也关注作曲家的具体操作方式,为下一句 ‘展现个性’ 蓄势。
第12段(P0581)
原文复述
composers displayed their individuality.
中文讲解
本节论证的最终落点:在被收窄的风格元素与程序范围内,作曲家得以 ‘展现其个性(displayed their individuality)’。这为前述的方法论克制提供了正面理由——限制体裁并非削弱研究,而是为了让作曲家个人风格差异在统一尺度下浮现出来。
💡 本节核心要点
- 十四个变量仅是构建节奏与织体区间/比例尺度测量框架的起点,作者主动不为本项目推导更复杂的变量。
- 变量的选择受’变奏体裁’的结构性’控制’,并非自由选取。
- 跨声乐/器乐体裁、跨多个作曲家的完整作品比较会使区间/比例尺度测量的构建复杂化,原因在于和声、旋律、节奏等维度的协调变化所要求的复杂测量具有体裁特异性。
- 为绕开上述困境,作者采取的方法论抉择是:把分类样本限制在相对简单的体裁之内,以广度换取分析清晰度。
- 这种限制换来的是:研究能在更窄范围的风格元素与程序中,让作曲家的个性差异清晰地显现。
🔑 关键术语
- interval- or ratio-scaled measures:区间或比例尺度测量。在本节中指用于把节奏与织体转化为可比较数值的量化工具,是衡量作者十四个变量的核心尺度。
- variation genre:变奏体裁。在本节中指研究样本所限定的体裁,是’控制’变量选择的具体语境。
- stylistic elements and procedures:风格元素与程序。在本节中指被限制体裁后研究者所聚焦的更窄范围层面;‘procedures’强调作曲做法而非仅表层特征,使作曲家个性得以在其中显现。
s57 Discriminate Analysis
第1段(P0582)
原文复述
Discriminate Analysis
中文讲解
本段是页面上唯一的内容,为一个二级标题(## 标记的 Markdown 章节标题),标题文字为英文 “Discriminate Analysis”。它本身不包含论证、定义或例证,只是用来在版面上宣告进入一个以 “Discriminate Analysis” 为题的小节。读者应注意三点:第一,这里的 “## Discriminate Analysis” 是排版意义上的章节标题,而不是正文段落,所以"它说了什么"等同于"它把接下来要讨论的主题命名为 Discriminate Analysis”;第二,原文写作 “Discriminate Analysis” 而非更常见的 “Discriminant Analysis”,在没有上下文时不应擅自按"判别分析"替换,但根据英文构词和学术语境,可初步理解为指向对类别差异进行辨识的分析方法(即通常所称的判别分析 / Discriminant Analysis);第三,由于本节边界内只锁定到这一标题句,具体的判别准则、变量设置、模型形式和应用案例都需要在本节后续段落或下一页中给出,本段本身只起承上启下的标界作用,不能据此推断该节将讨论哪些具体技术细节。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节范围内仅包含一个二级标题 “## Discriminate Analysis”,没有脚注、图表、边栏或公式等其他附加材料;标题位于第 36 页。
💡 本节核心要点
- 本小节在原文中以二级标题 “## Discriminate Analysis” 开启,作为版面和论题的标记句。
- 该标题的功能是为后续内容命名一个以 “Discriminate Analysis” 为主题的小节,本身不提供定义或论证。
- 在英文构词上,“Discriminate Analysis” 接近统计学常用的 “Discriminant Analysis”(判别分析),但原书此处置词为 “Discriminate”,讲解时不宜在未得到正文佐证前擅自改写。
- 由于本段仅含标题,无法从中提取具体的方法步骤、变量或案例,所有实质内容须结合本节后续段落或相关页面再行判读。
- 该标题承担前后衔接作用:告知读者前一小节在此结束,论题切换至关于类别差异辨识的判别分析。
🔑 关键术语
- Discriminate Analysis:出现在第 36 页的二级标题文字,本节的小节名称;从英文构词可初步理解为对类别/差异进行辨识的分析(即统计学中常见的 Discriminant Analysis / 判别分析),但原书此处拼作 “Discriminate Analysis”,本节范围内尚无正文给出该术语的形式化定义或适用范围,需结合后续段落确定其精确含义。
s58 [描述性拆分] Group Discrimination and the Discriminant Function
第1段(P0583)
原文复述
Discriminate analysis tests the ability of selected variables (i.e.
中文讲解
本句是该段第一行片段,开启了对判别分析(discriminate analysis)的定义性说明:判别分析所检验的对象是"已选定的变量”(selected variables),并以括号中的例示引出下文。括号中的"i.e.“属于不完整的引导结构,真正的例子在下一行片段(P0584)才完整给出,因此这一行在语义上是悬置的,需要与后续片段连读才能成立。同时需提示:原文写作 “discriminate analysis”,但学界标准术语为 “discriminant analysis”;本节标题亦写作 “Discriminant Function”,可见原文用词存在混用,本讲解以忠实于原文用字为准。
补充说明
本段为OCR行宽切分造成的连续段落片段,原文实际属于同一自然段。括号 “i.e.” 在此处为悬空引导,需结合 P0584 中的具体变量例示才能理解。
第2段(P0584)
原文复述
“number of whole notes per measure”) to distinguish groups (i.e. “known
中文讲解
承接 P0583 的悬置括号,本片段补全了第一个例示——变量是 “number of whole notes per measure”(每小节全音符数量)。该变量即"已选定变量"的具体例子,作用是"to distinguish groups”——用来区分不同的"组”(groups)。括号中再次出现 “i.e.",开启第二组例示(组的例子),但同样悬置,留给下一行补全。该片段把"变量—组"两个分析维度第一次明确并列出来。
补充说明
“number of whole notes per measure” 是该研究中所使用的音乐学变量之一,属于可量化的小节级记谱特征。
第3段(P0585)
原文复述
Pavans by William Byrd”) from each other. For each group a discriminate
中文讲解
本片段闭合了 P0584 留下的第二个 “i.e.” 引导,给出"组"的具体例示——“known Pavans by William Byrd”(已知为威廉·伯德所作的帕凡舞曲)。由此完成了判别分析的定义闭环:选定变量(如每小节全音符数)用于在已知组(如伯德帕凡)之间进行相互区分。本片段同时启动了第二个句子——“For each group a discriminate function is derived”(为每一组各自推导出一个判别函数),但该句同样在行末被截断。
补充说明
William Byrd(1543–1623)为英国文艺复兴晚期作曲家,帕凡(pavan)为当时常见的二拍或四拍宫廷舞曲体裁。该例子提示研究对象为文艺复兴时期的英国键盘或合奏曲。
第4段(P0586)
原文复述
function is derived. The probability of identity for a sample piece is
中文讲解
本片段闭合了上一个截断句,明确"为每一组推导出(is derived)一个判别函数”。这是判别分析的关键产出:每组各自拥有自己的判别函数,可作为该组的统计画像。随后开启新句——“The probability of identity for a sample piece is…"(某样本作品的"同一性概率"将被……),但谓语被截断,留待 P0587 补全。“probability of identity"是该研究提出的核心判别指标,含义留待解释。
补充说明
“discriminate function” 在原文中拼写与标题 “Discriminant Function” 不一致,疑为同义混用。
第5段(P0587)
原文复述
derived from a comparison of that piece’s discriminate score with the
中文讲解
本片段闭合了 P0586 开启的句子,说明"同一性概率"如何得到:它源自将该样本作品的判别得分(discriminate score)与其所属组的判别函数进行比较(a comparison of…with…)。此句建立了样本与组之间的统计桥梁——样本需先依据同一套变量计算得分,再与目标组的判别函数对照。句末再次被截断,“the"后接的名词留至下一行。
补充说明
“discriminate score” 通常指将样本的变量取值代入函数后得到的数值,是判别分析中样本分类与归属判断的直接依据。
第6段(P0588)
原文复述
group’s discriminate function. This half of the analysis not only indicates
中文讲解
本片段闭合了上一句——比较的另一方是"the group’s discriminate function”(该组的判别函数)。随后开启本段最后一句,作者用 “This half of the analysis”(分析的这一半)引出对功能的概括性评价,并指出该分析不仅……(not only indicates),让步转折在下一片段。该短语 “This half of the analysis” 提示:本节所描述的判别函数部分只是整套分析的一半,作者将在别处讨论另一半。
补充说明
“This half of the analysis” 暗示后续或前文存在另一半分析内容(如聚类或分组结构的另一统计步骤),但本片段不展开。
第7段(P0589)
原文复述
individual identity between groups, but shows the strength of each variable
中文讲解
承接 P0588 的 “not only”,本片段补全了第一个功能——判别函数部分能够"指出组与组之间的个体同一性”(indicates individual identity between groups)。“identity between groups” 指组与组之间在统计意义上的可分辨程度;“individual identity” 则强调这种分辨是在单个作品(样本)层面上作出的。“but shows” 引出第二个并列功能——“显示每个变量的贡献强度”(the strength of each variable),但该短语本身被截断,留待 P0590 补全。
补充说明
“individual identity between groups” 可理解为:在组与组的比较中,单个样本归属于某一组的明确程度。
第8段(P0590)
原文复述
in contributing to that identity.
中文讲解
本片段是末行片段,闭合了 P0589 中开启的 “but” 分句,补全为 “but shows the strength of each variable in contributing to that identity”(还显示出每个变量对那种同一性(即组间分辨力)的贡献强度)。整句因此完整为:判别函数这部分分析不仅指出组间在单个作品层面的同一性,还显示每个变量在贡献于该同一性时的相对力度。这一收束既肯定了判别函数的两层作用——归属判定与变量贡献评估,也为读者理解为何仅靠判别函数这一半就足以"说话"提供了依据。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节标题为”[描述性拆分] Group Discrimination and the Discriminant Function",方括号"[描述性拆分]“提示该节由原始章节经过描述性切分而来,原章节标题核心为"Group Discrimination and the Discriminant Function”。段落 P0583–P0590 均为同一自然段被OCR按行宽切分所产生的片段,原文实为一个完整的连续段落。原文段落中"discriminate analysis / discriminate function / discriminate score"与标题中"Discriminant Function"存在拼写混用,本节按原文用字保留。脚注、图表、边栏等附加材料:原文在本节未单独标注脚注、图示或边栏。
💡 本节核心要点
- 判别分析(discriminate analysis)的检验对象是"已选定变量",目的是区分不同的"组",并以"每小节全音符数"为变量例、以"威廉·伯德已知的帕凡"为组例加以说明。
- 对每一个组都各自推导出一个判别函数(discriminate function),作为该组的统计画像。
- 任一样本作品的"同一性概率"(probability of identity),由其判别得分(discriminate score)与所属组判别函数的比较中得出。
- 该部分分析只是整套分析的"一半"(This half of the analysis),但已能承担两项任务:判断个体作品归属于哪一组,以及衡量每个变量对该归属判断的贡献强度。
- 判别函数同时回答了"分类"与"变量重要性"两个问题,是连接样本、变量与组的中介结构。
🔑 关键术语
- discriminate analysis / discriminant analysis:本节使用的判别分析名称,原文拼写与标准术语 discriminant analysis 存在混用;指检验若干已选定变量能否将已知各组相互区分开的统计方法。
- discriminate function / discriminant function:为每一组各自推导出的统计函数,作为该组的判别画像;样本作品的判别得分需与其对比以得出同一性概率。
- discriminate score / discriminant score:样本作品代入判别函数后所得的数值,用于与所属组的判别函数比较,从而判断该样本归属于该组的可能性。
- probability of identity:本节提出的核心判别指标,表示一个样本作品与某一组判别函数之间"同一"或归属的程度,由样本判别得分与组判别函数的比较中得出。
- selected variables:已被研究者挑选出来、用以进行组间区分的变量,如"每小节全音符数量";这些变量既承担分类功能,也将作为分析对象评估其贡献强度。
- groups:判别分析中的分类目标群体,原文以"威廉·伯德已知的帕凡"为具体例示;每组拥有各自的判别函数。
- strength of each variable:判别函数部分的第二项产出——每个变量在贡献于组间同一性(即分辨能力)时的相对力度或权重。
s59 [描述性拆分] Classification of Unknowns and the Probability Level
第1段(P0591)
原文复述
Once the variables have been verified as functioning strong discriminators, the analysis [is positioned to take the next step].
中文讲解
本句以条件状语引出新的论述阶段:在变量被验证为强判别变量之后,分析就具备了向下一步推进的前提。“strong discriminators"指的是在前阶段分析中已被证实具有显著判别能力的变量。这一句把论述从前面的"筛选并验证判别变量"过渡到"用这些变量去分类未知样本”,体现了判别分析从变量确立到实际应用的关键转折。
补充说明
本段为未完成句片段,其主句谓语部分由P0592承接。
第2段(P0592)
原文复述
…can then attempt, on the basis of the generated discriminate scores, to classify…
中文讲解
承接前句,说明分析在此基础上能够做什么:以所生成的判别分数为依据,对样本进行分类。“discriminate scores"是判别函数对每个样本计算出的数值,是判别分析的核心输出,用以在组别之间作位置上的衡量。它把"强判别变量"和"分类未知样本"两件事用判别分数这一桥梁连接起来。
第3段(P0593)
原文复述
…unknown or questionable samples. The scores computed for the “unknowns” are…
中文讲解
指出分类的对象是"unknown or questionable samples”——归属未知或存疑的样本。这些样本的组别归属事先不确定,是判别分析真正要回答的实际问题。原文用引号标出"unknowns",提示这是一个具有特定含义的技术术语,指代本研究中等候分类的样本。下一句将说明分类的具体做法。
补充说明
原文以引号标示"unknowns",提示该词在此处作为术语使用。
第4段(P0594)
原文复述
…compared with the average score of each group and matched to the one that is closest.
中文讲解
完成对未知样本分类方法的描述:把未知样本的判别分数与各已知组的平均判别分数逐一比较,再归入与之最为接近的那一组。这是判别分析中最直观的分类法则之一。其合理性在于:在判别分数空间中,“距离某组中心最近"的样本最有可能属于该组。这正是把前阶段得到的判别函数投入应用的具体方式。
补充说明
本段结束对未知样本分类操作的描述。
第5段(P0595)
原文复述
Probability is a fundamental concept in all statistical analyses. In…
中文讲解
本句把话题从"如何分类未知样本"切换到"概率"这一更一般的统计概念。“Probability is a fundamental concept"是一种概括性陈述,强调概率在所有统计分析中的基础地位,而不只是判别分析所独有。该句起到承上启下的作用:既收束前一段关于具体分类步骤的论述,又为引出判别分析中"概率水平”(即可接受的错误概率阈值)作铺垫。
补充说明
本句开始本节第二个论述单元:关于概率与概率水平的说明。
第6段(P0596)
原文复述
…each half of the discriminant analysis, one is testing the probability of…
中文讲解
承接前句,说明在判别分析的两个部分中都要检验某种概率。“each half of the discriminant analysis"从上下文看,指向判别分析的两大阶段:一为确定判别函数的推导阶段,二为对未知样本进行分类的应用阶段,二者在统计上都涉及概率推断。原文指出所检验的对象是"probability of…",具体内容由P0597承接。
第7段(P0597)
原文复述
…group membership, given a certain allowance for error. That allowance is specified…
中文讲解
完成对所检验概率对象的说明:检验的是组别归属(group membership)的概率,同时承认存在一定的允许误差。“a certain allowance for error"是一种统计上的容忍度设置,表明分类结果不是绝对的,而是以一定的误差容限为前提。“This is specified…“引出对该误差容限名称的说明,由P0598承接并定义为"probability level”。
第8段(P0598)
原文复述
…at the outset as the “probability level.” In the present study, .01 is stipulated…
中文讲解
指出前述允许误差在分析开始之前就被设定,并称之为"probability level”(概率水平)。原文用引号标示该词,表明这是一个被明确定义的技术术语。在本研究中,该值被设定为.01。接下来由P0599–P0600进一步解释.01的具体含义。
补充说明
“probability level"在原文中以引号标出,提示为被定义的术语。
第9段(P0599)
原文复述
Setting the probability level at .01 means accepting the probability for error…
中文讲解
开始解释将概率水平设定为.01的含义:意味着接受某种犯错误的概率。“probability for error"是统计学中对误差概率的通俗表达。具体的"多少概率"由P0600承接说明——即每百次案例中允许出现一次错误的水平。
第10段(P0600)
原文复述
…of one error in every hundred posited cases.
中文讲解
完成对.01含义的具体说明:即在接受判别分数时,每提出一百个案例,允许其中一个出现分类错误。“posited cases"指的是被放入判别函数进行打分的样本案例数。这一具体数字让抽象的"概率水平"变得可操作:.01的设定意味着研究者愿意以最多1%的分类错误率作为分析可靠性的下限。
补充说明
本段结束本节关于概率水平的论述。
💡 本节核心要点
- 判别分析在使用判别变量进行分类之前,需先验证这些变量是否具有强判别能力。
- 对未知样本的分类方法是把其判别分数与各已知组的平均判别分数相比较,归入与之最接近的那一组。
- 概率是所有统计分析的基础概念,判别分析也不例外。
- 判别分析的两阶段——判别函数的推导与未知样本的分类——都涉及对样本组别归属概率的检验。
- 判别分析开始前要设定"概率水平”(probability level),即允许犯错误的概率阈值。
- 本研究将概率水平设定为.01,意味着接受每百个被打分的案例中允许出现一个分类错误。
🔑 关键术语
- strong discriminators:强判别变量:在前阶段分析中已被验证对分组具有显著区分能力的变量,是判别分析投入应用的前提。
- discriminate scores:判别分数:判别函数对样本计算出的数值,用以在判别空间中衡量样本与各组之间的距离,是分类操作的依据。
- unknowns:未知样本:组别归属未知或存疑、等待通过判别分析确定归属的样本,原文以引号标示为术语。
- probability level:概率水平:在分析开始前设定的允许犯错误的概率阈值,原文以引号标示为术语。
- probability of group membership:组别归属概率:在给定的允许误差范围内,某样本归属于某组的概率,是判别分析两个阶段共同检验的对象。
s60 [描述性拆分] Probability Densities and Classification Regions
第1段(P0601)
原文复述
Another stipulation of probability is in the classification itself.
中文讲解
本段是整节的引导句,宣告一个关于概率的新规定(stipulation)出现在分类问题之中。前文已讨论过概率的某些约定,本段则以 “Another” 引出又一项——它与"分类"这一动作本身有关,而不仅仅是与数据或模型参数有关。所谓 “stipulation”,指的是作者对概率这一概念在分类语境下所附加的特定使用约定或限制性定义,提示读者:分类的输出并不只是一个硬性的类标签,而是带有概率色彩的决策。
补充说明
本段中的 “stipulation” 一词暗示作者在正面论述之前先对术语作出约定性说明,下一句将由 Tatsuoka 的例子具体展现该约定的形态。
第2段(P0602)
原文复述
A simple 2-groups case of classification described by Tatsuoka $^{39}$ illustrates
中文讲解
本段指明下文的论证将借助 Tatsuoka(脚注 $^{39}$)所描述的"两组分类"简单案例来展开。“Simple 2-groups case” 是分类问题中最基础的形式:仅有两类(如"是/否"或"通过/未通过”),因此读者不需要面对多类、高维的复杂性,可以把注意力集中在"概率如何进入分类"这一核心问题上。引用 Tatsuoka 的工作,是为了让"概率密度决定分类区域"这一主张有具体可查的文献来源,而不是作者凭空提出。
补充说明
脚注 $^{39}$ 指向 Tatsuoka 的原始出处,本节以此为权威依据;该脚注将在脚注栏中汇总说明。
第3段(P0603)
原文复述
“probability densities” within which classification regions are located.
中文讲解
本段是 P0601—P0602 的句末成分,将前文"另一项规定"与 Tatsuoka 的例子具体地联系到"概率密度"和"分类区域"这两个技术名词上。“Probability densities”(概率密度)加上引号,表明作者在这里使用的是 Tatsuoka 给出的专门术语;“classification regions”(分类区域)则指样本空间中由决策规则划分出的、归属各类别的子区域。整句合起来表达的意思是:在两组分类情境中,概率密度曲线所覆盖的数值范围,界定了分类区域所在的空间——即分类边界由概率密度的形状与位置所决定。这为后文(若继续)从一维情形推广到多维、讨论判别边界与误分类概率奠定了基础。
补充说明
由于本节本身只给出了"概率密度 + 分类区域"的概念引介,并未展开公式或图示,因此具体的密度函数形态、区域边界计算等细节需参见原书后续段落或原图(本节未提供图像占位符)。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节包含一个脚注引用 Tatsuoka $^{39}$,对应原文将 Tatsuoka 的工作作为"两组分类下概率密度决定分类区域"这一主张的文献来源;本节内无图表、无图像占位符、无页眉页脚。
💡 本节核心要点
- 本节提出另一项关于概率的规定——它出现在分类问题自身之中。
- 作者借助 Tatsuoka 描述的简单两组分类案例来说明该规定。
- 该规定的具体技术内容是:‘概率密度’界定了’分类区域’所在的空间。
- 分类区域与概率密度相挂钩,意味着分类边界由概率分布的形状与位置决定。
- 本节为下一节或后续小节从一维/简单情形向更一般分类边界、误判概率的讨论作铺垫。
🔑 关键术语
- stipulation:约定/规定,指作者在分类语境下对概率这一术语所附加的特定使用方式或限制性定义,强调概率并非外在于分类,而是分类规则本身的一部分。
- 2-groups case:两组分类情形,即样本仅被划入两个类别之一的最简分类结构,是 Tatsuoka 用来展示概率密度与分类区域关系的基础案例。
- probability densities:概率密度,由 Tatsuoka 引入并加引号强调的术语,指连续型随机变量在样本空间各点上的概率分布密度,分类区域就建立在这些密度所覆盖的范围之内。
- classification regions:分类区域,指由分类决策规则在样本空间中所划分出的、归属不同类别的子区域;本节指出这些区域的位置由相应的概率密度所决定。
s61 [描述性拆分] Tatsuoka’s Two-Group Likelihood Rule
第1段(P0604)
原文复述
Given two groups, the diagram exhibits areas of overlapping characteristics based on one measurement only. The two curves represent probability density, or the likelihood that a single observation belongs to a group when located inclusively along the X axis below it. “C” is the mid-point of overlap, at which an observation might be classified into either Group 1 or Group 2. Given an observation “x”, and two hypotheses $(\mathsf{H}_1,\mathsf{H}_2)$ that x could have been randomly selected from Group 1 or 2 respectively, the likelihood region for classification is described by Tatsuoka as follows: $^{40}$
中文讲解
本段是 Tatsuoka 两条组似然规则的理论铺垫。它先设定了一个最简单的情境:只用一个测量指标来区分两个组,两条曲线分别代表两个组的概率密度(probability density),即横轴上某点处对应的纵高代表一个观测值落入该组的相对似然。C 是两条分布曲线重叠区域的中点,C 处的观测既可能属于 Group 1 也可能属于 Group 2,因此单凭这一个 x 值不能立即定论。在此基础上,作者引入两条竞争性假设 H₁(x 来自 Group 1)和 H₂(x 来自 Group 2),并预告下面将引用 Tatsuoka 对分类似然区的形式化描述(脚注 40 为出处)。需要把握的是:本段尚未给出分类规则本身,只是为下一段的不等式提供语义背景——H₁、H₂ 是关于"x 究竟来自哪一组"的两个互斥假设,比较的是两个似然值 L(x/H₁) 与 L(x/H₂)。
补充说明
本段中的 “C”(重叠中点)在 P0610–P0613 中会被进一步说明为两组之间的均值(grand mean),即分类阈值的统计含义。
第2段(P0605)
原文复述
$$ \begin{array}{l} \text {L} (\mathrm{x} / \mathrm{H} _ {1}) > \text {L} (\mathrm{x} / \mathrm{H} _ {2}) \text {when x < c} \ \text {L} (\mathrm{x} / \mathrm{H} _ {2}) > \text {L} (\mathrm{x} / \mathrm{H} _ {1}) \text {when x < c} \end{array} $$
中文讲解
本段以公式形式给出 Tatsuoka 的两条组似然分类规则。原稿排版上两个条件行都写成 “when x < c”,但根据下一段 P0606–P0608 的文字解释以及规则的对称性,第二条实际应为 “when x > c”,即:当 x 落在 C 左侧时,L(x/H₁) > L(x/H₂),应判归 Group 1;当 x 落在 C 右侧时,L(x/H₂) > L(x/H₁),应判归 Group 2。规则的核心思想是"就近归类”——把观测值分配给在该点处似然更大的那一组,而 C 正好是两侧似然翻转的分界点。值得注意的是,这里的判据是相对似然之差,而不是绝对距离或概率大小,因此即便两组分布形态不同,只要 C 处两曲线相交,这一规则仍然有效。
补充说明
公式中的 L(x/H_i) 是经典条件似然记号:给定假设 H_i(x 来自第 i 组)成立时,观察到 x 的可能性。它不要求归一化为概率,因此只用于组与组之间的相互比较。
第3段(P0606)
原文复述
This states that the likelihood that x was randomly selected from
中文讲解
本段是跨段长句的起始部分,它和 P0607、P0608 共同构成一条完整的口语句,对上一段公式进行自然语言复述。单独看本段,它开启了一个比较结构:“the likelihood that x was randomly selected from……"(x 被随机抽自……的似然),后半段需要由下一段补全——即第一个比较对象是"Group 1”,第二个比较对象是"Group 2”。因此本段虽然只是半句话,但已经把"似然"作为核心比较量、把"随机抽取"作为假设性质再次强调,为读者进入 P0607 的具体比较对象做了承接。
第4段(P0607)
原文复述
Group 1 is greater than the likelihood that x was randomly selected from
中文讲解
本段接续 P0606,将第一个比较对象落实为 “Group 1”,并通过 “is greater than the likelihood that x was randomly selected from” 把比较结构的前半截写完:即"x 来自 Group 1 的似然 大于 x 来自……"。后半截则留给 P0608 收束。值得注意的是,本段在叙述中已经默认了第一段公式的第一行,即在某种条件下(如 x < c)Group 1 的似然更大,因此读者读到这里应意识到作者正在用文字把不等式翻译成句子。
第5段(P0608)
原文复述
Group 2 when the value of x is less than the value of c (and vice versa).
中文讲解
本段结束 P0606–P0607 开启的长句,补全第二个比较对象"Group 2"以及触发条件"when the value of x is less than the value of c”,并以括号注 “(and vice versa)” 说明反向情形(即 x > c 时,Group 2 的似然更大)。这是对上一段公式 P0605 规则的口语化重述:x 在 C 左侧更可能来自 Group 1,x 在 C 右侧更可能来自 Group 2。括号里的 “and vice versa” 把第二行不等式覆盖掉了,使读者在阅读文字时不必再回头查看公式。
第6段(P0609)
原文复述
It is important to clarify the phrases “less than” and “greater than”.
中文讲解
本段是一个承上启下的提醒句。它告诉读者,下面的解释不是要把公式再复述一遍,而是要专门澄清两个容易引起误解的关键词——“less than” 和 “greater than”。之所以需要专门澄清,是因为在两条组比较的情境中,这两个词既可以指"绝对数值大小”,也可以指"相对 C 的偏离方向",而 Tatsuoka 的规则使用的是后者。作者在 P0610–P0613 中将逐一拆解这种歧义。本段的修辞功能是提醒读者:接下来要谈的是术语解释,而不是规则再述。
第7段(P0610)
原文复述
Group 1 may have higher numerical values than Group 2 or vice versa, so it
中文讲解
本段与 P0611–P0613 共同构成一个解释性长句。单独看本段,它提出一个反直觉的事实:两个组在测量指标上的高低顺序并不固定——Group 1 的数值可能比 Group 2 大,也可能比 Group 2 小。这一观察非常重要,因为它直接切断了读者可能产生的误解:以为规则中"less than / greater than"是在比较 x 与某组均值的大小。本段后半句的 “so it” 把因果关系留给 P0611 接续:正因为两组的相对位置不固定,分类才不能依赖绝对数值。
第8段(P0611)
原文复述
is not a matter of which is greater than c (the between-groups, or “grand”
中文讲解
本段接续 P0610,开始点出关键结论:分类并不取决于"哪个组的均值大于 c"。括号中的 “the between-groups, or ‘grand’ mean” 第一次给 c 一个统计身份——它是两组的合并均值(grand mean),即两组整体的中心位置。注意:括号横跨到 P0612 中才闭合,因此本段在视觉上独立,但语义上仍属于 P0610 起的长句。这一信息对理解规则至关重要:因为 c 是两组的总均值,所以无论哪个组的均值高于它,c 永远是中性的对称分界点,不会偏向任何一组。
第9段(P0612)
原文复述
mean). Instead it is the opposing distance in either direction from c that
中文讲解
本段先闭合 P0611 中关于 c 的括号(结束 “grand mean” 的注释),再以 “Instead”(相反地)转折,引出真正决定分类的量:观测值 x 在 c 两侧的"对向距离"(opposing distance in either direction from c)。也就是说,分类依据不是绝对水平,而是 x 落在 c 的左边还是右边——左偏多少、右偏多少都不重要,重要的是方向。这一表述也间接说明了:两条分布若对称,则 C 处的似然天然相等,规则不会失效;若分布偏态,则 c 不再是分布的中点,但只要它仍然是两侧似然交叉的位置,规则仍适用。
第10段(P0613)
原文复述
will distinguish groups from each other.
中文讲解
本段收束 P0610–P0612 的整条长句:"……will distinguish groups from each other."——即这种相对于 c 的方向性距离才是区分两组的真正判据。本句为本节的核心澄清做出总结:Tatsuoka 的两条组似然规则本质上是一种"方向分类",x 在 c 的哪一侧就归向哪一组,而与两组均值孰高孰低无关。这与上文的似然不等式呼应:因为左右两侧的概率密度曲线高低恰好相反,所以无论整组均值如何排列,C 总能保证两侧似然可比、分类可执行。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节包含一处形式化材料——P0605 的公式,引用出处见 P0604 的脚注 40(Tatsuoka)。本节内未出现独立的图表说明或边栏;上一段(节边界外)提到的"两条曲线概率密度图"在 P0604 中以文字描述承担,未在本节重复。脚注 40 标明 Tatsuoka 是分类规则的来源作者,属于引用型脚注。
💡 本节核心要点
- Tatsuoka 的两条组似然规则比较的是 L(x/H₁) 与 L(x/H₂) 两个条件似然值,而非绝对概率或绝对距离。
- 分类阈值 C 在统计上是两组的 grand mean(合并均值),它对称地落在两组整体的中心,与任一组均值孰高孰低无关。
- 规则的形式是:x < c 时归 Group 1,x > c 时归 Group 2;其本质是按 x 相对于 C 的方向进行分配。
- P0605 公式中两条 “when x < c” 的排版属于明显错误,依据 P0606–P0608 的文字与对称性应理解为第二条条件为 “when x > c”。
- P0609–P0613 的专门澄清表明:在两组的均值顺序不固定时,分类判据只能依赖"相对于 C 的方向性距离",否则会误用绝对数值比较。
🔑 关键术语
- Likelihood region:似然区,指在两条分布重叠区间内、依据条件似然值大小将观测 x 划归某一组的判定区域;本节中即 C 两侧的左右半区。
- Probability density:概率密度,本节指两条曲线在某 x 处的纵高,代表 x 落入对应组的相对可能性(似然),用于组与组之间的相互比较。
- Hypothesis (H₁, H₂):互斥假设,H₁ 表示 x 来自 Group 1,H₂ 表示 x 来自 Group 2;条件似然 L(x/H_i) 即在某假设下观察到 x 的可能性。
- C (mid-point of overlap / grand mean):两条组分布重叠区的中点,在统计上等同于两组的合并均值(between-groups mean / grand mean),是分类的方向对称分界点。
- Opposing distance in either direction from c:x 相对于 C 的偏离方向(左或右),是本节澄清后的真正分类判据,强调"方向"而非"绝对数值"。
- Tatsuoka:本节规则的原始提出者(见 P0604 脚注 40);本节以 Tatsuoka 的两条组似然不等式作为分类依据。
s62 [描述性拆分] MANOVA and the Hypothesis of Group Differences
第1段(P0614)
原文复述
An indirect way to approach classification is by testing the hypothe-
中文讲解
这是本节的开篇片段,提出一种处理分类(classification)问题的间接路径:不去直接分类,而是检验一个假设——‘各组是否相同’。原文在行末把单词’hypothesis’断为’hypothe-’,下一片段会接续。从论证结构看,作者把分类与’组均值相等’的假设检验对接:若各组均值显著不同,反过来就支持分类有意义——即可以通过均值差异来区分各组。本节标题’MANOVA and the Hypothesis of Group Differences’(MANOVA 与组别差异的假设)也与此呼应。
第2段(P0615)
原文复述
sis that groups are identical, or that their within-group means are identi-
中文讲解
此片段承接上一行的断词’hypothe-’,补全为’hypothesis’,并展开假设的两种等价表述:‘各组相同’(groups are identical)或’各组内的均值相同’(within-group means are identical)。连词’or’(或者)表明这两个说法在本节语境下是等价的——若各组在统计意义上’相同’,其本质就是各组均值彼此相等。同样,‘identical’在行末被断为’identi-’,下一片段将继续完成该单词。
第3段(P0616)
原文复述
cal. Multivariate analysis of variance (MANOVA) provides a partition
中文讲解
此片段先补全上一行的’identical’,以句号结束开篇句,然后开启新句,正式引入MANOVA(multivariate analysis of variance,多元方差分析)。作者提出 MANOVA 的两个核心功能:第一,提供一个’分解定理’(partition theorem);第二,提供对’组内均值相等’假设的拒绝检验(test for rejection)。‘partition’在行末被断词,下一片段将与其后接续的’theorem’合成术语’partition theorem’。这一片段的功能是把 MANOVA 这一统计工具正式带入论述,为后续小节的具体展开铺垫。
第4段(P0617)
原文复述
theorem that describes the within-group means’ comparative relation to the
中文讲解
承接上一行断词’partition’,本片段与之合成完整术语’partition theorem’(分解定理)。该定理的功能是描述’组内均值(within-group means)相对于组间均值的比较关系’。换言之,MANOVA 通过分解定理把每个组的组内均值放进一个比较框架中,使各组之间的差异可以被定量地刻画。’to the’在行末再次断词,下一片段将接续出’between-groups mean’(组间均值)。
第5段(P0618)
原文复述
between-groups mean, as well as a test for rejection of the hypothesis of
中文讲解
承接上一行,本片段完成’between-groups mean’(组间均值)——与’组内均值’相对的、把所有组合并后计算得到的总体均值。句中用’以及’(as well as)连接 MANOVA 的第二项功能:对’组内均值相等’假设的拒绝检验(test for rejection of the hypothesis)。这意味着 MANOVA 同时具备描述(分解定理)与推断(假设检验)双重功能。‘of’在行末被断词,下一片段会补全出整个零假设的完整措辞。
第6段(P0619)
原文复述
equal within-group means.
中文讲解
本片段作为整段的收尾,把上一行未完的’假设’补全为’equal within-group means’(组内均值相等),并以句号结束全句。把六个片段连起来读:MANOVA 提供了一个分解定理,用以描述组内均值相对于组间均值的比较关系,并同时提供对’组内均值相等’假设的拒绝检验。这一收束把开篇的’间接分类’思路落到具体统计工具上:通过对’组内均值相等’假设的检验,间接判断各组是否存在显著差异,从而为分类提供统计依据。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节在原文中由六个因排版换行而拆开的连续片段组成(P0614–P0619),实质上是一段完整论述,没有额外的脚注、图表或边栏附加材料。节标题’MANOVA and the Hypothesis of Group Differences’由任务系统提供的’[描述性拆分]‘标签与正文标题组合而成。
💡 本节核心要点
- 作者把 MANOVA 定位为一种处理分类问题的间接方法:通过检验’各组是否相同’的假设,反向推断组别是否存在差异,从而支撑分类的合理性
- ‘各组相同’被等价表述为’各组内均值相等’(within-group means are identical),这是本节论证的核心统计命题
- MANOVA 提供两项功能:分解定理(partition theorem)用于描述组内均值相对于组间均值的比较关系;以及一个对’组内均值相等’假设的拒绝检验
- 分解定理具备描述性(刻画组内均值与组间均值的对比关系),而拒绝检验具备推断性(用于判断组别差异是否显著),二者构成 MANOVA 的一体两面
- 本节是从’分类问题’过渡到’MANOVA 工具’的引介段,先给出工具的整体定位与功能轮廓,为后续小节具体展开分解定理与检验统计量做铺垫
🔑 关键术语
- MANOVA (Multivariate Analysis of Variance):多元方差分析。本节把它定位为间接处理分类问题的统计工具,既能给出组内均值与组间均值的分解关系,又能检验’组内均值相等’的假设。
- Partition theorem (分解定理):MANOVA 提供的一种定理形式,描述组内均值相对于组间均值的比较关系。它是连接描述性比较与假设检验的桥梁。
- Within-group mean (组内均值):每个组别内部样本的均值。在本节假设中,‘组相同’被等价表述为各组的组内均值彼此相等。
- Between-groups mean (组间均值):将所有组合并后计算所得到的总体均值。它是组内均值进行比较的参照基准,出现在分解定理的比较关系中。
- Hypothesis of equal within-group means (组内均值相等的假设):MANOVA 所检验的零假设,即各组的组内均值彼此相等;若该假设被拒绝,则意味着各组在均值层面存在显著差异,从而支持分类的合理性。
- Test for rejection (拒绝检验):用于判断是否拒绝零假设的检验。在本节指 MANOVA 对’组内均值相等’假设所提供的拒绝程序。
s63 [描述性拆分] MANOVA Partition: T = B + W and Wilkes’ Lambda
第1段(P0620)
原文复述
In the following formula $X_{k1}$ represents the variable score for the $i^{th}$ sample (i.e. variation) in the $j^{th}$ group (i.e. pieces by Farnaby). K
中文讲解
这一句是下一条公式 P0622 的符号说明。作者在引入公式前先解释记号:$X_{k1}$ 表示第 j 组(论文中的 Farnaby 作品)中的第 i 个样本(变体)的变量得分。这里需要读者特别注意一个 OCR/排版遗留问题——下标同时出现了 “k1”、“i^{th}” 和 “j^{th}” 三种不同写法,说明原文在变量索引上并不统一;下文 P0622 实际呈现的公式使用的是 $X_{ki}$,所以 “i” 指样本序号、“k” 指组序号才是后续理解中应当沿用的口径。句末以 “K” 截断,并不是新符号,而是与下一段 P0621 拼成一个完整句子。
补充说明
本段与其后的 P0621 共同构成同一句的文字,按版面被分到两个段落 ID;讲解时以两段拼接后视为一个完整陈述。
第2段(P0621)
原文复述
defines the groups under study, m is the overall mean, and $m_{k}$ is the group mean for group k. $^{41}$
中文讲解
承接 P0620 末尾的 “K”,本句补全了符号说明:K 定义研究中的所有组;m 是全部样本的总体均值;$m_{k}$ 是第 k 组的组内均值。三个量构成 P0622 分解公式的全部要素:$X_{ki}$ 是原始观测,m 是总均值,$m_{k}$ 是组均值。其中 $m_{k}$ 既是定义项,也是与 m 相减得到组间偏差的关键量。段尾的 $^{41}$ 是脚注引用,本节在 additional_information 中再做处理。
补充说明
脚注标记 $^{41}$ 在 P0621 末尾出现,其内容未在本节文本中给出,仅以引用形式保留。
第3段(P0622)
原文复述
$$ X _ {k i} = m + \left(m _ {k} - m\right) + \left(X _ {k i} - m _ {k}\right) $$
中文讲解
这是 MANOVA 中最基本的方差分解恒等式:任意一个样本观测值 $X_{ki}$ 等于总体均值 m,加上 (组均值 $m_{k}$ − 总均值 m) 这个组间偏差,再加上 (样本值 $X_{ki}$ − 组均值 $m_{k}$) 这个组内偏差。直观含义是:把"某个体偏离总体"分解为两部分——“该组整体偏离总体"和"该个体在其所在组内进一步偏离组中心”。这个恒等式之所以重要,是因为它把每个观测值的总偏差在数学上严格拆开,是后面 T = B + W 矩阵分解的代数基础。
补充说明
公式中括号里 $(m_k - m)$ 与 $(X_{ki} - m_k)$ 互不重叠且求和为 $X_{ki} - m$,因此对全部观测平方并按 k、i 求和后将自然产生"总 = 组间 + 组内"的矩阵形式,这正是 P0623 中 T = B + W 的来源。
第4段(P0623)
原文复述
When the theorem is summarized for all groups under study and each element squared, the resulting equation is symbolized by the relation $T = B + W$ . $T$ is the matrix of sums of squares and cross products of deviations of all group samples from the overall mean (or “Total”). $B$ is the matrix of weighted squares and cross-products of deviations of group means from the overall mean (or “Between”). $W$ is the matrix of squares and cross-products of deviations of group samples from their within-group means pooled over all groups (or “Total”).
中文讲解
作者把上一段恒等式对所有组、所有观测平方并求和,得到矩阵层面的关系式 T = B + W。其中 T(Total)是"所有样本相对于总体均值 m 的偏差"的平方和与交叉积矩阵;B(Between)是"各组均值 $m_{k}$ 相对于总体均值 m 的偏差"的加权平方和与交叉积矩阵;W(Within,本段原文中也称 “Total”,应理解为"组内",即"各样本相对于其所在组均值 $m_{k}$ 的偏差"在所有组上汇总后的平方和与交叉积矩阵)。需要注意的是:原文中 W 的文字解释出现了"(or ‘Total’)",这显然是排版错误,与 T 的"Total"含义冲突,正确称谓应为 “Within”。从论证链上看,这一节的关键在于把单变量的总方差分解平移到多变量的矩阵分解:单变量情况下是 SS_T = SS_B + SS_W,多变量情况下则是三个矩阵满足 T = B + W。
补充说明
原文本中 W 后面的括号标签写作 “(or ‘Total’)",与 T 的 “Total” 重复,从上下文与 MANOVA 标准术语来看,应为 “(or ‘Within’)";这一判断仅基于本节对术语对应关系的内部一致性,不引入外部知识。
第5段(P0624)
原文复述
A test of the ratio of $|T|$ to $|W|$ called “Wilkes’ Lambda” will determine the degree of significant dissimilarity between groups. $^{42}$
中文讲解
本句把矩阵 T 与 W 引入统计检验。Wilkes’ Lambda 即 $\Lambda$,定义为 $|W|$ 与 $|T|$ 的比值(详见 P0625 公式),用以衡量组间的显著差异程度。从论证功能看,这一句是从"分解"走向"检验"的转折:之前只是在说"总偏差 = 组间偏差 + 组内偏差”,现在开始问"组间偏差是否大到不能被组内波动解释”。脚标 $^{42}$ 为脚注引用。
补充说明
脚注标记 $^{42}$ 在本段末尾出现,其内容未在本节文本中给出,仅以引用形式保留。
第6段(P0625)
原文复述
$$ \text {入} = \begin{array}{c} | \mathrm{w} | \ | \overline {{\mathrm{T}}} | \end{array} $$
中文讲解
公式给出 Wilkes’ Lambda 的定义:分子是 $|W|$(组内偏差矩阵的行列式),分母是 $|T|$(总偏差矩阵的行列式)。原文以汉字"入"作为符号,这是 Lambda(Λ)的 OCR 误读/排版替代——“入"与希腊字母 Λ 形近而被混用。理解时应当把"入"读作 Λ。直觉上,$\Lambda = |W|/|T|$ 取值在 0 到 1 之间:若组间差异显著,组间偏差在总偏差中占比大,$|T|$ 远大于 $|W|$,$\Lambda$ 趋近 0;若各组均值几乎重合,$|W| \approx |T|$,$\Lambda$ 趋近 1。这一比值越大,组间差异越不显著。
补充说明
原式中分母记为 $|\overline{T}|$,上划线是 OCR/排版遗留,并非对 T 取平均或取补集,按上下文应理解为 $|T|$。
第7段(P0626)
原文复述
An increase in the value of $|T|$ relative to $|W|$ increases the likelihood
中文讲解
这句话在功能上是连接 P0625 公式与 P0627 结论的桥梁:作者要说的是"当 $|T|$ 相对于 $|W|$ 增大时(即分母变大、分子相对变小)",结果是什么。原句在此处截断,逻辑留到 P0627 完成。从公式上看,$|T|$ 相对 $|W|$ 增大就等价于 $\Lambda = |W|/|T|$ 减小,因此本段实际上是在铺垫”$\Lambda$ 越小→越倾向于拒绝组间无差异的原假设"这一方向性结论。
补充说明
本段是 P0624–P0625 与 P0627 之间的过渡句,按版面被拆为两段,讲解时需将 P0626、P0627 视为一句完整陈述。
第8段(P0627)
原文复述
of rejecting the hypothesis of no difference between groups.
中文讲解
承接 P0626,本段补全结论:当 $|T|$ 相对于 $|W|$ 增大时,拒绝"各组之间没有差异"这一原假设的可能性会提高。换言之,Wilkes’ Lambda 越小,组间显著差异的证据越强。这正是把 P0625 的统计量与一个明确的统计决策(拒绝/不拒绝原假设)挂钩的句子,是本小节从"分解公式"到"检验判据"的最终落点:在 MANOVA 框架下,差异是否显著等价于问"$\Lambda$ 是否足够小"。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节包含两处脚注引用:P0621 末尾的 $^{41}$ 与 P0624 末尾的 $^{42}$。两次引用仅以角标形式出现,脚注正文未在本节文本范围内,因此无法在此处复述其内容;按本节逻辑,$^{41}$ 通常对应"均值与组均值符号说明的来源/术语依据",$^{42}$ 通常对应"Wilkes’ Lambda 这一检验的来源出处",但具体内容需参见原文对应页面的脚注区。文中 W 的释义出现 “(or ‘Total’)” 标签,从术语一致性看应为 “(or ‘Within’)” 的排版错误。Wilkes’ Lambda 符号在 P0625 中以汉字"入"呈现,这是 Λ 的 OCR/排版替代,讲解时应还原为 Λ。
💡 本节核心要点
- P0622 的恒等式 $X_{ki} = m + (m_k - m) + (X_{ki} - m_k)$ 是 MANOVA 中"总偏差 = 组间偏差 + 组内偏差"在单条观测层面的拆解,是本节所有后续结果的代数起点。
- 把 P0622 对所有组、所有观测平方并求和后,平移到矩阵层面就得到 $T = B + W$,即 Total 矩阵 = Between 矩阵 + Within 矩阵;这是单变量方差分解在多变量情形下的自然推广。
- Wilkes’ Lambda 定义为 $\Lambda = |W|/|T|$,取值介于 0 与 1 之间,是把"分解"转化为"检验"的关键统计量。
- 判读规则:$\Lambda$ 越小(即 $|T|$ 相对 $|W|$ 越大),拒绝"组间无差异"原假设的证据越强;$\Lambda$ 越接近 1,则证据越弱。
- 本节在论证链上承担过渡角色:从符号定义(P0620–P0621)→ 恒等式(P0622)→ 矩阵分解 T = B + W(P0623)→ 检验统计量(P0624–P0625)→ 决策结论(P0626–P0627)。
🔑 关键术语
- $X_{ki}$:第 k 组中第 i 个样本在某一变量上的观测得分;下标 i 标识样本(变体),k 标识组(Farnaby 作品),是 P0622 分解公式的起点。
- m / $m_k$:m 是全部样本在某一变量上的总体均值;$m_k$ 是第 k 组的组均值;二者之差 $(m_k - m)$ 即"组间偏差",是构成 Between 矩阵 B 的基本量。
- T (Total 矩阵):所有样本相对于总体均值 m 的偏差所形成的平方和与交叉积(SSCP)矩阵,刻画多变量意义上的"总波动"。
- B (Between 矩阵):各组均值 $m_k$ 相对于总体均值 m 的偏差经样本量加权后的 SSCP 矩阵,刻画"组间波动"。
- W (Within 矩阵):各样本相对于其所在组均值 $m_k$ 的偏差在所有组上汇总后的 SSCP 矩阵,刻画"组内波动"。原文将其标签误写为 “Total”,应为 “Within”。
- Wilkes’ Lambda (Λ):定义为 $\Lambda = |W|/|T|$,取值在 0 到 1 之间;在本节中作为检验组间是否显著差异的多变量统计量,Λ 越小表示组间差异越显著、越倾向于拒绝"组间无差异"的原假设。
s64 [描述性拆分] Discriminant Analysis as a Weighted Ratio (B/W Maximum)
第1段(P0628)
原文复述
Where MANOVA tests the hypothesis of group differences, discriminate analysis weights the equation in favor of between-groups means.
中文讲解
本句将判别分析(discriminant analysis)与其前文讨论的 MANOVA 进行了对比定位:MANOVA 的目标是检验各组之间是否存在显著差异(即回答“有没有差别”),而判别分析则更进一步,它不再仅仅检验差异,而是构造一个加权的线性组合,使“组间(between-groups)”差异相对于“组内(within-groups)”差异尽可能被放大。换言之,判别分析关心的是“如何把不同组尽可能清楚地分开”,而不是仅仅判断组均值是否相等。这里出现的脚注 43 在原文附录/参考文献中提供出处。
补充说明
脚注 43 的具体内容在当前任务输入中未给出,需查阅原文脚注区确认出处。
第2段(P0629)
原文复述
λ = (B / W) | maximum
中文讲解
这是判别分析的目标函数。λ(lambda)是 B/W 这一比值,其中 B 代表组间平方和(between-groups sum of squares)或对应的组间变异,W 代表组内平方和(within-groups sum of squares)或对应的组内变异。竖线加“maximum”表示:在所有可能的线性加权方向中,判别分析要寻找使 B/W 比值达到最大的那一个方向。直观上,就是让“组间差异 / 组内差异”这一信噪比最大化,从而得到区分各组能力最强的线性组合。该最大比值 λ 正是判别函数权重的来源。
第3段(P0630)
原文复述
The value of lambda resulting will contribute to weights on the discriminate score for each group. The discriminate score, or function is formulated as follows:
中文讲解
本段起承接 P0629 的最优化结果:使 B/W 达到最大时得到的 λ,会被用于构造每一个组的“判别分数(discriminate score)”,也就是判别函数(discriminate function)。也就是说,λ 决定了接下来公式中各变量的权重系数 d。文中随即给出该判别函数的具体形式。脚注 44 在此处提供出处。
补充说明
脚注 44 的具体内容在当前任务输入中未给出,需查阅原文脚注区确认出处。
第4段(P0631)
原文复述
D_i = d_{i1} z_1 + d_{i2} z_2 + … d_{ip} z_p
中文讲解
这是判别函数(discriminate function)的标准公式形式。下标 i 表示“第 i 个判别函数”,因为在实际问题中通常不止一个判别函数(这一点在 P0634–P0635 中会进一步说明)。d_{i1}, d_{i2}, …, d_{ip} 是第 i 个判别函数中分别赋给变量 1, 2, …, p 的权重系数,它们正是上一段所说由 λ 的最大化过程所产生的。z_1, z_2, …, z_p 是各变量的标准化取值(standardized values),即经过标准化处理后的观测值。函数 D_i 就是将各标准化变量按各自权重线性相加后得到的判别分数,用来代表某观测在第 i 个判别维度上的位置。
第5段(P0632)
原文复述
D_i is the score on discriminate function i, weighting values are represented as d, Z’s are standard values of the variables 1 through p, and p is
中文讲解
本句与 P0633–P0635 一起,逐项解释公式 D_i = d_{i1}z_1 + … + d_{ip}z_p 中各符号的含义。这里已经说明:D_i 表示“第 i 个判别函数上的得分”,d 表示“权重值”,Z 表示“各变量的标准化值”(变量编号从 1 到 p),并正在引出 p 的含义。
第6段(P0633)
原文复述
sented as d, Z’s are standard values of the variables 1 through p, and p is
中文讲解
承接 P0632,继续定义公式符号:d 是各项权重,Z 是 1 到 p 号变量的标准化取值,p 是变量的最大个数。注意“Z’s”是多个标准化变量 z_1, z_2, …, z_p 的总称。
第7段(P0634)
原文复述
the maximum number of variables. There can be a maximum number of discrimi-
中文讲解
本句前半段完成对 p 的定义:p 是变量的最大个数;后半段引出一个新的限制——判别函数的最大个数是有限的,且与组数有关。原文因排版断行被拆为两段(P0634 与 P0635),需合在一起阅读才能完整。
第8段(P0635)
原文复述
nate functions of one less than the total number of groups. The discriminate
中文讲解
本句给出判别函数的最大数目规则:判别函数的个数最多为“组数减 1”。也就是说,如果有 g 个组,那么能构造出的判别函数最多为 g−1 个。出现这一上限的原因是:g 个组的均值整体上只有 g−1 个自由度可以用于在不同方向上“拉开”,再多出的方向无法提供新的组间区分信息。
第9段(P0636)
原文复述
scores produced for each group provide a reference for comparison against
中文讲解
本句说明判别分数的用途:为每一组先计算出各自的判别分数,这些分数将作为后续比较的“参考基线”。也就是说,先用已知类别的样本建立“组参考”,再用这些参考去比对未知样本。原文因排版断行与 P0637 共同构成完整一句话。
第10段(P0637)
原文复述
the score from an unknown sample.
中文讲解
承接 P0636:各组已有的判别分数,将被用来与“未知样本(unknown sample)”的判别分数进行比较。未知样本究竟落在哪一组附近,就依据其判别分数与各组参考分数的接近程度来判断——这是判别分析最终用于分类(classification)的核心逻辑:从“检验差异”走向“分配新样本到最可能的组”。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节包含两处脚注引用(脚注 43 与脚注 44),但其具体内容未在本次输入中给出,需结合原文脚注区查阅;本节正文另含两段行间数学公式(λ = B/W | maximum 与 D_i = d_{i1}z_1 + … + d_{ip}z_p),在 P0629 和 P0631 中以公式形式呈现。
💡 本节核心要点
- 判别分析与 MANOVA 的关系:MANOVA 检验组差异是否显著,判别分析则构造加权的线性组合使组间差异相对于组内差异尽可能被放大。
- 判别分析的目标函数是使 B/W(组间变异 / 组内变异)达到最大值 λ,λ 决定了判别函数中各变量的权重 d。
- 判别函数的形式为 D_i = d_{i1}z_1 + d_{i2}z_2 + … + d_{ip}z_p,其中 z 是变量的标准化取值,p 为变量总数。
- 判别函数的个数受限于组数:若有 g 个组,则最多可构造 g−1 个判别函数。
- 判别分析的实际用途是分类:先由已知分组样本得到各组的判别分数作为参考,再用这些参考比对未知样本的判别分数,以判断未知样本最可能属于哪一组。
🔑 关键术语
- Discriminant analysis(判别分析):本节所讨论的方法,用于在多变量条件下,依据已知分组构造加权线性函数,使组间差异相对于组内差异最大化,从而对新样本进行分类。
- MANOVA:多元方差分析,前文已讨论;其作用是检验多个组在多个因变量上是否存在显著差异,为判别分析提供出发点。
- λ = B/W | maximum:判别分析的目标函数,B 为组间变异,W 为组内变异,λ 在所有可能的加权方向中取 B/W 的最大值。
- Discriminant function / discriminate score(判别函数 / 判别分数):公式 D_i = d_{i1}z_1 + … + d_{ip}z_p 所定义的线性组合,D_i 即某样本在第 i 个判别维度上的得分。
- d(权重系数):判别函数中赋给每个标准化变量 z 的权重,由使 B/W 最大的优化过程产生。
- z(标准化变量取值):1 到 p 号变量经标准化后的取值,作为判别函数的输入。
- p(变量个数):进入判别函数的变量最大个数。
- g − 1 个判别函数:若有 g 个组,可构造的判别函数最多为 g−1 个,由组间均值的自由度决定。
- Unknown sample(未知样本):类别未知的观测,其判别分数将与各已知组参考分数比较,以判定其归属。
s65 [描述性拆分] Stepwise Discriminant Analysis Procedure
第1段(P0638)
原文复述
To test variables in the analysis and discard insignificant discriminate
中文讲解
本句是开篇的不定式短语,交代使用逐步判别分析的功能定位:在判别分析中检验各变量,并剔除不显著的(判别函数)。它把"变量筛选"与"最终判别函数估计"两件事分开——先筛掉不重要变量,再据此估计最终函数。句末 ‘discriminate’ 一词属排版断行造成的形符截断,实际内容在下一段补全。
补充说明
本段末 ‘discriminate’ 在下一段补全为 ‘discriminate functions’,属断行造成的形符截断,并非独立术语。
第2段(P0639)
原文复述
functions, a procedure known as step-wise discriminate analysis is used.
中文讲解
承接上段,把上一行末尾的 ‘discriminate’ 补全为 ‘discriminate functions’(判别函数),并正式命名完成上述检验与剔除任务的程序为 “step-wise discriminate analysis”(逐步判别分析)。该句既完成了对方法名称的命名,也完成了对其功能的闭环说明:它就是用来"检验变量、丢弃不显著判别函数"的那一步骤。
第3段(P0640)
原文复述
The first discriminate function is based upon the scores on a single
中文讲解
从本段开始,作者转入对逐步判别分析操作步骤的具体描述。第一个判别函数建立在"某一个变量(a single variable)“的得分之上。这里强调 ‘a single’,意味着逐步法的第一步是逐个地、单变量地挑选变量,而不是把所有变量一次性投入。
第4段(P0641)
原文复述
variable that most effectively answer the equation for lambda above, maxi-
中文讲解
承接 P0640,说明被选入第一个判别函数的变量是哪一个:它应当是"最有效回答上文中 lambda 方程(the equation for lambda above)“的那个变量。’lambda above’ 表明 lambda 的定义来自前文,本节只是借助它作为挑选变量的判据。‘maxi-’ 在下一段与 ‘mizing’ 拼合,构成 ‘maximizing’(最大化)。
补充说明
本节 ’lambda’ 一词来自前文(‘above’)所给出的方程定义;其具体形式与判别准则需结合前文确认。
第5段(P0642)
原文复述
mizing between-group differences. The second discriminate function uses
中文讲解
本段把上一段末断行的 ‘maxi-’ 与本段开头的 ‘mizing’ 拼合为 ‘maximizing’,完成"最大化组间差异(maximizing between-group differences)“这一入选标准的表述。它与上文的 lambda 方程呼应:被选中的变量应当使 lambda 减小到最大限度,也就是使各组之间尽可能分离。随即本段末尾开启对第二个判别函数的描述。
第6段(P0643)
原文复述
the first score as a referent and determines which second variable in com-
中文讲解
描述第二个判别函数的构造方式:把第一个判别函数的得分(the first score)作为参照(referent),再在剩下的变量中判断哪一个能产生最具区分力的得分。这里的关键思想是"以第一根轴的得分为锚”——保证新变量所提供的判别信息是相对于已有结构而言的,而不是孤立的。‘com-’ 在下一段与 ‘parison’ 拼合为 ‘comparison’。
第7段(P0644)
原文复述
parison produces the most divergent, or orthogonal score in relation to the
中文讲解
承接上段 ‘in com-’,拼合为 ‘in comparison’(在比较中)。本段给出第二个变量的入选条件:它所产生的得分应与此前已合并的得分尽可能"发散”(the most divergent),在数学上即等价于"正交”(orthogonal)。‘正交’ 在本节语境中意味着新变量与已有变量在统计上独立,从而向判别函数贡献不重复的新信息。
补充说明
正交(orthogonal)在此指统计独立:两个变量的得分互不相关,避免判别信息重复。
第8段(P0645)
原文复述
previously pooled scores. This procedure taken through several steps
中文讲解
本段开头承接上一段末的 ‘relation to the’,补全为 ‘in relation to the previously pooled scores’(相对于此前已合并的得分)。‘pooled scores’ 指累计到当前步骤为止的判别函数得分集合。然后开始过渡:把上述"选入—正交化—再选入"的规则"经过若干步(taken through several steps)“反复执行,把单步规则推广到多步过程。
补充说明
‘pooled scores’ 指累计到当前步骤为止的判别函数得分集合,每新加入一个变量都会与此集合做正交化比较。
第9段(P0646)
原文复述
guards against a final discriminate analysis in which weakly contributing
中文讲解
承接上段 ’taken through several steps’,明确逐步判别分析的防御性目的:经多步筛选之后,可 ‘guards against’(防止)出现这样一种最终判别分析——其中混入了 ‘weakly contributing’(弱贡献)的变量。这句话把逐步判别分析的价值定位为"避免弱变量混入最终模型”。
第10段(P0647)
原文复述
variables are unidentified.
中文讲解
本段仅一个分句,补全上段为 ‘a final discriminate analysis in which weakly contributing variables are unidentified’(在最终的判别分析中,弱贡献的变量未被识别出来)。这是整段论述的收束:若不经过逐步筛选,那些贡献微弱的变量会悄悄混进最终判别函数而不被察觉,从而稀释判别效果、降低结果可解释性。逐步判别分析正是为防御这一风险而设。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节无脚注、图表或边栏附加材料。
💡 本节核心要点
- 逐步判别分析(step-wise discriminate analysis)是一种变量筛选程序,用以检验变量并剔除对组间差异贡献不显著的判别函数。
- 第一个判别函数基于单一变量,挑选标准是使前文给出的 lambda 方程取极值、最大化组间差异。
- 后续判别函数以已有得分为参照(referent),要求新变量得分与之前合并的得分(pooled scores)正交(orthogonal),从而提供不重叠的新判别信息。
- 上述"选入—正交化—再选入"的规则经多步反复执行,逐步累积互不相关的判别变量。
- 逐步法具有防御性价值:避免弱贡献变量混入最终判别函数而未被识别(unidentified),保证最终函数的清晰性与可解释性。
🔑 关键术语
- step-wise discriminate analysis(逐步判别分析):本节介绍的一种变量筛选程序:通过逐次加入使 lambda 减到最小的变量,并保证新变量与已有变量正交,最终只保留显著贡献的变量进入判别函数。
- lambda(λ):本节来自前文(‘above’)所给出的方程中的量,作为挑选变量时依据的统计量;逐步判别分析每一步都选择使该量减小最多的变量。
- orthogonal(正交):在本节语境中指统计独立:要求新变量的得分与已合并得分互不相关,避免判别信息重复。
- referent(参照):本节指第一个判别函数的得分作为后续变量选择的锚点,使新变量的判别信息建立在前一变量已捕获的差异基础之上。
- pooled scores(合并得分):逐步法累计到当前步骤为止的判别函数得分集合,每新加入一个变量都会与此集合做正交化比较。
- discriminate function(判别函数):由若干变量的线性组合构成的、用于区分不同类别的函数;逐步判别分析的功能是挑选进入该函数的变量,而不是估计函数本身。
s66 [描述性拆分] Summary of the Procedural Plan for This Research
第1段(P0648)
原文复述
The procedure taken in this research began with a pretest of the data
中文讲解
本句是整段研究流程概述的开篇,交代作者将以分步骤方式介绍其实证研究的具体执行方案,并以"a pretest of the data"(对数据进行预检)作为第一步,由此奠定"先检验、再建模、再验证"的论证逻辑。
第2段(P0649)
原文复述
using analysis of variance to determine the amount of variable overlap
中文讲解
接续前句,说明该预检的具体做法——使用"analysis of variance"(方差分析)来测定"the amount of variable overlap"(变量重叠程度)。在此语境下,方差分析的功能并不是通常意义上比较组间均值,而是要诊断各变量之间是否存在高度共线或冗余,从而为下一步多元判别分析是否可行提供先决条件。
第3段(P0650)
原文复述
occurring between groups. Stepwise discriminate analysis was run to derive
中文讲解
上一句的"variable overlap"明确限定为"occurring between groups"(发生于各组之间)。紧接着,作者转入第二步方法:运行"stepwise discriminate analysis"(逐步判别分析),目的是"derive"(推导得出)……这里的"discriminate analysis"即判别分析(discriminant analysis),是一种依据若干变量将样本归入已知类别的多元统计方法。
第4段(P0651)
原文复述
the most effective discriminate scores. The discriminate analysis proper
中文讲解
完成第二步的目标——推导出"the most effective discriminate scores"(最有效的判别得分)。随后,作者提出第三步:“The discriminate analysis proper”,即"正式的/主体判别分析",意指在已完成变量筛选的基础上展开实质性的分类建模分析。
第5段(P0652)
原文复述
was run twice, once using all variables and again using only those variables
中文讲解
本句进一步说明"主体判别分析"的具体执行方式——“was run twice”,运行两次:第一次将所有变量(using all variables)纳入模型,第二次则仅使用……这种双轨对照设计是为了比较"全变量模型"与"精简变量模型"在判别表现上的差异。
第6段(P0653)
原文复述
recommended by the step-wise procedure. To verify the validity of the
中文讲解
……仅使用由前述逐步判别分析所"recommended"(推荐)的那些变量。这一对照设计的核心意义在于:检验逐步法所筛选出的变量是否真正具有判别贡献,从而判断剔除"冗余变量"是否能改善模型,也避免全变量模型可能带来的过拟合风险。紧接着,作者引出验证环节——“To verify the validity of the results”,为了确认结果的效度(validity),将另作一项独立分析。
第7段(P0654)
原文复述
results, another separate discriminate analysis was run comparing known
中文讲解
承接"to verify the validity of the results",本句说明验证手段的具体形式:另起一项"separate"(独立的)判别分析,比较的对象为两组"known"(已知的)样本——这种交叉验证思路的目的在于用外部已知归属来检验判别函数的稳健性。
第8段(P0655)
原文复述
pieces by two composers to other known pieces from the same sample groups.
中文讲解
补全上一句未说完的两组对照样本:一组是两位作曲家(two composers)的已知作品,另一组是来自同一抽样总体(the same sample groups)中的其他已知作品。其逻辑是用归属性已明确的作品来考察判别函数能否正确归类,从而交叉验证主体分析的可信度;选择"同一抽样总体"也控制了样本来源的混杂。
第9段(P0656)
原文复述
The results of each test are described in the following chapter.
中文讲解
本句作为整段研究流程概述的收尾,预告后续章节的内容安排:上述各项测试(each test)的具体结果都将在"the following chapter"(下一章)中逐一描述。这是实证研究报告典型的过渡写法,把方法概述与结果报告两个章节顺畅衔接起来。
💡 本节核心要点
- 整个研究流程被明确拆分为四个有序步骤:方差分析预检、逐步判别分析筛选变量、判别分析主体(两次对比运行)、独立的交叉验证判别分析。
- 预检阶段使用方差分析的目的不是比较组间均值,而是诊断各变量在组间的重叠程度,为后续多元分析是否可行提供先决条件。
- 主体判别分析被设计为"两次运行"的对照——一次使用全部变量,一次仅使用逐步法推荐的变量——用以评估变量筛选对判别表现的影响,并控制过拟合风险。
- 验证阶段采用"已知归属作品"作为外部对照:把两位作曲家的已知作品与来自同一样本总体的其他已知作品进行比较,借此交叉检验主体分析结果的效度。
- 本节以预告下一章将报告各项测试结果作结,体现研究报告"方法在前、结果在后"的标准结构过渡。
🔑 关键术语
- analysis of variance (ANOVA):方差分析;在本节中用于研究流程的第一步预检,目的是测定各变量在组间发生的重叠程度,为后续判别分析是否可行提供诊断依据。
- stepwise discriminate analysis:逐步判别分析;本节中作为研究流程的第二步,用于从全部变量中迭代筛选并推导出最有效的判别得分。
- discriminate scores:判别得分;由判别分析计算得到的综合性指标,用于将样本归入相应类别,本节中作为逐步判别分析追求的输出目标。
- discriminate analysis proper:正式的/主体判别分析;本节中作为研究流程的第三步,实际运行两次——一次纳入全部变量,一次仅使用逐步法推荐的变量,以对照判别表现。
- validity:效度/有效性;本节中通过另起一项独立判别分析、以已知归属作品作为外部对照来检验主体分析结果的可靠性。
s67 CHAPTER IV: RESULTS
第1段(P0657)
原文复述
CHAPTER IV: RESULTS
中文讲解
P0657 是第四章的章名标题,英文原文为"CHAPTER IV: RESULTS"(第四章:结果)。它在版面层级上高于正文段落,标志着论文进入第三、四章方法论描述之后的"结果汇报"阶段。结合下一段可知,本章将要呈现的是:对已收集的数据进行判别分析(用以区分不同作曲家)后所得到的结果。在学术论文结构中,“RESULTS"章的功能是把方法章节中规划的分析步骤的实际输出呈现出来,为后续"DISCUSSION"或"CONCLUSION"章对结果的解读与评估提供事实基础。由于该段只是章节标题,因此不做内容推理,只说明其标题功能。
第2段(P0658)
原文复述
In order to use the collected data to distinguish between composers, discriminate analysis was carried out in several steps. Before discriminate analysis could be effectively computed, the variables needed to be examined for their appropriateness as possible discriminators.
中文讲解
本段以方法学叙述的方式开启第四章,交代"结果章"中将呈现的核心分析方法及其前置准备步骤。其中心主张有两层:第一,本研究的目的在于利用已收集到的数据,对不同作曲家进行区分;第二,实现这一目的所采用的统计手段是判别分析(原文写作 discriminate analysis,按统计学惯例应理解为 discriminant analysis,即判别分析),并且该分析是分多个步骤完成的。
作者在第二句中提出了一个关键的方法论前提:判别分析并非拿来即用,在正式计算之前,必须先对各个变量是否适合作为判别依据(discriminators)进行考察。这句话承接了前文(第三章方法部分)的变量设定,并为后文即将列出的具体分析结果设下门槛——读者即将看到的数字结果,是建立在"变量已被筛选、已被确认具有判别力"这一前提之上的。因此本段既交代了"为什么做”(区分作曲家)和"怎么做"(判别分析),也暗示了"按什么顺序做"(先筛选变量,再正式判别),为整章的结果呈现搭建了逻辑框架。
容易误解之处:原文中 “discriminate” 在统计学语境下应读作 “discriminant”(判别的),而不是日常英语中 “歧视” 的意思;变量作为 “possible discriminators”,指的是它们能否在不同作曲家之间形成可测度的差异,而不是它们是否存在偏见。
补充说明
原文两次写作 “discriminate analysis”,从统计学语境判断应为 “discriminant analysis”(判别分析),这是用于根据多个变量把样本归入已知类别的多元统计方法;此处仅依据本段上下文提示这一术语含义,不再补充外部信息。
脚注 / 边栏 / 图表 / 附加信息(如有)
无额外附加材料。本节仅包含一个章名标题与一段引言性正文,未出现脚注、图表、公式或边栏。
💡 本节核心要点
- 本章(CHAPTER IV: RESULTS)承担论文的"结果呈现"功能,承接第三章方法部分,向后续讨论章过渡。
- 研究的核心分析目的,是利用已收集的数据区分不同的作曲家。
- 用于实现该目的的统计方法是判别分析(discriminant analysis),并被分解为多个步骤执行。
- 判别分析在正式计算之前,必须先对各变量作为判别依据的适合性(appropriateness as possible discriminators)进行考察。
- 本段建立了"先筛选变量、再进行判别"的逻辑顺序,为后文具体结果的呈现限定了前提。
- 原文中的 “discriminate analysis” 应按统计学惯例理解为 “discriminant analysis”(判别分析)。
🔑 关键术语
- discriminate analysis / discriminant analysis(判别分析):本研究中用于区分不同作曲家的多元统计方法;按统计学惯例,原文 “discriminate analysis” 应理解为 “discriminant analysis”。在本节中,它既是数据分析的核心手段,也是后续结果汇报的主线。
- discriminators(判别依据 / 判别变量):指在被引入判别分析之前需要接受适合性检验的那些变量;只有被判定为合适的变量才能作为区分不同作曲家的依据进入正式计算。
- collected data(已收集的数据):指论文在前几章(采集、整理与预处理阶段)所积累的、即将被用于判别分析的数据集合;本节强调这些数据将被进一步加工以服务于作曲家区分这一目的。
s68 Preliminary Analysis of the Known Pieces
第1段(P0659)
原文复述
Preliminary Analysis of the Known Pieces
中文讲解
这是一个Markdown二级标题(##),原文为英文小节标题“Preliminary Analysis of the Known Pieces”,可直译为“已知棋子的初步分析”。在小节编排中,标题的功能在于开启论题、宣告论述范围的转换:从此前的一般性讨论切换到对“已知棋子”进行专门、初步性的分析。所谓“已知棋子”,指的是在前文已经被识别、列出或讨论过的棋子集合;所谓“初步”,提示读者本节的分析属于起步阶段,后续还可能有更深入或更系统的处理。该标题本身不提供论据或结论,仅标示论证的下一阶段方向——即针对已掌握棋子展开前置性剖析,为后续更细致的讨论作铺垫。
补充说明
本段仅为Markdown层级标题标记(##),无正文句子;讲解依据原文标题字面与章节结构功能,不引入原文未提供的外部信息。
💡 本节核心要点
- 本段是Markdown二级标题,仅起开启论题的作用,不包含正文论述。
- 标题指示论证阶段从一般讨论转入对“已知棋子”的专门初步分析。
- “Preliminary”(初步)一词限定本节为前置性、起始性的分析,预留后续深入讨论的空间。
- “Known Pieces”(已知棋子)回指前文已经识别或列举过的棋子集合,限定本节讨论对象。
🔑 关键术语
- Preliminary Analysis:初步分析;指本节对已知棋子所进行的起步性、前置性的考察,区别于后续可能的深入或系统性分析。
- Known Pieces:已知棋子;指前文已经被识别、列出或讨论过的棋子,是本节分析所针对的对象范围。
s69 [描述性拆分] ANOVA and Table IV-A on the Fourteen Variables
第1段(P0660)
原文复述
An analysis of variance and a discriminate analysis were used to determine which of the fourteen variables (see pp.30-31, Chapter III) were possible candidates for discrimination between composers. The ANOVA for a given variable provides a test of where composers’ means are different. The significance level of the corresponding F statistic indicates whether the variable merits further study. If the significance level of the F statistic is .05 or smaller, there is evidence that the composer means are different for that variable, and it is a candidate for further study in the discriminate analysis. Table IV-A summarizes the ANOVA results from all 56 pavans by the six composers.
中文讲解
本段交代了统计分析的方法论框架和研究对象。作者联合使用了方差分析(ANOVA)和判别分析(discriminate analysis),目的不是直接给出结论,而是先从十四个变量中筛选出能够区分作曲家的候选变量。这是一个典型的两阶段策略:第一阶段用ANOVA做粗筛,第二阶段用判别分析做精判。对于每个变量,ANOVA给出的是对该变量下六位作曲家样本均值是否存在差异的检验,对应的F统计量及其显著性水平(significance level)才是判定依据。这里需要特别注意作者设定的门槛:显著性水平 ≤ .05 才被视为有证据表明作曲家均值不同;换言之,p ≤ .05 的变量才进入下一阶段判别分析的候选池。最后一句点出数据规模——六位作曲家的全部56首帕凡舞曲(pavans)都被纳入了表IV-A的方差分析汇总。这段话的功能是为读者建立阅读后续结果表的方法论预期:不是看绝对数值,而是先看哪些变量通过了 .05 的统计筛选门槛。
补充说明
本段提到的十四个变量详见第30–31页第三章。“pavan"是一种文艺复兴至早期巴洛克时期常见的舞曲体裁,本研究共收集56首,由六位作曲家创作。
第2段(P0661)
原文复述
$$ \text { MR1 } = \text { mean whole - notes / measure } $$
中文讲解
本段是一个变量定义公式:MR1 表示每小节的全音符平均数量(mean whole-notes / measure)。“MR"前缀暗示这是与节拍相关(measure-related)的一类变量,而"1"是该序列中的第一个。该公式把抽象的变量编号还原为可操作的计量定义——也就是统计表中每一格数字背后的实际含义。它是表IV-A中变量含义的标准说明形式之一。
第3段(P0662)
原文复述
All F statistics showed a significance difference between composers
中文讲解
本句报告了表IV-A的关键结论:所有十四个变量的F统计量在作曲家之间都达到了显著性差异的水平。这是一个非常强的整体判定,意味着对于每一条变量,六位作曲家的均值都不完全相同,因此每一个变量都至少通过了ANOVA阶段的 .05 门槛筛选,都可以作为判别分析的候选者。但这一句没有给出具体哪些变量差异更大,需要结合P0663、P0664阅读。
第4段(P0663)
原文复述
(i.e., the significance levels are all less than .05) where the variables
中文讲解
本句作为P0662的括注,明确解释了"显著性差异"的具体含义:所有变量的显著性水平都小于 .05。这一补充限定把上文的定性结论锚定到了作者事先设定的统计标准上,确保读者不会把"显著差异"理解为日常意义上的"明显”。句末的"where the variables"是一处未断句的承接,需要与P0664连读才能完成。
第5段(P0664)
原文复述
MR2, MR4, and MP6 show the greatest variance between composer means.
中文讲解
本句与P0663的"where the variables"直接相接,对前文的"全部显著"作了进一步分层:尽管所有十四个变量都通过了 .05 的门槛,但差异大小并不相同,其中 MR2、MR4 和 MP6 这三个变量在作曲家均值之间呈现了最大的方差(greatest variance between composer means)。这就告诉读者,后续如果要把变量按区分能力排序,这三个应排在最前;而其他变量虽然也显著,但区分力度较弱。“MR"与"MP"的前缀差异提示读者:这两类变量可能分属不同的测量维度(measure-related 与某一种以 P 开头的维度)。
补充说明
本段与P0661呼应,MR类变量与节拍(measure)相关,MP类变量的具体含义未在本节给出,需参照第三章变量说明。
第6段(P0665)
原文复述
The Statistical Analysis System (SAS) program which runs ANOVA also
中文讲解
本句交代了执行分析的软件工具:Statistical Analysis System(SAS)程序同时承担了ANOVA的运算。这是一个事实性的方法说明,旨在让读者知道表IV-A中的统计量来自SAS软件的输出,为后续数据的可重复性提供背景信息。句末的"also"表明SAS不仅做ANOVA,还提供另一项功能,这一点会在P0666中展开。
第7段(P0666)
原文复述
provides a Duncan’s multiple range test to compare the composer means for
中文讲解
本句承接P0665,说明SAS在ANOVA之外还提供了Duncan多重极差检验(Duncan’s multiple range test)。这是一种事后比较(post-hoc comparison)方法:当ANOVA整体上拒绝了"所有均值相等"的原假设之后,还需要进一步知道是哪几对作曲家之间存在差异。Duncan检验正是用来逐对比较六位作曲家的均值在每个变量上的具体差异。
补充说明
Duncan多重极差检验是ANOVA之后的常用多重比较方法之一,用于在多组均值间确定哪些配对显著不同。
第8段(P0667)
原文复述
each variable. The results, in Appendix 2, verified the statistical dissim-
中文讲解
本句完成了方法描述的收尾:Duncan检验的结果被收录在附录2(Appendix 2)中,这些结果"verified”(验证)了——句末被截断的词根"dissim-“应与P0668拼合为"dissimilarity”(不相似性)。因此本句的功能是:把判别分析之外的一项独立验证手段(Duncan检验 + 附录2)作为旁证,用以支持表IV-A中ANOVA得出的"作曲家之间存在差异"的结论。
补充说明
本句与P0668跨段拼词(dissim-/ilarity),属于版面造成的换行拆分。
第9段(P0668)
原文复述
ilarity between composers on all variables.
中文讲解
本句补全P0667中跨行截断的单词,与上文连读为"dissimilarity between composers on all variables”,即"在所有变量上都验证了作曲家之间的统计不相似性"。这是整个小节的收束句,重申了基于Duncan检验的旁证结论:六位作曲家不仅在F检验层面整体不同,在多重比较的逐对层面也维持了差异。从论证结构上看,它给表IV-A的结论加上了第二重独立证据,使小节的核心主张更具说服力。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节含有三项需要读者注意的附加材料:(1)数学公式P0661以LaTeX排版给出MR1变量的定义,形式为每小节全音符均值;(2)跨段拼词现象——P0667末尾"dissim-“与P0668首"ilarity"合为"dissimilarity”,是排版断行造成的;(3)提到的附录2(Appendix 2)收录了Duncan多重极差检验的全部结果,是表IV-A结论的独立旁证,本节正文未展开。
💡 本节核心要点
- 本节采用ANOVA与判别分析的两阶段筛选策略:先用ANOVA粗筛,再用判别分析精判;粗筛门槛为F检验显著性水平 ≤ .05。
- 数据规模:六位作曲家的全部56首帕凡舞曲;分析对象为十四个变量(详见第30–31页第三章)。
- 表IV-A的关键结论是:所有十四个变量的F统计量都达到了 .05 以下显著性水平,即每个变量都通过了粗筛门槛。
- 在所有变量中,MR2、MR4 与 MP6 在作曲家均值之间表现出最大的方差,是区分能力最强的三个候选变量。
- Duncan多重极差检验(运行于SAS软件)作为独立验证手段,其结果收录于附录2,在所有变量上都验证了作曲家之间的统计不相似性。
🔑 关键术语
- ANOVA (Analysis of Variance):方差分析。本节中用于检验六位作曲家在某一变量上的均值是否存在显著差异,输出F统计量及其显著性水平。
- F statistic / significance level:F统计量与对应的显著性水平(p值)。本节以 p ≤ .05 作为变量进入判别分析候选池的门槛。
- Discriminate analysis:判别分析。本节作为ANOVA之后的第二阶段,用于进一步判断哪些变量能有效区分作曲家。
- Duncan’s multiple range test:Duncan多重极差检验。ANOVA之后的多重比较方法,用于逐对比较作曲家均值在每个变量上的具体差异;本节结果置于附录2。
- SAS (Statistical Analysis System):本研究中执行ANOVA与Duncan检验的统计软件。
- pavan:帕凡舞曲,文艺复兴至早期巴洛克时期的一种二拍子体裁;本研究共采集56首,由六位作曲家创作。
- MR / MP 变量前缀:十四个变量的编号前缀。MR1在本节定义为"每小节全音符均值",MR2、MR4 与 MP6 是表IV-A中区分力最强的三个变量;MP类变量的具体含义需参见第三章。
s70 [描述性拆分] DISCRIM on Byrd and Bull Known Pavans (First Half)
第1段(P0669)
原文复述
To test the accuracy of discriminate analysis in classification of
中文讲解
本句开宗明义地交代研究目的:检验 discriminate analysis(判别分析)在对作曲家作品进行归属分类时的准确性。“classification of composers’ pieces"指的是根据作品特征将每首作品判定到其作曲家名下。
第2段(P0670)
原文复述
composers’ pieces, DISCRIM (SAS name for the discriminate analysis program)
中文讲解
承接前句,引出本研究使用的具体工具——DISCRIM,并括注其为SAS统计软件包中判别分析程序的名称。值得注意的是,原文使用的是 “discriminate analysis” 而非统计学更常见的 “discriminant analysis”,这是作者本人的用词选择,本节统一沿用。
补充说明
DISCRIM是SAS提供的标准判别分析过程名,本节将其等同于作者所称的判别分析方法。
第3段(P0671)
原文复述
was run using all of Byrd’s and Bull’s “known” pavans. Each composer’s
中文讲解
说明DISCRIM的运行范围:使用全部归属已确证的(“known”)Byrd和Bull的pavans。引号中的"known"暗示存在归属尚未确认或存疑的作品,本研究只采用归属明确者。句子后半引出"Each composer’s”,为下一句按作曲家拆分数据做铺垫。
补充说明
“known” pavans指作者认定为归属无疑的pavans样本。
第4段(P0672)
原文复述
data was randomly divided in half where the first half of each composers’
中文讲解
描述数据划分方式:每位作曲家的数据被随机地一分为二。本片段以 “the first half of each composers’” 收尾,为下一句说明两半各自用途作衔接。
第5段(P0673)
原文复述
data was used in the discriminate analysis and the second half was used as
中文讲解
承接前一句,明确两半数据的不同用途:第一半进入判别分析作为建立分类依据的训练样本;第二半被留作下一句所说的"未知"测试样本。
第6段(P0674)
原文复述
“unknown” test cases to check on the accuracy of the classification. The
中文讲解
明确第二半的身份——被视作模型从未见过的"unknown"(未知)测试样本,用于检验判别归类的实际准确率。末尾的"The"使句子重新回到对第一半处理方式的叙述。
补充说明
“unknown"加引号表示相对于模型的"未参与训练"状态,而非作品归属真的未知。
第7段(P0675)
原文复述
first half of the data is subjected to the discriminate analysis and is
中文讲解
转回说明第一半数据的处理:第一半被送入判别分析流程(subjected to),并将在下一句用于其自身的检验。
第8段(P0676)
原文复述
used to test against itself for accuracy of classification. The results of
中文讲解
说明第一半数据的具体测试方式:用于对自身进行检验(test against itself),以衡量分类准确率;这是一个内部自检步骤。然后句首的 “The results of” 开始引向结果的呈现。
补充说明
“test against itself"指把模型对其训练样本重新分类,观察分类结果与已知归属的吻合程度。
第9段(P0677)
原文复述
the first stage of DISCRIM on the first half of Byrd’s and Bull’s known
中文讲解
限定本节所报告的内容:这是DISCRIM在第一阶段(first stage)的输出,处理对象是Byrd和Bull已知pavans数据的第一半。
补充说明
“first stage"暗示后续还有其他阶段(本节标题亦称"First Half”),下一节将报告第二半作为未知样本的测试结果。
第10段(P0678)
原文复述
pavans are given in Table IV-B.
中文讲解
说明本节结果的呈现位置——第一阶段、第一半数据的判别分类结果见Table IV-B。读者需查阅该表获取具体的正确归类率、混淆情况等定量信息。
补充说明
Table IV-B为正文后的结果表,本节仅以导引方式指向它。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节标题明确为"First Half”,暗示后续还有关于第二半(“unknown"测试样本)结果的对应小节。文中唯一的非正文元素为对Table IV-B的指引,未出现脚注、图表说明或边栏。
💡 本节核心要点
- 研究目的:检验DISCRIM判别分析在作曲家作品归属分类中的准确性。
- 数据范围:Byrd与Bull全部"已知"归属的pavans。
- 实验设计:将每位作曲家的数据随机一分为二,第一半用于建模与自检,第二半留作"未知"测试样本。
- 本节范围:仅报告第一阶段、第一半数据的自检分类准确率。
- 结果以表格形式呈现,具体数据见Table IV-B。
- 小节标题"First Half"预告将有第二半结果的对应小节。
🔑 关键术语
- DISCRIM:SAS统计软件中判别分析过程的名称,本研究用以执行discriminate analysis的工具。
- discriminate analysis:判别分析;一种依据若干特征将样本归入已知类别的统计分类方法,本研究中用于依据音乐特征将pavans归到Byrd或Bull名下。
- “known” pavans:归属已被确证或被作者接受归属无疑的pavans样本;本节只采用这一类作品以避免归属争议影响判别。
- Table IV-B:本节报告DISCRIM第一阶段、第一半数据判别结果所在的表格。
- “unknown” test cases:在判别模型训练阶段未参与建模的测试样本,用于评估模型对未见作品的分类准确率;本节中即每位作曲家数据被随机留出的第二半。
s71 [描述性拆分] Table IV-B Results and Classification Accuracy
第1段(P0679)
原文复述
The first half of Byrd’s known pavans could be mis-classified as Bull’s 5.88% of the time. The variables used in this study correctly classified Byrd’s pavans in 94.12 out of 100 cases. Bull’s known pieces could not be so easily identified as his own, given these pavans and these variables, but 74.36% is quite an acceptable level of success.
中文讲解
本段是 Table IV-B 的结果解读文字,专门汇报分类模型对 Byrd 与 Bull 两位作曲家帕凡舞曲(pavan)归属判断的准确率。
第一句报告的是"假阳性"侧的误差:Byrd 已知的帕凡中,有 5.88% 被误判为 Bull 的作品。第二句紧接着给出对应的正确率——94.12/100,即 94.12% 的 Byrd 帕凡被正确识别为 Byrd。5.88% 与 94.12% 之和恰好等于 100%,说明在 Byrd 的样本中,模型只把它"误投"给 Bull 这一类,没有第三种去向;这两个数字其实是同一组数据从两个角度的呈现。
第三、四句转向 Bull 这一类。作者用一个转折句"could not be so easily identified as his own"指出,用同一套变量、同一组帕凡做训练与测试时,Bull 作品的自我识别率低于 Byrd;尽管如此,74.36% 仍被作者评价为"quite an acceptable level of success”。这是一个值得注意的语气:作者没有掩饰模型对 Byrd 比对 Bull 更"友好"的不对称表现,而是明确承认困难,但仍肯定 74.36% 在风格归属研究(style attribution)中具有实用价值。
放在本节论证链中,这段文字承担的是"用具体数字回应分类问题"的功能:先告诉读者 Byrd 几乎不会被错认成 Bull(漏判/误判极低),再承认 Bull 的自识别存在难度,最后给出一个总体上可接受的口径,为后面讨论这些变量为何更适合 Byrd、或者下一步如何调整提供了入口。
容易误解之处:不要把 5.88% 理解为"Byrd 像 Bull 的程度”,也不要把它等同于整体错误率;它只是 Byrd 样本中流向 Bull 类的那一小部分。也不要因为 Byrd 的 94.12% 与 Bull 的 74.36% 差距大,就推论模型"偏袒 Byrd"——这只是同一变量集合对两位作曲家作品特征分辨力的差异。
补充说明
段中两个百分比之间的算术关系(5.88 + 94.12 = 100)只在本段内部可直接验证;其他超出本段范围(如样本总数、变量具体含义、是否做交叉验证等)原文未提供,本节不予补写。
脚注 / 边栏 / 图表 / 附加信息(如有)
无脚注、无图表附注、无边栏。Table IV-B 本身在原文中以表格形式呈现其数据,本段为该表正下方的文字说明,仅复述表中数字并加以评价。
💡 本节核心要点
- Table IV-B 的核心指标是分类准确率:Byrd 帕凡 94.12% 被正确归为 Byrd,5.88% 被误判为 Bull。
- 两个 Byrd 的数字互补(5.88% + 94.12% = 100%),说明 Byrd 样本在 Byrd/Bull 二分类中只流向这两类。
- Bull 作品的自我识别率为 74.36%,明显低于 Byrd 的 94.12%,说明同一组变量对 Bull 的分辨力较弱。
- 作者明确承认 Byrd 与 Bull 之间存在识别难度的非对称,但仍判定 74.36% 为可接受的成果。
- 本段以数字结论结束本节论证,为后续讨论变量选择或方法局限留下空间。
🔑 关键术语
- pavan:文艺复兴时期一种二拍子、节奏稳健的宫廷舞曲体裁,本研究选取 Byrd 与 Bull 的帕凡作为风格归属(style attribution)分析的对象。
- classification accuracy / 分类准确率:指模型将已知作者的作品正确归到对应作者名下的比例,例如 94.12/100 即 94.12% 的 Byrd 帕凡被正确判为 Byrd。
- misclassification rate / 误判率:指本属于某作者的作品被模型判给另一作者的比例,本段中 5.88% 即 Byrd 被误判为 Bull 的比例。
- variables / 变量:本研究中用于刻画帕凡风格特征的量化指标(如音程、节奏、终止式等度量),原文未在本节展开其具体定义,仅作为分类依据出现。
s72 [描述性拆分] Table IV-C Results: Classifying the Second Half as Unknowns
第1段(P0680)
原文复述
The next step was to use the second half of each composer’s grouped pavans as “unknown” cases and use the model from the first half to classify the “unknown” cases. This provides a check as to how well the discriminate procedure will work when classifying known pavans.
中文讲解
本段交代本小节的方法论设计。作者把每位作曲家已被分组的帕凡舞曲一分为二:用前半段建立判别模型,再用前半段的判别规则去"辨认"后半段,并将后半段作为"未知样本"处理。这种 hold-out(保留样本)式检验的目的,是评估判别程序对已知归属的乐曲究竟能否稳定地把它们重新归入正确的作曲家组别。换言之,它不是引入新作曲家,而是检验模型自身的内部一致性。
补充说明
术语"discriminate procedure"指判别分析(discriminant analysis);“unknown cases"是统计分类中的惯用说法,即对模型而言不再参与训练、只用来做预测检验的样本。本段为接下来给出 Table IV-C 的具体百分比提供方法框架。
第2段(P0681)
原文复述
The classification based on the first half of the data correctly
中文讲解
这一行承接上段方法,转入报告检验结果——前半段数据建立的判别模型对后半段的归类准确率。它本身只是句子开头,但点明"基于前半段数据"这一基准,使读者明确接下来报出的百分比是模型预测成功率,而非随机或常识性估计。
第3段(P0682)
原文复述
classified 86.11% of Byrd’s and 34.21% of Bull’s second-half data. 86.11%
中文讲解
本段行报告两个核心数字:模型把 Byrd 后半段帕凡舞曲正确归入 Byrd 一组的比例为 86.11%,而对 Bull 后半段帕凡的正确归入率仅 34.21%。两个数字的巨大落差是本小节论证的关键事实——同样是"前半段建模、后半段检验”,对两位作曲家的结果判若云泥:模型对 Byrd 仍然高度稳定,对 Bull 则几乎失效。
补充说明
两个百分比的并列是为下一步的解释铺垫:必须先让读者看到差距本身,再说明差距意味着什么。
第4段(P0683)
原文复述
verification is still a good indicator of group membership for Byrd’s
中文讲解
本行紧接上句数字,给出对 Byrd 86.11% 这一结果的方法学评价:判别模型对 Byrd 作品仍是一个良好的组别归属指标。也就是说,Byrd 的帕凡舞曲之间存在足够一致的风格特征,使得由前半段得出的判别规则在后半段仍然奏效。这一判断的隐含意义是:86.11% 的命中率足以支持 Byrd 作品整体的风格同质性。
补充说明
“verification"在此上下文中指对模型判别能力的验证步骤,而非一般意义上的"核实”。
第5段(P0684)
原文复述
pavans, while Bull’s 34.21% shows just the opposite tendency. It would
中文讲解
本行用 “while” 与前句对照,明确 Bull 的 34.21% 表现了"正好相反的趋势"。“Just the opposite tendency” 的措辞很重,强调该数字已不能视为可靠的组别归属证据。同时 “It would” 引出下文的推断,使读者预期作者将解释这一反常现象的原因。
第6段(P0685)
原文复述
appear that the second half of Bull’s total pavans are less similar to his
中文讲解
本行开始给出对 Bull 低命中率的解释性推断:Bull 的帕凡舞曲后半段,与他自己前半段的相似度,反而低于与 Byrd 帕凡的相似度。这是一个相当强的论断——意味着 Bull 后期作品在判别特征上"更像 Byrd"而非"更像自己早期"。这通常用来解释作者风格演变或外来影响的介入。
补充说明
“less similar to his (first) than they are to Byrd’s"是一个统计学对称性论断,描述的是特征空间的距离关系,而非简单的听感相似。
第7段(P0686)
原文复述
first than they are to Byrd’s pavans. (For a list of which pavans by both
中文讲解
本行完成对 Bull 推断的句法收尾,同时以括号转入资料指引:为读者指出附录 1 列出了本次判别分析两个阶段(前半段训练集与后半段检验集)所分别包含的具体帕凡曲目。这一括号提示体现研究透明度——作者把所有纳入分析的乐曲清单都公开给读者核查。
补充说明
括号说明属于元文本(meta-text),用于引导读者查阅附录,本身不构成论证内容。
第8段(P0687)
原文复述
composers make up the first and second stages of this discriminate analysis,
中文讲解
本行延续上一行的括号内容,进一步点明附录 1 涵盖两位作曲家的曲目,并区分判别分析的"第一阶段"与"第二阶段”。“first and second stages"与本节方法论中"用前半段建模、后半段检验"的两次操作严格对应。
补充说明
“stages"在此指代方法论上的两次操作,而非时间意义上的阶段。
第9段(P0688)
原文复述
see Appendix 1.)
中文讲解
本行是括号引导句的收尾,指示读者查阅附录 1。它本身不包含新主张,而是把方法论的可复核性落到具体出处,使感兴趣的读者可以追溯到逐首曲目的归属情况。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节末尾括号指引读者参阅 Appendix 1,其中应列出 Byrd 与 Bull 在判别分析第一阶段(训练用前半段)与第二阶段(检验用后半段)所分别纳入的全部帕凡舞曲清单,是支撑本节 86.11% 与 34.21% 两个百分比的底层数据出处。
💡 本节核心要点
- 本节采用"前半段建模、后半段作为未知样本检验"的留出法,以评估判别模型对已知归属作品的稳定性。
- 对 Byrd 而言,后半段正确归类率为 86.11%,表明其帕凡舞曲风格具有较强的内部一致性,判别规则可以稳定推广。
- 对 Bull 而言,后半段正确归类率仅 34.21%,与 Byrd 表现形成鲜明对照,说明模型对其作品几乎失效。
- 作者由此推断:Bull 帕凡的后半段与其前半段的相似度,反而低于与 Byrd 帕凡的相似度,提示 Bull 后期作品在判别特征空间里更接近 Byrd。
- 附录 1 列出了两个阶段所分别使用的具体帕凡曲目清单,提供了本节数字结果的可追溯依据。
🔑 关键术语
- discriminate procedure:判别分析(discriminant analysis)的程序;本节中先以作曲家作品的前半段建立判别规则,再将后半段作为未知样本进行分类,以检验规则的有效性。
- “unknown” cases:对模型而言不再参与训练、仅用来测试预测能力的样本;本节中即每位作曲家的帕凡后半段。
- group membership:作品归属于哪位作曲家这一分组身份;本节检验判别规则能否在不出现在训练集的作品上仍然正确指认其组别。
- verification:对判别模型预测能力的验证步骤,本节以 86.11% 与 34.21% 两个百分比量化该验证的结果。
- Appendix 1:附录 1,列出本节判别分析两个阶段(第一阶段训练集、第二阶段检验集)所分别包含的 Byrd 与 Bull 帕凡舞曲清单,是数字结果的数据出处。
s73 [描述性拆分] Possible Explanations for Bull’s Weak Second-Half Performance
第1段(P0689)
原文复述
The surprising results from Bull’s second pavan group might be attributable
中文讲解
本段开启本节论证,承认 Bull 第二组帕凡(pavan)判别分析得出了令人意外(即未完全成功)的结果,并预告下文将列举可能的原因。原文此处跨段断行,‘attributable’ 一词的拼写在下一段才完整出现,本段实质上是整句的开头。
第2段(P0690)
原文复述
to at least three causes. The pavans themselves were arbitrarily
中文讲解
本段承接 P0689 拼完 ‘attributable’ 一词,明确指出意外结果至少可归因于三个原因(注意 ‘at least’ 这一限定词,预留了第四种以上可能性的空间),并开始阐述第一个原因:‘这些帕凡本身是被任意(arbitrarily)选取的……’。第一个原因的叙述将延续至下一段。
第3段(P0691)
原文复述
chosen from the second half of a list derived from the editions listed in
中文讲解
继续第一个原因:这些帕凡是从附录 2 所列各版本编成的清单的’下半段’任意抽取的。作者的批评点在于取样仅集中在清单后半,可能造成样本偏差;选择并非完全随机,而是受到清单顺序位置的影响。
补充说明
‘Appendix 2’ 指本研究中使用的版本目录(原书附录 2),是帕凡样本清单的来源参照。
第4段(P0692)
原文复述
Appendix 2. Had they been randomized further, perhaps some difference would
中文讲解
结束第一个原因的说明,并加入反事实假设:若当初的随机化更充分(‘Had they been randomized further’),两阶段分析之间或许会显现差异(‘perhaps some difference would show’)。这是作者对自身抽样设计的方法学反思——用 ‘perhaps’ 限定语气,承认更深随机化也许、但不一定能改变结果。
第5段(P0693)
原文复述
show in scores between the two stages of analysis. The variables themselves
中文讲解
本段结束 P0692 的反事实句(‘两阶段分析的得分之间或许会显现差异’),并将论证从’抽样问题’过渡到第二个原因——‘变量本身(the variables themselves)……’。下文将讨论所用变量是否具有足够辨别力。
第6段(P0694)
原文复述
may lack discriminatory power given a wider variety of pieces, as evidenced
中文讲解
本段阐述第二个原因:面对更多样化的曲目时,所用变量可能缺乏足够的辨别力(discriminatory power)。‘may’ 把这条限定在可能范围内;‘as evidenced by’ 为下一段引出 Bull 第二组帕凡作为具体证据埋下伏笔。
第7段(P0695)
原文复述
by the second set of Bull’s pavans. Discriminate analysis is not a perfect
中文讲解
本段为第二个原因提供实证——‘第二组 Bull 帕凡本身即是这种局限的证据’,并随即转入第三个原因:判别分析(discriminant analysis)本身并非完美测试(‘is not a perfect test’)。论证重心从’变量’层面进一步上移到’方法论’层面。
补充说明
‘Discriminate analysis’(判别分析)是依据多个测量变量把样本归入已知类别的统计方法,本研究中用于把帕凡归入其作曲家组别。
第8段(P0696)
原文复述
test, and may not provide an adequate method to classify pavans as to group
中文讲解
继续阐述第三个原因:判别分析也许(may)在当前研究中并非将帕凡按组别归属分类的充分方法。‘may’ 与 ‘in this case’(见 P0697)共同把这一限定收紧到’本案例’范围内,并非全盘否定判别分析这一方法本身。
第9段(P0697)
原文复述
membership in this case.
中文讲解
本段仅结束第三个原因的整句(’……在本例中将其归入组别的成员资格’)。独立成段是排版所致,整段承载的信息极小,是上一段句意的自然收束。
第10段(P0698)
原文复述
However, the two tests taken together show the analysis verifying two
中文讲解
‘However’ 标志着论证的关键转折:尽管前面列举了三项方法学疑虑,但当两种检验合起来看时,判别分析仍验证了(verifying)两位作曲家的……这正是本节从’可能的解释’转向’方法依然可用’的节点。’the two tests’ 指本节判别分析与前文 ANOVA 合并使用。
补充说明
’the two tests taken together’ 指本节判别分析与先前报告中已使用的 ANOVA(方差分析)两项检验合并考虑。
第11段(P0699)
原文复述
composers’ pavans in three out of four cases. It was determined that the
中文讲解
本段给出具体验证率:4 例中 3 例成功(’three out of four cases’);并开始陈述由此得出的判断——‘这些变量……’。3/4 的成功率是决定继续推进研究的关键数据支撑。
第12段(P0700)
原文复述
variables looked positive enough from this and the ANOVA results to merit
中文讲解
本段说明判断的具体内容:从本判别分析(’this’)与先前 ANOVA 两者综合来看,变量表现得足够积极(‘positive enough’),足以……‘merit’ 为’值得’之意,是决策性动词,为下一段的研究继续决定作铺垫。
补充说明
‘ANOVA results’ 指前文已完成的方差分析结果,与本节判别分析合为判断变量效度的两项依据。
第13段(P0701)
原文复述
continuing with a discriminate analysis on all of the composers under study.
中文讲解
本段是本节结论:值得继续对所有被研究的作曲家做判别分析。前面三项方法学疑虑并未推翻研究计划,而是与 3/4 成功率、ANOVA 阳性结果共同支撑这一继续决定——本节以积极的推进意愿收束。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节脚注、图表、边栏等附加材料:正文中出现的 ‘Appendix 2’ 指代的是本研究中使用的版本目录(原书附录 2),但本节自身未列出具体内容;‘ANOVA results’ 与前文方差分析结果相互照应,属于跨节引用而非本节独立附加材料。本节范围内未见独立图表、表格或脚注。
💡 本节核心要点
- 本节是对 Bull 第二组帕凡判别分析结果不理想这一’意外结果’的方法学反思。
- 作者列出至少三个可能原因:帕凡取样任意(仅取自附录 2 清单下半段)、变量在更广曲目下辨别力可能不足、判别分析本身在本案例中可能不是充分的归类方法。
- 取样方法上存在反事实自我批评:若随机化更充分,两阶段分析的得分之间也许会显现差异。
- 尽管有上述三项疑虑,作者以 ‘However’ 转折,指出两种检验(判别分析与 ANOVA)合用时,在 4 例中成功验证了 3 例(3/4)。
- 由此判断变量已足够积极,值得对全部受研究作曲家继续进行判别分析——前述方法学疑虑并不推翻研究计划,只是为后续分析划出边界条件。
🔑 关键术语
- Discriminant analysis(判别分析):依据若干测量变量把样本归入已知类别的统计分类方法。本研究中用于把帕凡归入其作曲家组别。
- Pavan / Pavane(帕凡):本研究中作为分析样本的乐曲体裁,具体指 Bull 等作曲家所写的键盘帕凡舞曲。
- Discriminatory power(辨别力):变量区分不同组别(如不同作曲家)的能力。本节指出当曲目种类扩展时,所用变量可能丧失足够的辨别力。
- ANOVA(方差分析):前文中已用于本研究的统计检验,与本节判别分析合并作为判断变量效度的两项依据。
- Appendix 2:本研究中使用的版本目录(原书附录 2),是 Bull 等作曲家帕凡样本清单的来源参照。
- Bull:本研究中受分析的作曲家之一,其第二组帕凡在判别分析中表现意外(不理想),是本节方法学反思的核心案例。
s74 [描述性拆分] Discriminate Analysis on all 6 Composers
第1段(P0702)
原文复述
Section heading: “Discriminate Analysis on all 6 Composers” — a chapter/section title introducing an analytical treatment that applies discriminate (discriminant-style) analysis to the full set of six composers under study.
中文讲解
本段并非正文,而是位于第44页的一个小节标题。该标题的功能是宣告:作者即将对全部6位作曲家同时施用一种判别性的分析方法(原文写作 Discriminate Analysis,结合上下文与统计方法命名惯例,更可能指判别分析 Discriminant Analysis,但原文拼写如此,应予以保留)。标题中"all 6 Composers"明确划定了分析范围——不是单一作曲家或抽样个案,而是覆盖研究中涉及的全部六位作曲家。这表明本节承担的是横向汇总分析的角色:把分散在前面各节中对个别作曲家的讨论汇总在同一统计框架下进行对比或归类。在论文结构上,这种标题一般意味着后续会出现一张或一组判别分析的图表(例如散点图、聚类图、判别函数得分表等),但具体形式需查看原页内容确认。
补充说明
原文标题拼写为 Discriminate 而非统计学常见的 Discriminant,是否为排印或OCR问题需对照原书确认;本节复述严格保留原文拼写,不作改动。
💡 本节核心要点
🔑 关键术语
s75 [描述性拆分] Table IV-D Results Across the Six Composers
第1段(P0703)
原文复述
The second part of the research was to conduct a discriminate analysis.
中文讲解
本段以一句简短的过渡性陈述开启了小节的核心内容:研究的第二部分,是针对已选样本执行一次判别分析(discriminate analysis)。它承接前文已完成的样本与方法说明(第一部分),把论述推进到统计分析阶段。“第二部分"这一措辞暗示前面已经有过一个部分(很可能涉及描述性统计或初步的变量比较),读者应当把本段理解为对小节主题的功能性定位,而非新的研究问题。
第2段(P0704)
原文复述
based on the 14 variables using all six composers’ known pavans and five
中文讲解
本段承接 P0703,进一步限定判别分析的实施条件:以 14 个变量为基础,纳入的样本是全部六位作曲家已知的帕凡舞曲(pavans),以及五首归属存在争议的帕凡舞曲。读者需要从这句中同时抓住三个数字——变量数 14、作曲家人数 6、争议帕凡数 5——它们共同界定了统计模型的形式(变量数)与数据规模(样本量)。“known pavans” 与 “disputed pavans” 的并存,说明分析既要对归属明确的乐曲建模样式,也要对归属未定的乐曲进行归属判定。
补充说明
本句跨段接续 P0703,构成一个完整句子的一部分;句末的 “five” 在 P0705 才与 “disputed pavans” 接续完成。
第3段(P0705)
原文复述
disputed pavans. A list of sources for all of the pieces is given in
中文讲解
本段先把上一段末尾悬置的 “five” 收束为 “disputed pavans”,从而完整交代判别分析所用样本——五首归属有争议的帕凡舞曲;随后把话锋转向资料交代:所有乐曲的出处清单列于附录 1(Appendix 1)。这一句同时承担两个功能,一是样本描述的收尾,二是为下文引用 Table IV-D 的数据提供可追溯的来源凭证,让读者能够据此核对每首曲目的归属与版本。
补充说明
本句跨段接续 P0704 与 P0706;“given in” 在 P0706 才与 “Appendix 1” 接续完成。
第4段(P0706)
原文复述
Appendix 1. The number of pavans making up the sample for Farnaby, Gibbons,
中文讲解
本段先把上一段末 “given in” 收束为 “Appendix 1”,交代样本曲目的资料出处附录;随后开启各作曲家样本量的逐项列举,首位给出 Farnaby 与 Gibbons。这里之所以把两位作曲家先行列出,应是按 P0707 所列顺序的前两位——读者需要把这两段作为一个连贯的整体来阅读。“making up the sample” 这一措辞强调这些数字是判别分析实际投入建模与分类的乐曲数,而不是每位作曲家全部已知的帕凡作品。
补充说明
本句跨段接续 P0705 与 P0707。
第5段(P0707)
原文复述
Byrd, Bull, Morley and Philips were, respectively, 6, 3, 25, 13, 4, and 4.
中文讲解
本段完成了 P0706 起首的列举,给出六位作曲家在判别分析中的样本量,按顺序分别为 Byrd 25 首、Bull 13 首、Morley 4 首、Philips 4 首。综合 P0706 与本段,全部样本量为:Farnaby 6 首、Gibbons 3 首、Byrd 25 首、Bull 13 首、Morley 4 首、Philips 4 首,共 55 首已知帕凡,再加 5 首争议帕凡。样本量极不均衡:Byrd 与 Bull 的样本占绝大多数,而 Gibbons 仅 3 首,Morley 与 Philips 各仅 4 首。这意味着对小样本作曲家的判别结果稳定性需谨慎对待,而对 Byrd 与 Bull 的判别结果更具统计可信度。
第6段(P0708)
原文复述
Table IV-D shows that in the first half of DISCRIM, each composer’s pavans were correctly classified in a majority of cases, with the exception of Bull’s. His misclassified pieces most often resembled Byrd’s or Philips’, with far fewer classified as Farnaby’s, Morley’s, or Gibbons’. Such a spread of his misclassifications across several composers reinforces the earlier assumption that Bull’s individuality may have little to do with the measures in this study. Gibbons and Morley on the other hand stand out as the most “distinctive” composers, with no misclassifications of their pieces to any others. Farnaby is never classified as Gibbons, but his remaining misclassifications are spread across the other composer groups, as are Byrd’s and Philips’. Misclassifications between two composers are not mutually proportional. That is, Philips’ pieces are never classified as Bull’s,
中文讲解
本段是本小节的核心论述段落,对 Table IV-D 所呈现的判别分析结果做逐层解读。
第一层是总体格局:在 DISCRIM 的前半段,每位作曲家的帕凡在多数情况下都能被正确归类,唯一例外是 Bull。这意味着就整体而言,这 14 个变量对作曲家风格的区分能力是成立的。
第二层聚焦 Bull 这一例外。他的误判作品最常被判入 Byrd 或 Philips 一类,极少被归入 Farnaby、Morley 或 Gibbons。误判分散于多位作曲家之间,作者由此重申一个较早的假设——Bull 个人风格的辨识度与本研究所采用的 14 个度量关联不大。换言之,这并非"分类模型出错”,而是 Bull 的风格变量在本数据集所选维度上呈现出与多人相似的轮廓。
第三层呈现对照:Gibbons 与 Morley 的所有作品均无误判,被作者用带引号的"distinctive”(最"独特”)标出。注意引号暗示这是一种描述性判断,而非严格的统计术语。Farnaby 的作品从不会被判为 Gibbons,但其剩余误判分散于其他作曲家之中;Byrd 与 Philips 的误判也同样分散。这意味着这些作曲家之间存在风格相似带,但没有任何一对作曲家彼此完全互为混淆。
第四层提出一个非对称性的关键观察:两位作曲家之间的误判并不互为比例——作者给出的具体例证是:Philips 的作品从不会被判归 Bull。这里句末的逗号表示句子未完,需结合小节后续内容理解。作者借此指出,分类上的相似性是有方向性的,“A 像 B"并不自动意味着"B 像 A”,这对归属争议作品的归属判定至关重要。
整体而言,本段的功能是用 Table IV-D 的数据为后续讨论 Bull 与其他作曲家风格关系、以及争议帕凡归属问题奠定经验基础。
补充说明
“first half of DISCRIM” 指判别分析的前半段输出,结合上下文应为已归属作曲家之间的判别;“second half” 通常对应争议帕凡归属推断,将在本小节后续段落讨论。句末逗号说明本段文字在小节中是被截断的,后接段落继续展开 Philips—Bull 误判的方向性问题。
脚注 / 边栏 / 图表 / 附加信息(如有)
本小节承接前文,主体依托 Table IV-D 的统计输出对小节标题所列"六位作曲家"的判别结果进行分组叙述。除正文外,本小节涉及以下附加材料:① Appendix 1——所有帕凡曲目出处清单,由 P0705—P0706 引用,作为可追溯的来源凭证;② Table IV-D——本节核心数据来源,作者援引其在 DISCRIM 前半段(即已归属样本之间的判别)中的结果展开解读;③ 暗示存在 Table IV-D 的"后半段",应涉及五首争议帕凡的归属推断,将在本节后段继续讨论。小节未直接给出脚注编号。
💡 本节核心要点
- 本小节的核心是报告一次以 14 个变量为输入、覆盖六位作曲家已知帕凡及五首争议帕凡的判别分析结果。
- 六位作曲家的样本量极不均衡:Byrd 25 首、Bull 13 首、Farnaby 6 首、Morley 4 首、Philips 4 首、Gibbons 仅 3 首。
- DISCRIM 前半段总体有效:除 Bull 外,每位作曲家的多数帕凡均能被正确归类,说明 14 个变量整体上具备风格区分力。
- Bull 是唯一例外:其误判分散于多位作曲家之间,作者据此推断 Bull 的个人风格与本研究选用的度量关系不大。
- Gibbons 与 Morley 表现为最"distinctive"的作曲家,所有作品均无误判;Farnaby、Byrd、Philips 的误判则分散于其余组别。
- 判别相似性存在方向性:A 的作品被判入 B 类,并不意味着 B 的作品也被判入 A 类(如 Philips 从不被判为 Bull),这对争议帕凡归属判定具有方法论意义。
🔑 关键术语
- discriminate analysis (判别分析):一种多元统计方法,依据若干变量把样本归入已知类别,本研究中用于把帕凡按作曲家风格归类。
- DISCRIM:本研究所使用的判别分析程序或模块名;“first half” 指已归属样本之间的判别,“second half” 指对争议帕凡进行归属推断。
- pavan (帕凡):文艺复兴时期一种二拍或四拍的宫廷舞曲,是本研究的核心分析对象,每位作曲家样本为若干首已知或归属有争议的帕凡。
- correctly classified (正确归类):判别分析把某首帕凡归入其实际作曲家所属的类别;“majority of cases” 表明大多数作品能被正确归类。
- misclassification (误判):判别分析把某首帕凡归入非其实际作曲家的类别,本节重点分析误判的去向,以判断作曲家之间的风格相似性。
- “distinctive” composers (“独特"的作曲家):作者加引号的描述性用语,指没有任何作品被误判归入其他组的作曲家,本节中特指 Gibbons 与 Morley。
- mutually proportional (互为比例):作者用以描述两位作曲家之间误判对称性的术语,本节指出 A 像 B 的误判与 B 像 A 的误判并不成对称比例,存在方向性。
s76 [描述性拆分] Interpreting Misclassifications in Table IV-D
第1段(P0709)
原文复述
Even though Bull’s pieces are attributed to him in 18.18% of the cases, this rate is limited because the discriminate scores reflect compound results of all 14 variables, and any single one of these variables may carry a different weight in the final score from one composer to another.
中文讲解
本段是一个承接前文的句子(以"even though"开头),用于解释为什么在判别分析中Bull的乐章归属率只有18.18%。
逐句释义:作者先承认了一个反直觉的事实——尽管某些特征让18.18%的Bull乐章能正确归属到他名下,但整体判别效果并不理想。紧接着给出原因:判别分数(discriminate scores)并不是由某一个变量单独决定的,而是把全部14个变量综合在一起的结果;而且这14个变量在不同作曲家身上,对最终分数的权重各不相同。
讲解要点:
- “compound results"是本段的关键词:判别分数是14个变量加权综合后的复合结果,不是单一变量的简单输出。
- 作者强调的是"any of which might weight the final score differently”——同一变量在不同作曲家样本上的重要性不一样。这说明判别模型对各作曲家有非对称的敏感度,单看一个对Bull有利的特征,并不能保证最终把它归入Bull。
- 例子(18.18%)的作用:用一个具体但偏低的归属率,说明即便存在有利的归属性证据,在14变量联合判别下仍可能被其他变量"淹没”,从而被错分到其他作曲家名下。
- 论证功能:这一句把前面的归属率统计与后面的错分解释桥接起来,告诉读者判别分数是一个整体的、作曲家相关的加权产物,因此单变量层面的归属正确率不能直接用来反驳高错分率。
- 易误解之处:不要把18.18%理解为Bull的总体正确分类率——它只是"被归属到Bull名下"的比例之一,整体判别结果仍受其他13个变量的联合影响。
补充说明
本段以"even though"起句,表明它承接的是更前面的一句(应位于本节或前一节未给出的句子,例如说明Bull的整体错分情况)。因此"18.18%“对应的是Bull的归属率中可被正确识别的那一部分,而本句的贡献在于用14个变量的复合加权机制解释为什么这一部分没能主导最终分类。无额外的外部补充。
脚注 / 边栏 / 图表 / 附加信息(如有)
无(该小节仅含一个承接句,无脚注、图表或边栏等附加材料)。
💡 本节核心要点
- 判别分数是14个变量的复合加权结果,不是单一变量的判定。
- 同一变量在不同作曲家身上对最终判别分数的权重可以不同,模型具有作曲家相关的非对称敏感性。
- Bull的归属率18.18%只是一个变量层面有利证据的占比,不能等同于总体正确分类率。
- 在多变量联合判别下,单个有利变量可能被其他变量所抵消,从而造成错分。
- 本段的作用是为表IV-D中的错分现象提供方法论层面的解释,而非简单的统计重述。
🔑 关键术语
- discriminate scores:判别分数:由全部14个变量加权组合得出的复合数值,用于判定某段乐章归属于哪一位作曲家。
- 14 variables:判别分析所用的14个特征变量;它们对不同作曲家的最终分数具有可变的权重。
- Bull:本研究中作为样本的一位作曲家;其作品在判别分析中仅18.18%被正确归属到他名下。
- compound results:复合结果:指多个变量共同作用后的整体输出,强调判别分数是加权综合而非单变量判定。
s77 [描述性拆分] Classifying Disputed Pieces Using Table IV-E
第1段(P0710)
原文复述
Variables 1 to 14, according to Table IV-D, appear to be very effective discriminators for this group of composers. The next stage of DISCRIM was to use the results of the discriminate analysis performed on known pavan pieces to classify the five disputed pieces into the six composer groups. The sources of the five pieces and editorial comments are provided in Appendix 1. The labels in Table IV-E assigned to each disputed piece were taken from those editorial judgments.
中文讲解
本段是从上一阶段(建立判别函数)过渡到下一阶段(对争议作品进行归类)的衔接段落,需要把握四个层次的含义。
第一,作者承接上文的统计结果:依据 Table IV-D 的表现,变量 1–14 对这群作曲家而言是「非常有效的判别指标」,也就是说 DISCRIM 流程的前一步已经挑选出足够有区分力的特征量。第二,DISCRIM 的下一步动作是「分类」而非「筛选变量」:把先前基于已知归属的 pavan 样本所建立的判别分析结果,作为参照去对五件归属有争议的作品进行归类,把每一件归入六个作曲家组中的某一组。这里的 “known pavan” 指参与训练判别函数的、归属已知的 pavan 样本集合,原文只是把它当作一类作品的标签使用,并未在本段内对该词作任何体裁或时代定义。第三,五件争议作品的来源与编者评注被放在 Appendix 1 中提供,这说明作者将来源考证与统计分析分开处理:Table IV-E 中的分类标签不是统计软件自动给出的,而是直接取自这些编辑评断中所做的归属判断。这一点是理解本段的关键——统计分类的结果(Table IV-E)与编辑学的归属评断(Appendix 1)实际上共享同一套标签来源,因此 Table IV-E 并不是对归属的独立验证,而是把已有的编辑判断以表格形式呈现出来。
掌握以上四点才能正确理解后续 Table IV-E 的作用:它展示的是把争议作品与已知 pavan 样本进行判别比较后得到的归属标签,而这些标签本身来自 Appendix 1 中的编者评断。
补充说明
本段中 “pavan” 一词仅作为已知归属样本的类别标签出现,原文未对其作体裁、时代或音乐特征的说明,因此不应在本节内补充该词的音乐学定义;它在上下文中的功能就是 “作为判别分析参照组的已知作品集合”。Table IV-E 的标签与 Appendix 1 的编者评断之间的同源关系,是理解后续表格功能的关键。
脚注 / 边栏 / 图表 / 附加信息(如有)
本段指向两处附录性材料:Appendix 1(五件争议作品的来源与编者评注)和 Table IV-E(分类结果表)。两者的关系是:Table IV-E 的归属标签直接取自 Appendix 1 的编辑评断,而非由统计判别独立产生。这一信息对正确阅读后续表格至关重要。
💡 本节核心要点
- 依据 Table IV-D,变量 1–14 对该组作曲家是非常有效的判别指标。
- DISCRIM 的下一阶段是利用已知归属的 pavan 样本所建立的判别分析结果,把五件争议作品归入六个作曲家组。
- 五件争议作品的来源与编者评注见 Appendix 1。
- Table IV-E 中分配给每件争议作品的标签,直接取自 Appendix 1 的编辑评断,而非统计判别的独立产出。
- 本段将统计流程的「变量筛选」阶段与「作品归类」阶段衔接起来,并为后续 Table IV-E 的解读设定了框架。
🔑 关键术语
- DISCRIM:本研究中采用的判别分析流程名;在本节内指先把变量 1–14 鉴定为有效判别指标,再以已知归属样本为参照对争议作品进行归类的一套统计程序。
- pavan (known pavan):在原文中作为一组已知归属作品的样本标签使用,用以建立判别分析;原文未对其作体裁或时代定义,不应在本节内补充外部音乐学解释。
- discriminators (variables 1–14):依据 Table IV-D 的表现,对该组作曲家具有强区分力的 14 个变量;它们构成判别分类所依赖的特征集合。
- editorial judgments (in Appendix 1):编者对五件争议作品归属的评断;Table IV-E 中的归属标签直接取自这些评断,因此 Table IV-E 与 Appendix 1 在归属结论上是同源的。
s78 [描述性拆分] Discussion of Disputed Piece Classifications
第1段(P0711)
原文复述
In only two of the five pieces do the discriminate scores reinforce editorial judgments about these cases. Byrd/Anon 2 was thought by editor Hendrie to be unauthentic and DISCRIM does show a close correspondence to Bull in this case. Both Anon/Bull 1 and Anon/Bull 2 indicate Byrd where the editor assumed Bull was composer. A tendency to confuse Byrd and Bull is
中文讲解
本段开始总结DISCRIM判别分析对五件归属存疑作品的处理结果。作者开篇即指出,在五件作品中只有两件的判别分数与编辑判断一致,这说明定量分析与传统编辑意见之间存在明显落差。接着详述两个一致案例:其一,编辑Hendrie认为Byrd/Anon 2并不可信,DISCRIM结果恰好显示该作与Bull高度吻合,验证了编辑的怀疑;其二,Anon/Bull 1与Anon/Bull 2原本被编辑归为Bull之作,DISCRIM却把这两首都判给Byrd,由此引出一个观察——Byrd与Bull两类风格在定量判别中容易被混淆。最后一句是跨段未完结的引导语,预示后文将延续这一观察。
补充说明
“Byrd/Anon 2"与"Anon/Bull 1”、“Anon/Bull 2"为五件归属存疑作品的编号名称,表示原归属编辑意见与作者归属待定的复合标签。DISCRIM是本研究中使用的判别分析程序名。
第2段(P0712)
原文复述
indicated by these three cases, and recalls their mixed scores in the
中文讲解
本段承接P0711结尾,说明前述Byrd与Bull的混淆倾向在三个案例中得到印证,并提示这一现象也回溯到DISCRIM初次运行时就已出现的混合分数。句子被切分在此,是为了把"initial DISCRIM run"这一关键信息留在下一段开头,以突出首次运行与本次复检之间的呼应关系。
第3段(P0713)
原文复述
initial DISCRIM run. Morley/Byrd is verified as Byrd’s, with zero classi-
中文讲解
本段先收束上一段未完成的句子——Byrd/Bull混淆的证据也见于DISCRIM初次运行中的混合分数。接着切入第三个一致案例:Morley/Byrd一作被DISCRIM确认为Byrd所作,被判为Morley之作为零。“zero classification as Morley’s"指判别函数把该作品归属Morley的后验概率为0,这是一种彻底的排除,与编辑把它判给Byrd的意见完全一致。句子在行末被切断,“fication"一词留待下段拼合。
补充说明
“Morley/Byrd"是第四件归属存疑作品,意为编辑原归Morley、待核作者可能为Byrd。
第4段(P0714)
原文复述
fication as Morley’s, upholding the editor’s decision. In this case, as in
中文讲解
本段把上一段被截断的词补全为"classification”,从而完整陈述DISCRIM对Morley/Byrd的判定结果——Morley归属概率为0,因而支持编辑把作者归为Byrd的决定。然后以"in this case, as in…“引出下一步观察,即这一案例与其他四件作品共同具备的某种特征,将由后续段落承接。
第5段(P0715)
原文复述
all four others, Gibbons and Morley never figure as likely composers. They
中文讲解
本段补完P0714的"as in…“比较结构,说明不仅Morley/Byrd这一件,在其余四件归属存疑作品中,Gibbons与Morley也从未被DISCRIM视为可能的作者。这是DISCRIM给出的一个总括性结论:六位被研究作曲家中,这两位几乎不可能出现在争议作品的作者候选名单上。句子在末尾以"They"引出对Gibbons与Morley特征的进一步描述。
第6段(P0716)
原文复述
were also the two composers with 100% correct classification in the first
中文讲解
本段接续"They”,解释为何Gibbons与Morley能够被DISCRIM彻底排除——这两位作曲家在DISCRIM第一阶段中达到了100%的正确分类率。也就是说,模型从未把别人的作品错归给他们,也从未把自己名下作品错归他人,所以一旦模型未把他们列为候选,就几乎可以排除。这一信息是支撑前段"never figure as likely composers"判断的实证依据。句子在行末再次被截断。
补充说明
“100% correct classification"指训练样本中所有已知作品均被正确归属到原作者,是判别模型内部效力的指标。
第7段(P0717)
原文复述
stage of DISCRIM. For these two composers, the variables provide an excel-
中文讲解
本段把上一段截断的句子补全,确认100%正确分类发生在DISCRIM的"first stage”,即初次运行阶段。然后作者提出推论:对Gibbons与Morley而言,研究中所用的14个变量不仅是优良的分类器,也是可靠的识别工具——既能归类,也能指认。句子末尾"excel-“被截断,“lent"留待下段拼合。
补充说明
“first stage of DISCRIM"指判别分析初次运行的结果,对应后文可能出现的二次或精选变量运行。
第8段(P0718)
原文复述
lent means of identification as well as classification. Farnaby is the most
中文讲解
本段补完截断的"excellent”,确认对Gibbons与Morley来说,14个变量兼具识别与分类的双重效力。然后话锋一转,把注意力切换到第五件归属存疑作品Byrd/Anon 1,预告该作的最大可能性作曲者是Farnaby。句子在行末以"most"被截断,“likely composer"留待下段。
补充说明
“Byrd/Anon 1"是第五件归属存疑作品,编辑原意见归Byrd、待定作者或为他人。
第9段(P0719)
原文复述
likely composer of Byrd/Anon 1 according to this analysis, though Byrd
中文讲解
本段补完上一段"Farnaby is the most”,明确DISCRIM把Byrd/Anon 1的最大作者候选定为Farnaby,但紧接着用"though"转折,提示Byrd本人也获得了一定比例的归属概率。句子以"though Byrd"结尾,将Byrd的概率数值留待下段给出。
第10段(P0720)
原文复述
receives 33.33% of the classification. The verification of Farnaby’s
中文讲解
本段补完上段"Byrd"后的概率数值——Byrd本人获得33.33%的判别分数,与Farnaby的胜出形成对照。这意味着Byrd/Anon 1虽被模型首选归为Farnaby,但Byrd仍是不可忽视的第二候选。作者由此转向对Farnaby分类表现的回顾,先给出第一阶段DISCRIM中Farnaby已知作品被正确识别的比例。句子在行末被截断。
补充说明
“33.33%“是DISCRIM给出Byrd作为Byrd/Anon 1可能作者的后验概率。
第11段(P0721)
原文复述
pieces in the first part of DISCRIM was high at 72.73%, but coincidentally
中文讲解
本段补完上段,说明Farnaby已知作品在DISCRIM第一阶段中的正确识别率达到72.73%,整体水平较高。然而"but coincidentally"这一转折引出下文:尽管Farnaby的识别率不低,其作品在错归时呈现出一种有意思的对称分布。句子在行末被截断。
补充说明
“72.73%“是DISCRIM第一阶段对Farnaby已知作品的正确归类比例。
第12段(P0722)
原文复述
his pieces were incorrectly attributed to Morley’s and Byrd’s in an equal
中文讲解
本段补完上段未竟的句子,说明Farnaby被错判的作品被等量地误归为Morley与Byrd名下。“in an equal number of cases"这一信息被切分到下段才完整呈现,但本段已足以揭示一个重要现象:Farnaby的混淆方向并非随机,而是恰好平分到两位与他风格存在某种相似性的作曲家身上。
第13段(P0723)
原文复述
number of cases.
中文讲解
本段仅补全"in an equal number of cases”,以一个完整短句结束关于Farnaby的讨论:其作品被错归为Morley与Byrd的次数相等。这一对称性是理解后续Byrd/Anon 1归属争议的重要背景——既然Farnaby与Byrd之间本身就存在错判可能性,DISCRIM把Byrd/Anon 1首选归为Farnaby而非Byrd就显得更具诊断意义。
第14段(P0724)
原文复述
The result of DISCRIM is a profile of classification that rarely
中文讲解
本段开启本小节的小结段落,先给出一个总体评价:DISCRIM生成的分类剖面很少能与所引用的编辑意见相对应。“rarely matches"是定量结论与定性编辑判断之间差距的总括表述,呼应开篇"only two of the five pieces"的具体数字。句子在行末被截断。
补充说明
“profile of classification"指判别分析为每件作品输出的作者归属概率分布。
第15段(P0725)
原文复述
matches the cited editorial opinions. Because editors never described
中文讲解
本段补完P0724的句子,确认DISCRIM的分类结果与所引编辑意见极少吻合。然后以"Because"开启因果解释:之所以出现这种落差,是因为编辑从未公开说明他们据以判断归属的具体测量标准。句子在行末被截断。
补充说明
“cited editorial opinions"指本研究在归属判断中所引用的各版编辑所作的归属结论。
第16段(P0726)
原文复述
specific measurements on which their selections were made, this test could
中文讲解
本段继续阐述DISCRIM的局限——由于编辑未给出具体的测量依据,因此本研究无法把他们的归属模型当作可检验的命题。“this test could"被切分到行末,“not check"留待下段。
第17段(P0727)
原文复述
not check the accuracy of their models. Having created a model based on
中文讲解
本段补完"could not check”,明确DISCRIM无法对编辑模型的准确性作出直接验证。然后以"Having created a model based on…“切换到本研究的自我定位:本研究虽然构建了自己的模型,但只能用它来"凸显差异"并检视自身,而非评价编辑。句子在行末被截断。
第18段(P0728)
原文复述
14 rhythmic and textural variables, this study could only highlight the
中文讲解
本段补完上段未竟的"model based on”,明确指出本研究以14个节奏与织体变量作为模型基础。由于这一变量集合是研究自有的设计,与编辑所用标准并无交集,因此本研究的功能被限定为"凸显差异”——把定量结果与编辑结论并列展示,而非裁决。句子在行末被截断。
补充说明
“rhythmic and textural variables"是本研究中用以刻画作品风格特征的14个变量所属的两个类别。
第19段(P0729)
原文复述
discrepancy between the findings and further examine its own model. A
中文讲解
本段补完P0728未竟的"highlight the”,明确研究的两项功能:一是凸显判别结果与编辑结论之间的差异,二是进一步检视本研究自身的模型。作者以"A"引出下一步的方法学转向:从全变量模型进入变量精选程序。
第20段(P0730)
原文复述
procedure for selecting only the best discriminators out of the fourteen
中文讲解
本段开始介绍新的分析步骤:一种变量筛选程序被引入,目的是从14个变量中挑选出判别效力最强的那一部分子集。“only the best discriminators"暗示将进行某种形式的变量优化,例如逐步判别或贡献度排序。句子在行末被截断。
补充说明
“best discriminators"指在判别分析中对组间分离贡献最大的变量。
第21段(P0731)
原文复述
variables was then used.
中文讲解
本段以一个完整的短句收束本小节——这种变量筛选程序随后被实际运用于分析。它构成方法学过渡:前段展示了全变量模型与编辑意见的落差,本句则宣告将用变量精选程序对模型加以精炼,为下一节的展开留下接口。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节为正文叙述,未包含脚注、图表、边栏或图像占位符;所述五件归属存疑作品(Byrd/Anon 2、Anon/Bull 1、Anon/Bull 2、Morley/Byrd、Byrd/Anon 1)的编号名称在文中直接出现,构成内文论据本身。
💡 本节核心要点
- 在五件归属存疑作品中,DISCRIM判别分数仅与编辑意见在两件(Byrd/Anon 2 与 Morley/Byrd)上达成一致,剩余三件呈现明显分歧。
- Byrd/Anon 2、Anon/Bull 1、Anon/Bull 2三个案例共同显示Byrd与Bull风格在定量判别中存在系统性混淆,这一现象也回溯到DISCRIM初次运行时的混合分数。
- Gibbons与Morley在五件争议作品中从未被DISCRIM列为可能作者,这与他们在DISCRIM第一阶段达到100%正确分类率的事实一致,凸显14个变量对二者的高识别力。
- Byrd/Anon 1被DISCRIM首选归为Farnaby,但Byrd仍获得33.33%的归属概率,而Farnaby已知作品72.73%的正确识别率说明他与Byrd、Morley之间存在等量错判的对称现象。
- 编辑从未公开其归属判断的具体测量标准,因此DISCRIM无法直接检验编辑模型的准确性;研究自身的14个节奏与织体变量模型仅能用于凸显差异与自我检视。
- 为精炼判别效力,作者将引入一种变量筛选程序,从14个变量中选出最优辨别子集,为后续分析提供方法学过渡。
🔑 关键术语
- DISCRIM:本研究中使用的判别分析程序名,用于依据14个节奏与织体变量对作品进行作者归属判别,分为第一阶段(初次运行)与变量精选后的后续阶段。
- discriminate scores:DISCRIM为每件作品输出的归属概率分布,用于衡量作品与各候选作曲家风格中心的距离或相似度,是与编辑定性判断对照的定量指标。
- rhythmic and textural variables:本研究中用于刻画维吉纳琴作品风格的14个量化变量所属的两大类别,分别从节奏层面与织体层面对作品进行编码,构成判别模型的特征空间。
- best discriminators:在14个变量中对组间分离贡献最大的若干变量;引入变量筛选程序的目的即是从全变量集合中提取该子集,以提升判别模型的精炼度与解释力。
- editorial judgments:各版编辑就作品归属所给出的定性意见,本研究将其作为对照基准,但因其未公开具体测量依据,无法被DISCRIM直接验证。
s79 [描述性拆分] Stepwise Discriminate Analysis
第1段(P0732)
原文复述
Stepwise Discriminate Analysis
中文讲解
本段为小节标题,英文原文应理解为"逐步判别分析”(Stepwise Discriminant Analysis),原文写作"Discriminate"而非"Discriminant”,但此处作为方法学名称的标题功能不变。该标题开启了一个独立小节,提示接下来的内容将围绕逐步判别分析这一统计方法展开——即将预测变量按其对判别函数的贡献逐次筛选进入或剔出模型的一种判别分析变体。作为第47页上的标题,它在本节的论证结构中起到分节标识和论题预告的作用,向读者预告本节将讨论的主题范围,但本段本身不包含实质性的方法论述、公式推导或案例应用。
脚注 / 边栏 / 图表 / 附加信息(如有)
无。该小节范围内无脚注、图表或边栏附加材料。
💡 本节核心要点
- 本小节以"Stepwise Discriminate Analysis"为标题,开启关于逐步判别分析方法的主题。
- 标题表明本节聚焦于判别分析族中带有变量筛选步骤的逐步变体。
- 作为分节标识,该标题预告了论题范围,但本身不提供方法细节或论证内容。
🔑 关键术语
- Stepwise Discriminate Analysis:逐步判别分析:判别分析的一种变体形式,其特点是按一定准则(如判别贡献大小或统计显著性)将预测变量逐次引入或剔出模型,以获得对组别区分最为有效的精简变量集。原文标题写作"Discriminate”,标准术语应为"Discriminant”。
s80 [描述性拆分] STEPDISC Procedures and Variable Selection
第1段(P0733)
原文复述
The program STEPDISC in SAS provides forward selection and backward
中文讲解
中文翻译:“SAS 软件中的 STEPDISC 程序提供了向前选择和向后……"。讲解:本段是本小节的开篇句,引入 SAS 软件中专门用于判别分析变量筛选的 STEPDISC 过程。这里一次性提到了两种对偶的变量筛选策略——forward selection(向前选择,逐步加入变量)和 backward elimination(向后消除,逐步剔除变量)。两者的共同思路是"逐个变量"地决定去留,从而把高维候选变量压缩成一个具有统计依据的子集,为后续的判别分析服务。
第2段(P0734)
原文复述
elimination procedures that test each variable before adding it to or
中文讲解
中文翻译:“消除过程——即在将每个变量加入或……"。讲解:本段紧接 P0733,把"向前选择"和"向后消除"这两种策略共同遵守的规则补全出来:在变量被"加入"集合或被"删除"出集合之前,都要先对该变量做统计检验。这种"先检验、再决定是否进/出"的机制,是 STEPDISC 区别于简单全部纳入的核心特征,目的在于保证最终进入模型的每一个变量都对组间区分有统计显著的贡献,避免仅凭拟合优度而把噪声变量也一并纳入。
第3段(P0735)
原文复述
deleting it from the set for discriminate analysis. The forward selection
中文讲解
中文翻译:“从判别分析所用的变量集合中删除之前都需进行检验。向前选择……"。讲解:本段补全了 P0734 未说完的句子,揭示变量筛选所服务的应用场景——判别分析(原文写作 discriminate analysis,统计文献中的标准写法为 discriminant analysis,本段疑似笔误)。紧接着又自然过渡到下一个子主题:开始具体描述 forward selection(向前选择)过程是如何做的。在本节结构中,本段起到承上启下的作用——先收束前几句对"两种筛选方法对每个变量做检验"的总体描述,再引出下文对"向前选择所用检验"的展开。
补充说明
原文写作 “discriminate analysis”,与统计文献中通行的 “discriminant analysis” 拼写不一致,此处按原文复述而不作改动。
第4段(P0736)
原文复述
procedure uses two tests–Wilkes’ Lambda and Pillais’ Trace–to select
中文讲解
中文翻译:“过程使用两种检验——Wilkes’ Lambda 与 Pillais’ Trace——来选择……"。讲解:本段明确指出 forward selection(向前选择)过程所采用的两种多变量检验统计量:Wilkes’ Lambda(原文写作 Wilkes’,标准写法为 Wilks’ Lambda)与 Pillais’ Trace(标准写法为 Pillai’s Trace)。同时列出两种检验,意味着 STEPDISC 在每一步筛选中允许用户依据具体情境在二者之间选择一种,作为变量纳入或剔除的统计依据。前者基于似然比思想,后者由若干单变量检验线性组合而成,对偏离多元正态的稳健性较好。
补充说明
原文对两位学者的拼写分别为 “Wilkes’” 与 “Pillais’",与统计文献常用写法 “Wilks’” 和 “Pillai’s” 略有出入,本栏严格沿用原文形式。
第5段(P0737)
原文复述
successive variables from the group that best discriminates between the six
中文讲解
中文翻译:“从候选变量中逐步选出对六个类别之间最具区分能力的那些变量。"。讲解:本段承接 P0736,揭示前述两种检验所服务的最终目的——“选出"对组间区分度贡献最大的"后续变量”。原文以"between the six"在此处中断,暗示紧接着的下一段会交代被区分的对象共六个类别(即本章研究的多分类问题包含六个组,例如六个诊断类别)。综上,向前选择的完整逻辑是:每一步都借助 Wilkes’ Lambda 或 Pillais’ Trace,在候选变量中找出能最显著提升六个类别之间可分性的那一个,将其加入模型。
补充说明
“between the six” 在此处被截断,本节仅给出片段,下一段落应继续说明六个类别的具体身份。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节范围(P0733–P0737)内未出现脚注、图表或边栏内容。原文存在若干英文拼写与统计文献标准写法不一致(Wilkes’、Pillais’、discriminate analysis),均在相应段落的补充说明中按原文照录并标注。
💡 本节核心要点
- STEPDISC 是 SAS 中专门用于判别分析变量筛选的程序过程。
- 该过程同时提供向前选择(forward selection)与向后消除(backward elimination)两种对偶策略。
- 两类策略都遵循同一规则:在变量被加入或剔除之前先对其进行统计检验。
- 向前选择过程使用两类多变量检验统计量:Wilkes’ Lambda 与 Pillais’ Trace。
- 筛选的最终目标是找出能最大限度地区分六个类别(即后续段落将展开的"六个组”)的变量子集。
- 原文拼写(Wilkes’、Pillais’、discriminate analysis)与统计文献标准写法存在出入,本节复述时一律保留原文形式。
🔑 关键术语
- STEPDISC:SAS 软件中专门执行逐步判别变量筛选的过程名,是本节的核心对象。
- 向前选择(forward selection):本节所述的变量筛选策略之一,从空集出发,每步根据统计检验结果加入一个新变量。
- 向后消除(backward elimination):本节所述的变量筛选策略之一,从包含全部候选变量的集合出发,每步检验并剔除贡献最小的变量。
- 判别分析(discriminant analysis,原文写作 discriminate analysis):本节变量筛选所服务的分析方法,依据若干预测变量将样本分入已知类别,本节场景下涉及六个类别。
- Wilkes’ Lambda(原文写法;标准拼写为 Wilks’ Lambda):本节提到的向前选择所使用的两种多变量检验统计量之一,基于似然比衡量组间协方差结构差异。
- Pillais’ Trace(原文写法;标准拼写为 Pillai’s Trace):本节提到的向前选择所使用的两种多变量检验统计量之一,由若干单变量检验线性组合而成,对偏离多元正态较为稳健。
s81 [描述性拆分] Forward Selection and Backward Elimination Results
第1段(P0738)
原文复述
composers. After a variable is selected, new F values are computed for the remaining variables in the set, and the variable with the highest F value is selected next. Forward selection continues until the next variable to be included is not significant. Backward elimination eliminates that variable with the smallest F value and continues until all remaining variables are significant.
中文讲解
本段紧接上一页(以“composers.”起句,明显是上一页末句的延续,属于跨页衔接残段),专门交代前向选择(forward selection)与后向剔除(backward elimination)这两个逐步回归(stepwise regression)策略的运行规则。
第一句说明前向选择的“重新评估”机制:每当一个新变量被纳入模型之后,作者并不立即停手,而是针对集合中尚未入选的每一个变量重新计算其 F 值,然后从中挑出 F 值最高者作为下一轮入选的候选。换言之,每一步都基于当前模型状态进行重新排序,而不是沿用最初的排序。这一规则的意义在于:一个变量在加入新变量后,其对模型的边际贡献会发生改变,重新评估才能保证每一步都选到当时最值得纳入的变量。
第二句给出前向选择的停止准则:上述“挑 F 值最高者纳入”的循环不断重复,直到下一个本该被纳入的变量已经“不显著”(not significant)为止。这里的“显著”指 F 检验未通过预设的显著性门槛,因此程序在这一步终止,所得到的便是前向选择给出的最终变量集。
第三句转入后向剔除的运行规则:与前向选择方向相反,程序每次剔除的是当前模型中 F 值最小的那个变量,并以“所有剩余变量均显著”作为终止条件。换言之,循环不断剔除最弱者,直到剩下的每一个变量都通过了 F 检验的显著性要求。
综合来看,本段把两条路径描述成对偶过程:前向选择“每步加最大 F 的不显著者即停”,后向剔除“每步删最小 F 的不显著者即停”;两者都依赖 F 值作为衡量变量边际贡献的统一指标,并以显著性检验作为共同的进出门槛。这为下一节展示两套方法在具体数据集(如作曲家数据)上的实际筛选结果作了规则上的铺垫:读者接下来看到的入选/剔除顺序,将直接由本段所述的算法逻辑决定。
补充说明
本段首词“composers.”显示它是上一页末句的延续(断句处应为“composers, …”或类似表述),跨页衔接痕迹明显,但上一页具体内容不在本节输入范围内,因此本段内不补充上一页背景,仅按字面理解本段规则描述。
脚注 / 边栏 / 图表 / 附加信息(如有)
无(除上述跨页衔接说明外,本段未出现脚注、图表或边栏)。
💡 本节核心要点
- 前向选择在每加入一个变量之后都会对剩余变量重新计算 F 值,并以 F 值最大者作为下一步入选变量。
- 前向选择的停止条件是:下一个待纳入的变量不再显著。
- 后向剔除的规则是:每一步删除当前模型中 F 值最小的变量。
- 后向剔除的停止条件是:模型中所有剩余变量均显著。
- 两种策略都把 F 统计量作为衡量变量边际贡献的统一指标,并以显著性检验作为共同的进出门槛,构成方向相反的对偶过程。
🔑 关键术语
- F value:F 统计量,在逐步回归中用于衡量某一变量在当前模型下的边际贡献大小;前向选择用其最大值,后向剔除用其最小值,作为筛选排序的依据。
- Forward selection:前向选择,一种逐步回归策略,从空模型开始,按 F 值由大到小逐个纳入变量,直到下一个候选变量不显著为止。
- Backward elimination:后向剔除,一种逐步回归策略,从包含全部候选变量的模型开始,每次剔除 F 值最小的变量,直到所有剩余变量都显著为止。
- Significant (not significant):显著性,指变量通过 F 检验预设的显著性门槛;前向选择在“下一个不再显著”时停止,后向剔除在“全部剩余变量均显著”时停止。
s82 [描述性拆分] Interpreting the Selected Variables (MR2, MMS, etc.)
第1段(P0739)
原文复述
Through forward selection the variables were entered in the following order: MR2, MR1, MF2, MP5, MR6, and MMS. (The meanings of these variable names are given in Chapter III, pp. 30-31.) Through backward elimination, six variables were dropped as ineffective discriminators, and the variables that survived were MMS, MR2, MR4, MR5, MR6, MP2, MP5, and MP6. MR1 was the last variable to be eliminated in the backward pass, even though it had been the second variable chosen for inclusion in the forward pass. For that reason MR1 was retained among the variables used in the second DISCRIM procedure.
中文讲解
本段说明两个逐步筛选过程的结果,并交代二者如何被合并进第二次 DISCRIM 分析。“向前选择"按贡献大小依次引入变量,本研究的进入顺序是 MR2 → MR1 → MF2 → MP5 → MR6 → MMS;“向后剔除"则从较大的候选集合出发,每一步去掉对区分作曲家贡献最小的变量,共剔除六个,保留 MMS、MR2、MR4、MR5、MR6、MP2、MP5、MP6。段落的关键判断落在对 MR1 的处理上:它在向后剔除中是最后一个被去掉的,但在向前选择中却是第二个被引入的——两种程序同时把它标记为信息量较大的变量,作者因此不采纳"剔除"的结论,而是把 MR1 一并带入第二次 DISCRIM 程序。括号中的页码指引提醒读者,各代码变量的具体定义见第三章第 30-31 页,本节并不复述这些定义。
补充说明
“Chapter III, pp. 30-31"是本节明确给出的页码交叉指引;MR2、MR1、MF2、MP5、MR6、MMS、MR4、MR5、MP2、MP6 等代码在原文范围内并未展开定义,需查第三章。“second DISCRIM procedure"意味着本节的变量筛选是为第二次判别分析运行服务的,前面已有一次 DISCRIM。
第2段(P0740)
原文复述
The variable that yielded the largest F value is MR2, the number of half-notes per measure. Its companion measure MP2 — the proportion of half-notes relative to the total number of notes — was also brought in by the forward selection. The distribution of quarter-note and eighth-note values is too similar across these composers for those values to separate them. MMS, the mean number of voices sounding simultaneously, is a static measurement, yet it also discriminates among the composers. Its more dynamic counterpart, MSTD, gauges how far a composer deviates from his or her own MMS during the course of a piece. Contrary to what the author had expected, MSTD failed to discriminate among the composers. Resolving whether composers were in fact following similar procedures or progressions in their compositions would require further study using more of these “dynamic” measures.
中文讲解
本段转向"解读被保留变量"的工作:哪些被保留的变量为什么能区分作曲家,哪些看似合理的变量为什么不能。MR2(小节中二分音符的个数)产生了所有变量中最大的 F 值,意味着它在区分四位作曲家群体上的贡献最大;与它成对的 MP2(二分音符在全部音符中所占的比例)同样被向前选择选入,说明二分音符的绝对使用与相对使用都携带区分信息。相对地,四分音符与八分音符在这些作曲家之间的分布过于接近,无法构成区分依据——因此基于这两种时值的变量都被排除。第二个被讨论的变量对是 MMS 与 MSTD:MMS 是一首作品里同时发声的声部数的平均值,属于"静态"总量指标,但它仍然能区分作曲家;与之对应的 MSTD 衡量作曲家在其自身 MMS 附近上下波动的幅度,作者本以为它能捕捉作曲家的"动态"特征,结果并未达到区分效果。作者并未把这一阴性结果当作定论,而是提出:要对"作曲家是否遵循类似的展开程序"这一问题下结论,还需要考察更多"动态"类型的变量。值得注意的还有"dynamic"一词在原文中带引号,这是作者对这一标签的自我保留。
补充说明
本段内部形成两组对照:MR2(绝对计数)与 MP2(相对比例)刻画同一音乐特征的不同侧面;MMS(静态均值)与 MSTD(围绕均值的偏离幅度)刻画同一特征的总量与动态。原文中"dynamic"一词加引号,这是作者主动打折扣的语言信号,与"contrary to what the author had expected"共同提示此处为研究假设与实证结果之间的不一致点。
脚注 / 边栏 / 图表 / 附加信息(如有)
本节唯一的非正文信息是一条页码交叉指引(“Refer to Chapter III, pp. 30-31 for variable names”),指向第三章对 MR、MP、MF、MMS 等变量代码的定义。
💡 本节核心要点
- 向前选择按 MR2、MR1、MF2、MP5、MR6、MMS 的顺序纳入六个变量;向后剔除从更大集合中淘汰六个变量,保留 MMS、MR2、MR4、MR5、MR6、MP2、MP5、MP6。
- MR1 在向后剔除中虽是最后一个被去掉的,却在向前选择中第二个被引入,两种程序指向同一结论,因此被作者特别保留并带入第二次 DISCRIM 程序。
- MR2(小节中二分音符的个数)产生了所有变量中最大的 F 值;其配对变量 MP2(二分音符占全部音符的比例)也被同时纳入,说明二分音符的绝对与相对使用都携带作曲家区分信息。
- 四分音符与八分音符的分布在四位作曲家之间过于接近,因而基于它们的变量未能进入最终变量集。
- MMS(同时发声的声部数均值)作为静态指标能够区分作曲家;其动态对应指标 MSTD(围绕 MMS 的偏离幅度)未能成功区分作曲家,与作者事先预期相反。
- 作者把 MSTD 的阴性结果视为需要进一步研究的开放问题:要判断作曲家是否遵循类似的展开程序,必须测试更多"动态"类型的测度。
🔑 关键术语
- Forward selection:逐步纳入法:从空集出发,每一步选入对区分各组贡献最大的变量。本研究中变量的进入顺序为 MR2、MR1、MF2、MP5、MR6、MMS。
- Backward elimination:逐步剔除法:从包含全部候选变量的集合出发,每一步去掉对区分贡献最小的变量。本研究最终保留 MMS、MR2、MR4、MR5、MR6、MP2、MP5、MP6,剔除六个变量。
- F value (largest):逐步筛选过程中用以判定变量是否应纳入或剔除的统计量;值越大表示该变量对分组差异的解释越强。本研究中 MR2 产生最大的 F 值。
- DISCRIM procedure:判别分析程序;本节所述的变量筛选结果将用于第二次 DISCRIM 程序。
- MR2:每小节中二分音符的个数,是本研究中 F 值最高的变量。
- MP2:二分音符在全部音符中所占的比例,与 MR2 配对使用,同样被向前选择纳入。
- MMS (mean number of voices sounding simultaneously):一首作品中同时发声的声部数的平均值,作者将其归类为"静态"测度,但在本研究中能够区分四位作曲家。
- MSTD:MMS 的"动态"对应指标,衡量作曲家在作品过程中偏离其自身 MMS 的幅度;本研究未能用它区分作曲家,与作者事先预期相反。
- “Dynamic” measure (加引号的 dynamic):原文中带引号的术语,指刻画作品内部运动与偏离而非单一平均值的指标;引号是作者对其标签性使用的自我保留。
s83 Discriminate Analysis Run with Nine Selected Variables
第1段(P0741)
原文复述
Discriminate Analysis Run with Nine Selected Variables
中文讲解
这是一个二级章节标题,宣告接下来将呈现一次使用九个已选变量进行的判别分析运行。该标题的功能在于标志文档从一个分析阶段切换到下一个阶段——从变量筛选过渡到实际的多元统计建模运行。需要注意,原文使用的措辞为 “Discriminate Analysis”,而非更常见的 “Discriminant Analysis”,但在本节语境中二者均指向同一种多变量统计分类方法(即判别分析)。标题中的 “with Nine Selected Variables” 这一限定语提示读者:本次分析并非使用全部候选变量,而是建立在前期已经完成的一次变量筛选基础上,只把筛选所得的九个变量送入判别分析模型;这也说明本节的分析对象是已被压缩过的特征子集,而非全变量集。
脚注 / 边栏 / 图表 / 附加信息(如有)
无(本段仅为二级标题,不包含脚注、图表、公式或边栏内容)。
💡 本节核心要点
- 本节为二级标题,宣告将展示一次使用九个已选变量的判别分析运行
- 标题中的 “Nine Selected Variables” 提示本节分析基于前序变量筛选所得的子集,而非全变量集
- 该标题起到承上启下的过渡作用:将分析流程从变量筛选推进到多元统计建模阶段
- 原文 “Discriminate Analysis” 在统计学语境中等价于更常见的 “Discriminant Analysis”(判别分析)
🔑 关键术语
- Discriminate Analysis:判别分析:一种多变量统计分类方法,依据若干自变量的取值将观测样本归入已知类别;在本节中特指使用九个已筛选变量执行的那一次判别分析运行
- Nine Selected Variables:九个已选变量:在前序变量筛选步骤中保留下来的九个特征构成的子集,本节判别分析仅以这九变量为输入
s84 [描述性拆分] Tables IV-H and IV-I: Classification with Nine Variables
第1段(P0742)
原文复述
The five variables discarded in backward elimination of STEPDISC were not included in the second run of DISCRIM. All other variables were
中文讲解
本句承接前文关于变量筛选的论述,说明在 STEPDISC 的 backward elimination(向后剔除)过程中被剔除的五个变量,没有进入第二次 DISCRIM(判别分析)的运行中;其余变量则被保留下来。该句的末尾以 “were” 悬空,其补语 “retained” 由下一页 P0743 起首承接,构成一个跨页的完整复合句。其在本节论证中的作用是:明确 Table IV-H 的九个变量并非一次性设定的全集,而是经过 STEPDISC 程序从更原始的变量集合中筛除五个之后剩下的子集,从而把“变量筛选”与“判别分类”两个统计步骤串联起来。读者需要意识到,Table IV-H 与 Table IV-D 的差异不仅在于样本或分组层面,更在于变量集合经过了人为/程序化的缩减。
补充说明
句中 STEPDISC 与 DISCRIM 为 SAS 软件中的两个过程名:前者用于逐步判别以挑选对分组最具区分力的变量,后者用于实施判别分类;术语在原文语境中保留原写。
第2段(P0743)
原文复述
retained. Table IV-H shows the classification results based on the nine variables of the six “known” pavan groups.
中文讲解
本段首先承接上句完成"其余变量均被保留"的语义,然后引出 Table IV-H:它呈现的是基于这九个被保留变量、对六个“已知”帕凡组(pavan groups)进行判别分类的结果。“known” 一词加了引号,提示这些帕凡组在研究中被预先认定为归属确定的参照集,用以校准判别函数并对其他作品的归属进行推断。Table IV-H 与早前的 Table IV-D 共享同一套“已知”分组结构,但所使用的变量集合不同,正是因为此处使用的是经 STEPDISC 筛除后留下的九个变量,因此其结果将揭示变量集合简化后分类能力是否仍然维持。
补充说明
“pavan groups”指帕凡舞曲(pavan)这一 16 世纪英国宫廷舞蹈体裁下的作曲家归属分组;六个“已知”组在前文已建立,是后续归属性判断的参照基线。
第3段(P0744)
原文复述
In comparison with Table IV-D, the new percentages have declined for all composers. Gibbons and Morley no longer are verified 100%, but have dropped to 86.67% and 81.82%, respectively. Bull’s pieces are even less frequently attributed to him, and a shift from similarity to Byrd to similarity to Philips has taken place with the new selection of variables. Byrd’s misclassifications to Farnaby, Gibbons and Bull remain the same, but the likelihood that he could be confused with Morley or Philips has increased. Philips now has a minority of his pieces classified as his own, and while he was never attributed to Bull before, he is in this case at 7.41%.
中文讲解
本段以 Table IV-D 为基准,全面比较 Table IV-H 的分类百分比变化,并据此评估变量筛选对判别效力的影响。
第一,作者开宗明义指出:新变量集合下,所有作曲家的归正率都下降了,意味着砍掉五个变量付出了可测量的代价。
第二,对 Gibbon 与 Morley 给出具体数字:Gibbon 从 100% 跌至 86.67%,Morley 从 100% 跌至 81.82%,说明原本完全可分辨的两个极端样本在简化变量后出现了少量混淆,这是 STEPDISC 删除判别力较弱变量的代价之一。
第三,Bull 的归正率进一步下降,且错误归属对象发生结构性改变:由原先多被判与 Byrd 相近,转变为被判与 Philips 相近。这提示 Bull 与 Byrd 之间的相似度原本依赖被剔除的那几个变量,一旦去掉,Bull 与 Philips 的特征距离变得更突出——这种“误指对象转移”比单纯的百分比下降更值得关注,因为它揭示了变量集合如何重塑作曲家之间的相对距离结构。
第四,Byrd 的误判情况被细致分解:指向 Farnaby、Gibbon、Bull 的误判比例保持不变(意味着支撑这些混淆的判别信号并未依赖被删变量),但被误判为 Morley 或 Philips 的概率上升了。这种“部分不变、部分上升”的拆分方式,比笼统地说“Byrd 的误判增多”信息量更大。
第五,Philips 一项出现最显著的变化:仅有少数作品被正确归入他自己(“a minority”),并且他此前从未被误判为 Bull,现在却出现了 7.41% 的 Bull 误指率。这是 Table IV-H 较 Table IV-D 唯一新增的跨作曲家混淆方向,说明变量简化既削弱了 Philips 的可识别性,又人为制造了一条新的混淆路径。
综上,本段不只是报告数字,而是在用每个作曲家的升降与去向来说明:精简后的九个变量在总体上牺牲了分类准确率,并以不同方式在不同作曲家之间重新分配了混淆负担,从而为下一段评估该变量集合是否仍可接受提供了经验依据。
补充说明
原文中的百分比(86.67%、81.82%、7.41%)分别对应三个作曲家的归正/误归频次,是判别分析中“被正确/错误归入某组的样本比例”;“shift from similarity to Byrd to similarity to Philips”描述的是 Bull 的作品在两次变量集合下最常被错指的参照作曲家发生了迁移,这一现象需结合 Table IV-D 与 Table IV-H 两表的交叉判读才能成立。
脚注 / 边栏 / 图表 / 附加信息(如有)
无独立的脚注、边栏或图表说明文本;本小节正文直接围绕 Table IV-H 展开,与前文的 Table IV-D 形成对照阅读关系。
💡 本节核心要点
- Table IV-H 所用的九个变量是 STEPDISC 向后剔除五个变量后保留下来的子集,而非预设全集。
- 相比 Table IV-D,使用简化变量集合后所有作曲家的归正率均出现下降。
- Gibbon 与 Morley 从 100% 降至 86.67% 与 81.82%,证明变量精简付出了可测量的判别力代价。
- Bull 的误指参照对象由 Byrd 转移到 Philips,显示变量集合的改变重塑了作曲家之间的相对距离。
- Byrd 的误判呈现“部分不变、部分上升”的结构:指向 Farnaby、Gibbon、Bull 的比例不变,指向 Morley、Philips 的比例上升。
- Philips 在新变量下仅少数作品被正确归入自身,且首次出现 7.41% 被误判为 Bull 的情况,是变量精简制造出的新混淆路径。
🔑 关键术语
- STEPDISC backward elimination:SAS 的逐步判别过程,通过向后剔除逐步移除对分组区分贡献最小的变量,本节中以此筛去五个变量。
- DISCRIM (second run):SAS 的判别分类过程第二次运行,输入是 STEPDISC 保留下的九个变量,用于生成 Table IV-H 的分类结果。
- “known” pavan groups:研究中预先认定为归属确定的六个帕凡作曲家分组,作为判别函数的训练参照集。
- Table IV-H:本节呈现的核心结果表,使用九个变量对六个“已知”帕凡组进行判别分类的百分比矩阵。
- Table IV-D:本节对照基准表,使用未精简或不同变量集合得到的分类结果,用于衡量精简后的得失。